
 TRAE-AI编程

让智谱 GLM 生成的单元测试一次通过,关键是把“被测对象、测试框架、断言方式”说死:先贴全源码并指定 pytest,再要求它只输出测试、用真断言、补边界。问题通常不在模型能力,而在你的提示没把约束钉死。很多新手看到测试红一片就怪模型,其实多半是提示漏了这几样,调一下就能绿。本文把四个最容易翻车的点拆开讲,并给出能直接照抄的提示模板,让你下次让智谱 GLM 生成的单元测试一次就能过。
先看结论
让智谱 GLM 生成的单元测试一次通过,记住四件事:第一,把被测函数和依赖先贴给它,别只说“给我写个测试”;第二,明确指定测试框架(pytest 还是 unittest)和运行目录;第三,要求断言用真断言、禁止用 print 假装验证;第四,让它先列边界用例再写代码,覆盖率才有保障。
⚠️ 注意:智谱 GLM 默认会“顺着你的话补全”,你没说框架,它就挑自己最熟的写;你没说目录,它就用相对导入,一跑就 ModuleNotFoundError。
这四点对应下面四节。如果你赶时间,直接翻到“四、提示要点四”末尾照抄模板即可;想弄懂原理,从头看起也很快。
一、问题出在哪:为什么 AI 写的单测总红灯
<概念>:单元测试是在最小范围内验证一个函数或类的输入输出是否符合预期,核心是用断言(assert)判定结果,而不是用打印看一眼。断言失败测试就红,通过才绿。
用智谱 GLM 写单测,新手最容易犯的错是只描述意图,不提供被测代码。比如你说“给这个登录函数写测试”,但没把函数贴出来,模型只能凭训练数据猜一个签名,跑起来当然对不上。还有人让它“顺便把函数也实现了”,结果测试和被测代码是同一段幻觉,绿了也没意义。
常见误解是“大模型既然能写代码,写测试肯定一次过”。事实是,单元测试对运行环境极其敏感:导入路径、测试框架、 fixtures 任一不对,智谱 GLM 生成的单元测试就会在CI里整片飘红。一次通过率低,通常不是模型不行,而是提示没把约束说死。想系统了解 AI 编程工具,可以先看 DeepSeek 中文教程。
版本边界上,pytest 的 assert 和 unittest 的 self.assertEqual 写法完全不同,智谱 GLM 没指定框架时最常拿 pytest 语法去套 unittest 文件,导致 AssertionError 都报不出来。所以提示里写明框架,是让 AI 写单元测试的隐形前提。
二、提示要点一:贴全被测对象与依赖
最稳的写法不是让模型“自由发挥”,而是把被测函数和它能 import 的模块一起喂给它。这样智谱 GLM 生成的单元测试才不会出现“找不到模块”的低级错误。
前置准备:确认你本地能跑通这个函数,再把源码和目录结构贴进对话。步骤很简单:
- 新建对话,提示这样写:下面是被测函数
add(a,b),位于calc.py,请用 pytest 为它写测试; - 要求输出“仅测试代码 + 必要的 import”,不要重写被测函数;
- 把结果贴进
test_calc.py,本地pytest跑一遍,失败就把它报的错贴回去。
# calc.py
def add(a, b):
    return a + b
# test_calc.py
def test_add():
assert add(1, 2) == 3
assert add(-1, 1) == 0
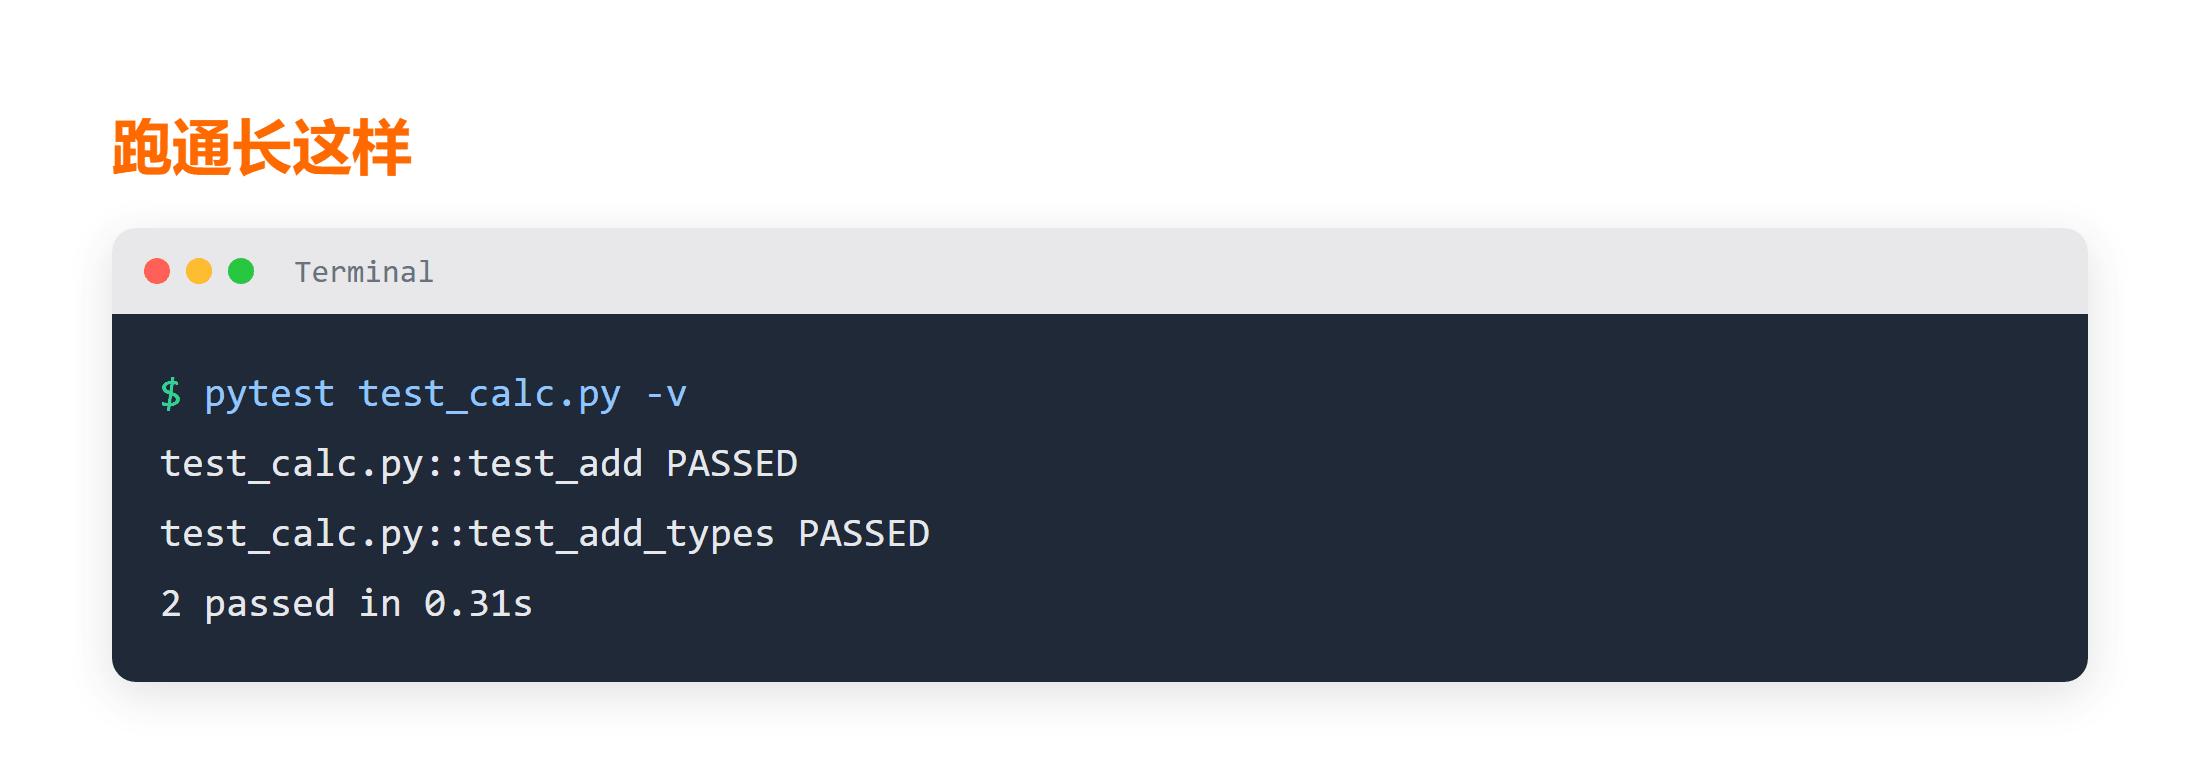
上面这两段是最小可运行示例,预期 pytest 跑出 2 passed。如果智谱 GLM 给你的测试里出现了 from calc import * 之外的奇怪路径,多半是你没告诉它文件位置。想就地试,可以用 TRAE 编程教程 里的运行环境直接验证。
💡 小提示:要求智谱 GLM “只输出测试文件、不要改被测代码”,比让它一把梭更靠谱,因为模型改写原函数的诱惑很强,改完测试就失去了独立验证的意义。
这一步解决的是“导入与依赖漂移”。只给函数名,模型倾向于自己造一个;贴全源码,等于把边界钉死,这是让 AI 生成的单元测试能跑通最划算的一招。
三、提示要点二:锁死框架与断言
第二常见翻车点是测试框架和断言写法。中文引号、tab 与空格混用、把断言写成 print(result == 3)(永远绿),都会让智谱 GLM 交付一段“假绿”的单测。最稳的约束是:明确框架、要求真断言、禁止 print 验证。
pytest 里一个合格的测试长这样:函数名以 test_ 开头,内部用 assert 判定。智谱 GLM 经常为了“好看”加一堆 print,但 print 不会改变测试通过与否,纯属自我安慰。先在 Python 教程 把 pytest 约定过一遍,再让模型写,能少走很多弯路。
def test_add_types():
    # 真断言:类型与值都要对
    assert isinstance(add(1, 2), int)
    assert add(1.5, 2.5) == 4.0
上面这段说明真断言的作用:不止比数值,还比类型。若把断言写成 print(add(1,2)==3),无论对错测试都绿,那就失去了单元测试的意义。
关于覆盖率,默认模型只会写你提到的几个用例。提示里加上“覆盖空值、边界、异常三类”,智谱 GLM 写出来的测试覆盖率才真的有提升,而不是只覆盖 happy path。这一节处理的是“语法落地”,让 AI 生成的单元测试八成的运行期报错都卡在框架与断言差异。
⚠️ 注意:unittest 文件里写
assert也能跑,但和self.assertEqual混用会让你读不懂失败信息,提示必须说“统一用 pytest 风格”或“统一用 unittest 风格”。
失败处理:若运行报 ModuleNotFoundError,九成是相对导入没说清包结构——在提示里补一句“被测文件在包 mypkg/calc.py 下,用 from mypkg.calc import add”,报错通常会消失。这一步处理的是“配置对了但仍跑不通”的残留问题,也适合和 OpenClaw 中文教程 这类助手横向对比时排查。
四、提示要点三与四:边界用例与踩坑清单
第三、四要点是边界覆盖和失败排查。很多“明明写了测试却没测到 bug”的问题,都源于只测了正常值。让智谱 GLM 先列边界再写代码,单元测试才算真正有效。
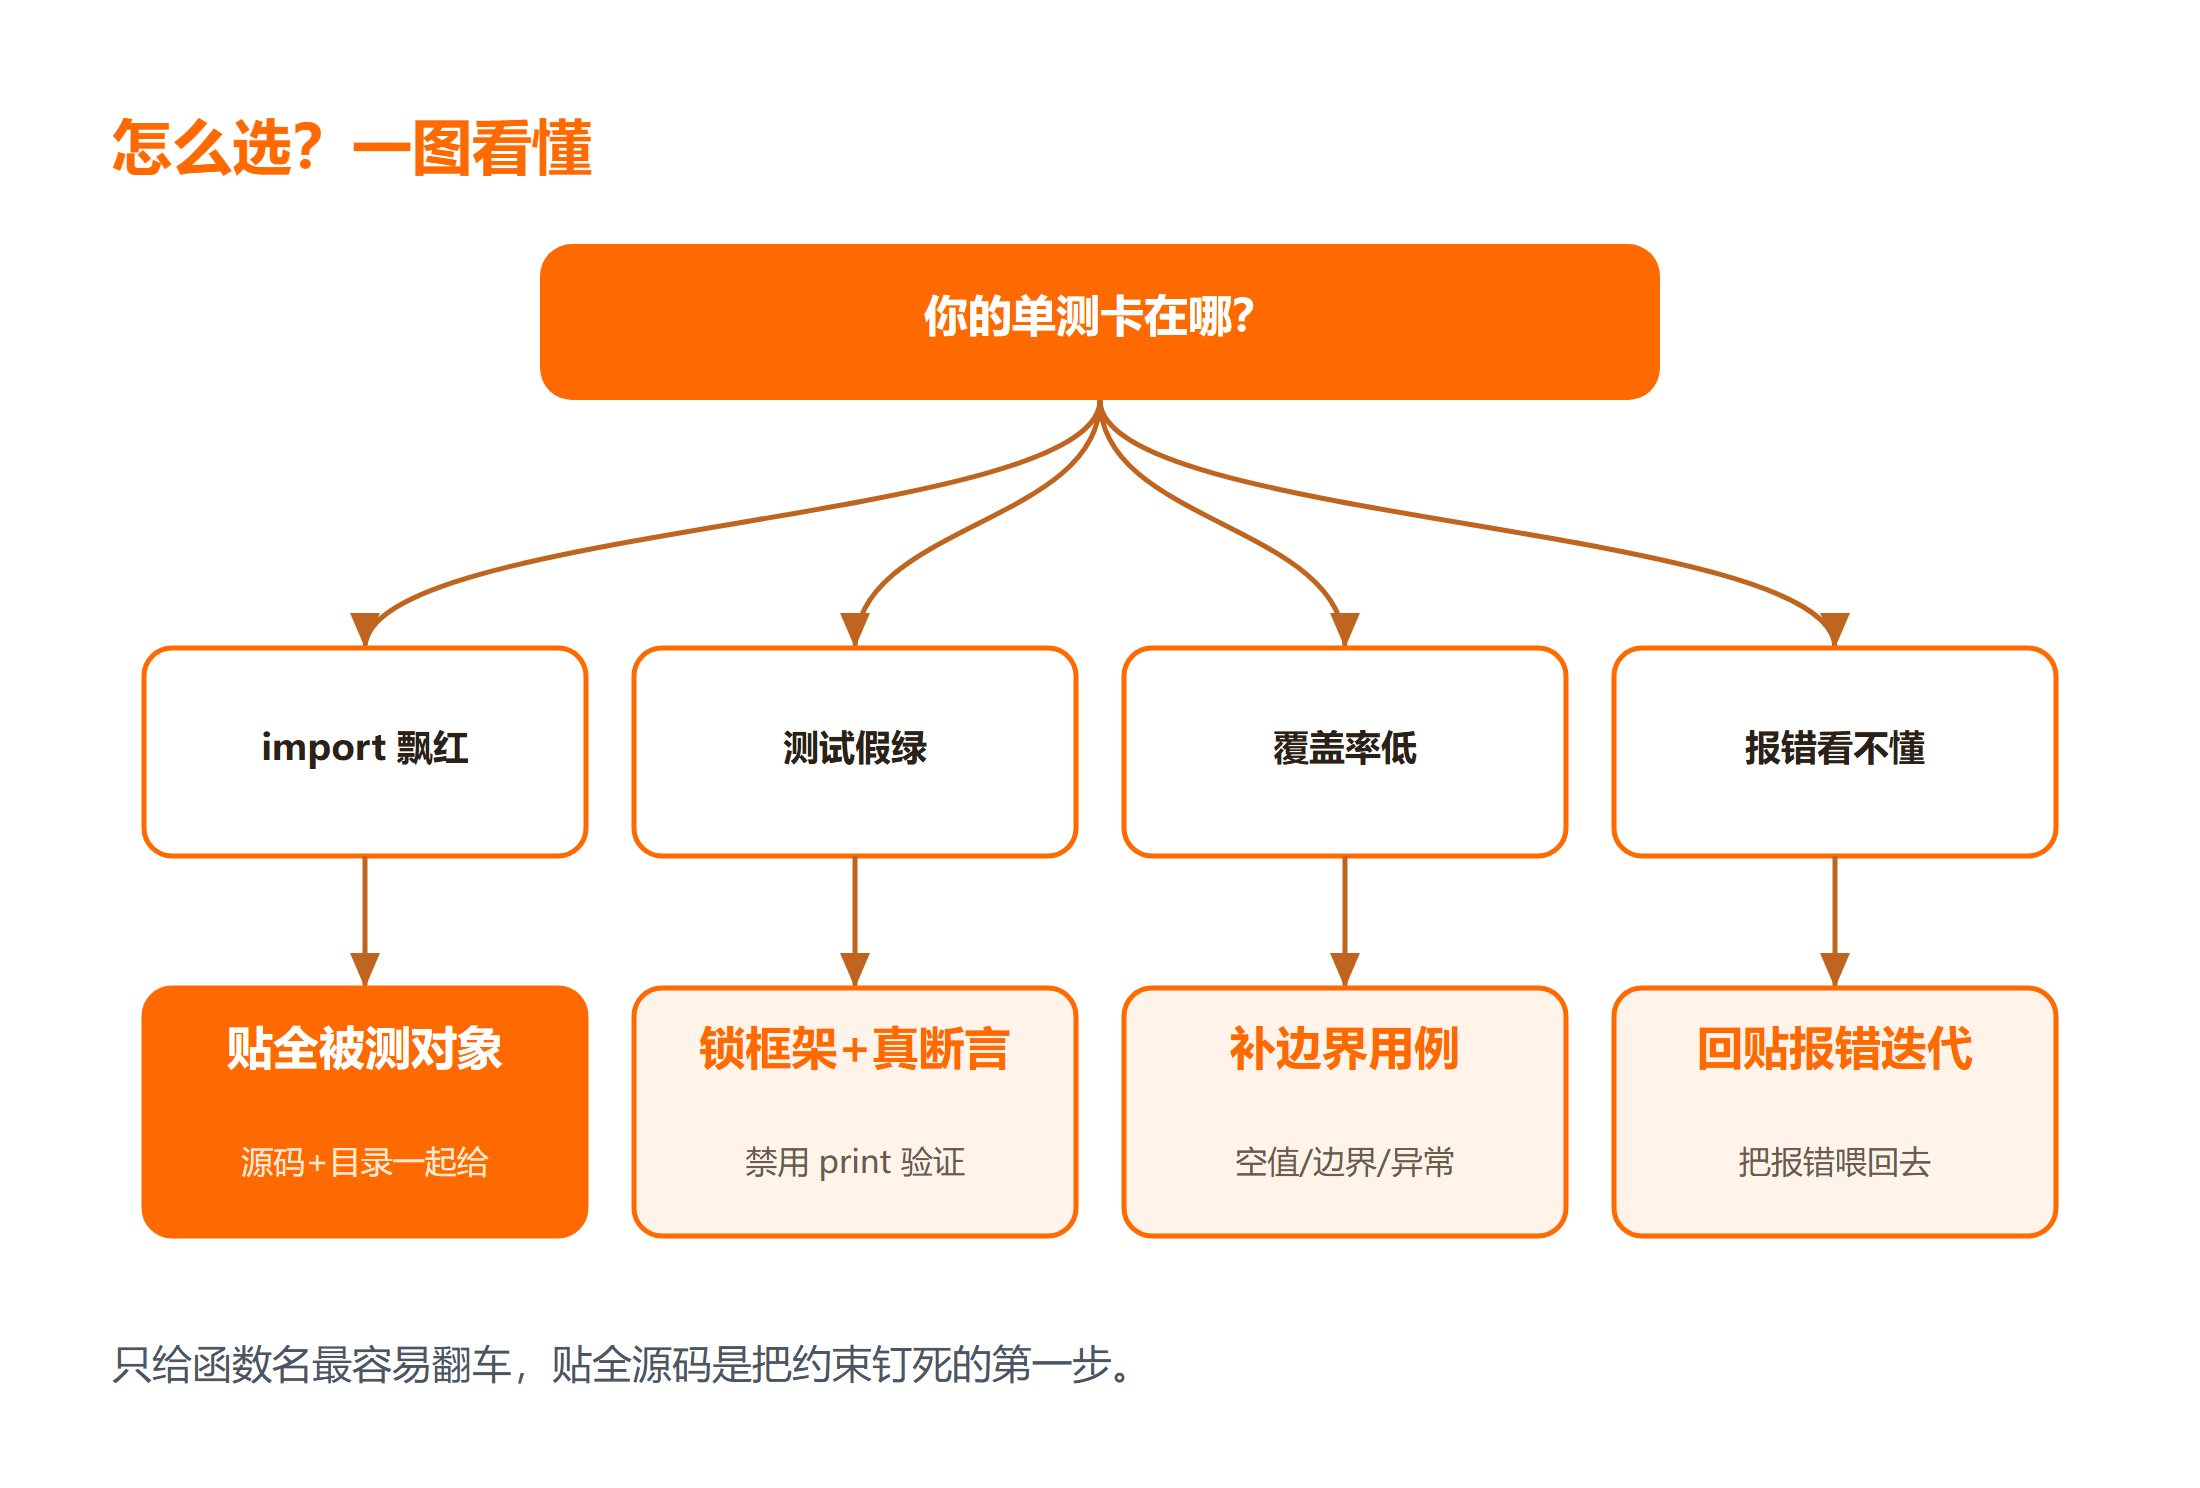
| 提示要点 | 错误做法 | 正确做法 |
|---|---|---|
| 贴被测对象 | 只说函数名 | 贴源码与目录 |
| 锁框架断言 | 混用 print | 指定 pytest + 真断言 |
| 补边界 | 只测 happy path | 空值/边界/异常 |
| 查失败 | 看一眼就改 | 把报错贴回模型 |
踩坑清单:
- 坑一:只给函数名不给代码,测试 import 飘红;
- 坑二:用 print 代替 assert,测试假绿;
- 坑三:没指定框架,pytest 语法塞进 unittest;
- 坑四:只测正常值,边界与异常全漏。
总结
让智谱 GLM 生成的单元测试一次通过,核心不是“让它猜”,而是写好提示词、把约束钉死:贴全被测对象、锁死框架与断言、补齐边界用例、把报错贴回模型迭代。一段好的提示词,比反复改测试代码更省时间。要点带走:源码比描述管用、真断言比 print 管用、边界比 happy path 管用。
💡 上手任务:挑一个你仓库里最稳的函数,按上面的四要点写一段提示让智谱 GLM 出测试,本地
pytest跑一遍;红灯就把报错贴回去,直到 2 passed 以上,感受一次通过率的变化。
下一步可以把代码生成和单元测试串成闭环:先让模型写实现,再让它写测试,最后用测试反推实现漏洞。记住,AI 生成的单元测试只是起点,能跑通、能覆盖才是真本事。
延伸学习
想把 AI 编程与测试这套能力补齐,可以按这个顺序来:
- 先过一遍 Python 零基础课程,把运行时与测试基础铺平;
- 语法记不住时,翻 DeepSeek 写正则 这篇笔记,看别人怎么把易错点写成清单;
- 想当场格式化再测,用 Python 代码格式化 统一风格。
常见问题
Q:智谱 GLM 给的测试在它回答里能跑,粘到我代码就报错?
A:几乎都是导入路径与框架差异。明确告诉它“用 pytest、被测文件在包 X 下、用绝对导入”,并检查相对导入是否跨包,报错通常会消失。
Q:为什么测试显示通过,但明明有 bug?
A:多半是用 print 代替了 assert,或者只测了正常值。把断言改成真 assert,并补上边界与异常用例,假绿会变真红,bug 才会现形。
Q:覆盖率一直上不去怎么办?
A:在提示里显式要求“覆盖空值、边界、异常三类用例”,并让它先列用例清单再写代码。模型默认只覆盖 happy path,你不点名它就不会主动补。



