
 TRAE-AI编程

用 AI 写技术文档,最怕术语前后打架:同一概念一会儿叫「函数」一会儿叫「方法」,读者越看越晕。先给结论:保持术语一致靠三件事——先建一份术语表喂给 AI、再在提示词里锁定「不准同义替换」、最后让 AI 自检有没有混用近义词。做好这三步,生成的多篇文档能像一个人写的。很多人直接丢一句「帮我写文档」就完事,结果每篇措辞各说各话,后期改起来比重写还累。下面按「先抽术语表 → 再写约束提示词 → 然后用小样本校准」的顺序讲清用法与边界,照着做既能提速又不失控,也能学会在什么场景该让 AI 接手、什么场景必须人工把关。
先看结论
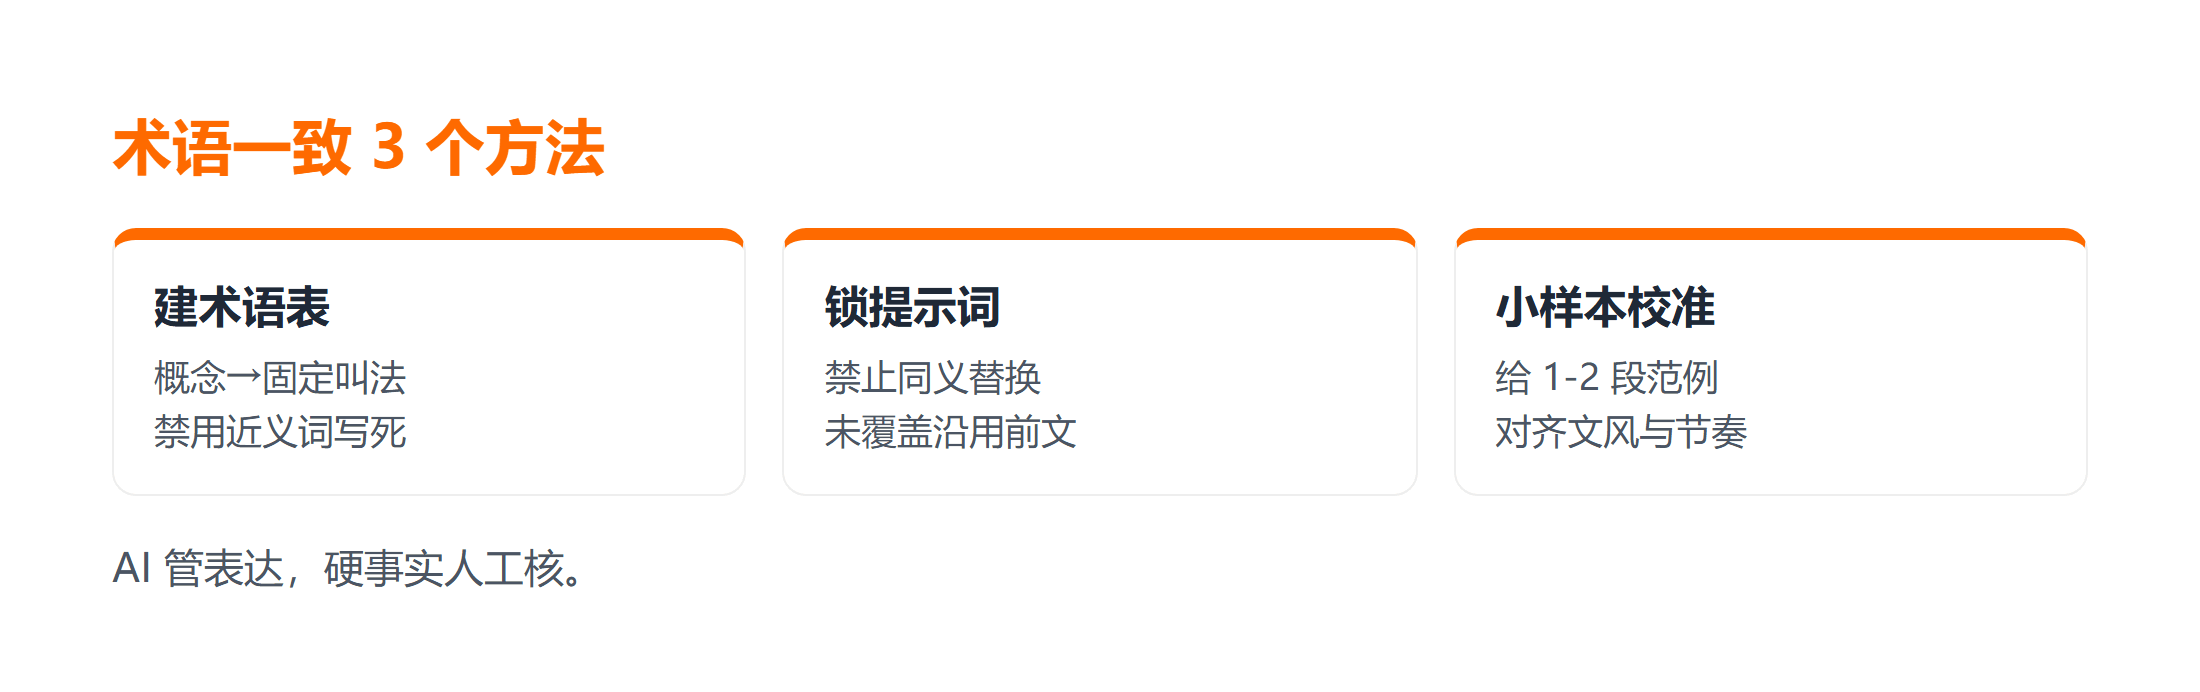
- 先抽术语表:把「概念 → 固定叫法」列清楚,全篇统一。
- 锁约束:提示词明确「近义词不得替换,必须沿用术语表」。
- 小样本校准:给 1-2 段范例,让 AI 对齐你的文风与措辞。
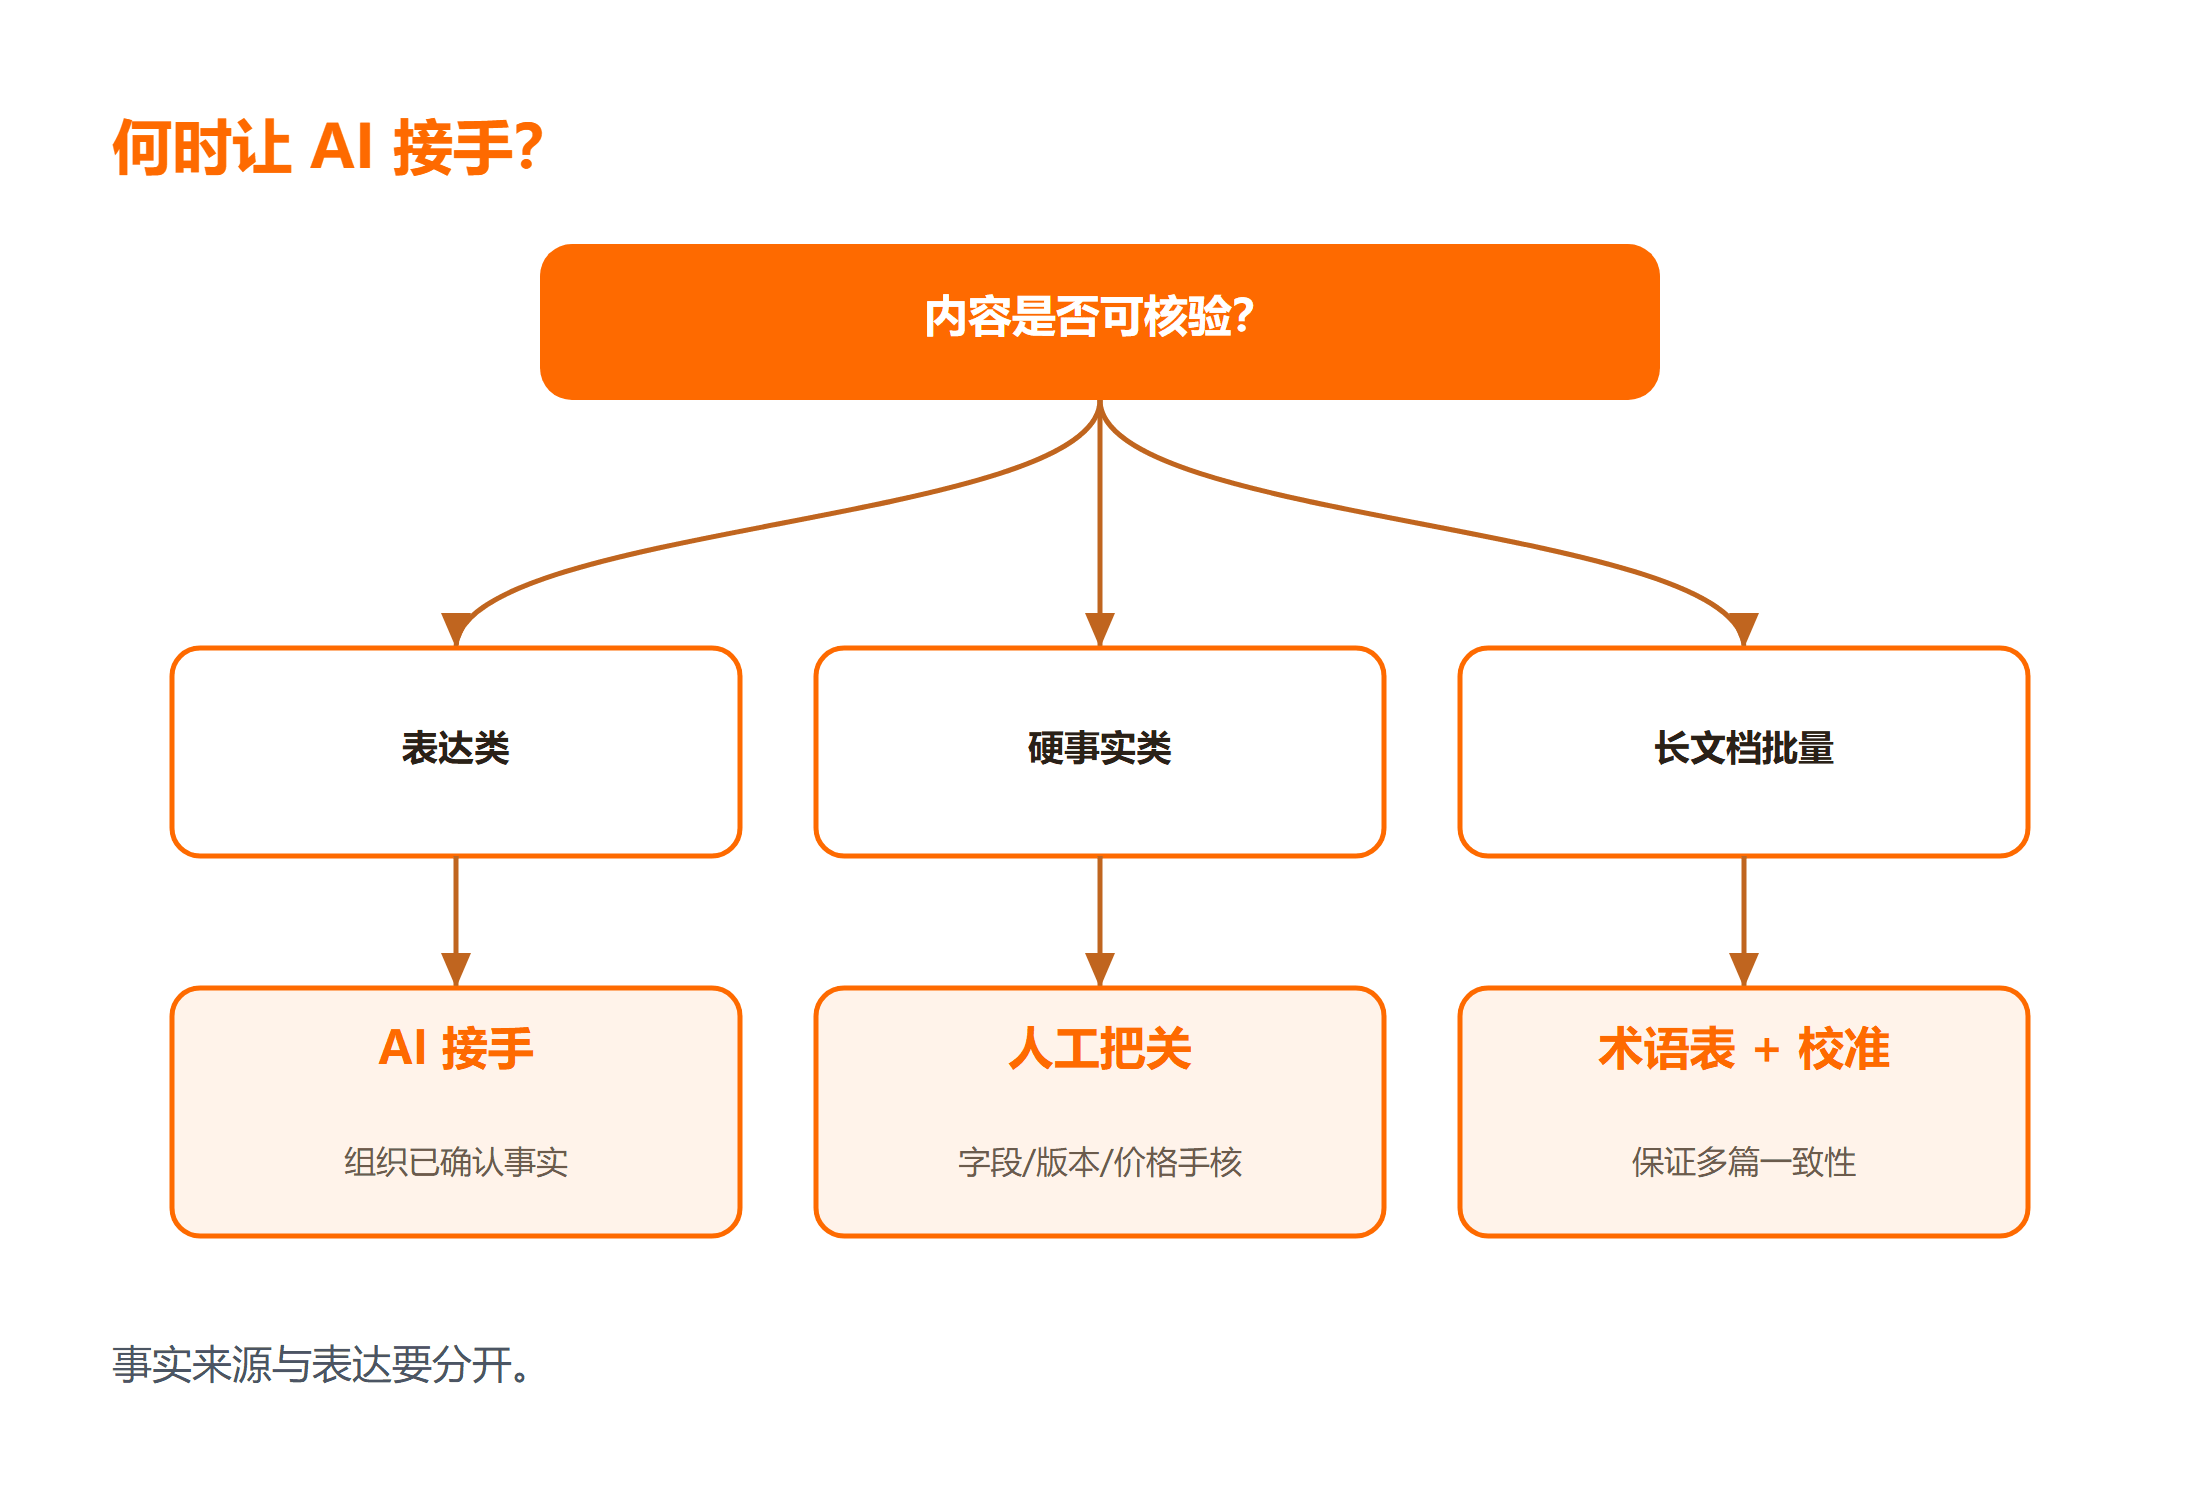
- 边界:法律、接口契约、版本号这类硬事实必须人工核对,AI 只管表达。
一、先抽术语表
术语表是统一措辞的地基。把文档里会出现的核心概念列成「概念 → 固定中文叫法 → 是否允许英文缩写」三列。例如:「API 网关」统一叫「网关」,不叫「API 网关」也不叫「接口网关」;「token」保留英文不翻译;「函数」与「方法」必须区分,不能混用。术语表越具体,AI 跑偏空间越小。
一个常见失败是术语表只写概念不写禁用叫法,AI 仍会用近义词。更好的写法是明确「用 A,禁用 B/C」:
# 术语表(节选)
- 网关:统一叫「网关」,禁用「API 网关」「接口网关」
- 函数:仅指独立定义的可调用单元,禁用「方法」代指
- 方法:仅指对象/类上的成员函数,禁用「函数」代指
- token:保留英文,不译「令牌」出现正文时除外
把这段随每次请求一起给 AI,是保持术语一致成本最低的一步。术语表不必一次写完美,可以边写边补:每发现一个新的近义词混用,就回头把它加进禁用清单,并标注正确叫法。两周下来,术语表会变成团队最值钱的基础资产,新人照着它写,产出质量立刻对齐老员工;等文档积累到几十篇,这套术语约束还能反过来帮你不漏掉历史页面的措辞。写文档前补基础,可以先过一遍 DeepSeek 中文教程,了解怎么把约束写进提示词。
术语表确定后,建议把它配置进团队的文档模板,并在本地安装一个术语校验脚本或编辑器插件,每次提交前自动检查有没有漏用术语表。这样从流程上把术语一致固化下来,而不是靠人工每次提醒。配置完成后可以先运行一次校验命令,看输出里是否还有近义词残留,再决定要不要补规则。
二、再写约束提示词
术语表只是素材,真正起作用的是提示词里的硬性约束。明确告诉 AI:「严格沿用术语表,遇到近义词一律以术语表为准,不得自行同义替换;若某概念术语表未覆盖,先沿用全文已出现的叫法,不要新造。」这一条能挡掉大半「自动润色」带来的措辞漂移。
给约束时也要给输出结构,避免它为了「通顺」悄悄换词:
约束:
1. 严格使用术语表,禁止同义替换;
2. 术语表未覆盖的概念,沿用前文已出现的叫法;
3. 每段不超过 200 字,先给结论再展开;
4. 不添加术语表以外的专业缩写。

为了让约束真正生效,建议把提示词模板存成可复用文件,每次生成前先运行一次小测试:用一段含易混术语的样例输入,检查 AI 是否严格沿用术语表;若预期输出里出现禁用近义词,就定位到对应约束并修复,再运行验证一遍,直到输出稳定一致。这一步看似多花几分钟,却能省掉后期逐篇改术语的返工。
这样 AI 在表达上被「绑住」,术语一致性立刻提升。对 AI 编程工具的提示词能力想深入,可看 TRAE 编程中文教程,里面大量用到约束式写法。
三、用小样本校准文风
术语对了,文风还得像同一个人写的。给 AI 1-2 段你认可的范例,让它照着仿:句式长短、主动被动、是否用「你」称呼读者。小样本比长篇风格描述更有效,因为模型能从具体例子里学到隐含规则。
# 校准示例:用范例对齐「先结论后解释」的节奏
examples = [
    "网关超时默认 3 秒。超时后请求会重试一次,仍失败则返回 504。",
    "token 超限会截断上下文。长文档应先摘要再喂入,避免关键信息被丢掉。",
]
# 让 AI 参照这两段的节奏生成新段落
这段示例展示了「先给结论、再补行为」的写法,AI 仿出来风格更统一。想了解 TRAE 怎么把 AI 能力接进写作流,可翻 Trae Plugin Use AI Capabilities,看插件如何固定提示词模板。
校准时不要只给一段范例,最好覆盖三种典型句式:说明类、步骤类、对比类,让 AI 学到不同场景下的措辞边界。比如说明类用「X 默认 Y,超出则 Z」,步骤类用「先 A,再 B,最后 C」,对比类用「A 侧重××,B 侧重××」。三种范式都给到,AI 在生成新段落时才不会在无范例处自行发挥,术语和口吻才能稳定延续。
四、边界:哪些必须人工把关
AI 管表达,管不了硬事实。接口字段名、版本号、错误码、法律条款、价格这些,生成后必须人工核对原文,不能让 AI「合理推断」。一个适用边界是:凡是能从权威源直接抄的,就不要让 AI 改写;AI 只负责把已确认的事实组织成通顺文档。遇到排查类问题,也可参考 TRAE 问题排查,把「事实来源」和「表达」分开对待。
落地时还有一个常被忽略的点:术语表本身也要版本化。文档迭代到第二版、第三版时,概念叫法可能调整,这时要去检查老术语表是否还适用,避免新文档沿用旧叫法、和已发布内容打架。把术语表放进和代码同源的版本库,每次改动都留记录,后续回溯谁改了哪个词、为什么改,都有据可查。
总结
用 AI 写技术文档,术语一致靠三件事:先抽术语表、再写硬约束提示词、最后用小样本校准文风。三者叠加,多篇文档能像出自同一人之手,后期维护成本大降。但要守住边界:术语表和硬事实必须人工核对,AI 只管把已确认的内容表达清楚,别让它替你做事实判断。
常见问题
Q:术语表要写到多细才够?
覆盖高频概念和所有容易混用的近义词即可,不必穷举。重点是把「函数/方法」「网关/API 网关」这类你最在意的区分写死,剩下的交给约束提示词兜底。
Q:AI 还是偷偷换了词怎么办?
大概率是约束不够硬或范例太少。把「禁止同义替换」写成编号强约束,并附 1-2 段范例;生成后再让它自检一遍「有没有偏离术语表」,两轮基本能压住漂移。
Q:哪些内容绝不能交给 AI 自由发挥?
接口字段、版本号、错误码、法律与价格等可核验事实。这些应从权威源直接确认后给 AI 当素材,让它只做组织表达,而不是推断编造。
延伸学习
- TRAE AI 开发 Python Django 后台管理系统(配套课程,把文档能力用进真实项目)
- PHP开发者必备手册——PHP8中文教程(笔记,对照一门语言的术语规范写法)
- Mermaid流程图(在线工具,文档里的架构图用它画更直观)



