
 TRAE-AI编程

用通义千问辅助写 SQL 想不踩坑,核心是先给表结构、强约束走索引、强制参数化,再本地验证后才上生产。它生成的 SQL 确实能省下大量翻文档的时间,但绝不能直接贴上生产环境。最常见的翻车有五类:凭空编造字段名、忽略索引导致全表扫描、直接拼接用户输入引发注入、混用数据库方言、以及不验证就上线。每次让 AI 生成 SQL 之前,先看清这 5 个坑,能帮你避开绝大多数线上事故。下面先把结论讲清,再逐坑拆解该怎么避、写错了怎么修。
先看结论
让通义千问辅助写 SQL 想要稳,记住五条底线。第一,给足表结构:把建表语句或字段清单贴给模型,别让它猜列名。第二,点明数据量与索引:明确告诉它这张表有几千万行、哪些列有索引,逼它写出能走索引的查询。第三,永远参数化:用户输入用占位符,绝不字符串拼接。第四,声明方言:说清是 MySQL 还是 SQL Server,函数写法天差地别。第五,先验证再上线:本地用真实数据跑一遍,确认结果和性能都达标。这五条做到,AI 生成 SQL 才是效率工具而非隐患。
适用边界:本文面向业务侧日常查询与报表 SQL,不涉及存储过程调优、分布式数据库或超大规模数仓。版本方面,以 MySQL 8 与 SQL Server 2019+ 的常见语法为准,老版本函数可能不兼容。
一、坑一:不给表结构,AI 凭空编造字段
如果你只说「查一下用户订单」,通义千问辅助写 SQL 会自己编字段名,比如写成 user_name、order_time,而你的真实列叫 username、created_at,一跑就报未知列。正确做法是把建表语句一起给:
-- 先贴真实表结构,再要查询
CREATE TABLE orders (
  id BIGINT PRIMARY KEY,
  user_id BIGINT,
  status TINYINT,
  amount DECIMAL(10,2),
  created_at DATETIME
);

-- 需求:查最近 7 天已支付订单
SELECT user_id, amount, created_at
FROM orders
WHERE status = 1
  AND created_at >= DATE_SUB(NOW(), INTERVAL 7 DAY);
预期结果(未在本机执行):字段名与真实表一致,查询可正常返回。失败处理:若报 Unknown column,先核对 AI 写的列名是否和 DESC orders 输出一致,不一致就纠正后再跑。想系统学 SQL 基础,可以看 SQL 教程 打底。
二、坑二:忽略数据量与索引,写出全表扫描
AI 默认按「能跑就行」写查询,常常丢掉索引条件。当 orders 表有千万行、且 created_at 索引缺失时,上面的范围查询会全表扫描,慢得离谱。解决思路是按需补索引,并提醒模型走索引列:
-- 为常用范围查询补索引
CREATE INDEX idx_orders_created ON orders(created_at);
-- 再用覆盖索引思路,只取必要列
SELECT user_id, amount
FROM orders
WHERE created_at >= DATE_SUB(NOW(), INTERVAL 7 DAY);关于索引与查询优化的系统知识,MySQL 教程 里有更完整的讲解。性能取舍:建索引会拖慢写入,但能让查询从秒级降到毫秒级,读多写少的报表表非常划算。
三、坑三:拼接用户输入,埋下注入隐患
最危险的一坑是让 AI 把前端传来的参数直接拼进 SQL。下面这种写法一旦用户输入 ' OR '1'='1,就会把全表拖出来:
-- 危险写法:字符串拼接用户输入
SELECT * FROM orders
WHERE user_id = ' + userId + ';
正确做法是用参数化查询,把输入当数据而非代码:
# 安全写法:参数占位,用户输入永远只是值
cursor.execute(
    "SELECT * FROM orders WHERE user_id = %s",
    (user_id,)
)
无论用哪门语言,参数化查询都是底线。把这条硬规则写进提示词,通义千问辅助写 SQL 才会默认产出安全写法。
四、坑四:混用方言,函数写法不对
MySQL 的日期函数是 DATE_SUB(NOW(), INTERVAL 7 DAY),而 SQL Server 要用 DATEADD(DAY, -7, GETDATE())。不声明方言,AI 可能混着写,一换数据库就报错。明确告诉它目标库,并对照 MySQL 速查手册 核对函数名。
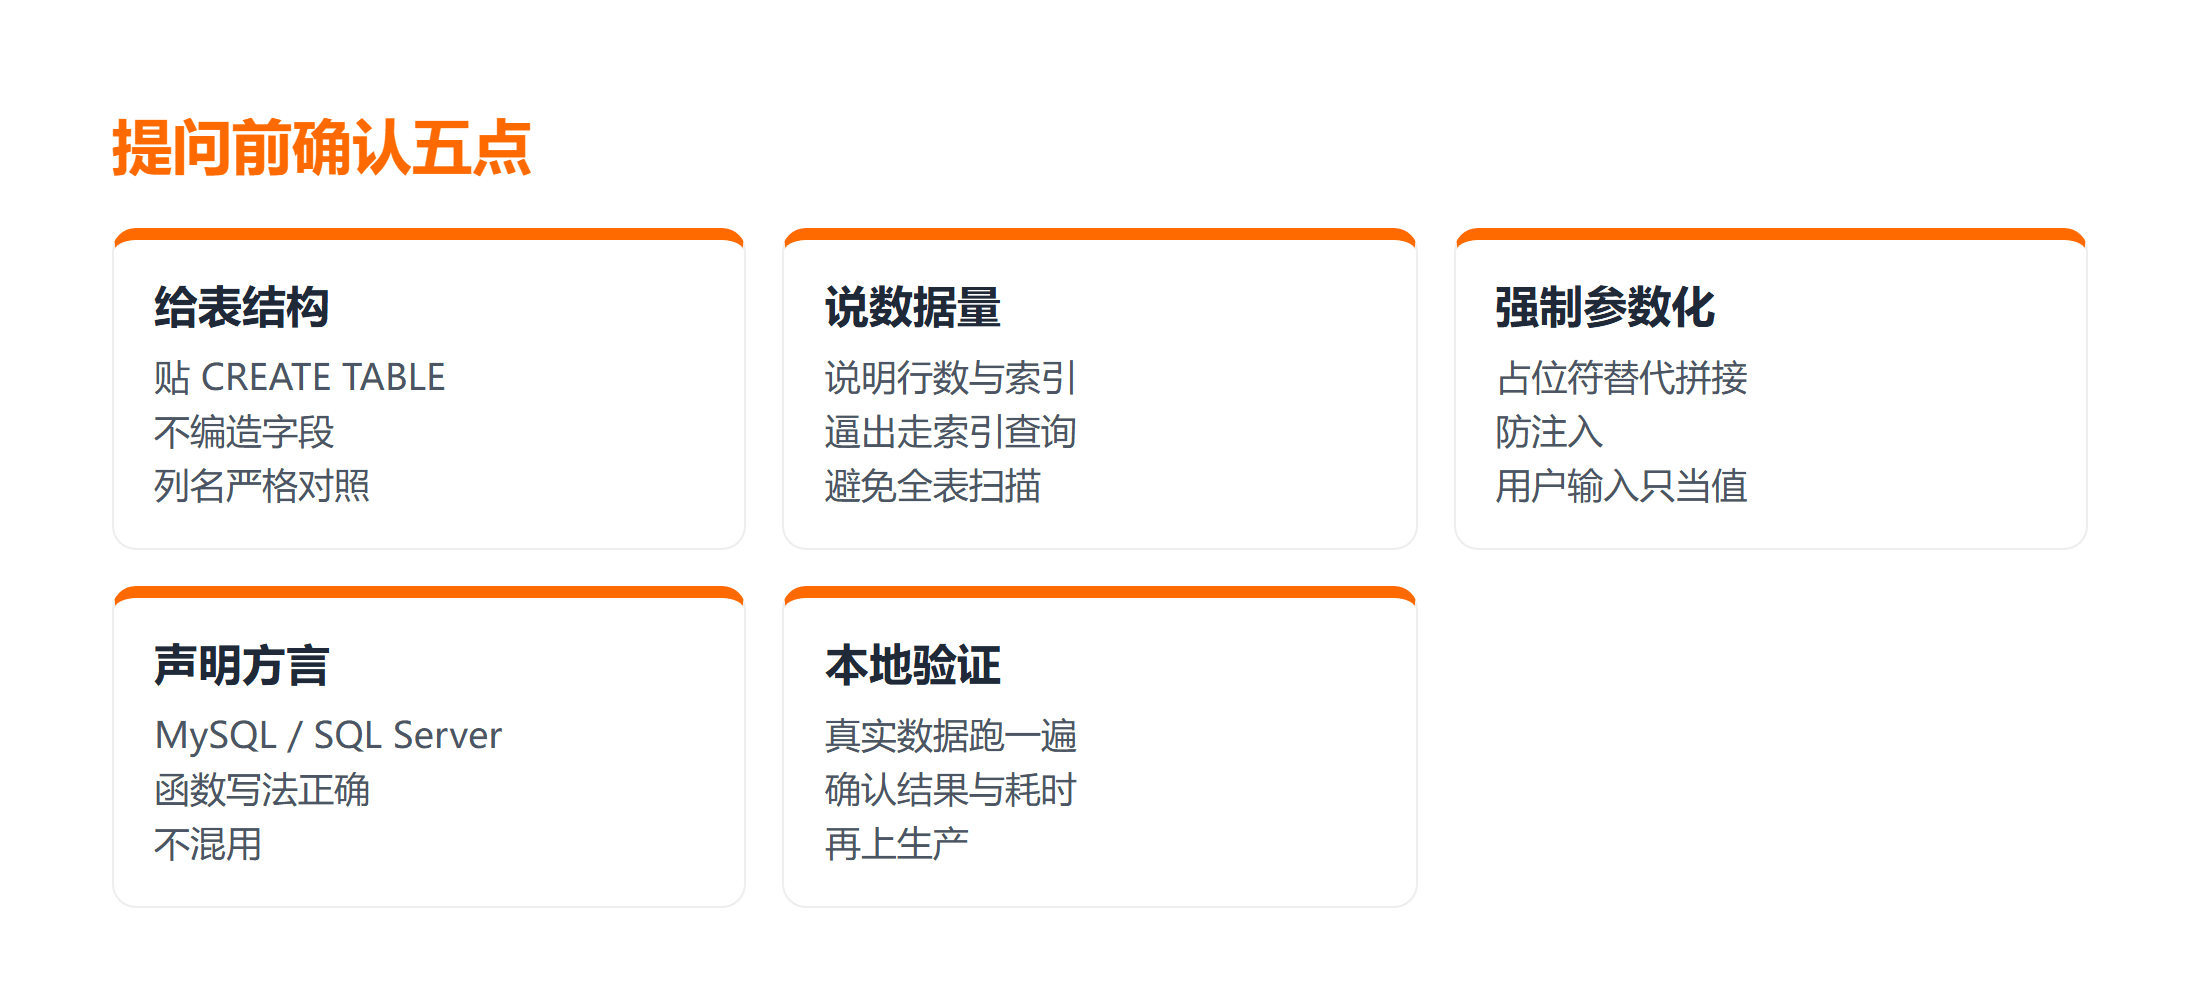
上手前的五步确认清单
真正用好通义千问辅助写 SQL,关键在把约束前置。第一,贴表结构,不让模型猜列名。第二,说明数据量与已有索引,逼它写能走索引的查询。第三,强制参数化,禁止字符串拼接。第四,声明数据库方言,函数写法才不会错。第五,本地用真实数据验证结果与耗时后再上线。把这五步固化成提问模板,AI 给的 SQL 从第一版就接近可用。
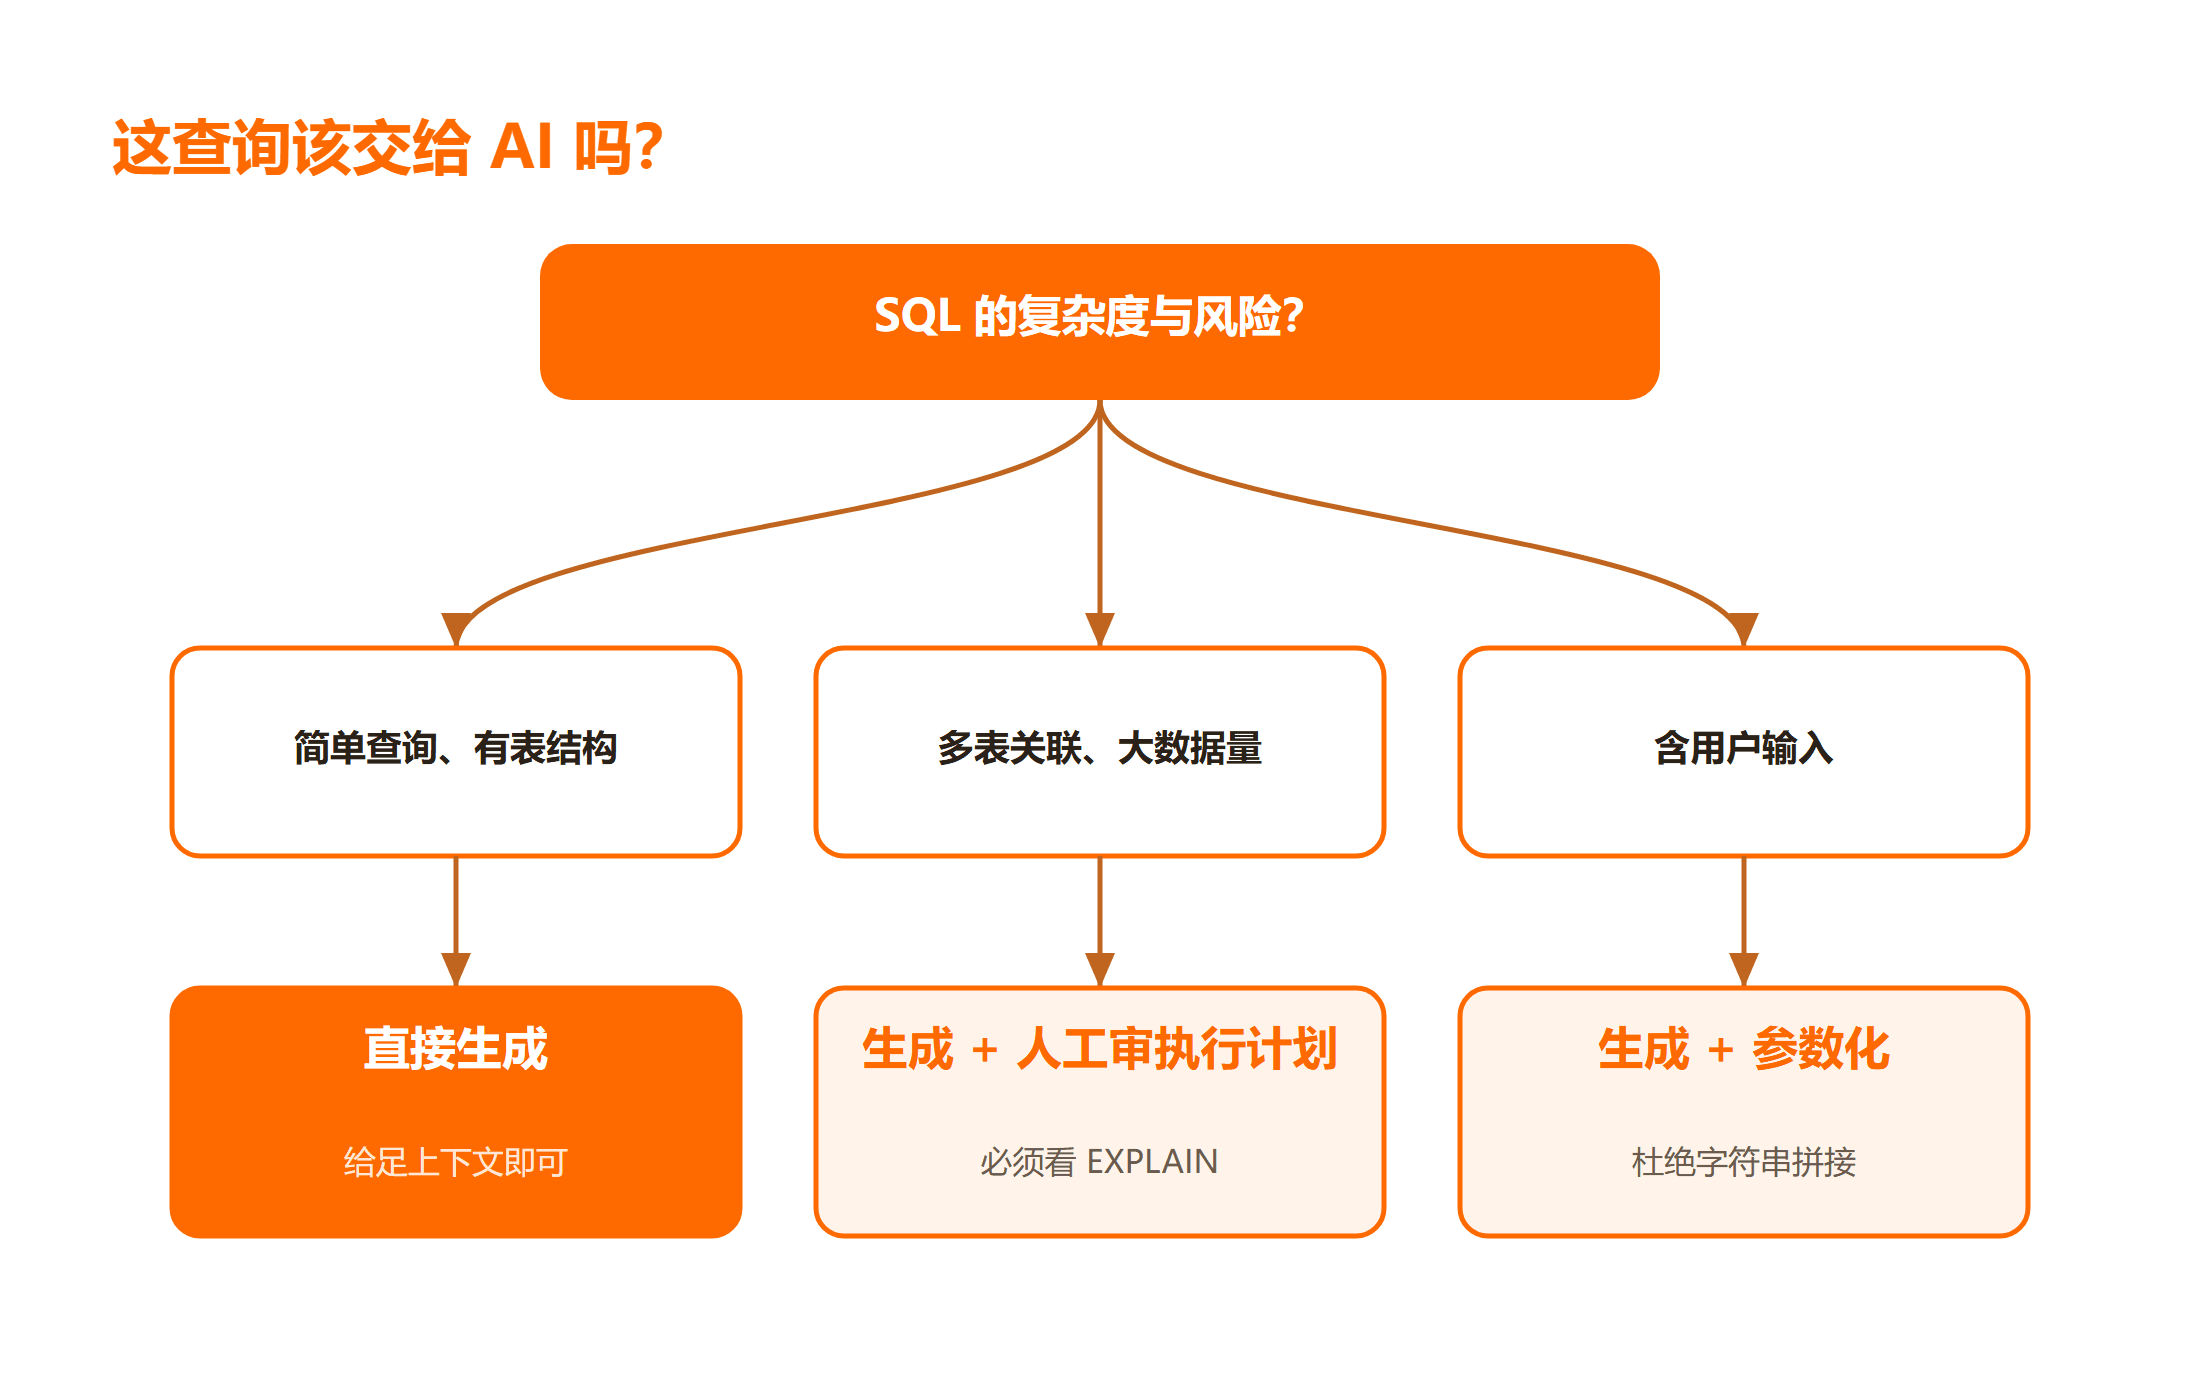
还有个容易被忽略的点:AI 生成的聚合或分页 SQL,常常在空表或 null 值上返回异常。上线前务必造几条边界数据(空结果、超大金额、重复 user_id)跑一遍,确认 SUM 不会因 null 变 null、分页不会丢数据。把这套顺序记牢,基本能避开绝大多数 SQL 事故。
真正落地前,建议本地运行一遍 AI 给的 SQL 验证可用性:mysql -u test -p demo < query.sql,检查返回行数是否符合预期,确认聚合在空表和 null 值下结果仍正确;若生产环境仍慢,用 EXPLAIN 检查执行计划是否全表扫描,失败就回到补索引或改写 WHERE 条件那一步重新验证。
一个细节:分页方言别写错
MySQL 用 LIMIT offset, size,SQL Server 2019+ 用 OFFSET ... ROWS FETCH NEXT ... ROWS ONLY,老版本还要套 ROW_NUMBER()。让 AI 生成 SQL 时务必点明分页方式,否则在高并发列表接口上会直接报错或返回错页。
常见问题
Q:我已经给了表结构,AI 还是写错列名怎么办?
通常是表结构贴得不全,或字段注释有歧义。把完整的 CREATE TABLE 和几条样本数据一起给,并在需求里点明「列名严格以建表语句为准」,能大幅降低编造概率。
Q:AI 写的 SQL 本地快,生产慢,可能是什么原因?
多半是生产数据量大、且查询没走索引。先用 EXPLAIN 看执行计划,确认是否 type=ALL(全表扫描),再按需补索引或改写 WHERE 条件,逼它命中索引列。
Q:参数化查询会不会影响 AI 生成 SQL 的可读性?
不会。参数化只是把变量从 SQL 文本里抽出来,查询逻辑完全不变,反而更清晰、更安全。把「一律参数化」写进规则,通义千问辅助写 SQL 会默认遵守。
总结
用通义千问辅助写 SQL 想不踩坑,本质是先把五件事钉死:给足表结构、说明数据量与索引、强制参数化查询、声明数据库方言、本地验证后再上线。记住五个坑——编造字段、全表扫描、注入隐患、方言错配、不验就上,基本能让 AI 生成的 SQL 成为可靠的效率工具,而不是埋在生产里的雷。
读者任务链(前置 / 操作 / 验证 / 失败处理)
- 前置:确认目标数据库类型(MySQL 还是 SQL Server)与可访问的建表语句,先想清楚这张表的数据量与已有索引。
- 操作:把表结构、方言、数据量一起交给通义千问,并明确要求「强制参数化、走索引列、不拼接用户输入」。
- 验证:本地用真实样本数据跑一遍,确认返回结果正确,并用
EXPLAIN确认没有全表扫描。 - 失败处理:若报未知列,先核对外键与字段名;若慢查询,先看执行计划是否命中索引;若注入告警,立刻改回参数化写法。



