 免费 AI IDE

C 语言 fgets 读不完整时,先判断缓冲区是否装下了换行符。读到换行表示这一行结束;没有读到换行,可能是输入被截断,剩余字符仍留在输入流中。本文用不同长度的输入打印返回长度、末尾字符和下一次读取结果,说明如何处理空行、超长行和EOF。 为了便于复现,文中会把C 语言 fgets、输入缓冲区、换行符分别落到输入、判断和输出三个位置,并用边界样例说明何时应该接受、拒绝或继续排查;同时明确讨论字符串终止与输入截断。
一、fgets读取的是一段,不保证整行
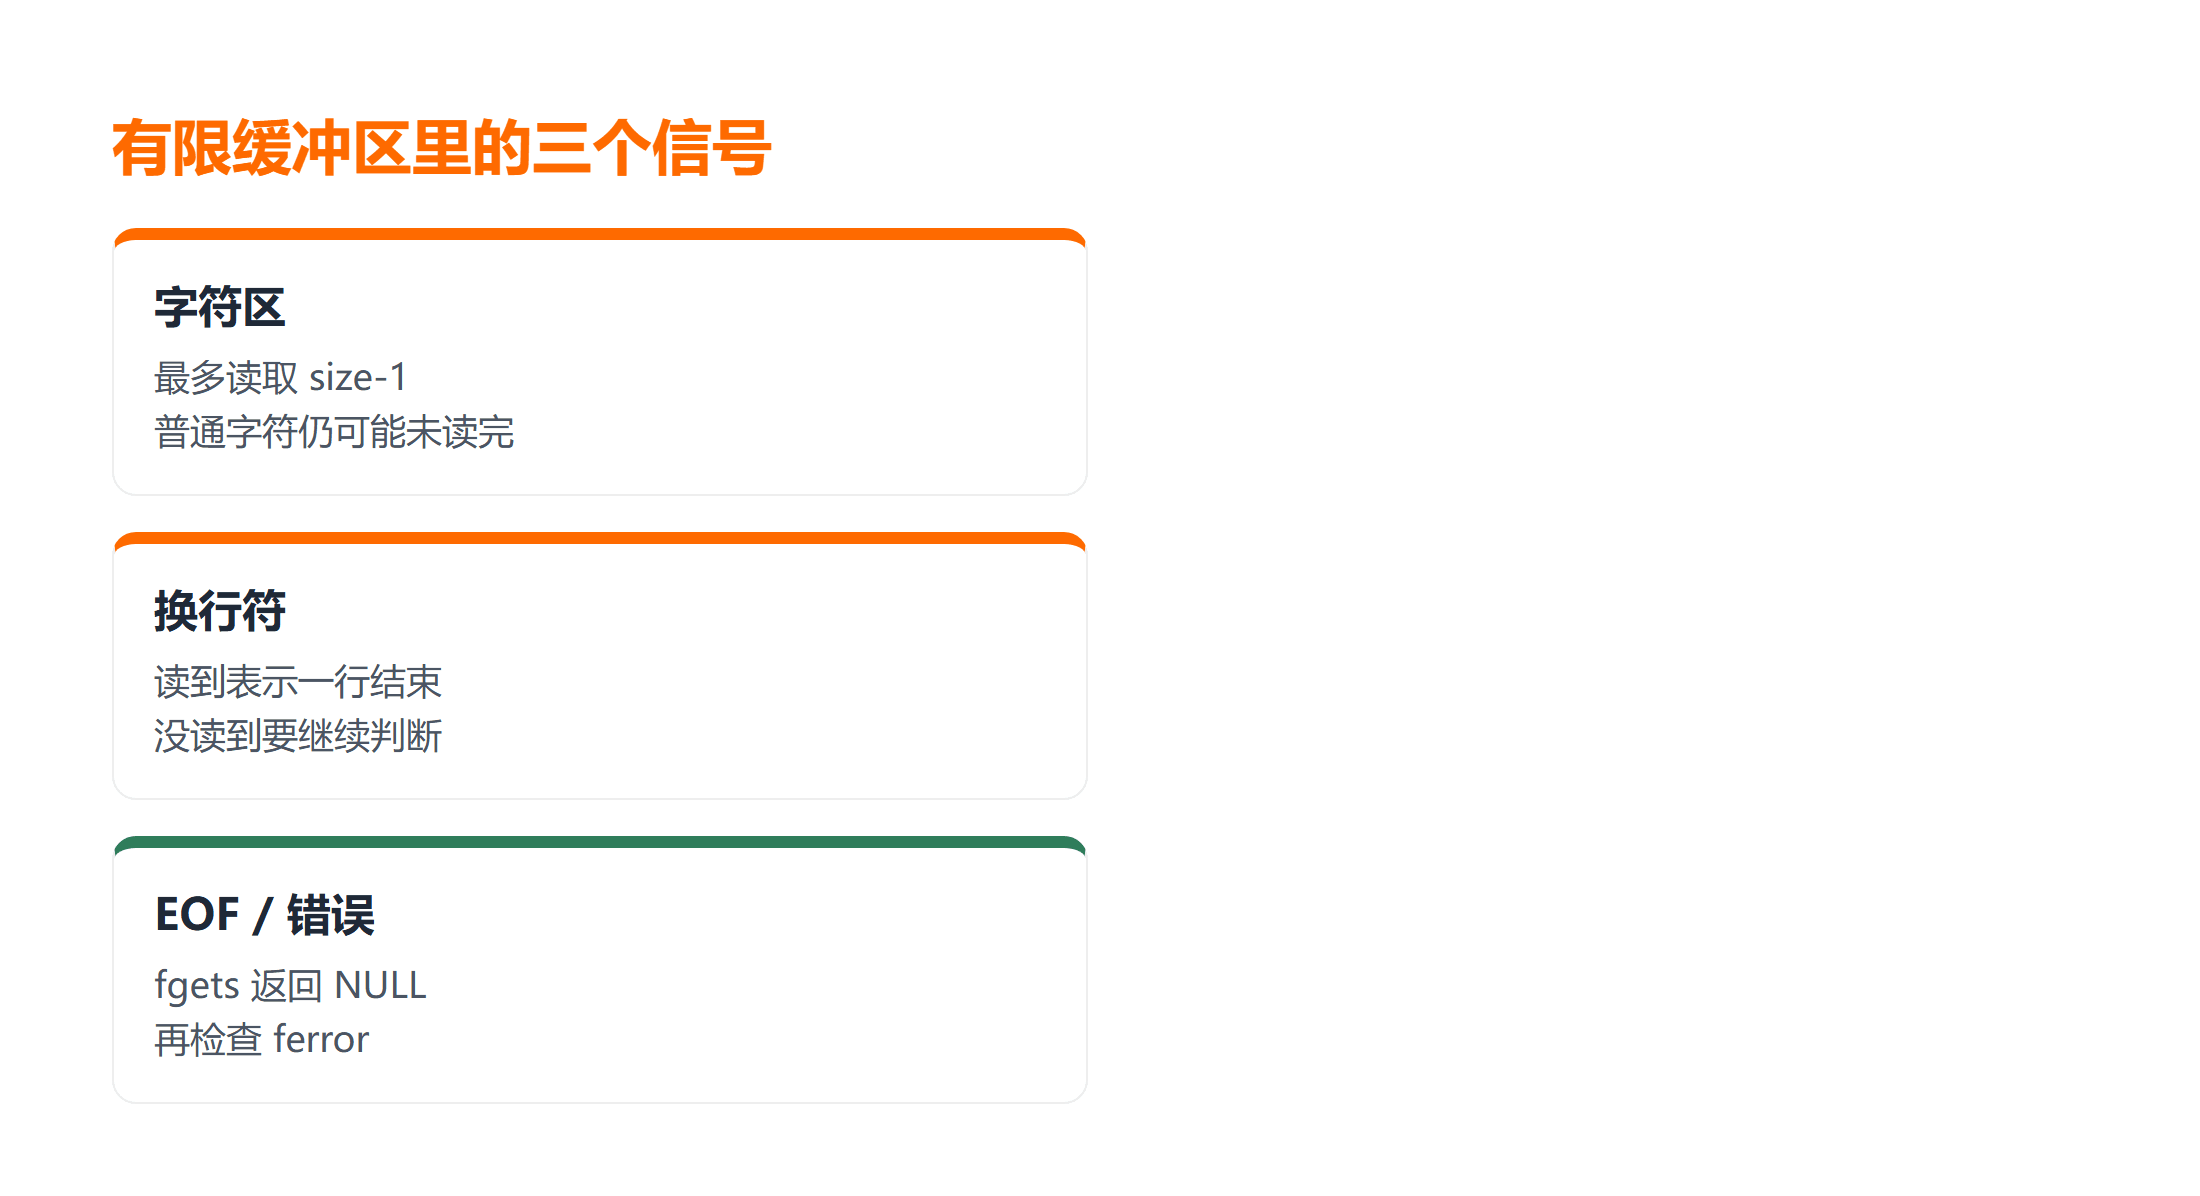
fgets最多读取size-1个字符,并在末尾写入\0;如果提前遇到换行,也会把换行写入数组。数组长度小于整行时,第一次调用只得到前半段。不要把“返回非NULL”理解成完整读取。
如果需要补齐基础概念,可先阅读C 语言教程,再回到下面的示例核对结果。
#include <stdio.h>
#include <string.h>

char buf[8];
if(fgets(buf,sizeof buf,stdin)){ printf("len=%zu last=%d\n",strlen(buf),(unsigned char)buf[strlen(buf)-1]); }
fgets最多读取size-1个字符,并在末尾写入\0;如果提前遇到换行,也会把换行写入数组。打印最后一个字符的数值,能区分换行、普通字符和空字符串。
二、用换行判断是否发生截断
如果strlen大于0且最后一个字符是换行,说明这一段包含行尾;否则需要继续读取直到遇到换行或EOF。输入刚好填满数组时,末尾可能是普通字符,下一次读取仍会拿到剩余部分。
int ch;
size_t n=strlen(buf);
if(n && buf[n-1]=='\n') puts("完整一行");
else { while((ch=getchar())!='\n' && ch!=EOF){} puts("清理剩余输入"); }
如果strlen大于0且最后一个字符是换行,说明这一段包含行尾;否则需要继续读取直到遇到换行或EOF。清理剩余输入后再读取下一项,避免把上一行尾巴当成下一项。
三、空行和EOF要单独处理
空行可能只包含一个换行符,不能用buf[0]是否为0判断;EOF时fgets返回NULL,可能发生在文件末尾或读取错误。交互程序应给出结束提示,批处理程序应检查ferror区分错误和正常结束。
如果需要补齐基础概念,可先阅读C++ 教程,再回到下面的示例核对结果。
char line[32];
while(fgets(line,sizeof line,stdin)){
  if(line[0]=='\n') puts("空行");
  else printf("%s",line);
}
if(ferror(stdin)) perror("stdin");
空行可能只包含一个换行符,不能用buf[0]是否为0判断;EOF时fgets返回NULL,可能发生在文件末尾或读取错误。把空输入、空行和EOF写成三个测试,名称不要混用。
四、不要依赖fflush(stdin)
fflush对输入流的行为不适合作为跨平台清理方案。读取字符并丢弃到换行或EOF,虽然代码稍长,却能表达真正的边界。更复杂的程序可以封装read_line函数,返回完整性和错误状态。
int discard_line(void){int c; while((c=getchar())!='\n' && c!=EOF){}
  return c==EOF?0:1;}
fflush对输入流的行为不适合作为跨平台清理方案。函数返回值告诉调用者是遇到换行还是EOF,调用者再决定是否继续。
五、边界测试与排错记录
输入空行、短于7字符、刚好7字符、超过31字符和文件末尾无换行的文本。每次记录fgets返回值、strlen和末尾字符;超长行必须明确标记并清理剩余字符,下一次读取不能出现上一行内容。用重定向文件测试EOF,再用终端测试交互行为,二者都要检查ferror。
在“C 语言 fgets 读不完整怎么办?分清换行、截断与剩余输入”这个问题上,把测试结果按“输入、实际输出、预期输出、结论”记录下来;出现失败时保留原始错误和运行环境,不要只截取最后一行。输入流和缓冲区有自己的边界,返回值、长度、换行和 EOF 要一起记录,不能只凭屏幕上的一行文字判断。
常见误区与选择建议
不要用scanf后直接接fgets却不处理残留换行;不要访问空字符串的最后一个字符;不要把数组长度写死在函数外而不传入;不要用fflush(stdin)作为通用清理;不要把超长行静默截断后继续提交。
落地检查清单
- 为C 语言 fgets准备一份最小正常输入和一份已知失败输入,先固定环境再比较结果。
- 检查输入缓冲区的边界,明确哪些情况应接受、拒绝或继续排查。
- 记录换行符的判断依据,避免错误被默认值、静默重试或格式化输出掩盖。
- 回归时一次只改一个变量,并把失败样例保留在测试目录。
- 交接时写明版本、命令、输入、输出和已知限制,让下一位维护者能复现结论。
- 对照正常输出与失败输出,确认错误信息能指出具体字段、路径、版本或状态,而不是只返回“失败”。
- 若规则发生变化,先更新样例和预期结果,再修改实现,避免测试通过但验收标准已经悄悄改变。
- 最后记录哪些情况尚未覆盖,把它们列为待确认项,不用默认值替代未知结论。
动手练习
- 先运行正文中的正常样例,保存完整输出。
- 只改变C 语言 fgets相关的一个输入,确认失败位置符合预期。
- 再改变输入缓冲区,比较错误信息是否仍然可定位。
- 关闭一项校验或配置,确认测试能够主动失败。
- 恢复配置并重跑,检查结果是否回到基线。
- 把一次失败记录整理成可交接的复现步骤。
- 将尚未覆盖的边界加入下一轮回归清单。
结果怎么判读
- 输出符合预期且日志完整:记录为通过,并保留输入样例。
- 输出不符合预期但错误位置清楚:记录为可修复失败,先定位规则。
- 输出看似成功但缺少关键字段:不能放行,补充边界校验。
- 同一输入在不同环境结果不同:先比较版本、配置和依赖。
- 修改后正常样例通过、失败样例消失:优先检查错误是否被吞掉。
- 只有把C 语言 fgets、输入缓冲区和换行符的证据一起保存,结论才适合交接。
总结
fgets的关键是识别换行和截断。检查返回值、长度和末尾字符,按需清理剩余输入,把空行、EOF和读取错误分开处理,才能让下一次读取可靠。
延伸学习
- C 语言 fgets基础:C 语言入门课程
- Python 3 教程
- C 语言实践笔记
常见问题
Q:为什么fgets结果末尾有换行?
A:因为它会在空间允许时把输入的换行一并放入缓冲区,需按业务决定是否移除。
Q:超长输入应该截断还是拒绝?
A:交互表单通常应提示超长并拒绝;日志或流处理可分段读取,关键是不能静默当成完整一行。