
 TRAE-AI编程

智能体审查指的是让 AI 在你提交代码前先做一遍自动检查,重点看改动是否引入明显缺陷。先给结论:在 TRAE 里配置智能体审查,不是找一个开关打开就行,而是要先确认审查范围、规则来源和触发时机这三件事,否则很容易出现审查结果泛泛而谈、或每次提交都跑一遍拖慢节奏的问题。本文按"先确认、再配置、后验证"的顺序,给出一套可复用的最小流程:从规则文件怎么写、审查任务怎么描述,到输出怎么验收、失败怎么排查,每一步都说明适用边界。根据文档整理的配置思路,对同类 AI 编程工具同样适用。
一、最小场景:先确认审查到底审什么
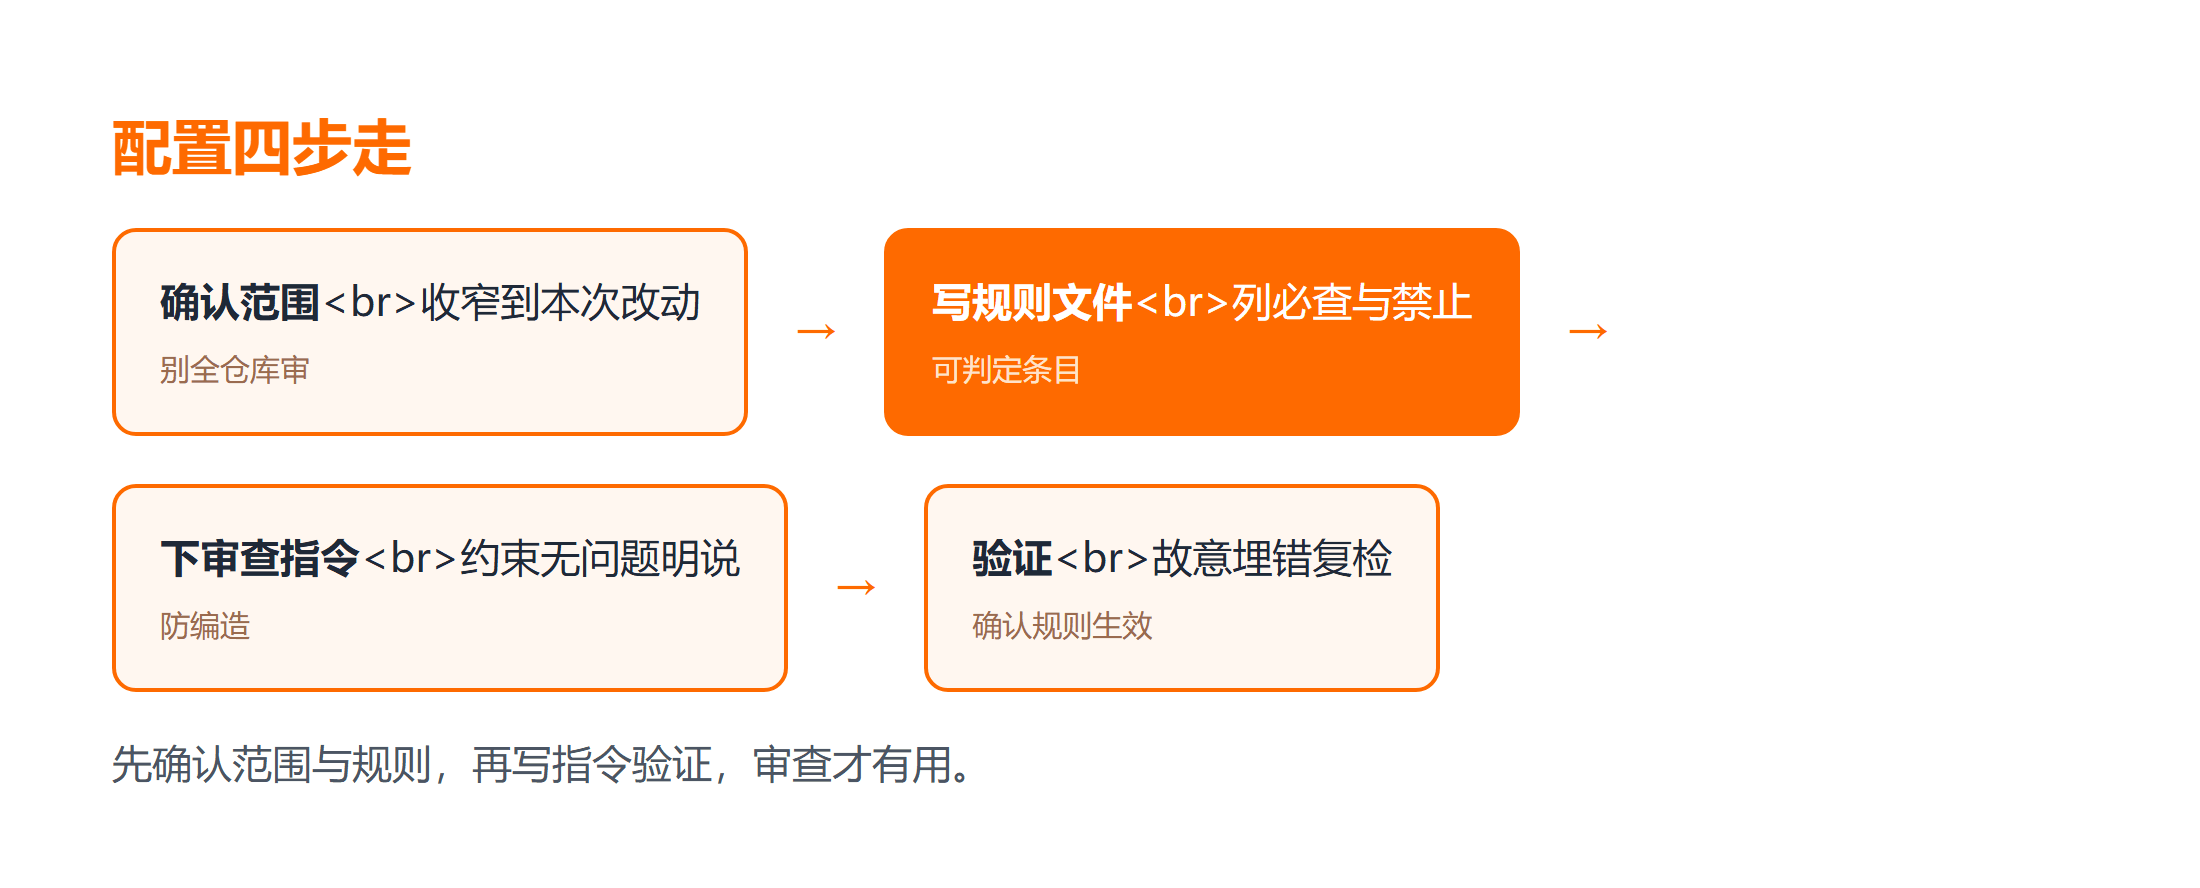
配置之前,先把审查任务收窄到一个可验证的场景。推荐的最小场景是:只审查本次改动的 Python 文件,检查三类问题——语法错误、明显的空指针风险、以及是否绕过了既定的错误处理约定。把它写清楚,比"帮我审查代码"这种宽泛指令有用得多。
为什么强调"本次改动"?因为全仓库审查的输出会非常长,AI 容易在无关代码里找问题,反而淹没真正的风险。限定到改动文件,既省 Token,也让结果可核对。这一步对应的是审查范围,属于必须先确认的第一件事。
第二件要确认的是规则来源。审查依据最好落成一份项目内的规则文件,让团队每个人、每次审查都用同一套标准,而不是靠各自临场发挥。第三件是触发时机:是每次保存都审,还是提交前手动触发一次?初学者建议先用手动触发,确认结果稳定后再考虑自动化。
这三件事没确认就动手,最常见的后果是审查结果看起来很热闹,却对实际提交没有帮助。想补一点智能体能力的背景,可以了解 智能体技能中文教程 里对任务边界的说明。
二、最稳实现:用规则文件加一次性审查任务
最稳的做法分两部分:一份固定规则文件,加一条明确的审查指令。
规则文件不必复杂,把项目的技术栈、必须遵守的约定、明确禁止的做法列出来即可。下面是一份可直接改用的最小示例,保存为项目根目录下的规则文件:
# 审查规则
- 技术栈:Python 3.10 + Django 后台管理系统
- 必查项:异常处理是否完整、数据库查询是否可能返回空
- 禁止项:不要用裸 except 吞掉异常;不要在循环里做逐条查询
- 输出格式:按文件列出问题,每条给出行号、原因、修复建议
指令要交代输入、范围和输出格式。一条能直接用的审查指令如下:
请审查我本次改动的 Python 文件,只依据项目规则文件里的必查项和禁止项。
按文件列出发现的问题,每条给出行号、原因和修复建议。
没有发现问题时明确回答"未发现符合规则的问题",不要虚构问题。
注意最后一句"没有问题时明确回答",这是防止 AI 为凑内容编造问题的关键约束。把规则文件的路径在对话里明确引用,让审查有据可依。如果团队里不同机器想用不同严格级别,可以把规则文件路径写进环境变量,让脚本启动时读取,换机器也不用改配置代码。
配置完成后,先用一个故意埋了问题的改动做验证:比如在一个函数里留下裸 except。预期结果(未在本机执行):审查应当指出这个 except 违反禁止项,并给出行号。如果它没发现,说明规则文件没被读到,需要检查引用路径。
期间如果要核对命令或路径是否写对,可以用 Git 速查手册 确认改动范围的相关命令。
三、替代方案与取舍
规则文件加一次性审查是最稳的起点,但不是唯一方式。三种常见做法的取舍如下。
| 做法 | 适用场景 | 优点 | 代价 |
|---|---|---|---|
| 规则文件 + 手动审查 | 初次上手、团队规则未统一 | 可控、结果易核对 | 每次要手动触发 |
| 内置审查模式 | 追求省事、规则较通用 | 配置少、上手快 | 难以贴合项目专属约定 |
| 提交前自动化审查 | 规则已稳定、团队固定 | 不漏检、口径一致 | 初期误报多、需要调规则 |
对绝大多数刚接触智能体审查的读者,建议从第一行开始,等规则稳定、误报可控后再考虑第三行。直接上自动化,往往会因为规则没调好而被误报淹没,最后干脆关掉,等于白配置。
取舍的核心 judgment 是:审查的边际收益是否大于它带来的噪声。如果一次审查只找出无关痛痒的命名建议,却花掉几分钟 Token,那不如先完善规则文件,把注意力集中到真正的高风险项上。
四、反例、边界与常见失败
把高频失败集中排查,每一条都给出判断依据和修复方式。
- 审查结果全是泛泛而谈:多半是没给规则文件,或规则写得太空。修复方式是把必查项写成可判定的句子,比如"数据库查询是否判空",而不是"注意代码质量"。
- AI 编造不存在的问题:这是没有约束"无问题就明说"导致的。补上那条输出约束,再跑一次验证。
- 规则文件没生效:检查对话里是否真的引用了文件路径。有些情况下路径要写相对项目根的路径,写错就读不到。这是配置环节最容易踩的坑。
- 每次审查输出过长:审查范围没收窄,或没要求按文件分段。限定到本次改动、要求条目化输出即可收敛。
- 性能与成本边界:智能体审查要消耗模型调用,改动越大越贵。建议在小改动上先跑通流程,确认输出可用,再逐步扩大范围;大仓库全量审查要单独评估开销,别默认天天跑。
- 版本与适用边界:不同版本的 TRAE 在规则文件的入口和命名上可能有差异,本文讲的是通用思路,具体文件名以你使用的版本为准。想核对当前版本的功能入口,可以翻 TRAE 编程中文教程。规则文件的写法本身与工具无关,换工具也能复用。
⚠️ 注意:智能体审查是辅助手段,不能替代代码评审和测试。它擅长发现符合明确规则的问题,对业务逻辑正确性判断有限。把可疑点交给人工确认,才是稳妥的闭环。顺手把代码格式化做在提交前,可以减少风格类噪声,让审查更聚焦。
总结
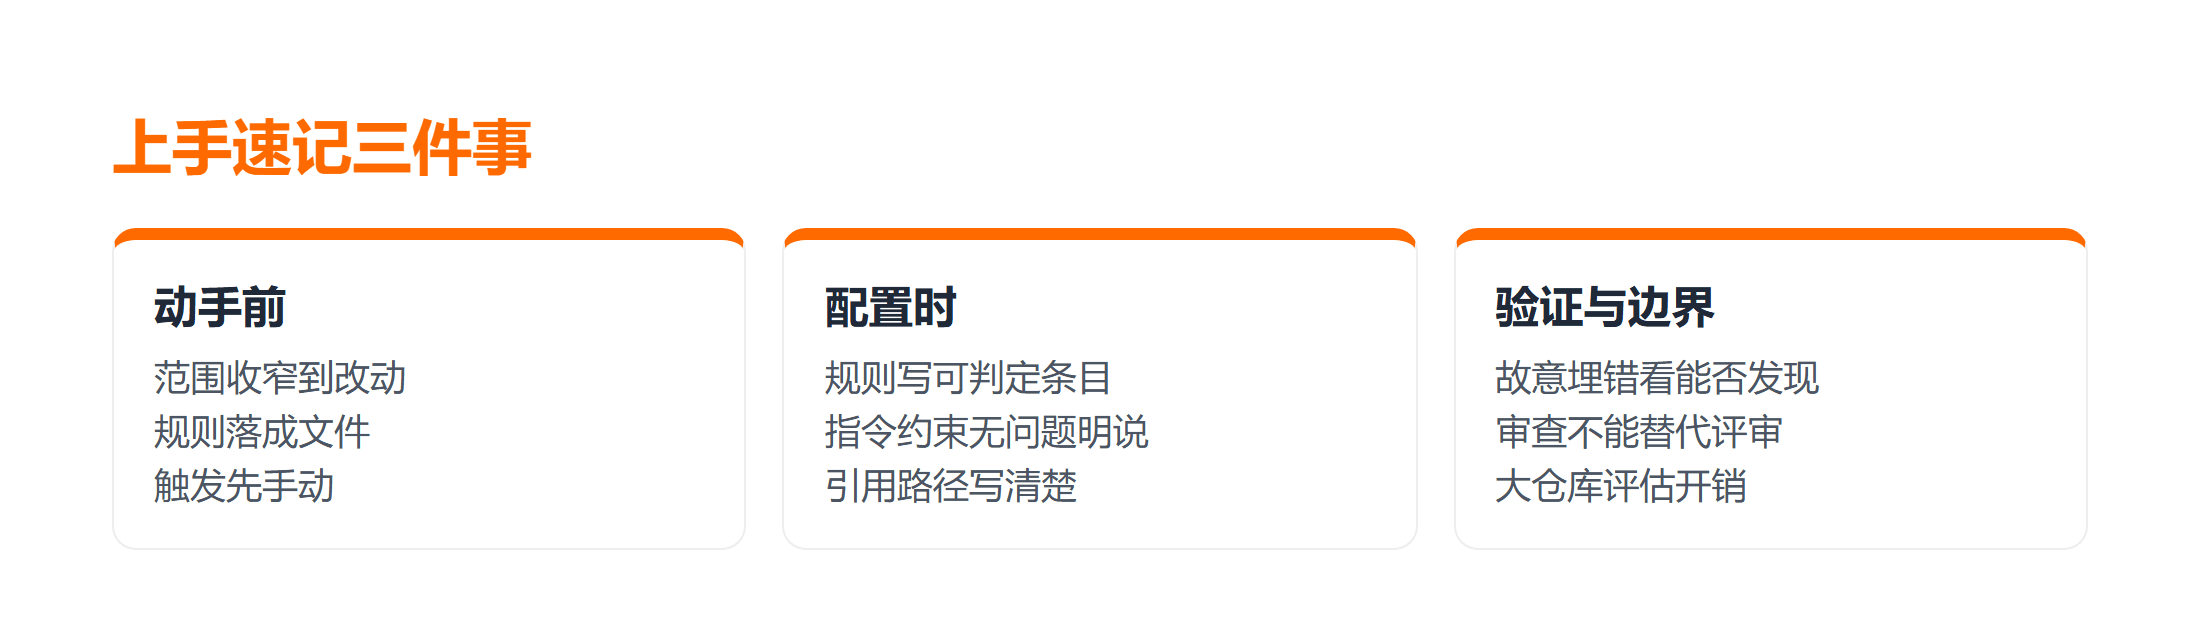
在 TRAE 里配置智能体审查,关键不在开关,而在动手前确认三件事:审查范围收窄到本次改动、审查依据落成项目规则文件、触发时机先从手动开始。落地时用"规则文件 + 一次性审查任务"这个最稳组合,并在指令里约束"无问题就明说",避免 AI 编造问题。配置完用一个故意埋错的改动验证,确认规则真的生效,再考虑自动化。记住审查是辅助,结论要人工复核。
要点带走:
- 先确认范围、规则、时机,再动手配置;
- 规则文件写成可判定条目,别写空话;
- 指令里约束无问题明说,防编造;
- 从手动触发起步,规则稳定后再谈自动化。
常见问题
Q:审查结果总是泛泛而谈怎么办?
A:多半是没给规则文件或规则太笼统。把必查项改成能判定真假的句子,并在对话里明确引用规则文件路径,再跑一次验证。
Q:智能体审查能替代人工代码评审吗?
A:不能。它适合发现符合明确规则的问题,对业务逻辑和架构权衡的判断有限。把它当第一道筛子,关键结论仍需人工确认。
Q:每次审查都很慢、很贵,正常吗?
A:审查成本和改动范围正相关。先限定到本次改动的小文件,确认流程可用后再扩大范围;大仓库全量审查要单独评估开销。
延伸学习
- 想系统学一遍 AI 开发,可以了解 TRAE AI 开发 Python Django 后台管理系统;
- 想看配置类问题的排错经验,翻 Java的三个环境变量:如何配置好Java的运行环境 这篇笔记;
- 提交前想统一代码风格,可以试试 Python代码格式化。



