 免费 AI IDE

pytest 参数化测试用 @pytest.mark.parametrize 把多组输入和预期结果展开成独立用例;用 ids 给失败报告可读名称,用 pytest.param 为单组数据添加标记,只有数据必须交给 fixture 构造或清理时才使用 indirect。参数化的目标是减少重复测试代码,同时让每个边界值仍然可以单独定位。
本文基于 pytest stable 文档与 Python 3.12,从一个价格计算函数开始,依次覆盖正常值、异常值、自定义 pytest ids、indirect fixture、收集检查和失败定位。所有示例可放进同一个 test_price.py,运行前先确认 python -m pytest --version 能找到当前环境中的 pytest。
一、先看结论:四个工具各管什么
| 工具 | 作用 | 典型写法 | 适用场景 |
|---|---|---|---|
parametrize |
把多组数据展开成独立用例 | @pytest.mark.parametrize("a,b", [...]) |
正常值、边界值批量测试 |
ids |
给每组数据起可读名称 | ids=["normal", "zero"] |
失败报告定位 |
pytest.param |
为单组数据添加标记 | pytest.param(..., id=..., marks=...) |
异常用例、xfail、自定义标记 |
indirect |
把参数交给 fixture 构造 | indirect=True |
临时文件、数据库记录、客户端 |
--collect-only |
只收集不运行 | pytest --collect-only -q |
检查节点数量和名称 |
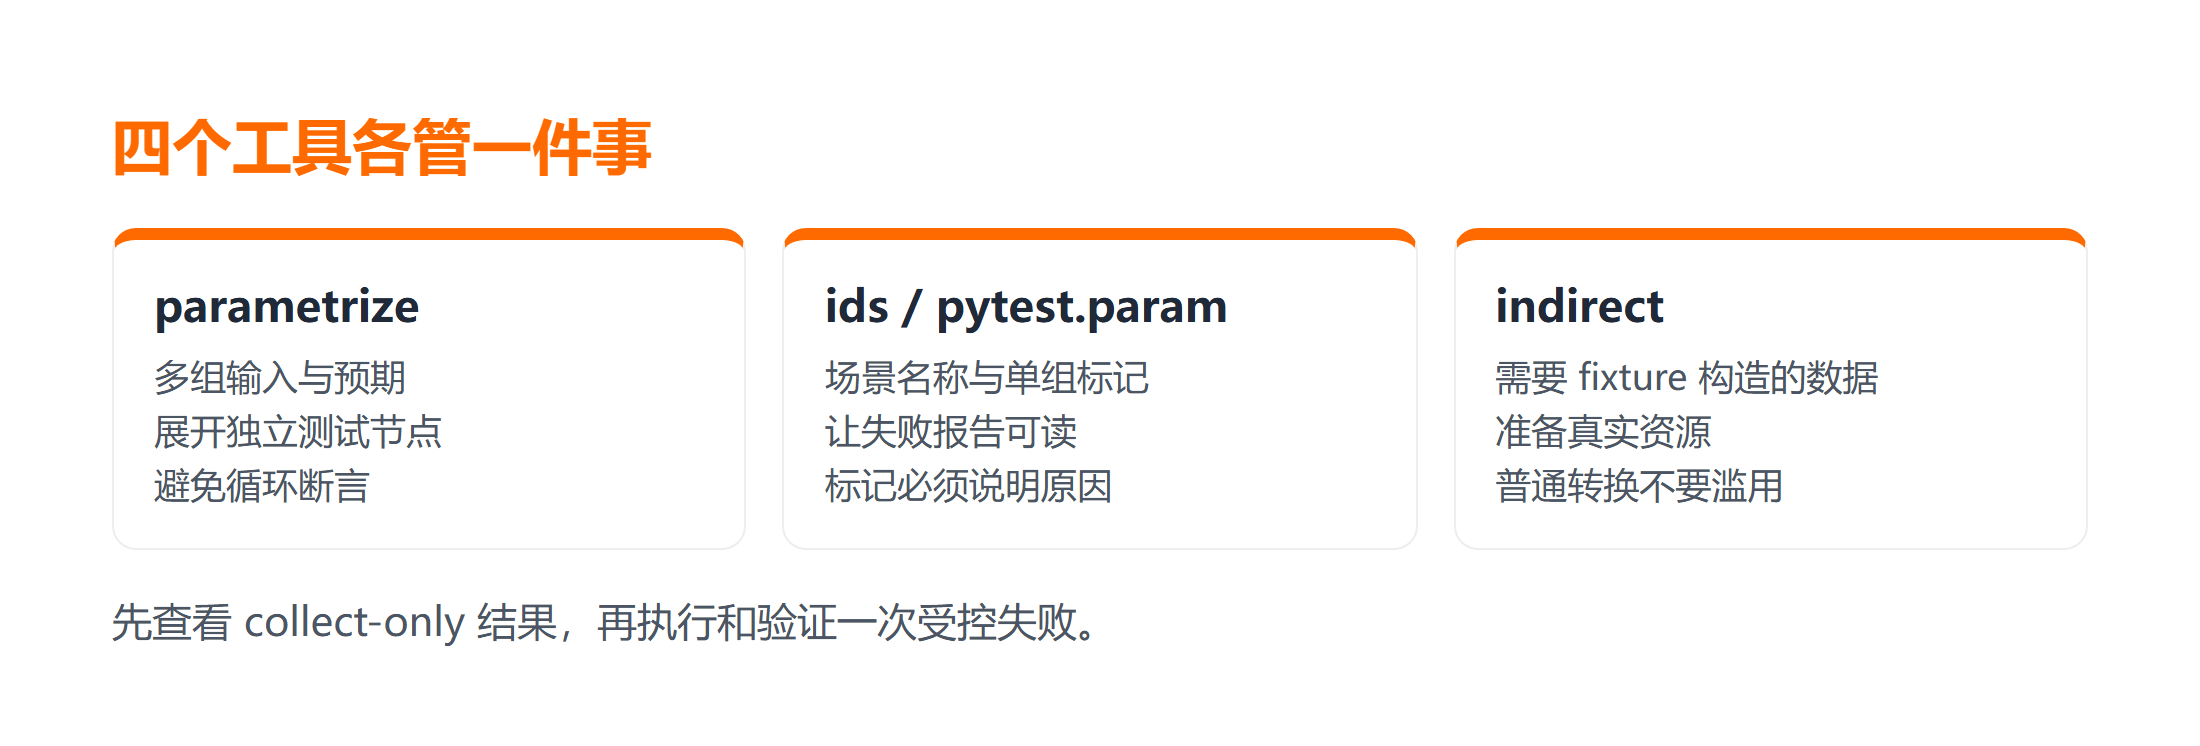
一句话:parametrize 管数据,ids 管可读性,pytest.param 管单组标记,indirect 管环境构造。
二、把重复断言改成多组数据
若还不熟悉测试发现和 fixture,可先看 pytest 教程;下面先保持依赖最小,只测试一个纯函数。
import pytest

def total(price: int, count: int) -> int:
    # 价格和数量都不允许为负数
    if price < 0 or count < 0:
        raise ValueError("price and count must be non-negative")
    return price * count

@pytest.mark.parametrize(
    "price,count,expected",
    [
        (10, 2, 20),  # 正常价格
        (0, 5, 0),    # 零价格
        (7, 3, 21),   # 奇数价格
    ],
    ids=["normal", "zero-price", "odd-price"],  # 失败报告显示业务名称
)
def test_total(price, count, expected):
    # 每组数据独立断言
    assert total(price, count) == expected
执行:
# 运行当前目录下的 pytest
python -m pytest -q
每组数据会成为独立节点。pytest ids 让失败报告显示 normal、zero-price 等业务含义,而不是难读的参数序号;ID 应描述场景,不要把完整输入复制一遍。
| 写法 | 失败报告 | 定位效率 |
|---|---|---|
| 无 ids | test_total[10-2-20] |
需要对照参数 |
| 有 ids | test_total[normal] |
一眼看出业务场景 |
| 循环断言 | 只显示一个测试 | 无法单独定位 |
如果暂时没有第三方插件,预期结果应是 3 passed。故意把第三组 expected 改为 20,应只失败 odd-price 一项,这正是参数化比循环断言更容易定位的地方。确认后恢复期望值,避免把故意失败留进提交。
装饰器和异常语法可在结果通过后再用 Python3 教程 补充,不要在排错时同时改语言基础和测试结构。
提交前再执行一次:
# 只收集用例,不运行
python -m pytest --collect-only -q
保存收集到的节点数量与名称。若新增一组数据却意外多出几十个节点,通常是叠加参数化形成了笛卡尔积;若节点减少,则要检查装饰器参数、跳过标记和测试发现路径。
三、异常用例使用 pytest.param
@pytest.mark.parametrize(
    "price,count",
    [
        # 用 pytest.param 给这一组数据单独命名
        pytest.param(-1, 2, id="negative-price"),
    ],
)
def test_total_rejects_negative(price, count):
    # 断言抛出 ValueError,并匹配错误信息
    with pytest.raises(ValueError, match="non-negative"):
        total(price, count)
不要把正常结果与异常断言硬塞进同一分支。测试目的不同就拆函数,失败信息更直接。
| 测试目的 | 推荐写法 | 说明 |
|---|---|---|
| 正常返回值 | assert total(...) == expected |
同一函数多组数据 |
| 抛出异常 | pytest.raises(...) |
单独测试函数 |
| 标记某组数据 | pytest.param(..., marks=...) |
xfail、skip 等 |
| 长期失败 | xfail 并写明原因 |
不能掩盖未知失败 |
pytest.param 还可以只给某一组加 marks=pytest.mark.xfail(...) 或自定义标记,但 xfail 必须写明原因;不能用它长期掩盖未知失败。
四、indirect 只用于交给 fixture 构造
import pytest

@pytest.fixture
def user(request):
    # request.param 接收 parametrize 传入的数据
    return {"name": request.param, "active": True}

@pytest.mark.parametrize(
    "user",
    ["alice", "bob"],
    indirect=True,  # 把参数交给同名 fixture
)
def test_user_active(user):
    # fixture 已经构造好 user 字典
    assert user["active"] is True
indirect 会把参数送到同名 fixture 的 request.param。普通数值转换不需要 indirect,否则读者要跨文件追踪数据。Python 速查手册 可用于核对集合语法。
| 参数类型 | 是否需要 indirect | 说明 |
|---|---|---|
| 普通数值、字符串 | 不需要 | 直接传给测试函数 |
| 需要临时文件 | 需要 | fixture 负责创建和清理 |
| 需要数据库记录 | 需要 | fixture 负责准备和回滚 |
| 需要客户端实例 | 需要 | fixture 负责连接和关闭 |
更真实的 indirect fixture 往往会创建临时文件、数据库记录或客户端,并在 yield 后清理。只有 fixture 真正承担环境准备时才值得增加这层间接关系:
import pytest

@pytest.fixture
def csv_file(tmp_path, request):
    # 根据 parametrize 传入的数据创建临时 CSV 文件
    path = tmp_path / request.param["name"]
    path.write_text(request.param["content"], encoding="utf-8")
    return path

@pytest.mark.parametrize(
    "csv_file",
    [
        # 空文件场景
        {"name": "empty.csv", "content": ""},
    ],
    indirect=True,
    ids=["empty-file"],
)
def test_csv_file_exists(csv_file):
    # 验证 fixture 已成功创建文件
    assert csv_file.exists()
这里的 indirect fixture 把“测试数据”转换成“真实临时文件”。直接传路径字符串无法完成同样的准备工作,因此间接参数化有明确价值。
五、收集失败先查参数形状
参数名数量必须与每组值长度一致;fixture 名拼错、重复参数化同一名称、空参数集配置也会在收集阶段失败。先运行 pytest --collect-only -q,确认节点名称,再执行测试。
| 收集失败现象 | 常见原因 | 修复方向 |
|---|---|---|
| 参数数量不匹配 | 参数名与值长度不一致 | 对齐名称与每组数据 |
| fixture 找不到 | fixture 名拼错或未定义 | 检查 fixture 作用域与名称 |
| 重复参数化同一名称 | 多个装饰器参数同名 | 合并或重命名 |
| 空参数集 | 数据列表为空 | 明确 skip 或补数据 |
| 节点数量异常 | 叠加参数化形成笛卡尔积 | 用 --collect-only 检查 |
失败用例应保留完整 traceback,不要只截最后一行。
参数化也有适用边界:
| 边界 | 风险 | 建议 |
|---|---|---|
| 数据达到数百组 | 收集时间和报告体积增长 | 只保留真正改变行为的边界值 |
| 依赖外部文件 | 测试输入悄悄变化 | 固定文件版本与字段 |
| 不同 Python/pytest 版本 | 空参数集和节点 ID 显示不同 | 固定 CI 版本 |
| 性能测试 | 混进普通断言 | 交给专门基准工具 |
六、组合参数时控制用例规模
叠加两个 parametrize 装饰器会生成笛卡尔积。三个浏览器乘四种权限再乘五组输入,就是 60 个节点;如果这些组合没有不同业务行为,只会增加运行时间与噪声。可以先列出真正需要覆盖的风险组合,再用成对数据表达。
import pytest

@pytest.mark.parametrize(
    "role,allowed",
    [
        ("admin", True),   # 管理员可以发布
        ("editor", True),  # 编辑可以发布
        ("guest", False),  # 访客不能发布
    ],
    ids=["admin", "editor", "guest"],
)
def test_can_publish(role, allowed):
    # 根据角色判断是否有发布权限
    assert (role in {"admin", "editor"}) is allowed
需要完整组合时,在代码评审中说明原因,并用:
# 查看最终节点数量
pytest --collect-only -q
数据来自 JSON 或 CSV 时,要验证文件版本、必需字段和空数据行为;否则外部数据一改,测试集合也会在无人注意时变化。
七、用失败实验验证报告是否真的可读
交付前做一次受控失败:
| 步骤 | 操作 | 预期结果 |
|---|---|---|
| 1 | 只把一个期望值改错 | 制造最小失败 |
| 2 | 执行 python -m pytest -q -vv |
输出节点 ID、输入和断言差异 |
| 3 | 恢复代码再次运行 | 全部通过 |
| 4 | 保存报告样例 | 确认可读性 |
这个步骤能发现重复 ID、过长对象 repr 和把全部数据塞进一个测试循环等问题。
若用例在收集阶段失败,先看装饰器参数数量与 fixture 名;若运行阶段失败,再看断言与准备数据。两类问题不要混在一起排查。CI 中还应保存完整测试报告,不能只截取最后一行“1 failed”。
八、ID 命名与数据隔离
多人项目还要约定 ID 命名。建议使用 条件-预期 或清楚的业务短语,例如:
| 推荐 ID | 不推荐 ID | 原因 |
|---|---|---|
empty-cart-zero |
case1 |
看不出场景 |
expired-token-rejected |
test2 |
无法定位边界 |
negative-price |
-1-2 |
输入不等于场景 |
guest-cannot-publish |
guest-false |
业务含义更清楚 |
包含对象时不要直接用默认 repr 生成超长节点名;可以传入 ids 函数,只抽取稳定字段。
当同一组数据需要在多个测试模块复用时,可放进普通 Python 常量或工厂函数,但不要为了“数据驱动”立即引入外部表格。外部文件增加了路径、编码、版本和字段校验成本,只有非开发人员需要维护或数据量确实较大时才值得使用。
最后检查参数之间是否独立。把可变列表或字典作为参数传入后,测试若原地修改它,后续用例可能看到污染后的状态。可在 fixture 中复制数据,或让生产函数返回新对象。参数化减少重复代码,但不会自动隔离共享可变对象。
| 共享可变对象风险 | 表现 | 修复方向 |
|---|---|---|
| 列表被原地修改 | 后续用例看到污染数据 | fixture 中复制 |
| 字典被修改 | 断言结果不稳定 | 返回新对象 |
| 全局状态 | 用例顺序影响结果 | 每个用例独立准备 |
总结
pytest 参数化测试的价值是让每组输入独立、可定位。parametrize 管数据,pytest ids 管可读性,pytest.param 管单组标记,indirect fixture 管环境构造;职责分开后,测试既比复制多个函数简洁,也不会退化成一个难以定位的循环。最终要用收集结果和一次受控失败验证报告质量。
延伸学习
- pytest 用例执行方法 补运行选项;
- pytest 与 unittest 对比 帮你选择测试框架。
常见问题
Q:ids 会影响测试逻辑吗?
A:不会,它只改变节点显示名称,便于报告定位。
Q:参数组合会自动做笛卡尔积吗?
A:同一装饰器按行取值;叠加多个 parametrize 装饰器时会形成组合,应控制用例数量。
Q:什么时候不要用 indirect?
A:参数可直接传给测试函数时不要用。只有 fixture 必须参与准备或清理时再启用。