
 TRAE-AI编程

把 OpenClaw 本地部署的模型接到编辑器里,核心价值是「代码不离机、响应还快」:模型跑在你自己的机器或内网服务器上,编辑器只负责把请求发到本地端点。但新手最常卡在三处:本地服务没起来、编辑器里的端点或模型名写错、API 密钥对不上。本文从零讲清一套完整步骤:先把 OpenClaw 本地部署跑通,再把编辑器指向它的端点,最后用一次真实请求验证链路。照着走,基本一次就能接上。
先看结论
OpenClaw 本地部署模型对接编辑器的关键,是让两端「说同一种协议」。第一,先在本地把模型服务跑起来,确认它暴露的是一个 OpenAI 兼容的 HTTP 端点(通常形如 http://127.0.0.1:8080/v1)。第二,在编辑器/IDE 的 AI 插件配置里,把 base_url 指向这个端点、model 填你加载的模型名、api_key 填本地约定的占位串。第三,发一条测试请求验证能通。只要端点、模型名、密钥三处对齐,编辑器就能顺畅调用本地模型,不必每次走公网。
适用边界:本文以单机上「OpenClaw 本地部署 + 编辑器 AI 插件」为主,不涉及多卡集群、量化参数调优,也不涉及把服务暴露到公网的安全加固。OpenClaw 的底层 provider 可参考 OpenClaw 提供商 OpenCode。在动手对接前,建议先理解 provider 在 OpenClaw 里的角色:它是一层模型能力的封装,屏蔽了不同模型在请求格式与采样参数上的差异,让上层编辑器只用关心「发一段对话、收一段回复」,换模型通常也只是改配置而非改代码。它把模型能力抽象成可替换的 provider,编辑器通过标准协议调用,不绑定某一家模型。系统知识可看 OpenClaw 中文教程。本地部署最大的好处是数据不出机:代码、日志与上下文都留在你自己的机器或内网,适合对隐私和延迟都有要求的团队。
一、先确认:OpenClaw 本地部署的服务已经起来
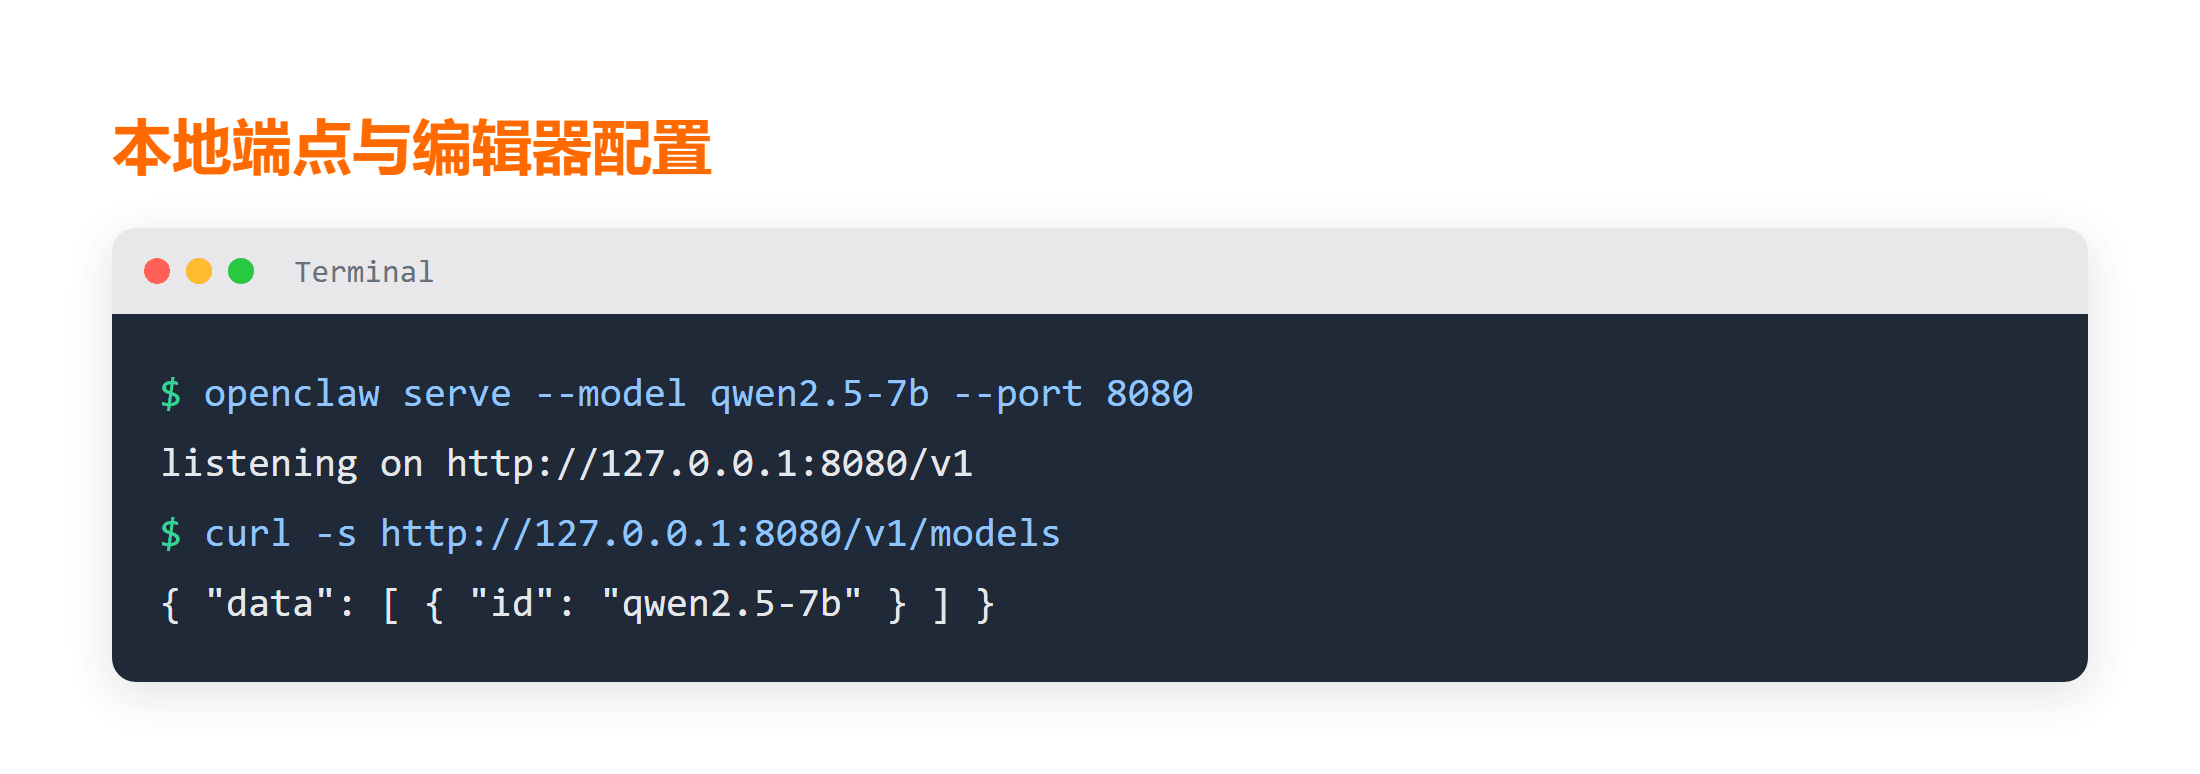
对接前第一步,是确认本地模型服务真的在监听。先启动 OpenClaw 并加载一个模型,再确认它暴露了兼容端点:
# 启动 OpenClaw 本地部署(具体子命令以你安装的版本为准)
openclaw serve --model qwen2.5-7b --port 8080
# 另开一个终端,确认端点能响应
curl -s http://127.0.0.1:8080/v1/models
预期结果(未在本机执行):curl 返回一段 JSON,里面列出已加载的模型名,说明服务已就绪。失败处理:若连接被拒,先确认进程是否真的在跑、--port 端口是否被占用,再检查防火墙是否拦了本地回环。关于编辑器侧的快捷键与操作,Emacs 速查手册 可作为对照参考(不同编辑器配置入口不同,但端点思路一致)。
二、在编辑器里填写端点、模型名与密钥
第二步,打开编辑器里 AI 插件的设置,把三项填对,尤其是 base_url 这个配置端点必须指向本地服务。多数插件接受一份 JSON 配置:
{
  "openclaw": {
    "base_url": "http://127.0.0.1:8080/v1",
    "api_key": "local-dev-key",
    "model": "qwen2.5-7b"
  }
}
这里最容易错的是 model 字段:它必须和第一步 curl 返回的模型名完全一致,多一个空格都不行。预期结果(未在本机执行):保存配置后,插件状态从「未连接」变为「已连接」,说明编辑器对接成功。关于把本地模型能力接进通用 AI 开发流的思路,DeepSeek 中文教程 里也有相通的配置范式可借鉴。
三、用一次真实请求验证整条链路
第三步,不要只看「已连接」就完事,发一条真实请求验证端到端通了:
# 用 OpenAI 兼容 SDK 指向本地端点,验证链路
from openai import OpenAI

client = OpenAI(
    base_url="http://127.0.0.1:8080/v1",
    api_key="local-dev-key",
)
resp = client.chat.completions.create(
    model="qwen2.5-7b",
    messages=[{"role": "user", "content": "用一句话解释什么是本地模型"}],
)
print(resp.choices[0].message.content)
性能与取舍:本地模型首 token 延迟通常比云端低(省去公网往返),但大模型吃显存,太小又答不准,需要按你机器显存权衡模型尺寸。预期结果(未在本机执行):脚本打印出一句关于本地模型的解释,证明「编辑器/脚本 → OpenClaw 本地部署 → 模型」整条链路打通。
从配置到验证的四步清单
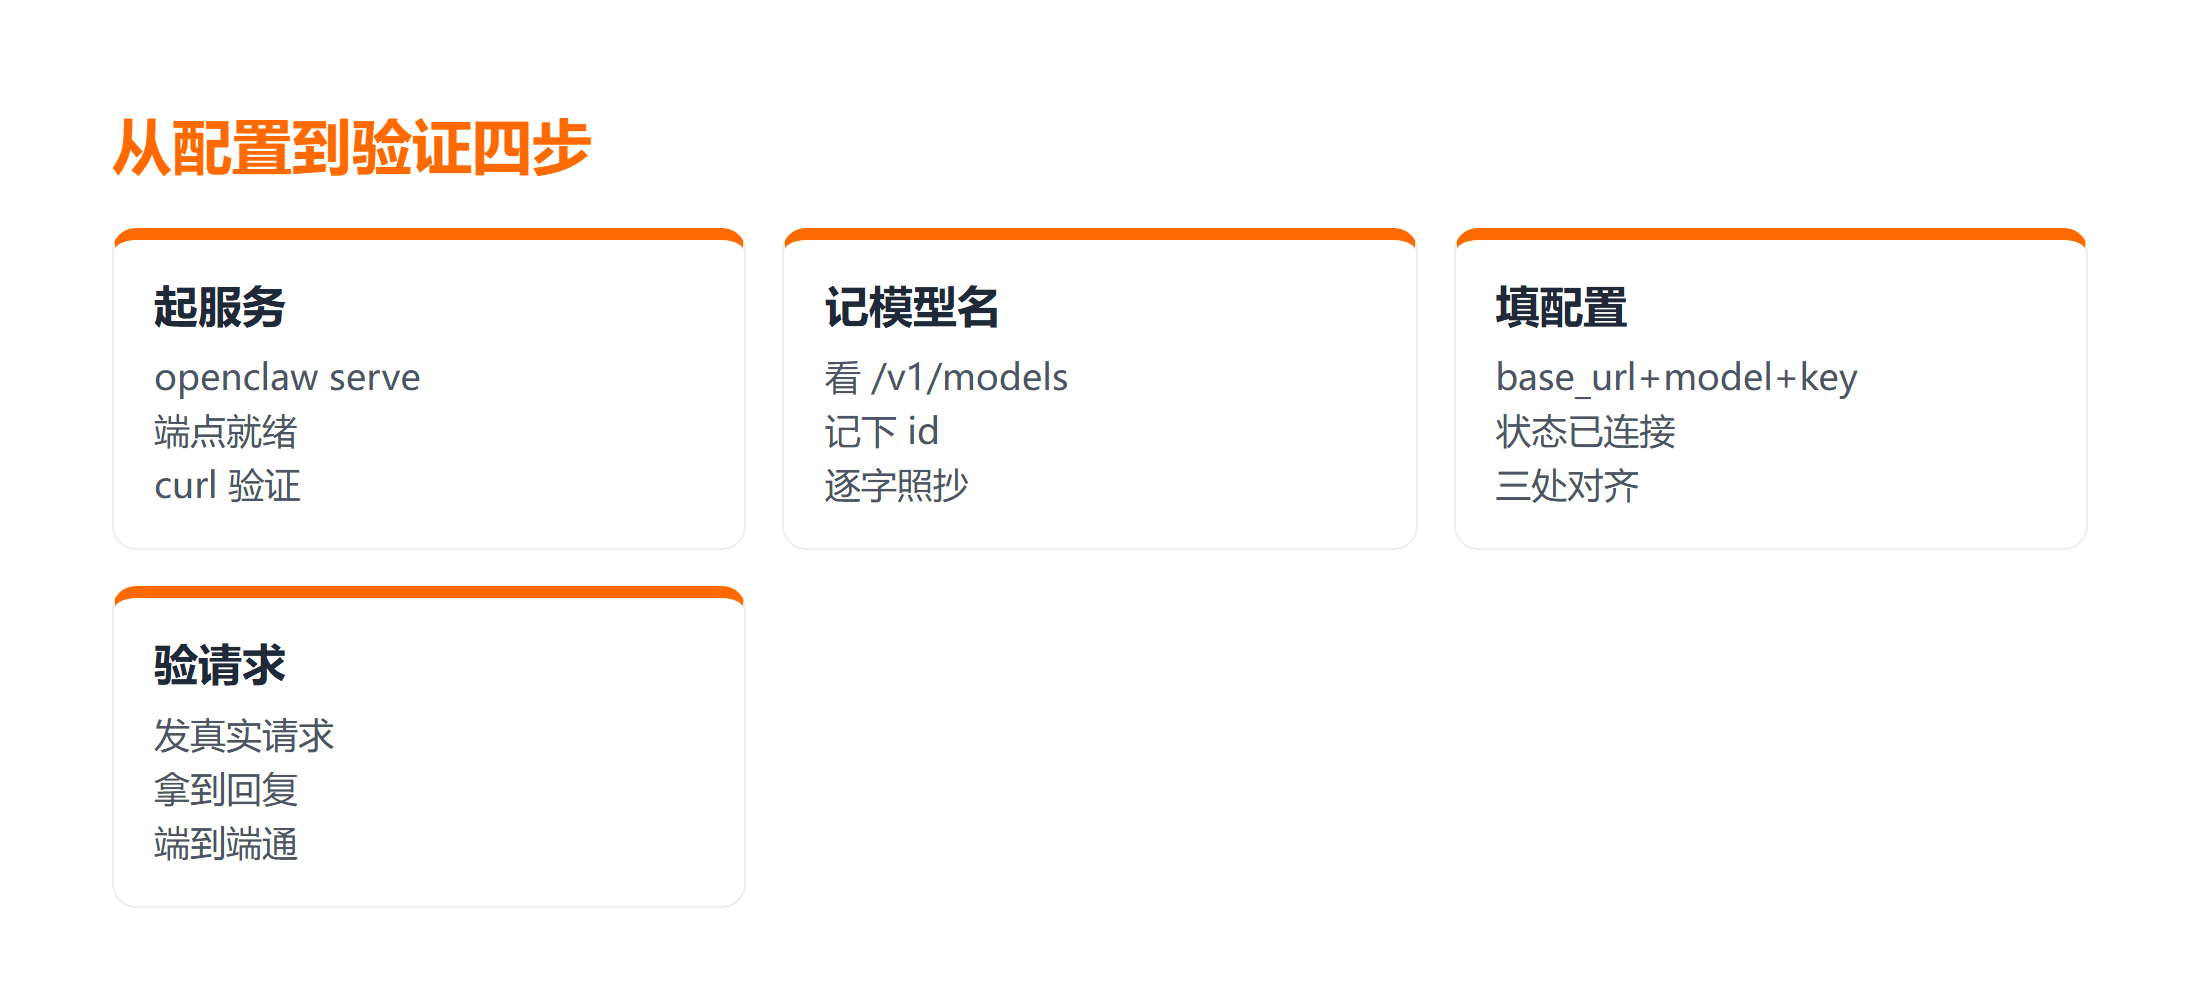
真正把 OpenClaw 本地部署接进编辑器,关键是顺序不能乱。第一步,启动本地服务并 curl 验证端点存在。第二步,确认返回的模型名,记下来待会儿要用。第三步,在编辑器配置里填 base_url、model、api_key 三项,模型名逐字照抄。第四步,发一条真实请求,确认能拿到回复。把四步固化成流程,编辑器对接基本一次成功。
还有个容易被忽略的点:编辑器里的 api_key 即便本地不需要真实密钥,也常被插件强制要求非空,填一个本地约定的占位串(如 local-dev-key)即可,但别留空。另外,若你换了模型或重启了服务,编辑器里的模型名也要同步更新,否则会报「model not found」。把这套顺序记牢,基本能避开绝大多数对接失败的尴尬。
一个细节:端点别随手暴露到公网
OpenClaw 本地部署默认监听回环地址 127.0.0.1,这是安全的。切忌为了「在别的机器上也能连」就把监听地址改成 0.0.0.0 还不加鉴权,那等于把你的模型服务裸奔到公网。确有跨机需求时,请用 SSH 隧道或内网代理转发,而不是直接改监听地址。
常见问题
Q:编辑器显示已连接,但一发请求就报 model not found?
九成是 model 字段和本地实际加载的模型名对不上。回到第一步的 curl /v1/models 输出,把模型名逐字复制进编辑器配置,注意大小写和连字符。
Q:本地服务起了,编辑器却连不上,怎么回事?
先确认端口一致、服务确实在跑;再检查编辑器是否运行在容器或沙箱里,导致 127.0.0.1 指向了容器自身而非宿主机。跨环境时改用宿主真实内网 IP 或端口转发。
Q:API 密钥本地没有,插件又不让留空怎么办?
填一个本地约定的占位串(如 local-dev-key)即可,只要和配置里、请求里的写法保持一致。本地部署通常不校验密钥真伪,重点在于非空且两端一致。
总结
把 OpenClaw 本地部署的模型对接编辑器,核心是让端点、模型名、密钥三处对齐:先本地把模型服务跑通并拿到模型名,再在编辑器里填对 base_url 与 model,最后发一条真实请求验证链路。记住四个步骤——起服务、记模型名、填配置、验请求,基本就能一次接上,享受代码不离机、响应还快的本地模型体验。
读者任务链(前置 / 操作 / 验证 / 失败处理)
- 前置:确认 OpenClaw 已安装、模型权重就绪,且本机有可用的显存或内存承载目标模型;准备好编辑器的 AI 插件。
- 操作:先用
openclaw serve把本地模型跑起来,记录/v1/models返回的模型名,再在编辑器配置里把base_url、model、api_key三项填对。 - 验证:发一条真实请求(或脚本调用),确认能拿到模型回复,说明「编辑器 → 本地端点 → 模型」整条链路打通。
- 失败处理:若连不上,先核端口与进程是否存活、模型名是否逐字一致;若跨容器运行,确认
127.0.0.1指向的是宿主而非容器自身。



