
 TRAE-AI编程

你用 Node.js 读个配置文件或日志,是不是在 fs.readFile 和 fs.readFileSync 之间拿不准,或者遇到中文乱码、路径报错?Node.js 读取文件,常见有同步读、异步回调、Promise(async/await)、按流读四种。本文用最小示例讲清每种写法、怎么指定编码避免乱码,以及两个最容易踩的坑。看完你能按场景选对 API。今天这篇文章,编程狮就把这块讲透。四种方式从同步到流式都给了可抄代码,再配上编码和路径两个高频坑,读完就能直接落地。
一、先看结论
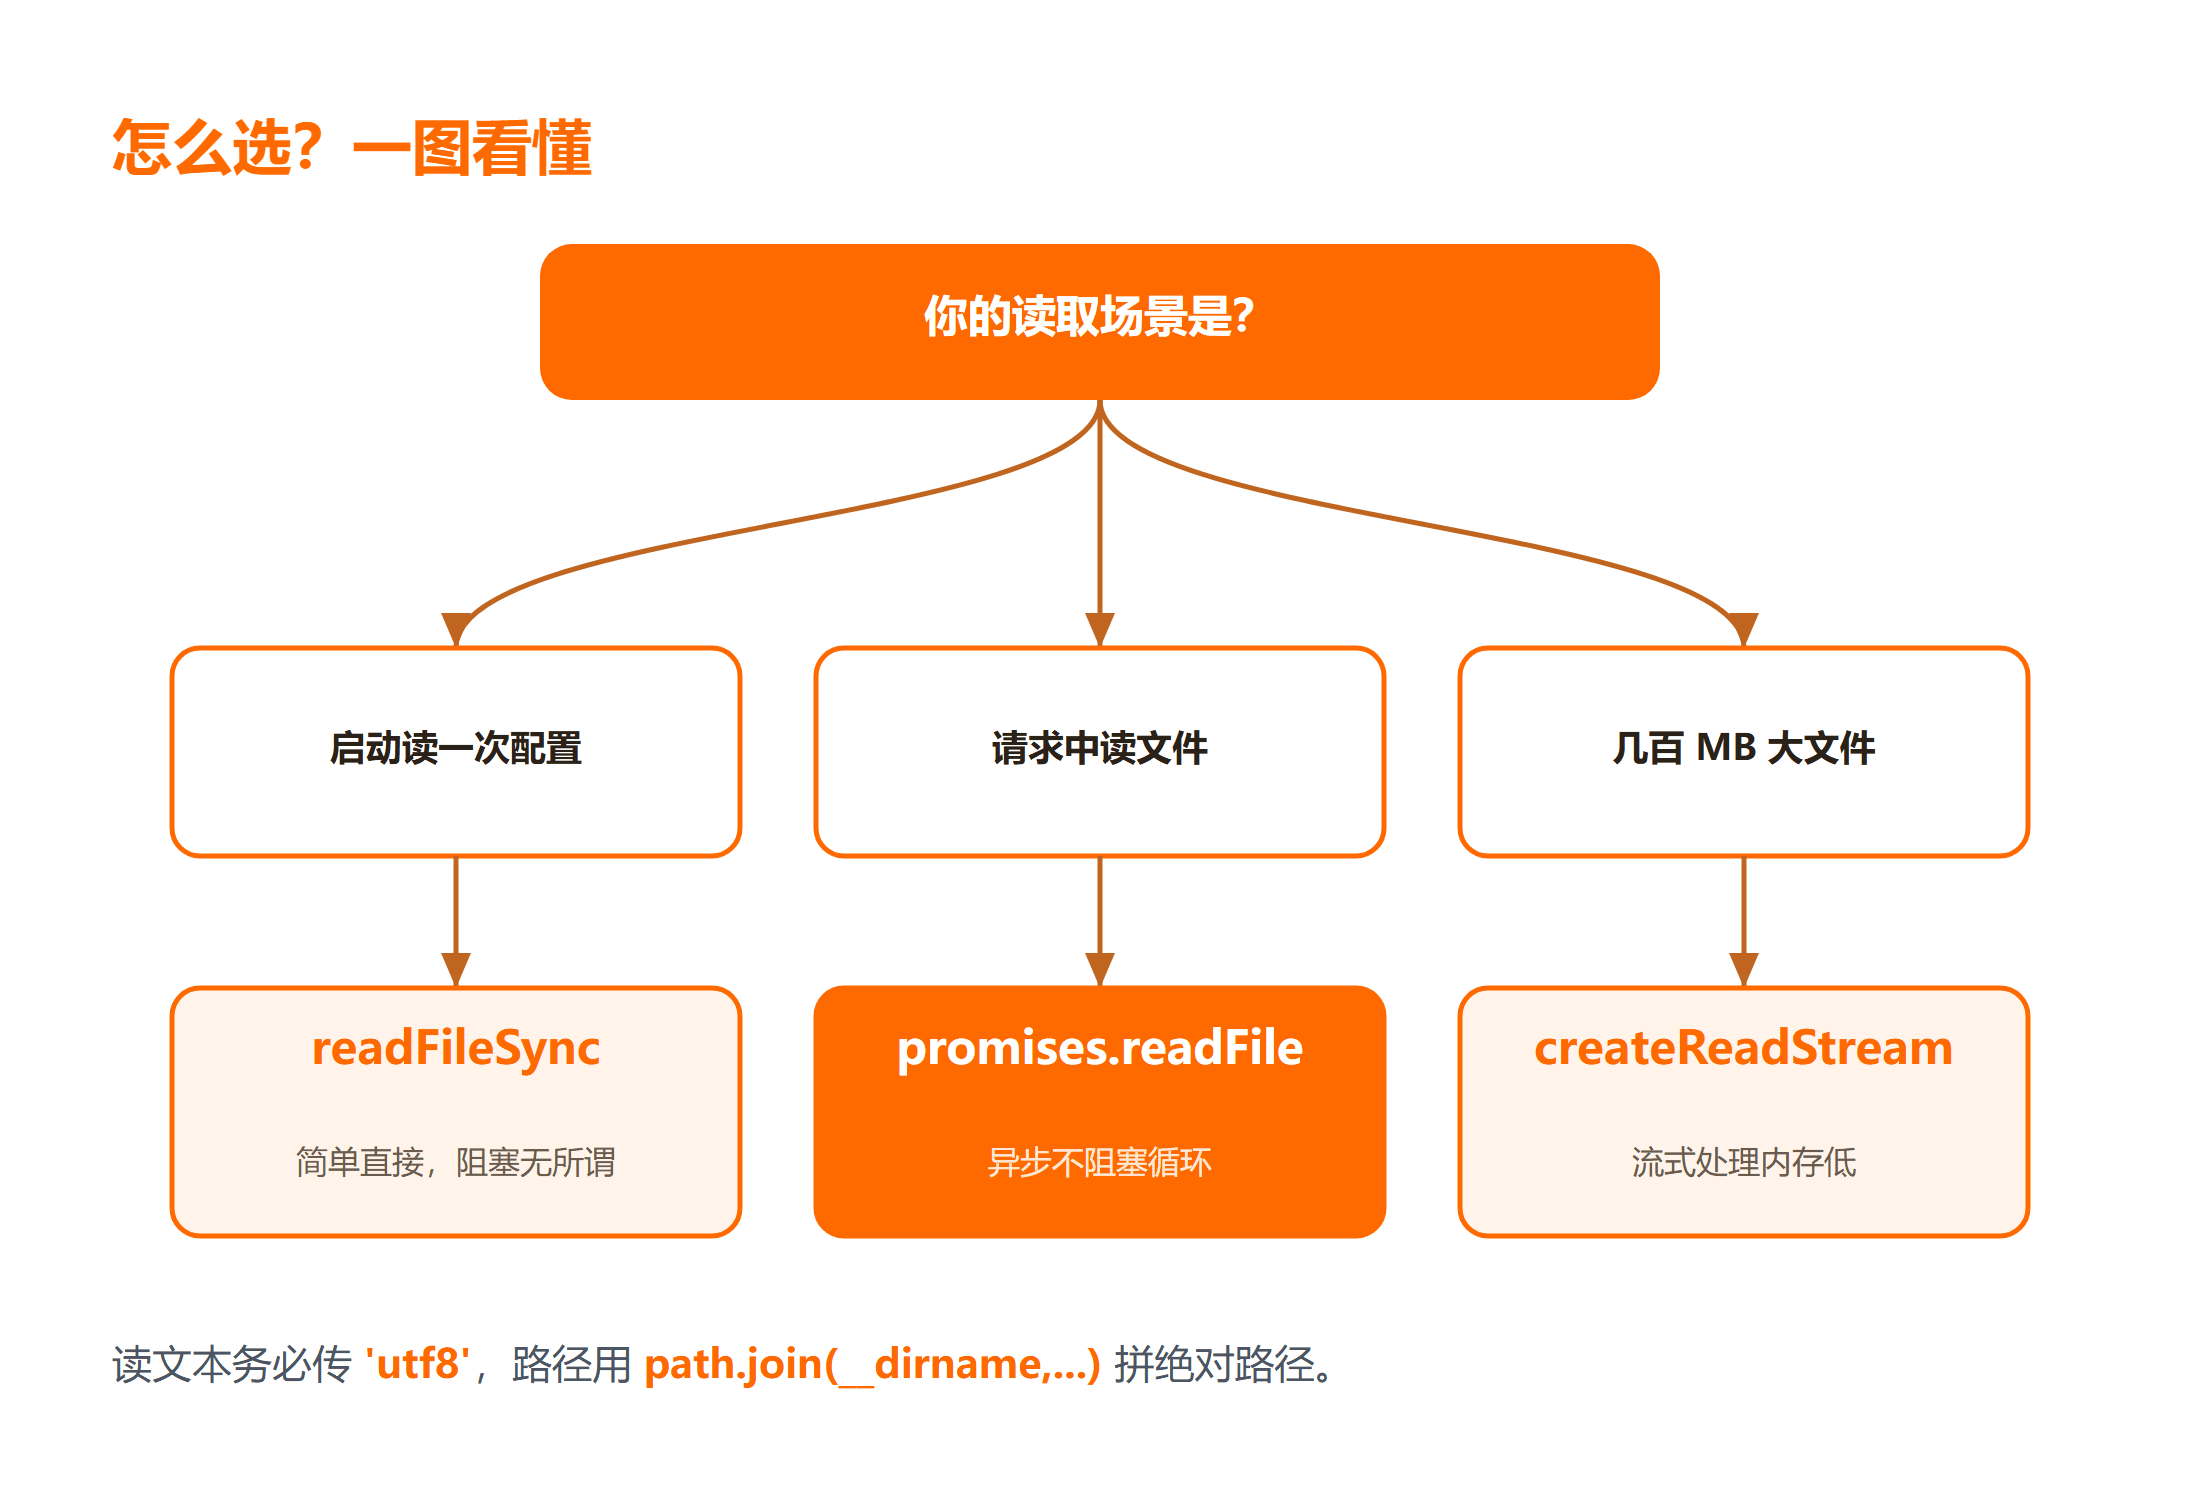
| 场景 | 推荐方式 | 理由 |
|---|---|---|
| 启动时读配置 | fs.readFileSync |
简单直接,阻塞无所谓 |
| 请求中读文件 | fs.promises.readFile + await |
不阻塞事件循环 |
| 大文件 | 流式 createReadStream |
内存占用低 |
| 老代码兼容 | fs.readFile 回调 |
历史写法 |
二、读取文件到底怎么发生
Node.js 读取文件 的核心区别在“同步还是异步”。Node 是单线程事件循环模型:如果用同步 readFileSync,线程会卡在这行直到读完,期间什么别的都做不了;如果用异步 readFile / promises.readFile,主线程先去干别的,读完了再回头执行回调。对“启动读一次配置”这种场景,阻塞一下无所谓;对“每个请求都读文件”的高并发场景,必须用异步,否则吞吐量会崩。
一个比喻:同步像排队打饭必须等前面人打完,异步像取了号先去占座,叫到再取餐。建议先过一遍 Node.js 教程 的 fs 模块章节。
三、方式一与二:同步读与异步回调
const fs = require('fs');

// 方式一:同步读,返回字符串(指定 utf8 避免乱码)
const syncTxt = fs.readFileSync('config.txt', 'utf8');
console.log(syncTxt);

// 方式二:异步回调读
fs.readFile('config.txt', 'utf8', (err, data) => {
  if (err) { console.error('读失败:', err); return; }
  console.log(data);
});
上面这段做了什么:方式一直接拿到字符串,简单但会阻塞;方式二不阻塞,但要在回调里处理结果与错误。'utf8' 这个编码参数很关键,不写会拿到 Buffer(二进制),打印出来是一串数字而不是文字。
四、方式三与四:Promise 与流式读
const fs = require('fs');

// 方式三:Promise + async/await(现代推荐)
async function load() {
  try {
    const data = await fs.promises.readFile('config.txt', 'utf8');
    console.log(data);
  } catch (e) {
    console.error('读失败:', e);
  }
}
load();

// 方式四:流式读大文件,分块处理,内存友好
fs.createReadStream('big.log', 'utf8')
  .on('data', chunk => process.stdout.write(chunk))
  .on('end', () => console.log('\n读完了'));
上面这段做了什么:方式三用 await 把异步写得像同步一样直观,还能用 try/catch 统一抓错,是现在的主流写法。方式四用流“边读边处理”,一个几 GB 的日志也不需要一次性塞进内存,适合大文件。
五、两个最容易踩的坑
| 现象 | 原因 | 修复 |
|---|---|---|
| 读出来是乱码/一串数字 | 没指定 'utf8',返回的是 Buffer |
读时显式传 'utf8' |
| 提示 ENOENT 文件不存在 | 路径相对的是“运行命令的目录”而非脚本目录 | 用 path.join(__dirname, '文件') 拼绝对路径 |
第一个坑前面强调过:不传编码得到 Buffer,需 .toString('utf8') 或读时直接传 'utf8'。第二个坑很隐蔽:readFile('config.txt') 里的相对路径是相对于“你敲命令时所在的目录”,不是脚本文件所在目录。用 path.join(__dirname, 'config.txt') 拼出绝对路径就稳了。
Node.js 读文件有三种姿势,选错会让代码要么阻塞、要么回调地狱。fs.readFile 是异步的,把路径和回调传进去,读完后操作系统通知你,主线程不卡顿,适合 Web 服务里的偶发读取;fs.readFileSync 是同步的,调用后线程一直等到读完才继续,写法简单但会阻塞事件循环,一旦在高并发路径上用,整个进程都会跟着变慢,只建议在启动初始化、CLI 工具这类“一次读完再干活”的场景用。fs.promises.readFile 返回 Promise,配合 async/await 写起来最清爽,也最容易做错误捕获,是现在最推荐的方式。
编码是第二个高频坑。不指定编码时,读出来的是 Buffer(二进制),你看到的是一堆十六进制或乱码;绝大多数文本场景要显式传 "utf8",这样直接拿到字符串。注意 utf8 是 Node 默认,但函数默认值在历史版本里曾变过,显式传最稳。还有相对路径:Node 里相对路径是相对于“当前工作目录 cwd”而不是“脚本所在目录”,所以在 cron、守护进程或不同目录启动时就可能找不到文件;稳妥做法是先用 path.join(__dirname, "xxx") 拼成绝对路径,再传给读文件函数。
第三个坑是“大文件”。readFile 会把整个文件读进内存,几百 MB 的日志或转储用它会直接撑爆内存、触发 OOM。正确思路是换成流式读取:fs.createReadStream 配合 data/end 事件,或者 readline 按行读取,数据像水流一样一段段处理,内存占用几乎恒定。顺带一提,读完文件一定要处理错误——try/catch 包住 await 版本,或检查回调的 err 参数,否则文件不存在、权限不足这类错误会让程序直接崩溃。把“异步优先、显式编码、绝对路径、大文件用流”这四句话记牢,读文件基本不会出事。
把四种方式串起来看:CLI 工具里用 readFileSync 最简单;Web 服务里用 fs.promises.readFile 配 await 最清爽;遇到几百 MB 的大文件,果断切 createReadStream 按块处理。无论哪种,都记得显式传 'utf8' 并用 path.join(__dirname, ...) 拼绝对路径,再用 try/catch 兜住文件不存在、权限不足这类错误。把“异步优先、显式编码、绝对路径、大文件用流”四句话贴在显示器边,读文件基本不会再出事故。
补充一句:读取文本时若文件可能很大且只需前几行,用 readline 逐行读比一次性 readFile 更省内存,处理日志头部信息特别合适。
动手配置好 Node 环境,把四种读文件方式分别运行,检查输出是否符合预期;若读出来是 Buffer,按“未传 utf8”的方向排查失败原因并修复。边界场景、性能取舍与适用选择下面根据实际运行与官方文档整理。
总结
要点带走:
- 启动读配置用 readFileSync,请求中读文件用 promises.readFile + await,大文件用 createReadStream 流;
- 读文本务必传
'utf8',否则拿到 Buffer 乱码; - 路径用
path.join(__dirname, ...)拼绝对路径,避免相对路径随运行目录漂移。
下一步建议系统过一遍 Node.js 教程,把模块、流和Node 是什么一起学。
延伸学习
想把这块知识系统补齐,可以按这个顺序来:
Q:readFile 和 readFileSync 选哪个?
A:看是否容忍阻塞。程序启动读一次配置,用同步最省事;在 HTTP 请求处理里读文件,必须用异步读取(回调或 Promise),否则会卡住整个事件循环、拖垮并发。
Q:为什么读出来是 Buffer 而不是文字?
A:因为没指定编码。fs 默认返回 Buffer(原始字节),打印就是数字数组。读文本时传第二个参数 'utf8',或在 Buffer 上调用 .toString('utf8') 即可还原成字符串。
Q:相对路径到底相对谁?
A:相对的是“执行 node 命令时所在的当前工作目录”,不是 .js 文件所在目录。脚本被不同目录调用时容易找不到文件,统一用 path.join(__dirname, 文件名) 拼绝对路径最稳妥。



