 TRAE-AI编程

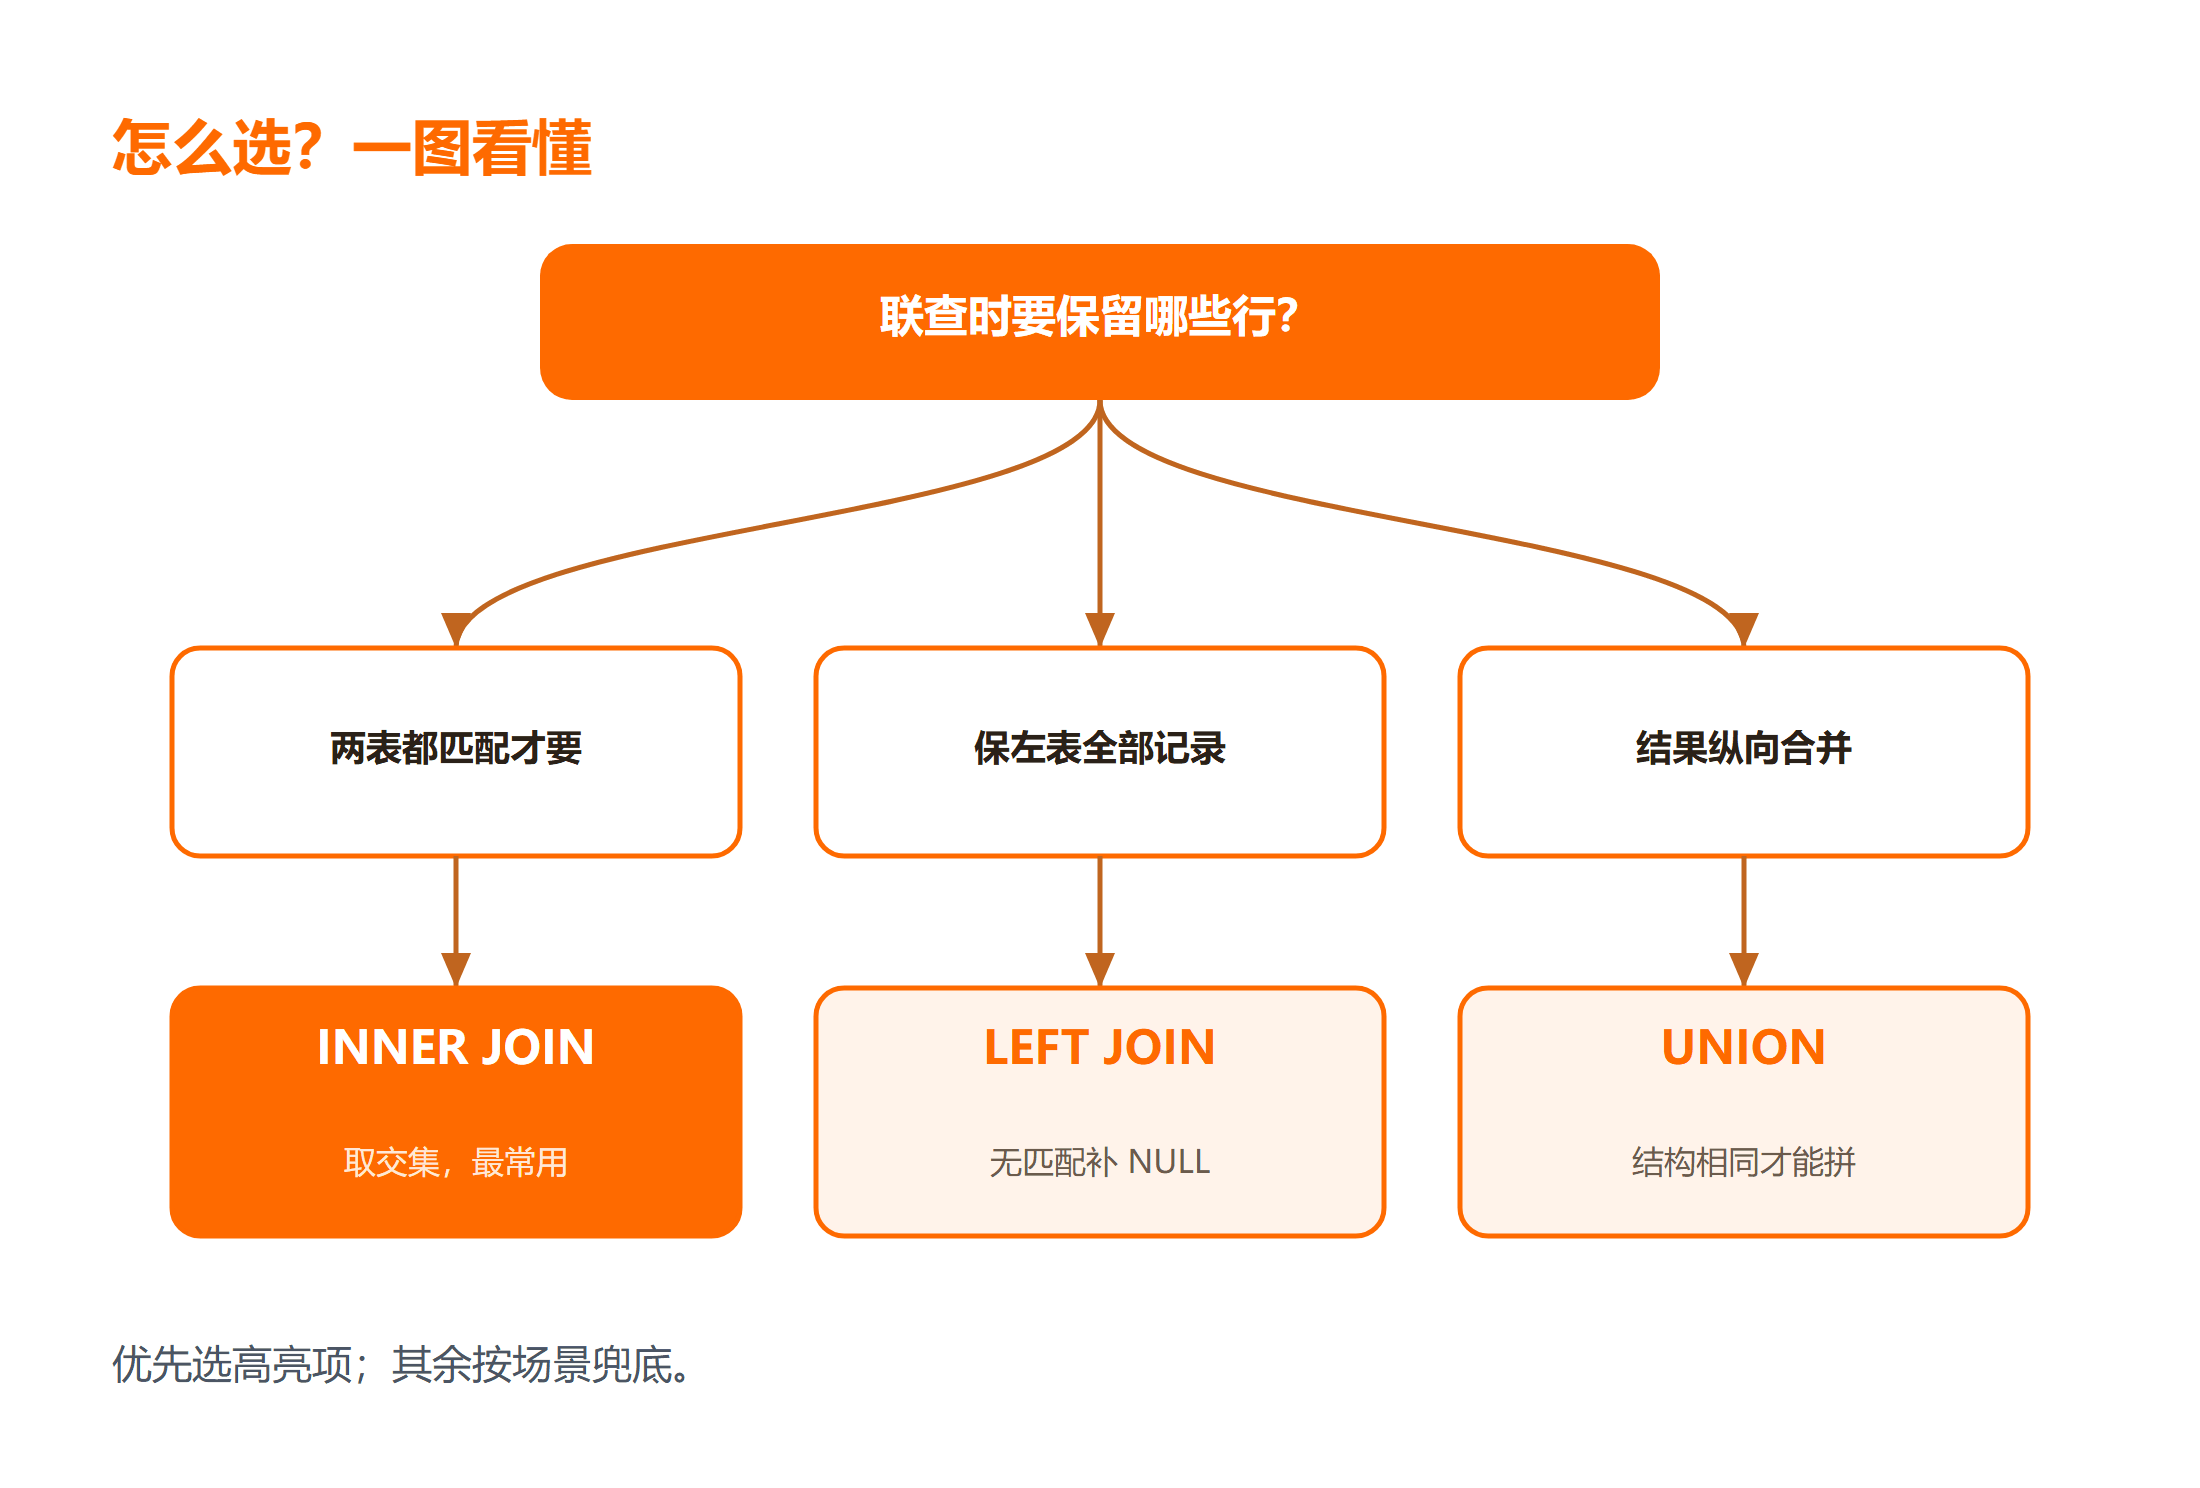
做 mysql多表联查 时,取交集用 INNER JOIN,保左表用 LEFT JOIN,集合运算用 UNION;先想清楚要保留哪边再选。这是本文给出的核心结论,也是你每次写连接语句前该先问自己的问题。很多同学一遇到\\"两张表要拼在一起\\"就本能地写 JOIN,却没想清楚到底要保留哪一侧的数据,最后要么把该留的记录过滤掉,要么不小心写出笛卡尔积导致行数爆炸。本文用三种最常用方式把思路彻底理顺——INNER JOIN 取交集、LEFT/RIGHT JOIN 保一侧、UNION 做集合合并,并附上一张方法选择表和一张失败排错表。无论你是刚接触 SQL 的新手,还是写了多年查询偶尔翻车的工程师,都可以照着下面的判断逻辑快速定位该用哪种写法。所有示例都基于两张最小表,你可以直接复制到本地 MySQL 验证,先建立直觉,再回到自己的业务表里替换字段名即可。
一、先看结论:MySQL 多表联查怎么选
在实际项目里,mysql多表联查 的难点从来不是\\"会不会写 JOIN 关键字\\",而是\\"该用哪一种 JOIN\\"。如果连接类型选错,后面加再多 WHERE 条件也救不回来。下面这张方法选择表,把三种最常见方式的适用边界一次性列清楚,建议你截图保存,写 SQL 前先对照查一遍。
| 方式 | 适用场景 | 不推荐场景 | 推荐顺序 |
|---|---|---|---|
| INNER JOIN | 只要两表都匹配上的行,例如\\"已下单的用户\\" | 需要保留未下单用户时 | 1(最常用、最安全) |
| LEFT / RIGHT JOIN | 要保住驱动表全部记录,例如\\"所有用户及其订单(含无订单者)\\" | 只想取交集时(会拖慢且语义不清) | 2(需补 NULL 时用) |
| UNION | 把结构相同的多个结果集合并,例如\\"活跃用户与沉睡用户合并统计\\" | 字段数或顺序不一致时 | 3(集合运算专用) |
这张表的核心判断维度只有两个:一是\\"要不要保留某一侧的孤行\\",二是\\"是不是在做集合合并\\"。只要抓住这两点,INNER JOIN、LEFT JOIN 的选择就不会乱。
另外补充一点关于 RIGHT JOIN 的说明:它的语义和 LEFT JOIN 完全对称,只是驱动表换到了右边。绝大多数团队约定\\"一律用 LEFT JOIN\\",通过调换表的出现顺序来替代 RIGHT JOIN,这样代码读起来方向统一,不容易看错。除非你接手的是历史老代码,否则日常写 MySQL 联表查询 时基本可以只记住 INNER JOIN 和 LEFT JOIN 两种。若你想先把基础语法系统补齐,推荐过一遍 MySQL 教程,再回来对照本表选型,理解会更快。
二、环境与最小示例
我们需要两张最小表来演示。第一张是用户表 users,存用户基本信息;第二张是订单表 orders,存下单记录,通过 user_id 关联回用户。之所以用\\"用户—订单\\"这个经典一对多关系,是因为它几乎出现在每一个业务系统里,你今天学的写法明天就能套到\\"文章—评论\\"\\"商品—销量\\"上。下面先建表,再插入少量样例数据,最后给出一个最简的 INNER JOIN,让你看到\\"两表拼起来\\"到底是什么样。
(以下为说明性代码,未在本机执行;预期结果:users 与 orders 各含 3 行样例,JOIN 后能正确按 user_id 关联,返回 3 行配对记录。)
-- 创建用户表,user_id 是主键,用于和订单表关联
CREATE TABLE users (
  user_id   INT PRIMARY KEY,        -- 用户编号,作为关联键
  user_name VARCHAR(20)             -- 用户昵称,仅用于展示
);

-- 创建订单表,user_id 是外键,指向 users.user_id
CREATE TABLE orders (
  order_id INT PRIMARY KEY,         -- 订单编号,自身主键
  user_id  INT,                     -- 下单用户编号,关联 users 表
  amount   DECIMAL(10,2)            -- 订单金额,用于后续聚合
);

-- 向用户表插入 3 条样例,其中 user_id=3 的用户稍后不建订单
INSERT INTO users (user_id, user_name) VALUES
  (1, \\\'张三\\\'),                      -- 第 1 个用户
  (2, \\\'李四\\\'),                      -- 第 2 个用户
  (3, \\\'王五\\\');                      -- 第 3 个用户,用于演示\\\"孤行\\\"

-- 向订单表插入 3 条样例,注意只有 user_id=1 和 2 有订单
INSERT INTO orders (order_id, user_id, amount) VALUES
  (101, 1, 99.00),                  -- 张三的订单
  (102, 1, 50.00),                  -- 张三的第二笔订单
  (103, 2, 20.00);                  -- 李四的订单

-- 最简 INNER JOIN:只返回两表都能对上的行
SELECT u.user_name, o.order_id, o.amount   -- 从两表各取需要的列
FROM users u                                -- 左表起别名 u,方便书写
INNER JOIN orders o                         -- 右表起别名 o,INNER 取交集
  ON u.user_id = o.user_id;                 -- 关联条件:编号相等才配对
这个最小示例是后面所有讲解的基础。请特别注意 INNER JOIN 那一行后面的 ON 子句,它定义了\\"什么算匹配\\"。如果 ON 条件写错,比如写成无关字段,就会得到错误的关联结果,甚至触发笛卡尔积。下一节我们单独展开 INNER JOIN 的取交集语义,并演示如何在此基础上做聚合统计。
三、方式一:INNER JOIN
INNER JOIN 是 mysql多表联查 里使用频率最高的方式,它的语义是\\"取交集\\":只有左右两张表都能根据 ON 条件匹配上的行,才会出现在结果里;任何一侧匹配不上的行都会被直接丢弃。从集合的角度看,它等于两个集合相交后保留下来的部分,这正是它叫\\"INNER(内部)\\"的原因。
(以下为说明性代码,未在本机执行;预期结果:返回张三的两条订单与李四的一条订单,共 3 行;王五因无订单被排除。)
-- INNER JOIN 标准写法,等价于早期的隐式逗号连接
SELECT u.user_name, o.order_id, o.amount   -- 选取要展示的列
FROM users u                                -- 左表:用户
INNER JOIN orders o                         -- 右表:订单
  ON u.user_id = o.user_id;                 -- ON 决定匹配键,必须写对

-- 加上筛选与聚合,统计每个用户的下单总额
SELECT
  u.user_name,                             -- 按用户分组展示
  COUNT(o.order_id) AS cnt,                -- 订单笔数
  SUM(o.amount)    AS total               -- 金额合计
FROM users u
INNER JOIN orders o
  ON u.user_id = o.user_id
GROUP BY u.user_name;                       -- 按用户昵称分组聚合
理解 INNER JOIN 有三个要点。第一,ON 子句只负责\\"怎么配对\\",不负责\\"怎么过滤\\",真正的过滤要放在 WHERE 里。例如\\"只要金额大于 30 的订单\\",应写成 WHERE o.amount > 30,而不是塞进 ON。第二,INNER 可以省略,直接写 JOIN,二者在 MySQL 中含义相同,但显式写上 INNER 可读性更好,一眼能看出这是取交集。第三,当左表一行对应右表多行时,结果会\\"展开\\"成多行,比如张三有两笔订单,就会在结果里出现两行,这是正常的乘法关系,不是 bug,做 COUNT/SUM 时务必想清楚是按用户还是按订单计数。
在写 MySQL 联表查询 时,如果你确认业务只需要\\"两边都有的数据\\",那么 INNER JOIN 永远是首选,因为它不会引入 NULL,也不会偷偷多出孤行,语义最干净、性能通常也最好。当连接涉及多张表时,建议小表放前面做驱动表,并为关联键建立索引,这样优化器能更快地完成匹配。
四、方式二:LEFT / RIGHT JOIN
LEFT JOIN 的语义是\\"保左表\\":左表(FROM 后面的那张)的每一行都会出现在结果里;如果右表没有能匹配上的行,右表对应的列就用 NULL 补齐。这正是处理\\"要保留某一侧全部记录\\"场景的利器,比如\\"列出所有用户,并标出各自最新一笔订单\\",即便某些用户从没下过单也要出现在清单里。
(以下为说明性代码,未在本机执行;预期结果:返回张三、李四、王五共 3 行;王五没有订单,order_id 与 amount 显示为 NULL。)
-- LEFT JOIN:保住左表 users 的全部用户
SELECT u.user_name, o.order_id, o.amount   -- 右表无匹配时这两列为 NULL
FROM users u                                -- 左表,驱动表,全部保留
LEFT JOIN orders o                          -- 右表,匹配不上就补 NULL
  ON u.user_id = o.user_id;                 -- 关联键仍是 user_id

-- 找出\\\"从未下过单\\\"的用户:利用右表主键为 NULL 判断
SELECT u.user_name                          -- 只需要用户昵称
FROM users u
LEFT JOIN orders o
  ON u.user_id = o.user_id
WHERE o.order_id IS NULL;                   -- 右表无匹配,说明没订单
LEFT JOIN 最常见的坑,是把\\"右表无匹配\\"误当成\\"有匹配但金额为 0\\"。记住,没匹配上是 NULL,不是 0,因此判断\\"没有订单\\"要用 o.order_id IS NULL,而不能用 = 0 或 <> 0。另外一个隐蔽的坑是:如果对右表加了 WHERE 过滤,且过滤条件写在右表列上(例如 WHERE o.amount > 10),LEFT JOIN 会被\\"悄悄\\"变成 INNER JOIN 的效果,因为 NULL 不满足这个过滤条件,于是左表里那些没匹配上的行也被一并剔除。正确做法是用 AND 把右表条件放在 ON 里,例如 LEFT JOIN orders o ON u.user_id = o.user_id AND o.amount > 10,这样\\"保左表\\"的语义才不会被破坏。
RIGHT JOIN 与 LEFT JOIN 对称,只是驱动表换到右边。由于可读性考虑,多数团队约定统一用 LEFT JOIN,通过调换表顺序达到同样效果。多表连接 时如果还要继续 LEFT JOIN 第三张表,建议保持驱动方向一致,避免逻辑混乱。需要把 NULL 展示成具体数值时,可以用 COALESCE(右表列, 默认值) 在 SELECT 层转换,但这只是展示层的替换,底层\\"无匹配\\"的语义依旧是 NULL。
五、方式三:UNION 与子查询及排错
UNION 不属于\\"连接\\"而是\\"集合运算\\",但在 mysql多表联查 的实战里经常和 JOIN 配合。它的作用是把多个结构相同(列数一致、对应列类型兼容)的查询结果纵向叠在一起。UNION 默认去重,UNION ALL 保留全部行不去重,后者性能更好,在确定无重复或需要保留重复时优先用 UNION ALL。注意 UNION 是\\"上下拼接\\"行,而 JOIN 是\\"左右拼接\\"列,二者不要混淆。
(以下为说明性代码,未在本机执行;预期结果:把\\"有订单用户\\"与\\"无订单用户\\"两个结果集合并成一张清单,列数均为 2,共 3 行。)
-- UNION:合并两个结构相同的查询结果(默认去重)
SELECT u.user_name, SUM(o.amount) AS total -- 第 1 个结果集:消费合计
FROM users u
INNER JOIN orders o ON u.user_id = o.user_id
GROUP BY u.user_name

UNION                                       -- 纵向合并,要求列数一致

SELECT u.user_name, 0 AS total             -- 第 2 个结果集:无订单补 0
FROM users u
LEFT JOIN orders o ON u.user_id = o.user_id
WHERE o.order_id IS NULL;                   -- 取没有订单的用户
使用 UNION 有三个硬约束:列数必须相同、对应列的数据类型要兼容、列的顺序要对应。如果报错\\"列数不一致\\",优先检查是不是某一边少写或多写了 SELECT 列。子查询则常用于把一段查询结果当作临时表再 JOIN,例如 FROM (SELECT ...) t INNER JOIN ...,注意派生表必须起别名,否则 MySQL 会报语法错误。在 UNION 的各段里若想整体排序,要把 ORDER BY 放在最后一个结果集之后,并且通常配合 LIMIT 才有意义。
下面这张排错表,覆盖 mysql多表联查 时最高频的几种失败现象,建议你对照排查。
| 现象 | 常见原因 | 修复方向 |
|---|---|---|
| 结果行数远超预期(几千上万行) | 漏写 ON 或 ON 条件无效,产生笛卡尔积 | 补上正确的关联键,确认 ON 引用了双方字段 |
| 该出现的行不见了 | 用 LEFT JOIN 却在 WHERE 里过滤了右表列,被悄悄变成 INNER | 把右表过滤条件移到 ON 子句的 AND 后 |
| NULL 被误过滤 | 用 = 0 或 <> 判断\\"无匹配\\",而实际是 NULL |
改用 IS NULL / IS NOT NULL 判断 |
| UNION 报错\\"字段数不一致\\" | 两个结果集 SELECT 列数不同或顺序错 | 对齐列数与顺序,必要时补占位列 |
| 联表查询很慢 | 关联字段无索引、返回列过多、笛卡尔积 | 给关联键建索引,只 SELECT 必要列,先小表驱动 |
这张排错表几乎能覆盖八成以上的 MySQL 联表查询 故障。当你发现结果\\"不对劲\\"时,先别急着加条件,而是回到\\"我要保留哪边、是不是集合合并、ON 写对了没\\"这三个根本问题。
总结
回看全文,mysql多表联查 的选型其实只有一条主线:先想清楚\\"要保留哪一边\\"。两表都要匹配就选 INNER JOIN 取交集;要保住驱动表全部记录就选 LEFT JOIN,并小心处理右表为 NULL 的情况;需要把多个结构相同的结果集合并,就选 UNION 做集合运算。多表连接 没有\\"最强大\\"的写法,只有\\"最贴合业务语义\\"的写法。把方法选择表和排错表存好,下次写 SQL 前先对照,基本能避开绝大多数翻车现场。最后提醒,本文所有示例均为说明性代码,请在自己的数据库里实跑验证,确认结果符合预期后再用于生产环境。想系统学 SQL 基础可看 SQL 教程。
延伸学习
- MySQL 入门课程:从零开始系统学习 MySQL 语法与实战。
- MySQL 表结构笔记:编程狮笔记一篇,讲解如何用命令查看表字段与索引。
- MySQL 速查手册:常用函数与语法速查,写查询时随用随查。
常见问题
Q:INNER JOIN 和直接写逗号连接(FROM a, b WHERE ...)有什么区别?
二者在结果上等价,但显式 INNER JOIN 把\\"关联条件\\"放在 ON 里、\\"过滤条件\\"放在 WHERE 里,结构更清晰,也更不容易漏写关联条件导致笛卡尔积。现代写法推荐一律用 JOIN 关键字,可读性更好。
Q:LEFT JOIN 之后右表字段是 NULL,我能在 SELECT 里把它转成 0 吗?
可以,用 COALESCE(o.amount, 0) 就能把 NULL 显示成 0,但这只是展示层转换,底层\\"没有匹配\\"的语义仍然是 NULL,判断\\"是否存在订单\\"仍需用 IS NULL,不能依赖转成 0 之后再去比较。
Q:UNION 和 UNION ALL 该用哪个?
如果确定两个结果集不会重复,或你本来就想保留重复行,用 UNION ALL,它不去重、性能更好;只有当确实需要去重合并时才用 UNION。在大数据量报表里,优先 UNION ALL 是常见优化手段。