
 TRAE-AI编程

大模型流式输出是服务端把生成内容切成一段段令牌、边生成边通过服务端推送发给前端的机制,你看到的逐字显示正是它在工作。当你在对话框里发送一条消息,对面几乎是“秒回”且一个字一个字往外蹦,而不是等好几秒突然整段弹出,这背后就是它。本文基于 OpenAI 与国内主流大模型 API 的通用协议,讲清它是什么、为什么体感快、前端怎么接,以及哪些场景其实不适合开流式。今天这篇文章,编程狮就把这块讲透。
先看结论
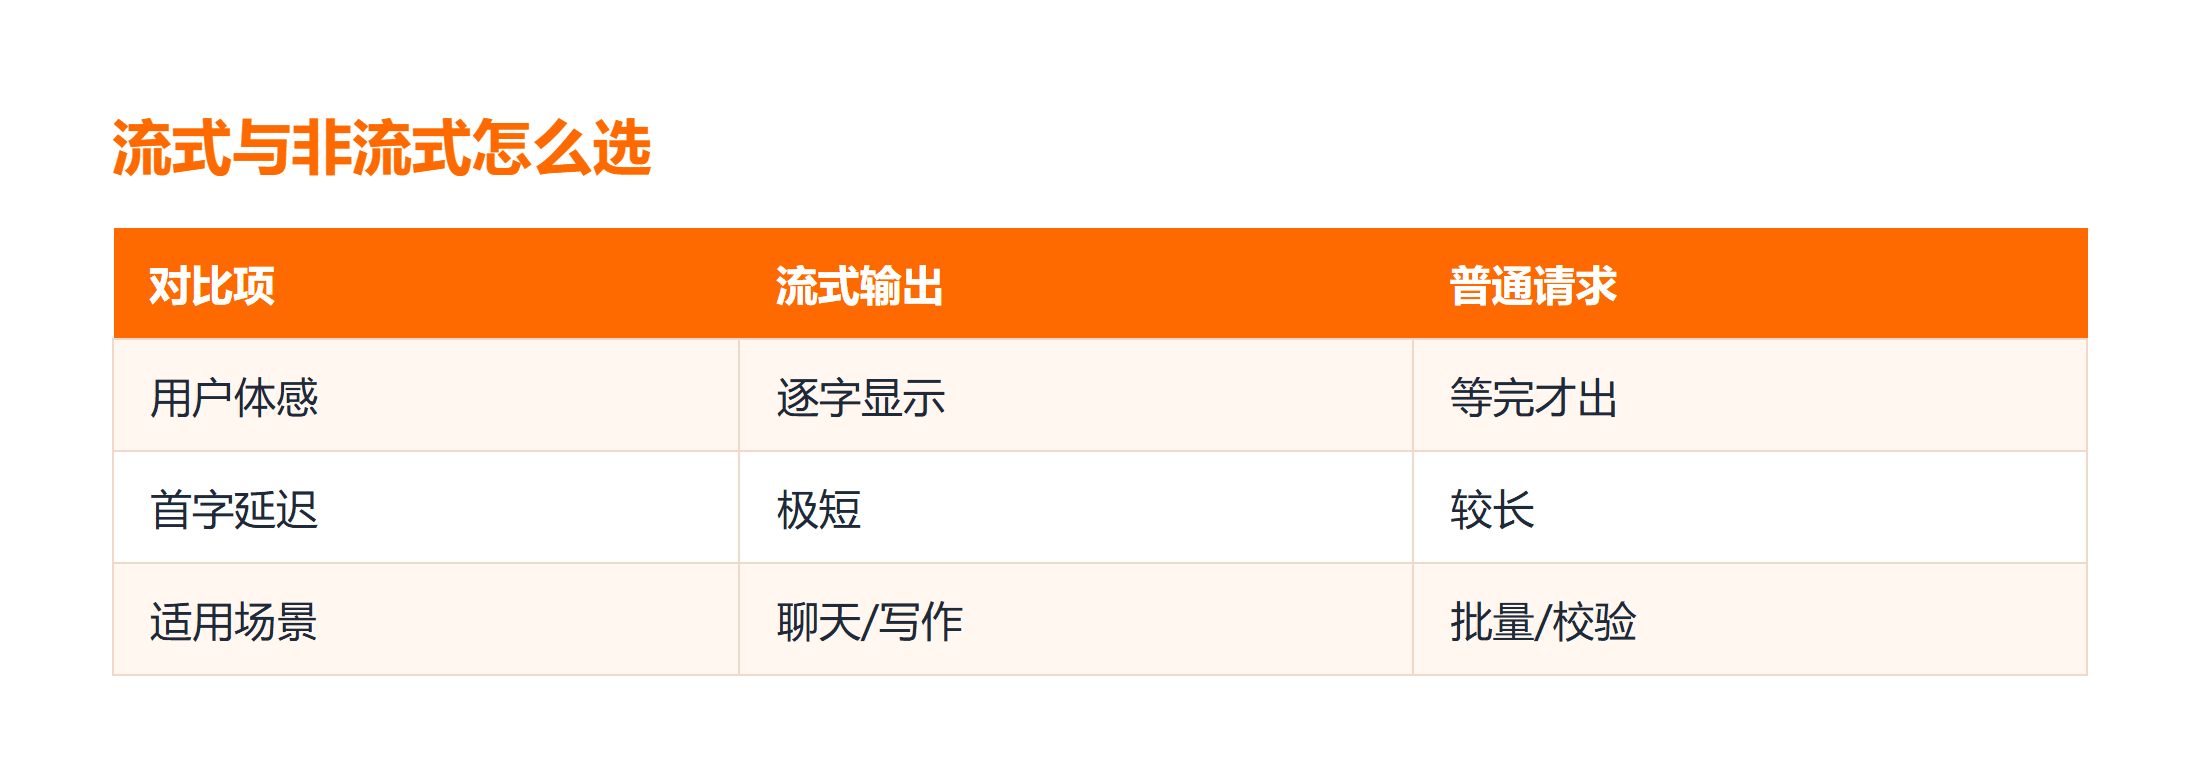
| 你的诉求 | 是否用流式 | 说明 |
|---|---|---|
| 做聊天、写作这类需要“边想边显”的对话式 AI | 用 | 用户提前看到内容,体感等待更短 |
| 后台批量生成报告、摘要,只要最终结果 | 不用 | 攒齐一次性返回更简单,也方便重试 |
| 对输出做完整校验后再展示 | 不用 | 流式中途无法回退,校验应放结束之后 |
一句话:要“快觉得”,开流式;要“拿到就用”,用普通请求。下面先把原理拆开,再讲怎么接、什么时候接。
一、它到底是什么:从一次打字体验说起
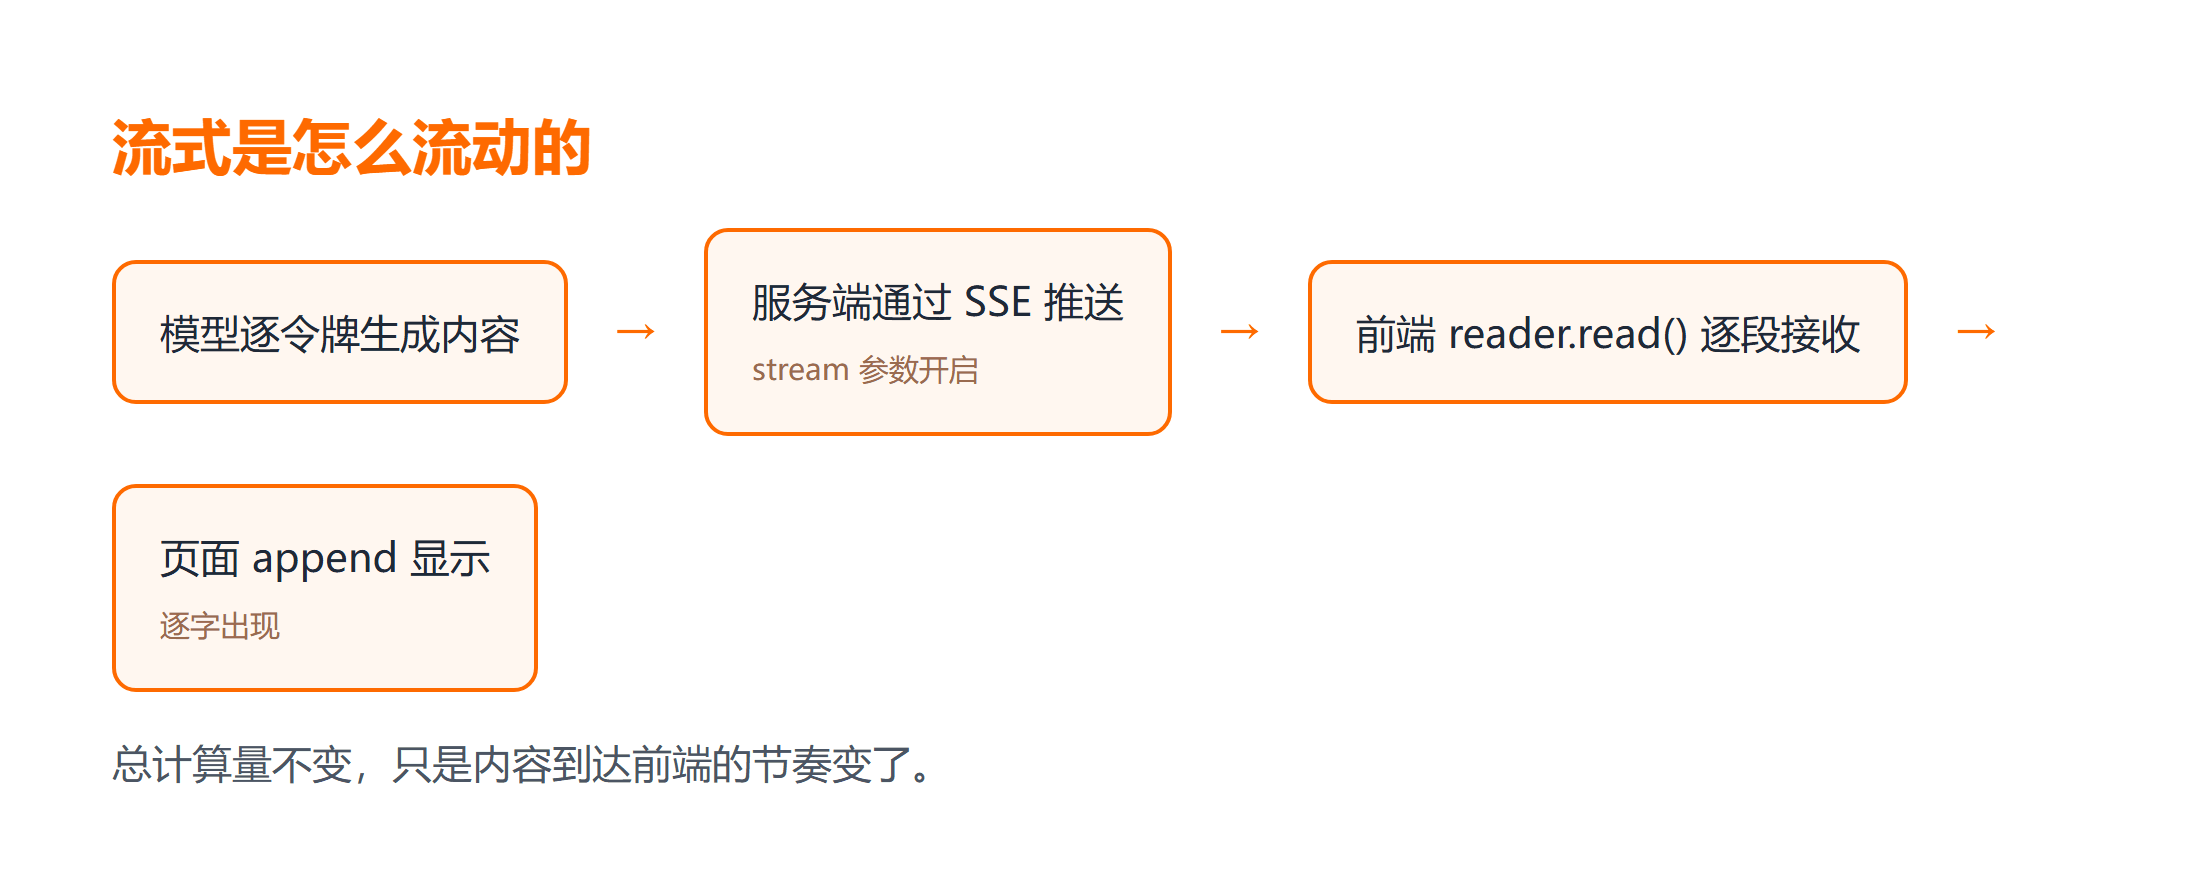
大模型生成内容的基本单位不是“字”,而是“令牌(token)”。中文里一个令牌往往对应一个或几个汉字,英文里常对应一个单词片段,代码里可能对应一个符号。模型每算出来一个令牌,服务端就可以立即把它推给前端,前端接到后追加显示——这就是逐字输出的本质,不是“提前算好再拆开播”。
1.1 为什么我们感觉它是“打字机”
人类阅读是逐行进行的。当一个字出现,大脑就已经开始理解;而整段等待时,大脑只能干瞪眼。流式把“生成时间”和“阅读时间”重叠起来:模型在算第 100 个令牌时,你正在读第 20 个。于是同样的十秒总耗时,流式让你前两秒就“有东西看”,非流式让你前十秒“啥也没有”。
💡 小提示:把令牌理解成传送带上的包裹,传送带一直在转,每到一个包裹就立刻交给收货人,而不是等整车装满再卸货。
1.2 令牌和字数不是一回事
很多人以为“逐字”就是按汉字一个个发,其实服务端发的是令牌。一个汉字可能是 1 个令牌,生僻词或英文单词可能是 1 个令牌对应多个字符。所以前端看到的“跳动节奏”并不均匀,有时一下蹦出半句话,这正是令牌边界造成的,属于正常现象,不必当成 bug。想系统理解这些基础,可以先过一遍 人工智能教程。
二、核心原理:服务端推送与令牌流
最常见的实现是 SSE(Server-Sent Events)。服务端保持连接不关闭,每生成一段就发一条 data: 消息;前端用 EventSource 或流式读取持续接收。大模型 API 在请求里带上 stream: true,返回就从“一个完整 JSON”变成“一条条增量片段”。这就是服务端推送在 AI 场景下的典型用法。
import requests

# 向大模型 API 发起流式请求,逐段读取返回内容
resp = requests.post(
    "https://api.example.com/v1/chat/completions",
    json={"model": "demo", "messages": [{"role": "user", "content": "你好"}], "stream": True},
    stream=True,
)
for line in resp.iter_lines():
    if line:
        print(line.decode("utf-8"))  # 每读到一段增量就立即处理
上面这段用 Python 的 requests 库(基础用法可参考 Python3 教程)发起一个流式请求,并逐行打印服务端推送过来的片段。预期结果是控制台一个片段一个片段地往外冒,而不是一次性出现整段文本。这段示例仅为说明协议形态,未执行,真实调用需替换为你自己的大模型 API 地址与鉴权信息,请以你方环境实测为准。
2.1 增量片段长什么样
非流式时,接口返回 { "content": "完整答案" };开流式后,你会连续收到若干 { "choices": [{"delta": {"content": "你"}}] } 这样的小片段,每个只带一点点新内容。前端要做的,就是把所有 delta.content 拼起来。不同厂商字段名略有差异,有的用 delta,有的包裹层级不同,接入前务必核对文档。
三、常见使用场景:什么时候该开流式
对话式 AI 产品几乎都默认开流式,因为用户能立刻看到第一个字,心理等待时间明显缩短。写代码助手、翻译、陪聊这类“边出边看”的场景,流式体验远好于一次性返回。
配置上,前端用 fetch 拿到响应后,通过 response.body.getReader() 持续读取;后端把大模型 API 的流式片段原样转发即可。运行后你会看到输出随生成进度增长,而不是卡住几秒后整段出现。下面在浏览器里用 JavaScript 教程 提到的 fetch 能力,给出前端读取流的骨架:
// 用 fetch 读取大模型 API 的流式响应,逐段追加到页面
const res = await fetch("/api/chat", { method: "POST", body: JSON.stringify({ q: "你好" }) });
const reader = res.body.getReader();
const decoder = new TextDecoder();
while (true) {
  const { value, done } = await reader.read();
  if (done) break;
  document.body.insertAdjacentText("beforeend", decoder.decode(value));  // 每读到增量就追加
}
上面这段在浏览器里持续把服务端推送的内容追加到页面。预期结果是输入框下方文字随生成进度一段段出现;若网络中断,循环会提前结束,需要你加重试逻辑兜底。
四、边界与误区:流式不是万能的
流式适合“看得见过程”的交互,但不适合“要拿完整结果再做判断”的任务。比如你要对输出做严格校验、格式解析或落库,最好等 stream 结束、拿到完整内容后再处理,否则中途片段并不完整,解析会失败。上线前建议先检查各厂商的增量字段命名是否一致,再用一段短文本验证返回结构是否符合预期,避免接入后才发现字段对不上。
版本方面,OpenAI 等主流大模型 API 自 2023 年起普遍支持 stream 参数;不同厂商的增量字段名略有差异,接入多家时要按文档核对。超时或断线时,前端应支持断点续传或整体重试,避免半截内容卡死。还有一个常见误区:以为流式能“让模型算得更快”。其实总计算量几乎一样,流式只是改变了内容到达前端的节奏,并不会缩短模型推理本身的时间。
总结
大模型流式输出是服务端把生成内容按令牌切分、通过服务端推送边生成边下发的能力,它让对话式 AI 实现逐字显示、缩短体感等待。要点带走:
- 流式适合“边出边看”的聊天、写作、翻译场景,用户体感更好;
- 后台批量、需完整校验的任务用普通请求更稳,避免中途片段不完整;
- 接入时认准
stream参数与各家增量字段差异,并做好断线重试。
大模型流式输出已成为对话式产品的标配能力,值得深入理解。
下一步想系统学 AI 应用开发,可以先过一遍人工智能教程打基础。
延伸学习
想把这块知识系统补齐,可以按这个顺序来:
- 想系统学 AI 应用开发,AI 实战课程 从项目角度串起完整链路;
- 想动手接 API,AI 编程技能教程 给了不少可参考的实战写法;
- 之前那篇 大模型实践笔记 从另一个角度讲了落地细节,适合延伸阅读。
常见问题
Q:流式输出是不是比非流式更快出结果?
A:不一定更快“算完”,但体感更快。模型总计算量差不多,流式只是把第一个字提前送到你眼前,让你觉得没在干等。
Q:断网或半路报错,已经显示的部分会丢吗?
A:前端若没做续传或重试,已显示内容通常保留在界面,但后续会中断。生产环境建议加整体重试或断点续传。
Q:所有大模型 API 都能开流式吗?
A:主流厂商基本都支持 stream 参数,但增量数据的字段命名和格式不完全一致,接入前务必核对对应厂商文档。



