 TRAE-AI编程

Vibe coding 指的是用自然语言描述你想要什么,让 AI 生成代码,你只管跑起来看结果,不逐行审查每一行。它上手快,适合做一次性小工具、原型验证和自动化脚本。它的边界也很清楚:涉及线上数据、权限、金额的代码,不能不看就上线。
初学者最容易被吸引的是「不用懂代码也能做东西」。这句话只在小工具范围内成立。真正决定成败的不是会不会写代码,而是能不能说清楚输入、输出和边界,以及能不能判断跑出来的结果对不对。
本文给出从零到跑通的五个步骤、一个完整可运行的示例、四个避坑点,以及判断什么场景该收手的具体标准。今天这篇文章,编程狮就把 Vibe coding 讲透。
先看结论
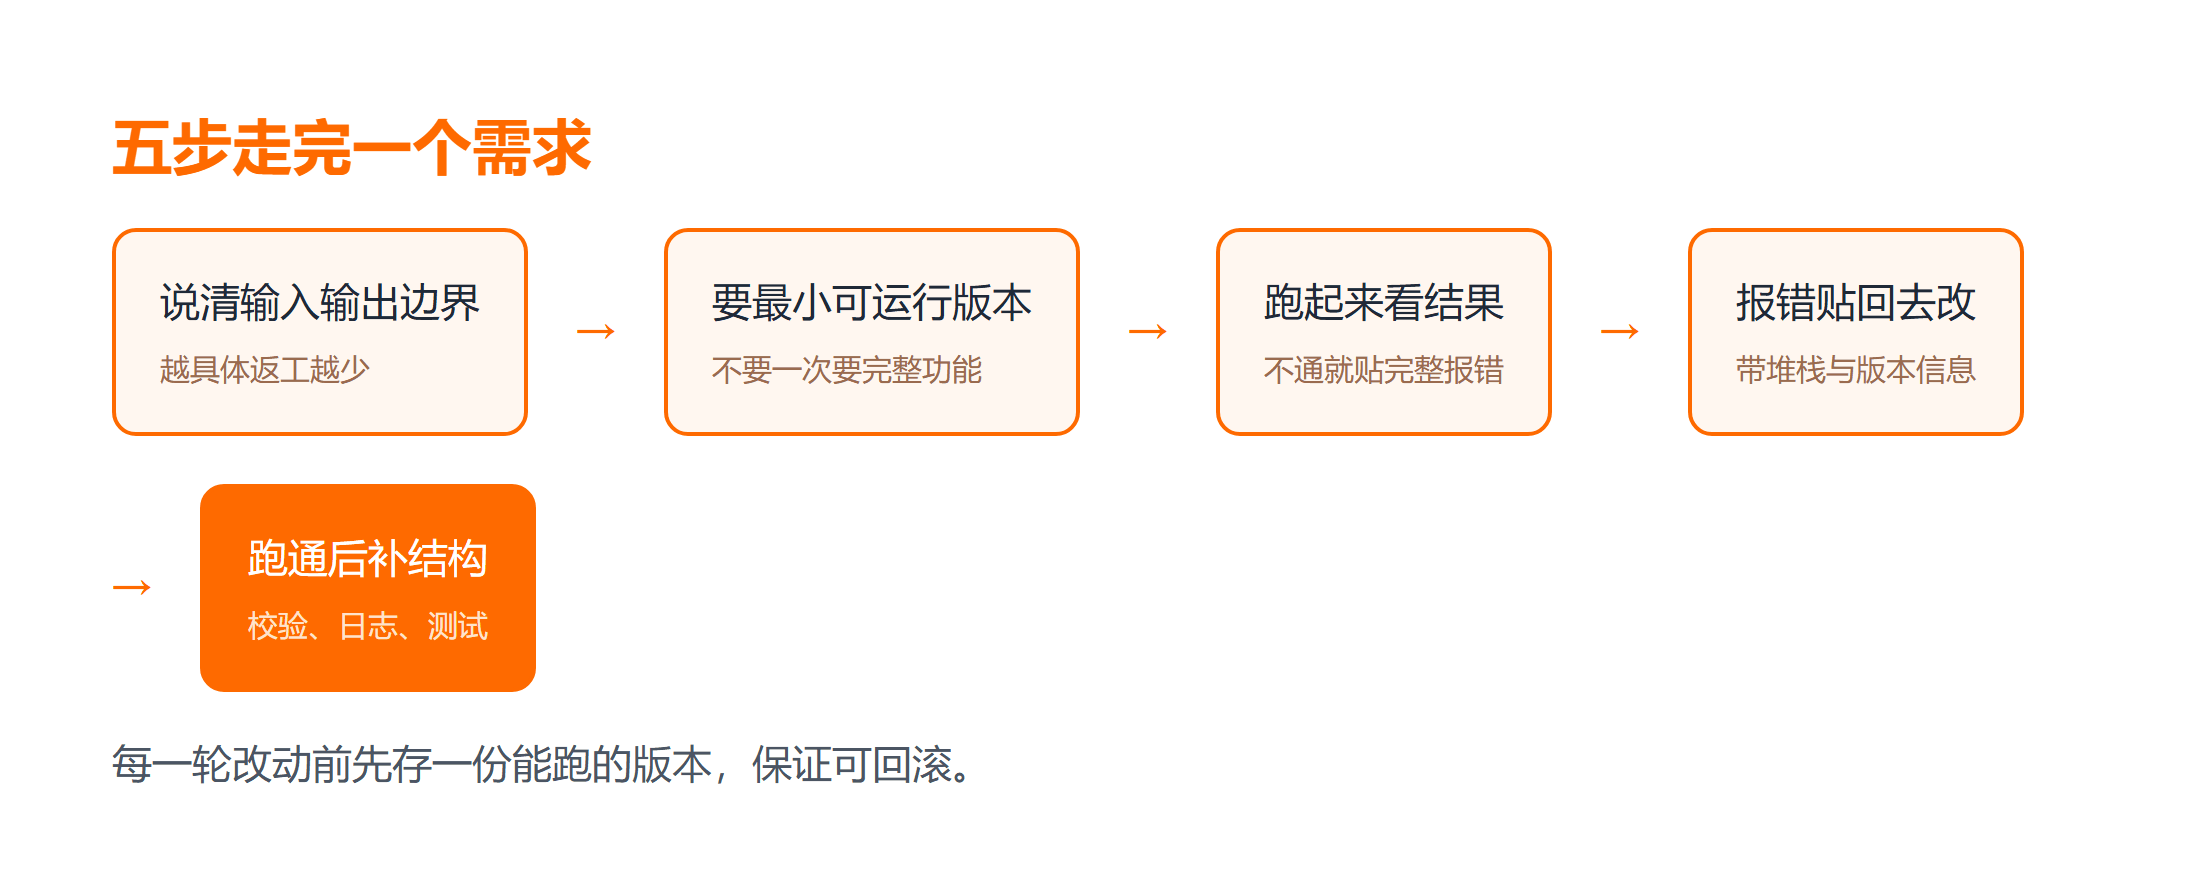
Vibe coding 的核心是把「写代码的动作」换成「描述需求 + 验证结果」两个动作。五个步骤是:说清目标、让它生成最小版本、跑起来看结果、报错就贴回去改、跑通后再补结构。
它的适用范围是一次性小工具和原型验证。不适用于线上服务、涉及权限与金额的逻辑,以及需要长期维护的代码——这些场景下,跳过审查省下的时间会在后面加倍还回去。
想看清这类工具的完整能力边界,可以先翻 AI 编程指南,再回来看步骤会更清楚。
一、它到底是什么:定义与边界
先把概念钉住,避免理解漂移。
1.1 一句话定义
Vibe coding 是一种工作方式:你描述需求与验收标准,AI 产出代码,你通过运行结果来判断对不对,而不是通过读代码来判断。
1.2 和传统写法的核心差别
| 维度 | 传统写法 | Vibe coding |
|---|---|---|
| 判断依据 | 读代码逻辑 | 看运行结果 |
| 出错处理 | 自己定位修复 | 把报错贴回去让它改 |
| 适合规模 | 中大型项目 | 一次性小工具 |
| 主要风险 | 写错逻辑 | 不知道它写了什么 |
1.3 三个常见误解
第一,以为它等于不用学编程。实际上描述需求的能力本身就要求你懂输入输出和边界。第二,以为它能直接产出可上线的代码。第三,以为跑通就等于正确——跑通只说明这条路径没报错,不代表边界情况都对。把这三类工作方式的差异理清楚,可以翻 AI 编程技能教程 对照着看。
⚠️ 注意:跑通和正确是两件事。一个只在示例数据上跑过一次的脚本,遇到空文件、超长字段、中文编码都可能出问题。
二、从零到跑通的五个步骤
按这个顺序做,每一步都能独立验证。
2.1 第一步:把需求说成「输入、输出、边界」
不要说「帮我做个处理 CSV 的工具」,要说「读一个 UTF-8 编码的 CSV,输出一个 JSON 数组,字段为空时保留空字符串,遇到编码错误直接报错不要静默跳过」。描述越具体,返工次数越少。
2.2 第二步:先要最小可运行版本
明确要求它先给一个能跑的最小版本,不要一次要完整功能。最小版本跑通后再逐步加,每一步都有可回滚的落点。
2.3 第三步:跑起来看结果
拿到代码先跑一遍。跑不通就把完整报错贴回去,不要自己猜着改。
2.4 第四步:报错贴回去让它改
这是 Vibe coding 效率最高的环节。贴报错时要带上完整堆栈和你用的版本信息,只贴一句「报错了」会浪费好几轮。
2.5 第五步:跑通后补结构
跑通之后才补参数校验、日志、测试。顺序反了会让调试变复杂,因为在没有基础结构的代码上加东西,出错时更难定位。
💡 小提示:每一轮对话前先把当前能跑的版本存一份。改动变坏时能立刻退回,比任何提示词技巧都管用。
三、完整示例:一个 CSV 转 JSON 小工具
下面这段是完整的、可直接运行的脚本,不依赖第三方库。
import csv
import json
import sys


def csv_to_json(src: str, dst: str) -> int:
    with open(src, encoding='utf-8') as f:
        rows = list(csv.DictReader(f))
    with open(dst, 'w', encoding='utf-8') as f:
        json.dump(rows, f, ensure_ascii=False, indent=2)
    return len(rows)


if __name__ == '__main__':
    if len(sys.argv) != 3:
        print('用法:python csv_to_json.py <输入.csv> <输出.json>')
        sys.exit(1)
    n = csv_to_json(sys.argv[1], sys.argv[2])
    print(f'共转换 {n} 行')
上面这段代码做的是:读入 CSV,按字典方式转成行列表,再以保留中文的方式写成 JSON,最后打印转换行数。参数个数不对时先打印用法再退出。
python csv_to_json.py data.csv out.json
上面这条命令做的是执行转换。预期结果(未执行,依据脚本逻辑)是终端打印「共转换 N 行」,并在当前目录生成 out.json。
用 Vibe coding 的方式拿到这段代码时,你的验收动作是:准备一个含中文和空字段的 CSV,跑一遍,打开 out.json 核对中文有没有被转义成 Unicode 序列、空字段是否保留。
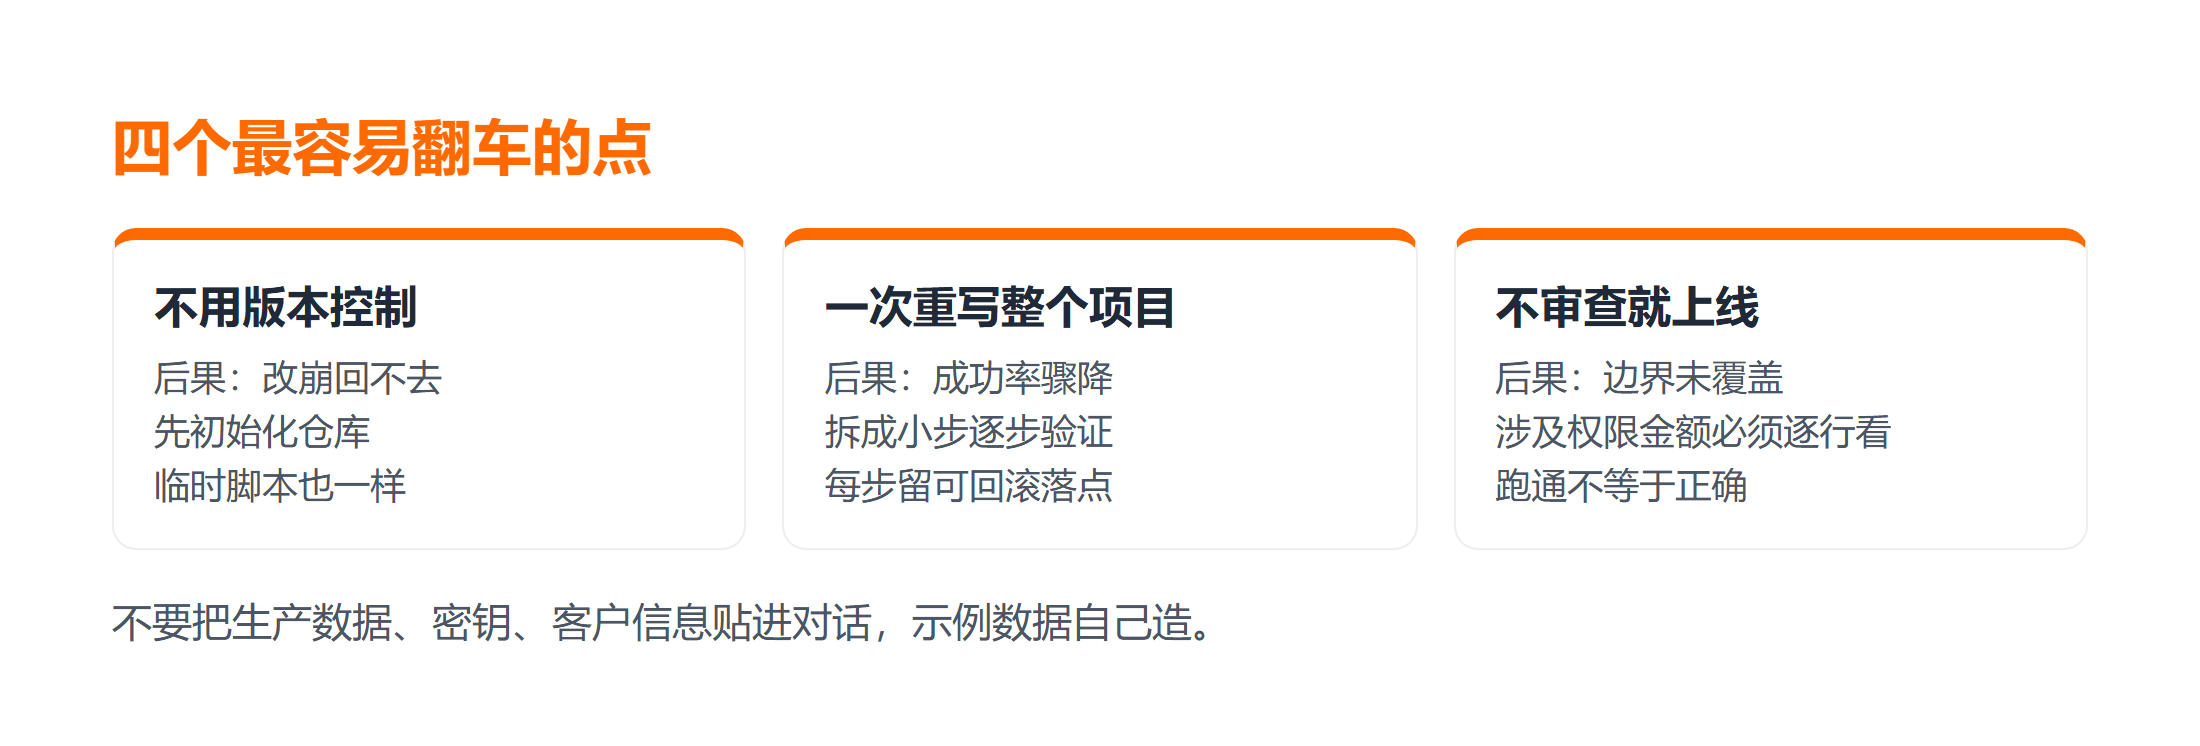
四、四个避坑点
这四个坑是实际用起来最容易翻车的地方。
4.1 不用版本控制
改崩了回不去是最常见的损失。哪怕是临时脚本,也先初始化一次仓库,至少保证有可回滚的落点。
4.2 让它一次重写整个项目
规模一大,成功率急剧下降。正确做法是拆成小步,每步跑通再继续。
4.3 不审查就用在线上
涉及数据库写入、权限判断、金额计算的代码,必须逐行看一遍再上线。Vibe coding 的产物没有经过设计,边界情况通常没覆盖。
4.4 不知道它写了什么
长期维护的项目里,如果你说不清某段代码在做什么,它就会变成没人敢动的死角。跑通之后至少把主流程读一遍。
⚠️ 注意:不要把生产环境的真实数据、密钥、客户信息贴进对话里。示例数据自己造,这一步没有例外。
总结
Vibe coding 是把「写代码」换成「描述需求加验证结果」的工作方式,五个步骤是描述清楚、要最小版本、跑起来、贴报错改、跑通后补结构。Vibe coding 适合一次性小工具和原型验证,不适合线上服务与需要长期维护的代码,这两者的分界要看代码会不会长期留在项目里。
要点带走:
- 描述需求要说清输入、输出、边界,越具体返工越少;
- 每一轮改动前先存一份能跑的版本,保证可回滚;
- 涉及权限、金额、数据库写入的代码必须逐行审查再上线。
下一步建议先拿一个真实的小需求完整走一遍五步流程,体会哪一步最耗时,再决定把它用在哪些环节。工具选择这块可以顺着 TRAE 编程中文教程 继续了解。
常见问题
Q:Vibe coding 是不是等于不用学编程?
A:不是。描述需求本身就要懂输入输出和边界,判断结果对不对也需要基础。Vibe coding 省的是敲键盘的时间,不是思考的时间,需求描述得越含糊,返工轮次就越多。
Q:跑通了是不是就说明代码没问题?
A:不是。跑通只说明这条路径没报错。空输入、超长字段、编码异常这些边界通常没被覆盖,需要自己补样例验证。
Q:适合用在公司项目里吗?
A:适合做原型、一次性脚本和内部小工具。涉及线上数据、权限和金额的部分要逐行审查,不能只看运行结果的写法。
Q:为什么让它改一个 bug 反而越改越乱?
A:多数是改动范围没限定。每次只让它改一处,改完先验证再提下一个,比一次提一堆要求要稳得多。
延伸学习
想把这种方式用稳,可以按这个顺序来:
- 读一篇相关笔记 AI 编程助手怎么选,看工具之间的差异;
- 想动手练,Python 配套课程 把基础补齐;
- 想理解模型为什么能写代码,可以看 大模型入门说明。