 免费 AI IDE

C 语言数组和指针经常写出相似表达式,但它们不是同一种东西:数组是连续元素组成的对象,指针是保存地址的变量。数组在多数表达式中会转换为首元素指针,这个自动转换才是混淆的来源。
本文用一个 int scores[4] 贯穿地址、sizeof、赋值、步进和函数传参。示例按标准 C11/C17 语义编写;当前环境没有 C 编译器,因此输出会明确标为预期结果(未在本机执行)。不同平台的指针字节数可能不同,不应把某个数字当语言规定。
一、先看结论:数组和指针的核心区别
| 对比项 | 数组 int scores[4] |
指针 int *cursor |
|---|---|---|
| 本质 | 连续元素组成的对象 | 保存地址的变量 |
| 能否赋值 | 数组名不能被赋值 | 指针变量可以重新指向 |
sizeof |
得到整个数组字节数 | 得到指针变量字节数 |
| 步进单位 | scores + 1 跨一个元素 |
cursor + 1 跨一个元素 |
| 取地址 | &scores 类型是 int (*)[4] |
&cursor 类型是 int ** |
| 函数参数 | 会调整为指针 | 本身就是指针 |
| 生命周期 | 由定义作用域决定 | 取决于指向对象和存储期 |
| 长度信息 | 在定义作用域内可由 sizeof 得到 |
不携带长度,必须另传 |
一句话:数组是对象,指针是变量;数组名在多数表达式中会退化为首元素指针,但数组本身没有消失。
二、先把数组对象和指针变量分开
#include <stdio.h>

int main(void) {
    // scores 是一个包含 4 个 int 的数组对象
    int scores[4] = {70, 80, 90, 100};

    // cursor 是指针变量,指向 scores 的第一个元素
    int *cursor = scores;

    // scores[0] 和 *cursor 都访问第一个元素
    printf("%d %d\n", scores[0], *cursor);

    // 指针后移,指向下一个 int
    cursor++;

    // 此时 cursor 指向 80
    printf("%d\n", *cursor);

    return 0;
}
预期结果(未在本机执行)是第一行 70 70,第二行 80。
scores 代表一整块能放 4 个 int 的数组对象;cursor 只保存其中一个元素的地址。cursor++ 会让指针移到下一个 int,不会移动数组本身。
C 语言数组与指针的第一条边界是可修改性:指针变量可以重新指向别处,数组名不能被赋值。
int scores[4] = {70, 80, 90, 100};
int *cursor = scores;

// 合法:指针变量可以重新指向
cursor = NULL;

// 非法:数组名不能被赋值
// scores = cursor;
若你对声明和解引用还不熟,可以先回看 C语言基础教程 的变量与指针章节。
三、地址看起来相同,含义和步进仍不同
scores 在多数表达式中转换为 &scores[0],所以打印二者常得到相同数值。可是 &scores 是“指向整个四元素数组的指针”,类型不同,步进也不同。
#include <stdio.h>

int main(void) {
    int scores[4] = {70, 80, 90, 100};

    // scores 在多数表达式中转换为 &scores[0]
    printf("%p\n", (void *)scores);

    // 显式取第一个元素的地址
    printf("%p\n", (void *)&scores[0]);

    // 分别计算 scores + 1 和 &scores + 1 的字节偏移
    printf("%td %td\n",
           (char *)(scores + 1) - (char *)scores,
           (char *)(&scores + 1) - (char *)&scores);

    return 0;
}
在常见 sizeof(int)==4 的平台,前两个地址数值相同;最后一行预期为 4 16。第一个加一跨过一个元素,第二个加一跨过整个数组。
这里的 4 和 16 只是该假设下的结果,严谨代码应使用 sizeof 计算,而不是写死。
| 表达式 | 类型 | 加一步进 | 说明 |
|---|---|---|---|
scores |
多数表达式中转为 int * |
跨 1 个 int |
首元素指针 |
&scores[0] |
int * |
跨 1 个 int |
首元素地址 |
&scores |
int (*)[4] |
跨整个数组 | 指向数组对象 |
scores + 1 |
int * |
跨 1 个 int |
指向第二个元素 |
&scores + 1 |
int (*)[4] |
跨 4 个 int |
指向数组之后 |
💡 小提示:数组名转换有例外。作为
sizeof的操作数、取地址运算符&的操作数时,它仍表示数组类型,而不是先变成元素指针。
四、sizeof 最能暴露 C 语言数组与指针差异
#include <stdio.h>

int main(void) {
    int scores[4] = {70, 80, 90, 100};
    int *cursor = scores;

    // 分别输出数组大小、指针大小、元素大小和数组长度
    printf("array=%zu pointer=%zu element=%zu length=%zu\n",
           sizeof scores,
           sizeof cursor,
           sizeof scores[0],
           sizeof scores / sizeof scores[0]);

    return 0;
}
若 int 是 4 字节、指针是 8 字节,预期输出为:
array=16 pointer=8 element=4 length=4
sizeof scores 计算完整数组,sizeof cursor 只计算指针变量。数组长度公式只能在数组仍是数组的作用域使用。
| 场景 | 写法 | sizeof 结果 |
说明 |
|---|---|---|---|
| 数组定义作用域 | sizeof scores |
整个数组字节数 | 16(假设 int 为 4 字节) |
| 指针变量 | sizeof cursor |
指针变量字节数 | 8(假设指针为 8 字节) |
| 单个元素 | sizeof scores[0] |
一个元素字节数 | 4 |
| 数组长度 | sizeof scores / sizeof scores[0] |
元素个数 | 4 |
| 函数参数内 | sizeof values |
指针大小 | 不是原数组长度 |
| 动态内存 | sizeof pointer |
指针大小 | 无法恢复分配长度 |
所谓 sizeof 数组,本质是让编译器读取数组类型里保存的元素数量,而不是运行时沿内存寻找结束位置。字符数组可能用 \0 作为字符串终止标记,普通整数数组没有哨兵;即使字符数组里有终止标记,sizeof 也统计分配的全部字节,strlen 才统计终止标记前的字符数。把两者混用会造成长度少一位,或把未使用容量算进有效数据。
这一点与 C++ 中的原生数组也有关,但 C++ 还能用容器与模板保留更多类型信息。想对照差异时可查看 C++基础教程,不要把 std::array 的行为反推给 C 数组。
五、函数参数写成数组,进入函数后仍是指针
#include <stddef.h>

// 参数写成 const int values[],实际会调整为 const int *values
int sum_scores(const int values[], size_t length) {
    int total = 0;

    // 函数内部不知道数组长度,必须依赖调用者传入 length
    for (size_t i = 0; i < length; i++) {
        total += values[i];
    }

    return total;
}
参数 const int values[] 会调整为 const int *values。函数收到首元素地址,不知道调用者数组有几项。因此必须把 length 一起传入。
在函数内部写 sizeof values / sizeof values[0] 得到的是指针大小除以元素大小,通常不是原数组长度。
// 在函数内部,这种写法通常得不到原数组长度
// sizeof values 得到的是指针大小
C 语言函数参数中的 [] 更像“这里接收一段连续元素”的阅读提示,不会复制整个数组。二维数组还必须保留后续维度,例如 int a[][4],因为编译器需要知道跨一行要移动多少字节。
| 函数参数写法 | 实际类型 | 是否复制数组 | 能否得到原长度 |
|---|---|---|---|
int values[] |
int *values |
否 | 不能 |
int values[10] |
int *values |
否 | 不能 |
int *values |
int *values |
否 | 不能 |
int values[][4] |
int (*values)[4] |
否 | 不能 |
六、三个常见错误怎样定位
第一个错误是返回局部数组首地址。函数结束后数组生命周期结束,指针变成悬空指针。应由调用者提供缓冲区,或使用明确的动态分配与释放约定。
// 错误示例:返回局部数组首地址
// int *get_scores(void) {
//     int scores[4] = {70, 80, 90, 100};
//     return scores; // 函数结束后 scores 生命周期结束
// }
第二个错误是越过数组边界。指针算术只在同一数组对象及其尾后位置范围内有定义;尾后指针可以比较,不能解引用。
第三个错误是把字节数当元素数,特别是在函数参数里误用 sizeof。
排错时依次记录变量声明、元素数量、每次索引范围和所有权。编译时开启警告,并使用 AddressSanitizer 等工具检查越界;本文没有可用编译器,不能把预期输出写成实测结果。
| 常见错误 | 现象 | 定位方法 |
|---|---|---|
| 返回局部数组首地址 | 悬空指针、随机值 | 检查返回指针指向的生命周期 |
| 越过数组边界 | 越界读写、崩溃 | 记录索引范围,开启 ASan |
函数内误用 sizeof |
长度算成指针大小 | 打印 sizeof values |
| 把字节数当元素数 | 循环次数错误 | 区分字节数与元素个数 |
| 指针未初始化 | 野指针 | 声明后立即初始化或置 NULL |
七、复杂声明与动态内存
还要区分三种容易看花的声明:const int *p 表示不能通过 p 修改元素;int *const p 表示 p 不能改指向;int (*p)[4] 是指向四元素数组的指针。它们分别约束数据、指针变量和步进单位。
int scores[4] = {70, 80, 90, 100};

// 不能通过 p 修改元素,但 p 可以重新指向
const int *p1 = scores;

// p2 不能改指向,但可以通过 p2 修改元素
int *const p2 = scores;

// 指向四元素数组的指针,加一步进跨整个数组
int (*p3)[4] = &scores;
阅读复杂声明时,从变量名向外按括号展开,再检查 const 修饰的是星号左侧还是右侧。
| 声明 | 含义 | 能否改指向 | 能否改元素 |
|---|---|---|---|
const int *p |
指向常量的指针 | 能 | 不能 |
int *const p |
常量指针 | 不能 | 能 |
int (*p)[4] |
数组指针 | 能 | 能 |
int *p[4] |
指针数组 | 不适用 | 不适用 |
动态内存也不会自动变成数组类型。malloc(4 * sizeof(int)) 返回一段足够大的存储,接收它的变量仍是指针,sizeof pointer 不能恢复分配长度。
#include <stdlib.h>

// 分配 4 个 int 的存储,但 ptr 仍然只是指针
int *ptr = malloc(4 * sizeof(int));

// sizeof ptr 是指针大小,不是 4 * sizeof(int)
工程代码应把指针与元素数量放进同一个结构体,统一创建、传递与释放,避免长度在调用链中丢失。
typedef struct {
    int *data;
    size_t length;
} IntArray;
总结
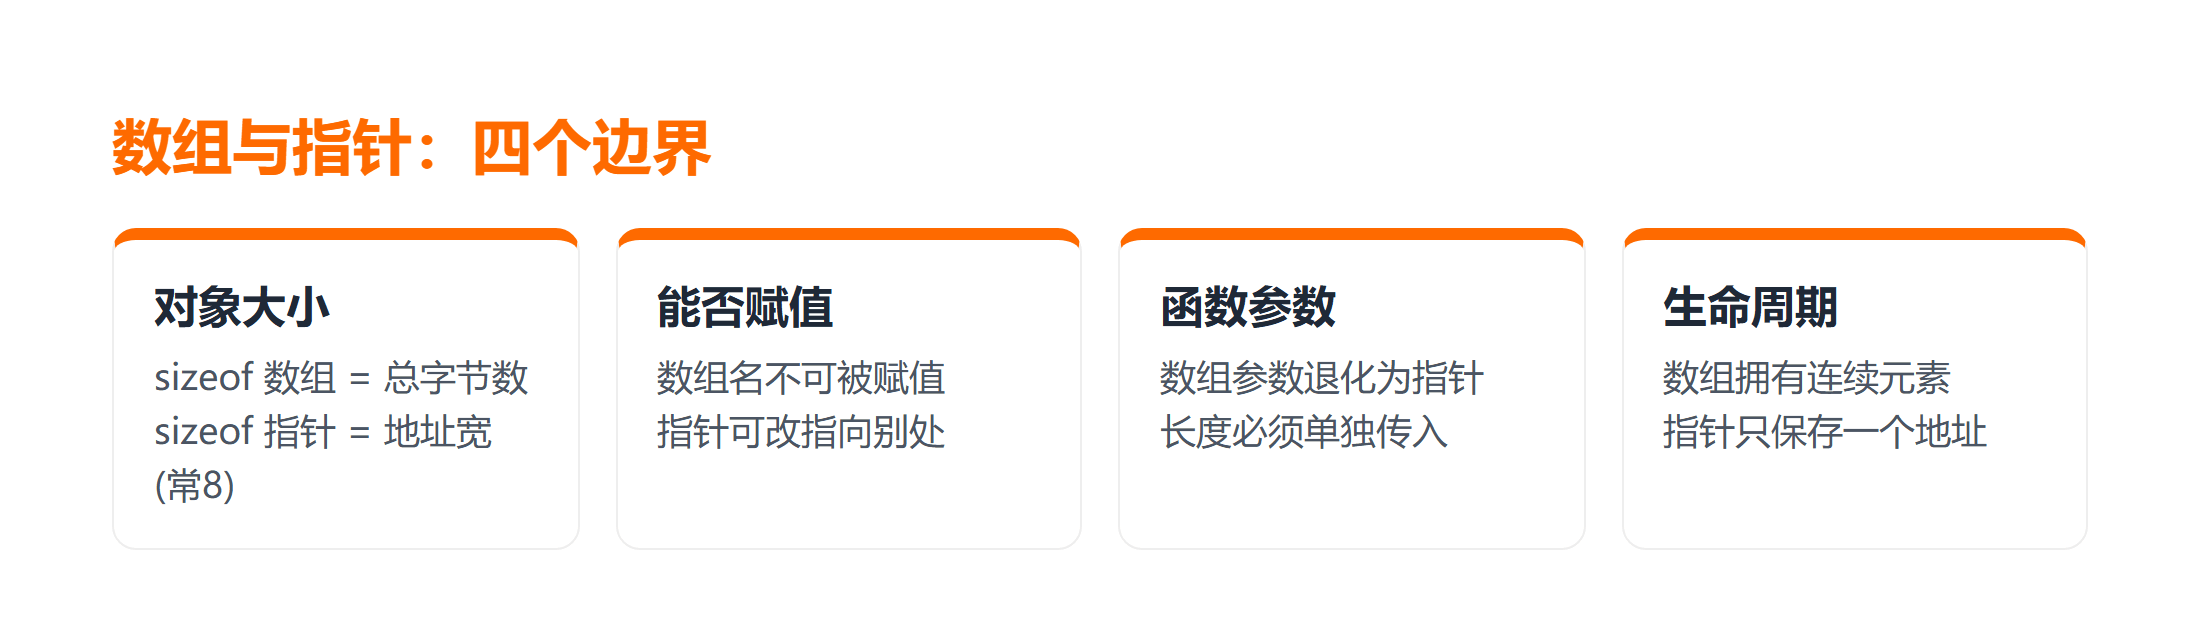
C 语言数组和指针之所以像,是因为数组表达式经常自动转换为首元素指针;它们之所以不能混为一谈,是因为对象大小、能否赋值、生命周期和函数参数信息完全不同。
记住四点:
- 数组拥有连续元素,指针只保存地址;
sizeof在原作用域能得到数组总字节数;- 数组参数进入函数后按指针处理;
- 长度和所有权必须显式传递。
掌握这些边界后,再看字符串、动态内存和二维数组会清晰很多。
延伸学习
- 想继续学习相近语法,可进入 C++入门课程 对照容器与原生数组;
- 需要练习声明和索引,可使用 编程题库 自测;
- 还没搭好编译环境时,先读 C语言编译器工作原理,理解源码到可执行文件的路径。
常见问题
Q:数组名就是常量指针吗?
A:不是。这个说法便于记忆,却不准确。数组名在多数表达式中会转换为指针,但数组本身仍是独立对象,也没有一个可被赋值的“常量指针变量”。
Q:为什么函数里算不出数组长度?
A:数组参数会调整为指针,函数只拿到首元素地址。把长度作为独立参数传入,或用结构体同时包装指针与长度。
Q:scores 和 &scores 地址为什么一样?
A:它们通常指向同一块起始内存,所以数值相同;类型不同,执行加一时分别跨一个元素和整个数组。
Q:指针一定是 8 字节吗?
A:不一定。它取决于目标平台和编译模型。代码需要指针大小时应写 sizeof(pointer),不要假设 32 位或 64 位结果。