 免费 AI IDE

AI 生成代码的验收顺序是先核对需求和依赖,再运行独立测试,最后检查输入边界与副作用。能运行一次只证明某条路径没有立刻出错,并不证明金额算对、非法数据被拒绝,或者新增依赖确实必要。把生成结果直接合并,容易把这些问题一起带进项目。
本文用一个“订单满额减免”函数演示验收过程。案例使用 Python 3.12 及以上版本的标准库,没有外部包和网络调用。你会得到业务规则、实现、自测文件和失败判据。重点是如何检验 AI 给出的答案,而不是用某个工具的名称替代工程判断。
一、先把需求写成机器能检查的约定
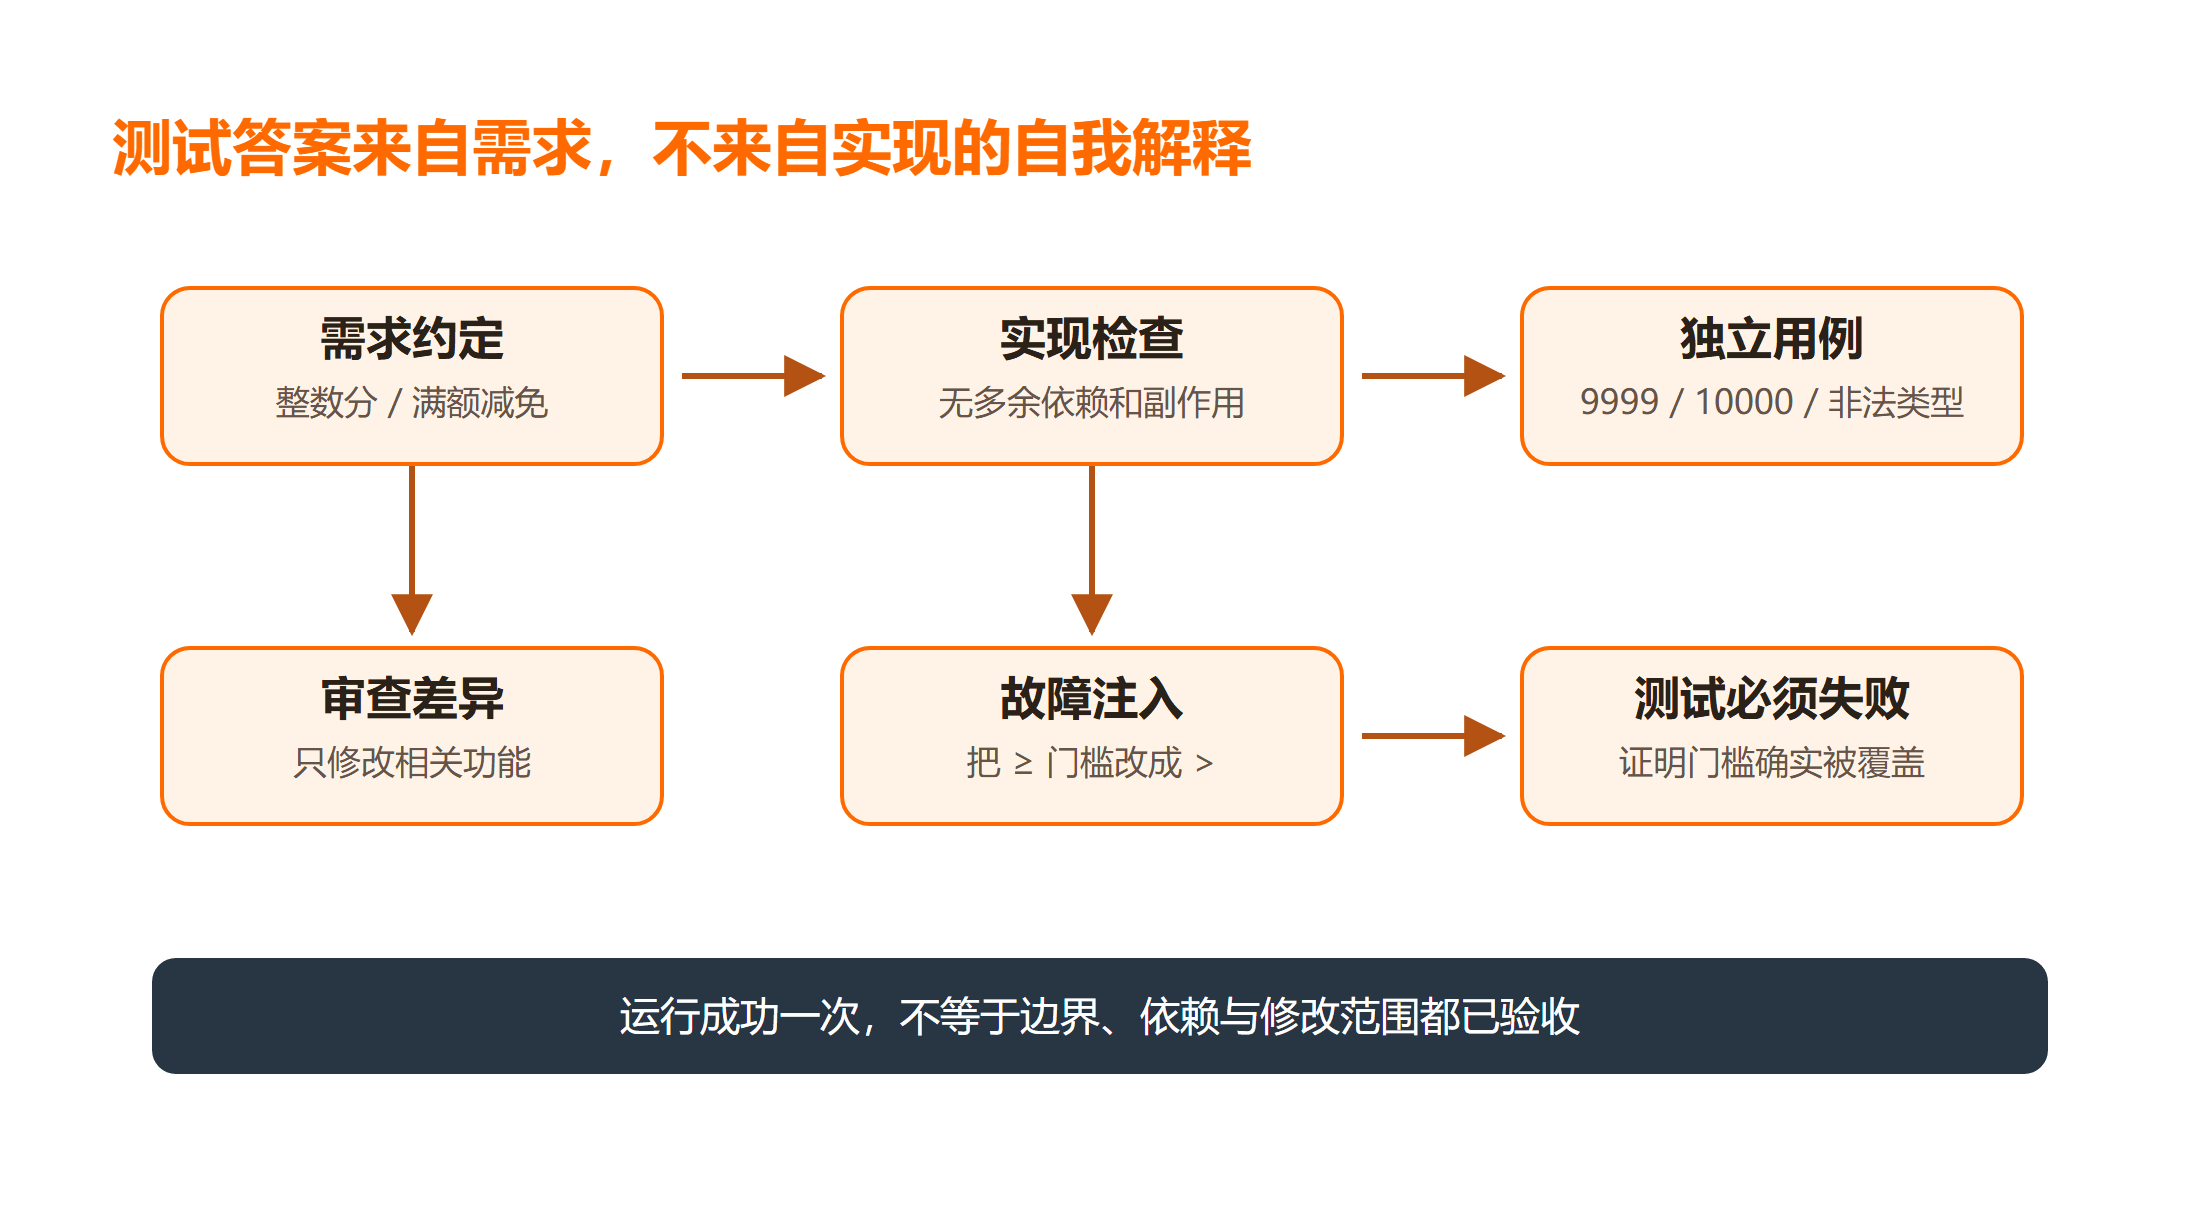
需求不能只写“算优惠价格”。本例明确规定:金额以整数分传入;满一万元分可以减两千分;不足门槛不减;负数、小数和布尔值不接受;函数只返回结果,不修改文件或访问网络。换成另一套业务规则,测试也必须跟着改变。
这份约定像验收清单,不规定 AI 必须用哪种写法,却规定结果必须满足什么条件。否则生成器可以写出语法正确的另一种促销算法,你却误以为它理解了需求。
可以结合 AI 编程技能教程 学习怎样描述上下文。提示词里最好给出输入类型、单位、边界、错误行为,以及明确不需要的外部操作;不要只要求“代码专业一点”。
先手算门槛前后两笔订单:九千九百九十九分仍是原价;一万元分应变为八千分。测试值取在门槛附近,比随意选择两个大金额更能发现“大于”和“大于等于”写反的问题。
二、依赖检查:这个功能是否需要安装包
一个整数比较和减法函数不需要第三方库。如果生成代码突然引入陌生折扣包,先要求说明它解决了什么问题。包名看起来像真实项目,并不能证明它存在、可信或适用;不要顺手执行安装命令再研究来源。
本例只导入 unittest 作为测试工具,它属于标准库。真实项目确实需要外部依赖时,应到官方仓库或包索引核对名称、版本约束、许可证与维护信息,并审查新增依赖文件的差异。锁定版本能减少环境漂移,但不能替代来源审核。
依赖检查也要看运行过程有没有额外动作:模块导入时是否访问网络,测试时是否读取工作区外的配置,安装步骤是否运行项目脚本。遇到超出功能需求的动作,先解释用途,再决定是否保留。
对于不了解的语言语法,可以用 Python3 教程 核对基本行为。尤其注意 Python 中布尔值与整数类型的关系:如果需求明确拒绝布尔值,宽泛的整数实例判断可能不够严格。
三、独立测试:从业务规则得出期望值
将实现保存为 discount.py。这里给出一份满足上述约定的参考实现,便于你把自己的生成结果放进同一测试流程比较。
def final_price(amount_cents):
    if type(amount_cents) is not int:
        raise TypeError("金额必须是整数分")
    if amount_cents < 0:
        raise ValueError("金额不能为负")
    if amount_cents >= 10000:
        return amount_cents - 2000
    return amount_cents
它没有把小数强制转整数,也没有把负数改成零。错误输入被显式拒绝,调用方才知道自己传了不符合约定的数据。若业务希望接受金额字符串,应另写输入解析层,不能让计算函数偷偷扩大输入范围。
将下面文件保存为 test_discount.py,与实现放在同一目录,运行 python -m unittest -v。
import unittest
from discount import final_price

class DiscountTests(unittest.TestCase):
    def test_thresholds(self):
        for amount, expected in [(0, 0), (9999, 9999), (10000, 8000), (15000, 13000)]:
            with self.subTest(amount=amount):
                self.assertEqual(final_price(amount), expected)

    def test_negative(self):
        with self.assertRaises(ValueError):
            final_price(-1)

    def test_wrong_types(self):
        for value in [True, False, 100.5, "10000", None]:
            with self.subTest(value=value):
                with self.assertRaises(TypeError):
                    final_price(value)

if __name__ == "__main__":
    unittest.main()
测试的期望值来自前面的业务约定,而不是复制实现里的条件。让 AI 同时生成实现和测试并非一定无效,但它们可能共享同一个误解;人工应至少独立核对关键边界。
还可以做一次故障注入:在副本中把门槛条件改成严格大于,再运行测试。一万元分那条应失败。如果测试仍然通过,就说明测试没有覆盖你声称检查过的边界。故障注入后应恢复正确实现,不要把故意制造的错误合并。
四、安全检查与合并条件要落到具体行为
这个函数没有文件、网络、命令执行或数据库操作,审查重点就是类型、范围和金额规则。不要为了写一份很长的安全报告,声称它已经防住所有攻击。能确认的是本例的明确输入集合和已执行测试,而不是无限范围的安全保证。
换成处理上传文件的生成代码,检查目标就应变成路径边界、文件大小和覆盖行为;换成数据库代码,则检查查询参数与权限;换成自动化脚本,就看重复运行会不会重复写入。审查应随真实副作用变化。
| 验收项 | 本例通过条件 | 不足以通过的证据 |
|---|---|---|
| 需求 | 单位、门槛与错误规则一致 | 注释说“支持优惠” |
| 依赖 | 只使用已说明的标准库 | 安装命令没有报错 |
| 测试 | 正常、边界、非法类型均覆盖 | 只调用一次 |
| 修改范围 | 仅新增计算与测试文件 | 整个仓库被自动格式化 |
合并前查看真实差异,确认没有顺带修改无关配置。记录测试命令、解释器版本与执行结果,让别人能复现。若只能完成静态审查,就写“未执行”,不能把分析过程描述成运行通过。
总结
AI 生成代码的质量,需要由外部约定和实际证据判断。需求给出正确答案的边界,依赖检查解释新增成本,独立测试验证关键行为,差异审查确认修改范围。四者共同决定是否接受实现。
你可以把下一段生成代码先缩成一个最小功能,手算两个边界结果,再写测试。等小范围行为明确后再逐步接入项目,遇到失败就定位具体输入与输出,而不是反复要求模型“再优化一次”。
延伸学习
- AI 人工智能教程 可补相关基础概念,帮助区分生成能力与验证责任。
- AI 开发实战课程 可作为完整项目练习方向,实践时仍需保留自己的验收规则。
- AI 编程效率研究解读 可作为理解效率与验证成本关系的延伸阅读,不能把特定研究数字当作所有团队的结论。
常见问题
Q:测试全通过就能直接合并吗?
还要看测试是否覆盖实际需求,以及修改范围、依赖和副作用是否合理。测试通过只说明已执行的用例满足断言,不证明所有可能输入都正确。
Q:可以让另一个 AI 做代码审查吗?
可以作为补充,但要提供独立规则与原始证据。若它只复述生成代码的解释,没有核对边界和运行结果,仍不能替代验收。
Q:为什么特别测试 True 和 False?
因为本例要求严格整数金额,而 Python 的布尔值与整数存在类型关系。这是针对具体语言行为设置的用例,不是随意凑出的异常输入。
技术依据:Python unittest 官方文档。