
 TRAE-AI编程

让大模型按 JSON 模式输出,结果里的代码块却把引号、换行折腾成一团乱麻?最直接的答案是:JSON 字符串必须使用反斜杠转义,把换行写成 \n、双引号写成 \",而代码块里的反斜杠本身要写成 \\;更稳的做法是让模型直接输出结构化字段,别把整段代码塞进一个字符串。本文用可复制的示例讲清三种写法的输入、输出和失败边界,帮你在 JSON 模式里既保住代码内容,又让结果能被程序稳定解析。全文基于 JavaScript 与 JSON 标准,环境差异在文末说明。今天这篇文章,编程狮把这块讲透。
先看结论
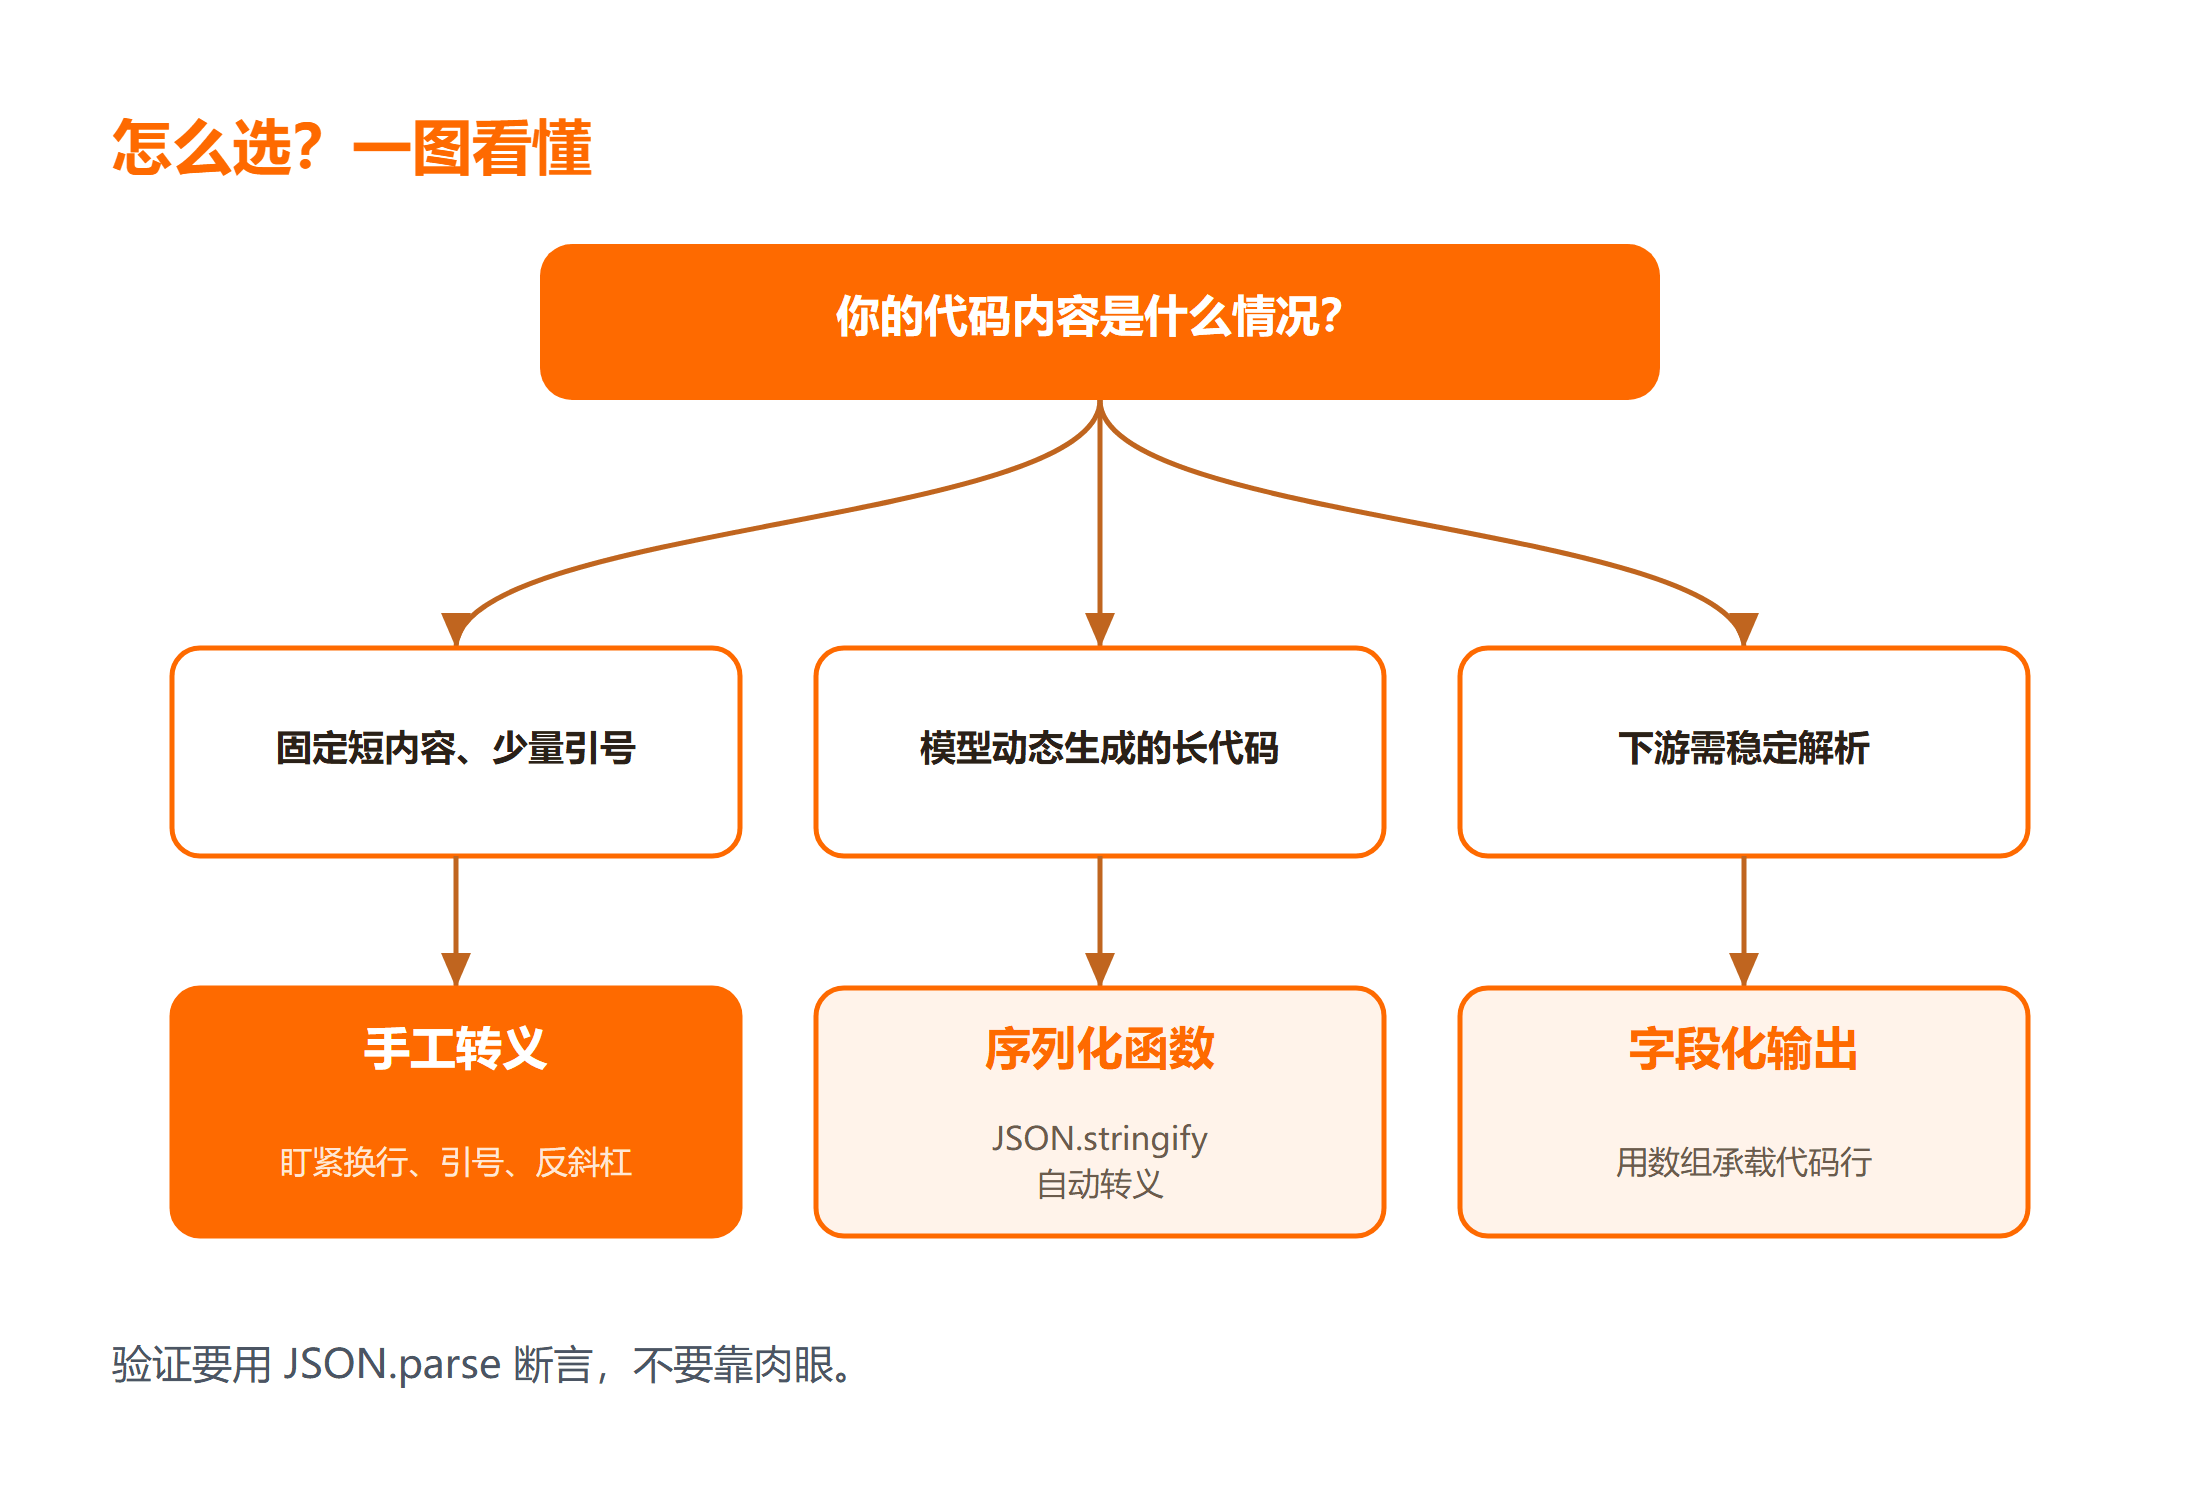
代码块转义到底怎么配才稳,先看三条能落地的结论:第一,凡是要进 JSON 字符串的内容,换行、双引号、反斜杠三类字符必须转义,少一个都会让解析失败;第二,如果要在字符串里保留一段代码,最稳的不是手工拼转义,而是用语言自带的序列化函数生成,例如 JavaScript 的 JSON.stringify;第三,能不把代码塞进字符串就不塞,用 JSON 的字段或数组结构表达代码行,从根上绕开转义。
判断用哪种的标准很直接:临时手写一个短字符串,手工转义可控;要程序化生成或内容里有引号反斜杠,用序列化函数;要让下游稳定解析、还要保留代码结构,改用字段化输出。想先把 JSON 的语法规则弄清,可过一遍 JavaScript 教程 的相关章节。
一、先弄清为什么会乱:JSON 字符串的转义规则
JSON 是一种严格的数据格式,字符串必须用双引号包起来,而字符串内部如果出现双引号、换行、反斜杠,就必须转义,否则解析器会把它当成字符串结束或非法字符。代码块恰恰是这三类字符的密集区:每行结尾有换行,字符串字面量带双引号,正则或路径里有反斜杠。
常见失败现象有三种:一是输出看起来是 JSON,但 JSON.parse 直接报 Unexpected token,多半是某个双引号没转义;二是解析成功但代码里的换行全没了,变成一长行,这是把换行当成真实换行写进了字符串;三是路径里的 \n 被当成换行符吃掉,本意是字面反斜杠加 n。理解这三类,后面定位问题就有方向。
一个高频误区:把"能打印出来"当成"转义正确"。控制台打印时换行会显示成换行,人眼看着没问题,但这个字符串若含未转义的真实换行,严格 JSON 解析依然会失败。验证要用解析器,不要用眼睛。
二、写法一:手工转义,适合短小固定内容
手工转义是最直观的方式:把换行写成 \n,双引号写成 \",反斜杠写成 \\。看一个最小示例:
// 手工转义:把两行代码放进一个 JSON 字符串
const raw = 'const a = "x";\nconsole.log(a);';
const obj = { code: raw };
const json = JSON.stringify(obj);
console.log(json);
// 输出:{"code":"const a = \"x\";\nconsole.log(a);"}
注意输出里代码原本的双引号变成了 \",换行变成了 \n。这就是合法的 JSON 字符串。用 JavaScript 速查手册 核对转义字符表,能少踩很多坑。
手工转义的边界很明显:内容一长、引号一多,漏转义的概率陡增。它适合固定、短小、你已经逐字确认过的内容,不适合由模型动态生成的长代码块。
三、写法二:用序列化函数,适合动态内容
更稳的做法是不手工拼转义,而是把内容交给语言的序列化函数。JavaScript 里用 JSON.stringify,它会自动处理所有需要转义的字符:
// 序列化:让函数负责转义,避免手工遗漏
const codeLines = ['const a = "x";', 'console.log(a);'];
const payload = { language: 'javascript', code: codeLines.join('\n') };
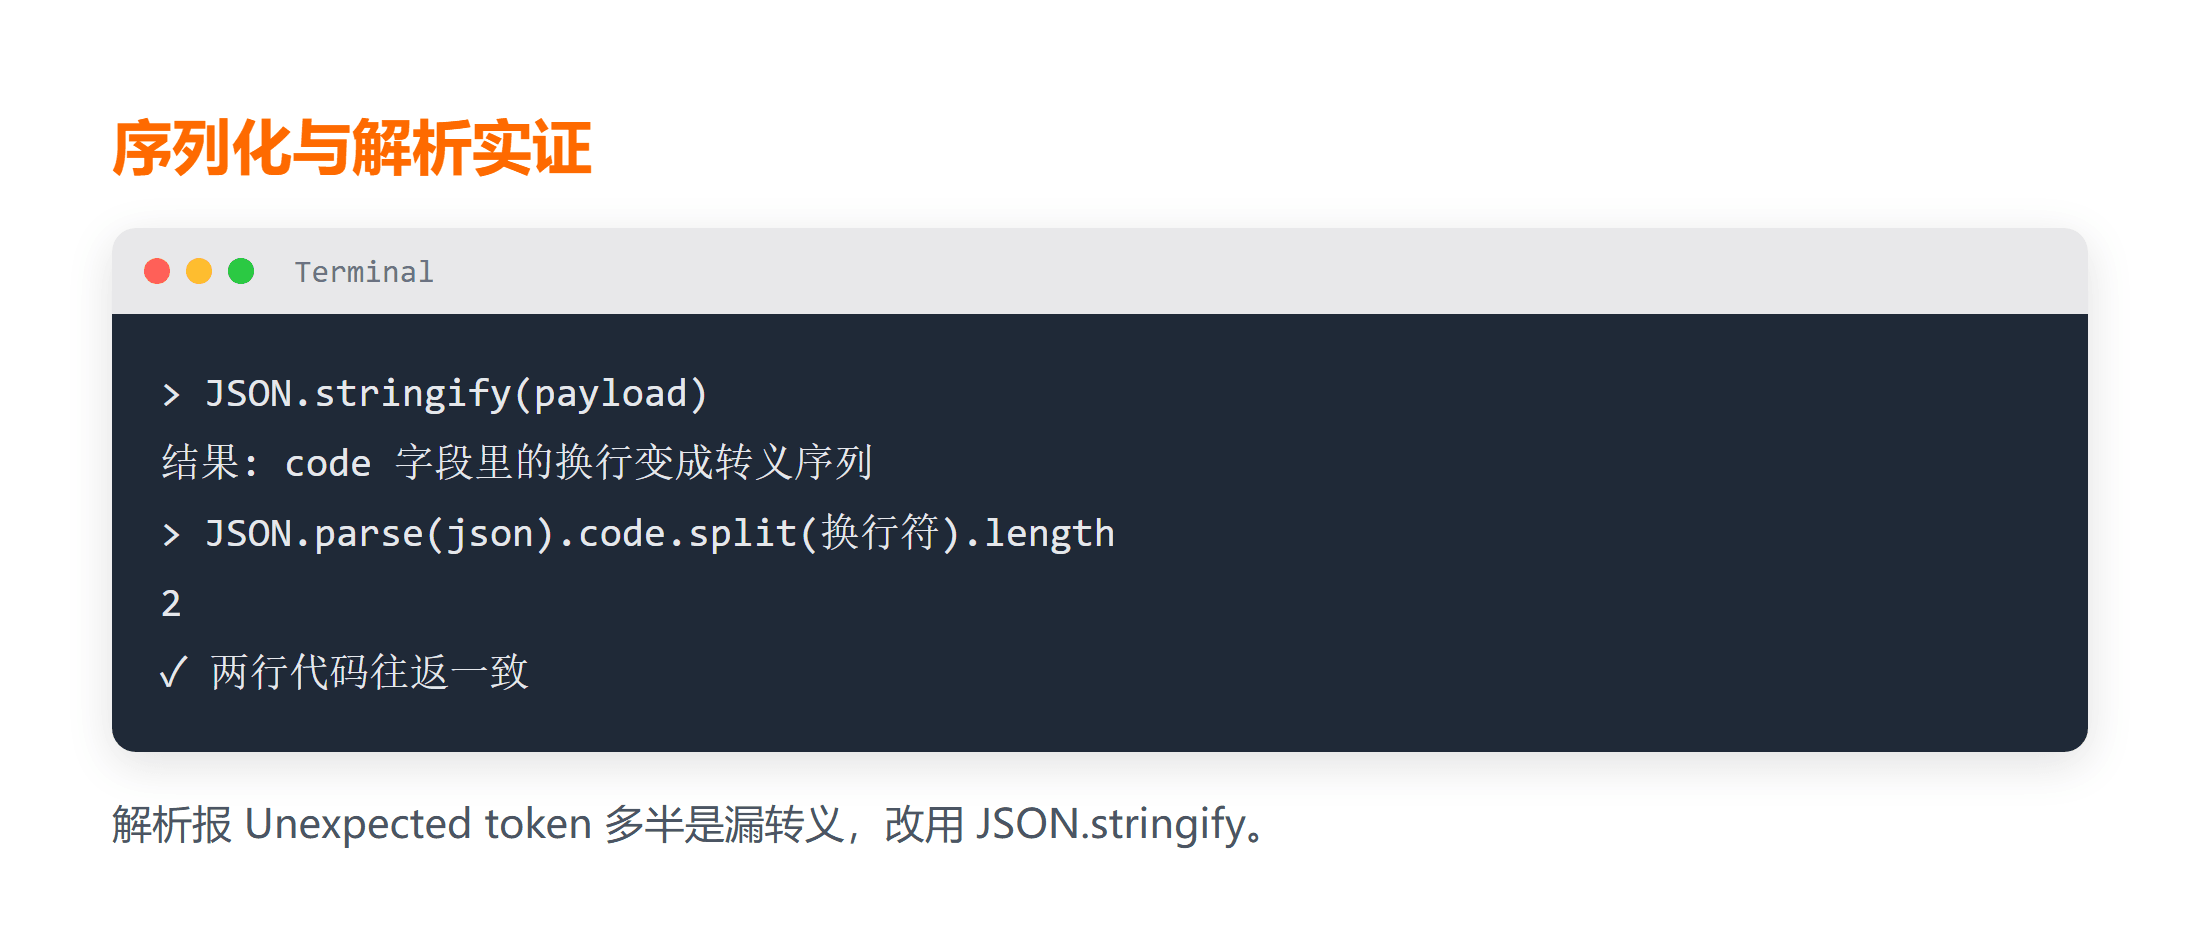
const json = JSON.stringify(payload);
console.log(json);
// 输出:{"language":"javascript","code":"const a = \"x\";\nconsole.log(a);"}

// 验证能否被正确解析回来
const parsed = JSON.parse(json);
console.log(parsed.code.split('\n').length); // 2
这套写法的价值在于"往返一致":序列化后再解析,内容与原始一致。split('\n').length 得到 2,说明两行代码都完整保留。检查解析结果要用程序断言,别靠打印肉眼看。
3.1 失败分支怎么处理
- 解析报
Unexpected token:多半是有人手工拼了 JSON 字符串却漏转义。改用JSON.stringify生成,不要手工拼。 - 反斜杠被吞掉:本意是字面
\n,结果变成换行。原因是少写了一层转义,字面反斜杠要写成\\n。用序列化函数可自动避免。 - 模型输出不是合法 JSON:即使声明了 JSON 模式,模型偶尔仍会带前后缀文字。解析前先截取第一个
{到最后一个}之间的内容,再解析。
修复顺序是"先让解析器通过,再谈内容完整",一次只改一处转义,避免同时动多个变量导致无法定位。每改完一处就重新运行脚本,把实际输出和预期结果对一遍,确认问题真的解决再进入下一处。
四、写法三:字段化输出,从根上绕开转义
如果下游要稳定解析,最彻底的办法是别把整段代码塞进一个字符串,而是让模型按结构输出:把代码的每一行作为数组的一个元素,或用 lines 字段承载。这样换行天然由数组结构表达,字符串里不再有换行符需要转义。
| 写法 | 输入成本 | 转义风险 | 适用场景 |
|---|---|---|---|
| 手工转义 | 低 | 高,越写越易漏 | 固定短内容 |
| 序列化函数 | 中 | 低,函数自动处理 | 动态生成内容 |
| 字段化输出 | 中 | 最低,结构即语义 | 下游需稳定解析 |
对比三类写法可以看出:字段化输出的解析风险最低,代价是提示词和消费端要做相应适配。这是结构复杂度与解析稳定性的取舍,不是哪种绝对更好。性能上三者差异很小,真正的开销在于模型生成更长的结构化文本。
总结
JSON 模式里代码块转义的稳法有三层:短内容手工转义要盯紧换行、双引号、反斜杠三类字符;动态内容用 JSON.stringify 让函数负责转义,保证序列化与解析往返一致;需要下游稳定解析时,改用字段或数组承载代码行,从结构上消除转义需求。无论哪种,验证都要用 JSON.parse 这样的解析器做断言,而不是靠控制台打印的肉眼效果。
常见问题
Q:为什么我打印出来的 JSON 看着正常,解析却失败?
A:控制台会把真实换行显示成换行,人眼难以区分"转义的 \n"和"真实换行"。严格 JSON 不允许字符串里出现未转义的真实换行,所以必须用解析器验证,例如 JSON.parse,能通过才算合法。
Q:JSON.stringify 会帮我处理所有转义吗?
A:它会处理 JSON 规范要求的转义字符,包括双引号、反斜杠和控制字符。但它不会替你修正"内容本身想表达字面反斜杠"的语义问题——这类要在构造原始字符串时就写对,或用数组结构避免。
Q:模型声明了 JSON 模式为什么还输出非 JSON 内容?
A:JSON 模式约束的是生成倾向,不保证百分之百合规。稳妥做法是在解析前做清洗:截取首尾花括号之间的内容、去掉代码块围栏标记,再解析;解析失败时按失败分支重试一次。
延伸学习
想把这块知识系统补齐,可以按这个顺序来:
- 想系统学 JSON 文件的读写,可以看 Python读取JSON文件方法;
- 对照"JSON 文件是什么"的基础写法,翻 什么是JSON文件JavaScript示例;
- 需要快速验证 JSON 与 XML 互转时,用 XML与JSON互转 辅助核对结构。



