
 TRAE-AI编程

结论先说:用智谱 GLM 辅助写正则,最危险的一步不是"让它写出来",而是"写完就直接用到生产里"。正则校验必须自己做:把模型给的表达式,套进一组你已知的"该匹配"和"不该匹配"的样例里跑一遍,确认结果符合预期,才算跑通。这一步省不掉,也是多数人把模型输出直接上线后翻车的根源。本文基于 2026 年智谱 GLM 的代码能力,讲清从零到校验正确的完整步骤,以及最容易踩的三个坑:贪婪匹配、特殊字符未转义、分组捕获理解错。
先看结论
用智谱 GLM 写正则并校验正确性,建议走"描述需求 → 拿表达式 → 写测试样例 → 本地跑验证 → 修边界"五步。核心是第三步:你准备的正例和反例,比模型给的解释更可靠。边界是:GLM 可能把语义猜错(比如把"手机号"理解成任意 11 位数字),它生成的代码不验证就上线,迟早在某条异常数据上翻车。
一、从零:先描述清楚你要匹配什么
第一步不要直接问"写个正则",而是把场景讲细。比如:"我要从日志里提取形如 2026-11-12 的日期,年四位、月两位、日两位,且月份 01-12、日 01-31,给我一个 Python 可用的正则和测试代码。"
描述越具体,GLM 给的正则越接近可用。模糊的"提取日期"会让它返回一堆不严谨的表达式,反而增加你校验的负担。也要认清正则的适用边界:它擅长结构化文本的提取与格式校验,但涉及语义判断(比如"这句话是否在夸某产品")就力不从心,别把 GLM 写的正则当万能锤。
二、拿到表达式后,先别急着用
模型通常会同时返回正则和示例代码。先读懂它的写法:分组用了几个、有没有用到断言、特殊字符转义了没。配合 正则表达式教程 系统过一遍语法,能更快判断它写得到底对不对,而不是盲信输出。
一个小提醒:GLM 给的代码示例,最好标注"仅供参考、需本地验证",不要默认它已跑通。
三、写测试样例:正例和反例都要有
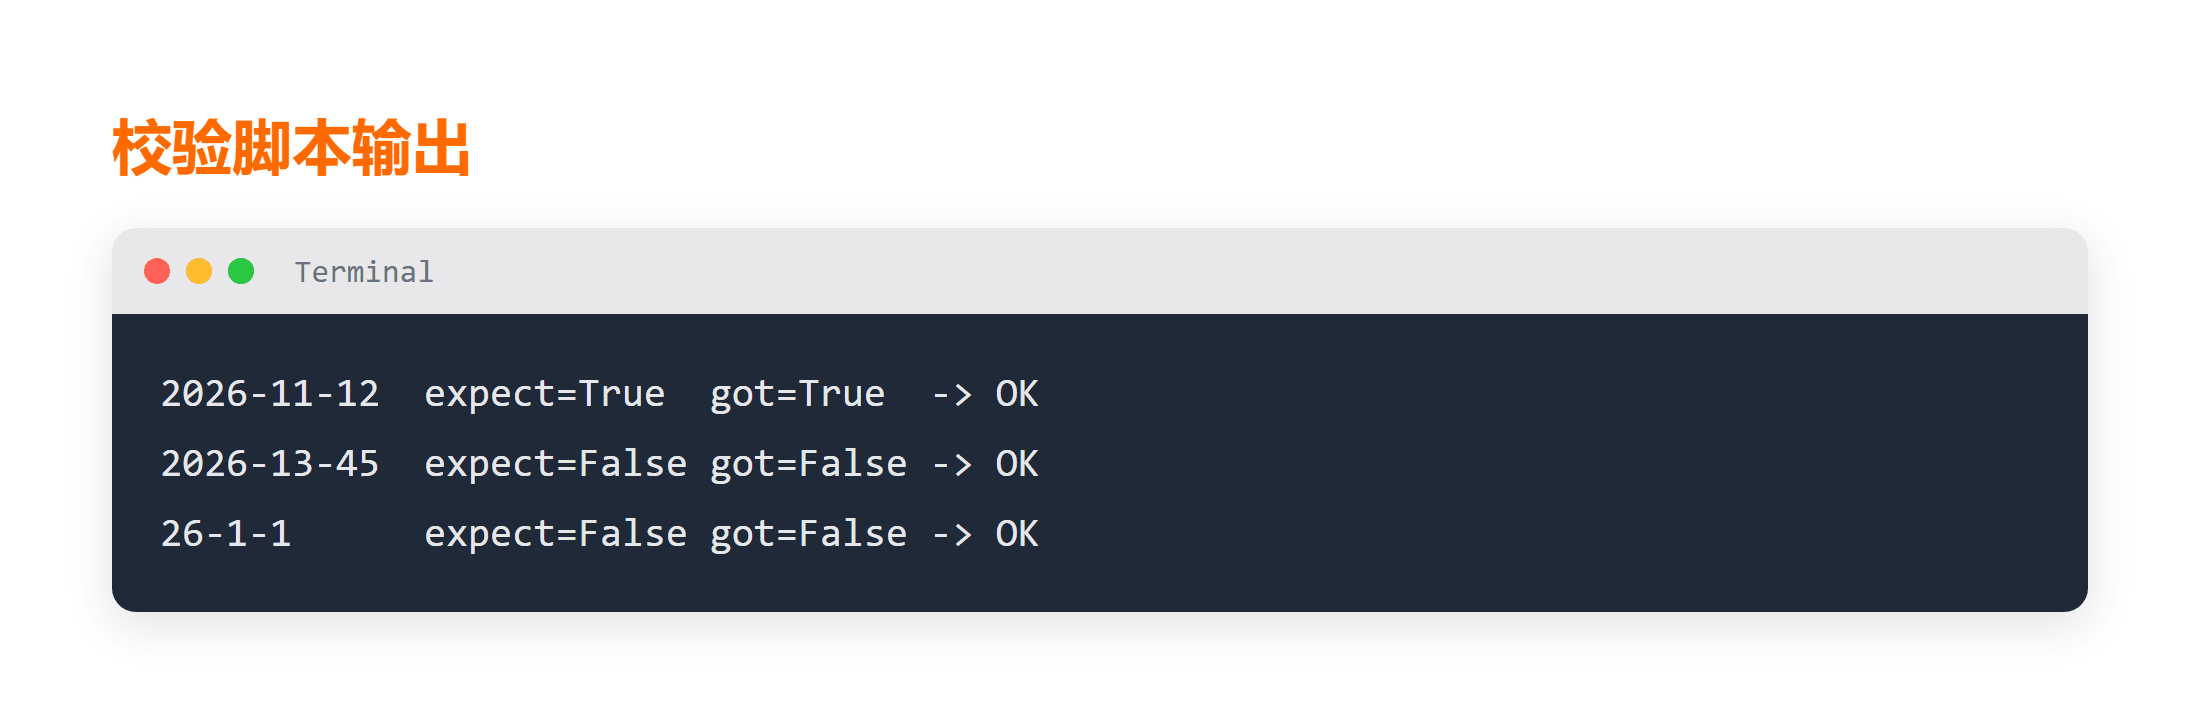
校验正则正确性的关键,是你自己准备样例。正例是"应该匹配上的",反例是"绝不能匹配上的"。比如上面的日期正则,正例放 2026-11-12,反例放 2026-13-45(非法月日)和 26-1-1(缺零)。
import re
# 模型给的表达式(示意,需自行验证)
pat = re.compile(r'(\d{4})-((0[1-9]|1[0-2]))-((0[1-9]|[12]\d|3[01]))')
tests = [('2026-11-12', True), ('2026-13-45', False), ('26-1-1', False)]
for s, expect in tests:
    got = bool(pat.fullmatch(s))
    print(f'{s:12s} expect={expect} got={got} -> {"OK" if got==expect else "FAIL"}')
准备完正例反例后,在本地运行这段脚本,检查每行预期结果和实际输出是否一致。上面这段把正则套进正例和反例里跑,能一眼看出表达式对不对。预期输出里三行都应是 OK;只要出现 FAIL,就说明模型给的正则还差一步,回去让它修边界条件。这正是正则校验最实在的一步。建议把这类小脚本存好,下次换表达式直接复用。
四、修边界:三个最高频的坑
第一,贪婪匹配。点号加星 .* 默认贪心,跨多个分隔符时会一次吃到底,需要用非贪婪 .*? 或在字符组里收窄。第二,特殊字符未转义,点号、问号、括号在正则里是元字符,匹配字面量要加反斜杠。第三,分组捕获理解错,你以为拿到的是整段,实际只捕获了某个括号里的内容。
每遇到一类问题,把修复后的表达式和样例一起喂回 GLM,让它解释"为什么之前错、现在对",比反复试错高效。配合 Python 速查手册 核对字符串与 re 模块的用法,也能少走弯路。
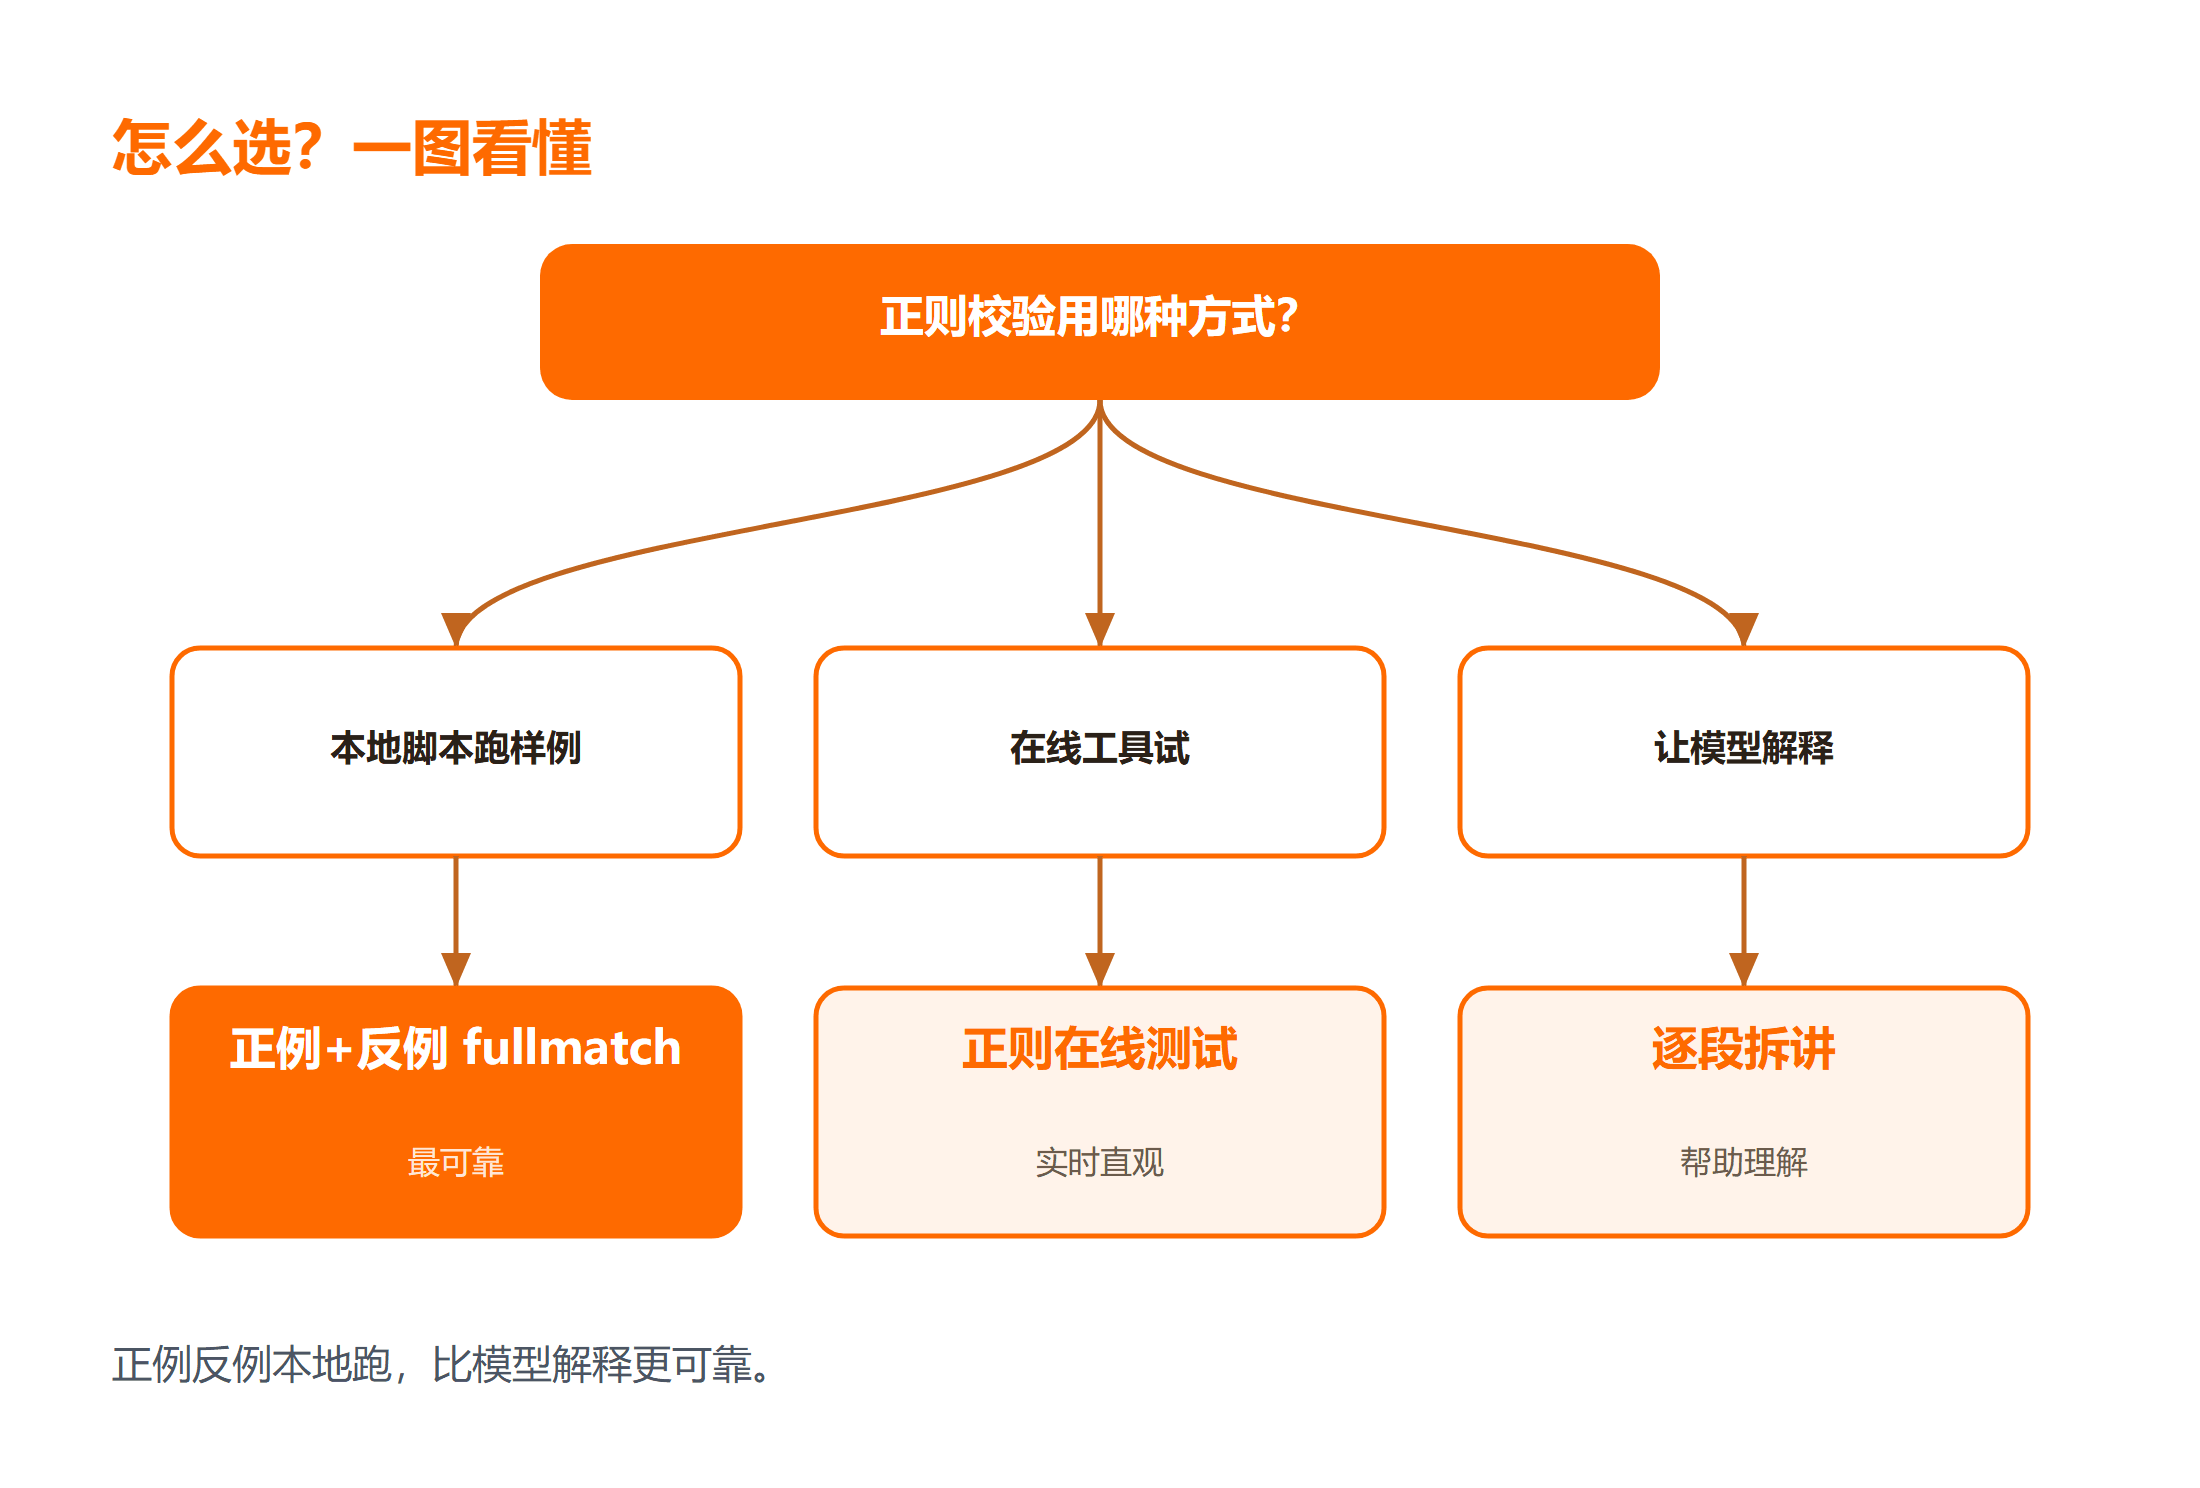
正则校验不是一次性动作,最好变成工作流里固定的一步。
第一种场景:你临时让 GLM 写个正则处理日志,用完即弃。即便如此,也至少跑一次正例反例,别把没验证的表达式直接写进脚本。
第二种场景:正则要进项目长期维护。建议把它和测试样例一起提交进仓库,谁改了表达式,谁负责让样例全绿。参考 Python 官方 re 模块文档,能避免把原始字符串漏写导致转义失效。
第三种场景:面对大批量文本,手动样例覆盖不全。可以抽样 20 条真实数据跑一遍,统计匹配率,对漏匹配和误匹配的单独补反例。性能上也要注意:复杂正则逐行扫大文件会慢,必要时用更紧的字符组收窄范围。
真实故障里最典型的一类,是 GLM 把"手机号"理解成"任意 11 位数字",结果把订单号也匹配进来;补一条"必须以 1 开头且第二位为 3-9"的反例就能拦住。这也划清了正则的适用边界:它管结构,不管语义,别指望一个表达式替你做业务判断。把校验动作固化为习惯之后,模型生成的正则你才敢直接进生产环境,而不是每次都心虚地再人工过一遍。正则本身没有"大概对",只有"匹配/不匹配",所以用正例反例兜底,才是对自己负责的做法。顺带一提,正则写好后建议存进团队的公共代码片段库,下次遇到同类的提取或校验需求直接复用,避免每次都从零让模型重写、再重新跑一遍正例反例。复用既省 token,也让校验标准在团队内保持一致。
常见问题
Q:GLM 给的正则能直接上线吗?
不能。任何模型生成的正则都必须过你自己的正例反例测试,尤其是面对真实脏数据时。校验这一步省不掉。
Q:为什么我的正则在网页能用、在 Python 报错?
多半是转义差异:网页正则和 Python 原始字符串对反斜杠的处理不同。统一用 Python 的 raw 字符串 r'...' 能避开大部分转义坑。
Q:复杂正则读不懂怎么办?
让 GLM 把表达式拆成逐段解释,每段说明匹配什么;同时用正则表达式在线测试工具实时试,两边对照最容易看懂。
总结
用智谱 GLM 辅助写正则,从零到跑通的核心是你亲手做正则校验:描述清需求、读懂表达式、准备正例反例本地跑、再修贪婪与转义等边界。AI 写正则省的是"起手式",正确性永远握在你自己的测试样例手里,Python 正则尤其要吃透分组与转义。



