
 TRAE-AI编程

Electron 应用常需要在主进程里拉起一个后台服务,比如本地接口、文件监听或定时任务,但新手往往卡在“到底该不该开子进程、怎么和渲染进程通信”。本文用三个可运行的最小示例,讲清 Electron 拉起后台服务的三种方式、各自的适用边界和常见坑,帮你把后台服务稳定运行起来,而不是只在自己的开发机器上跑得通。当你能在不同方式之间说清隔离性与资源占用的取舍时,选型就不再靠猜。
先看结论
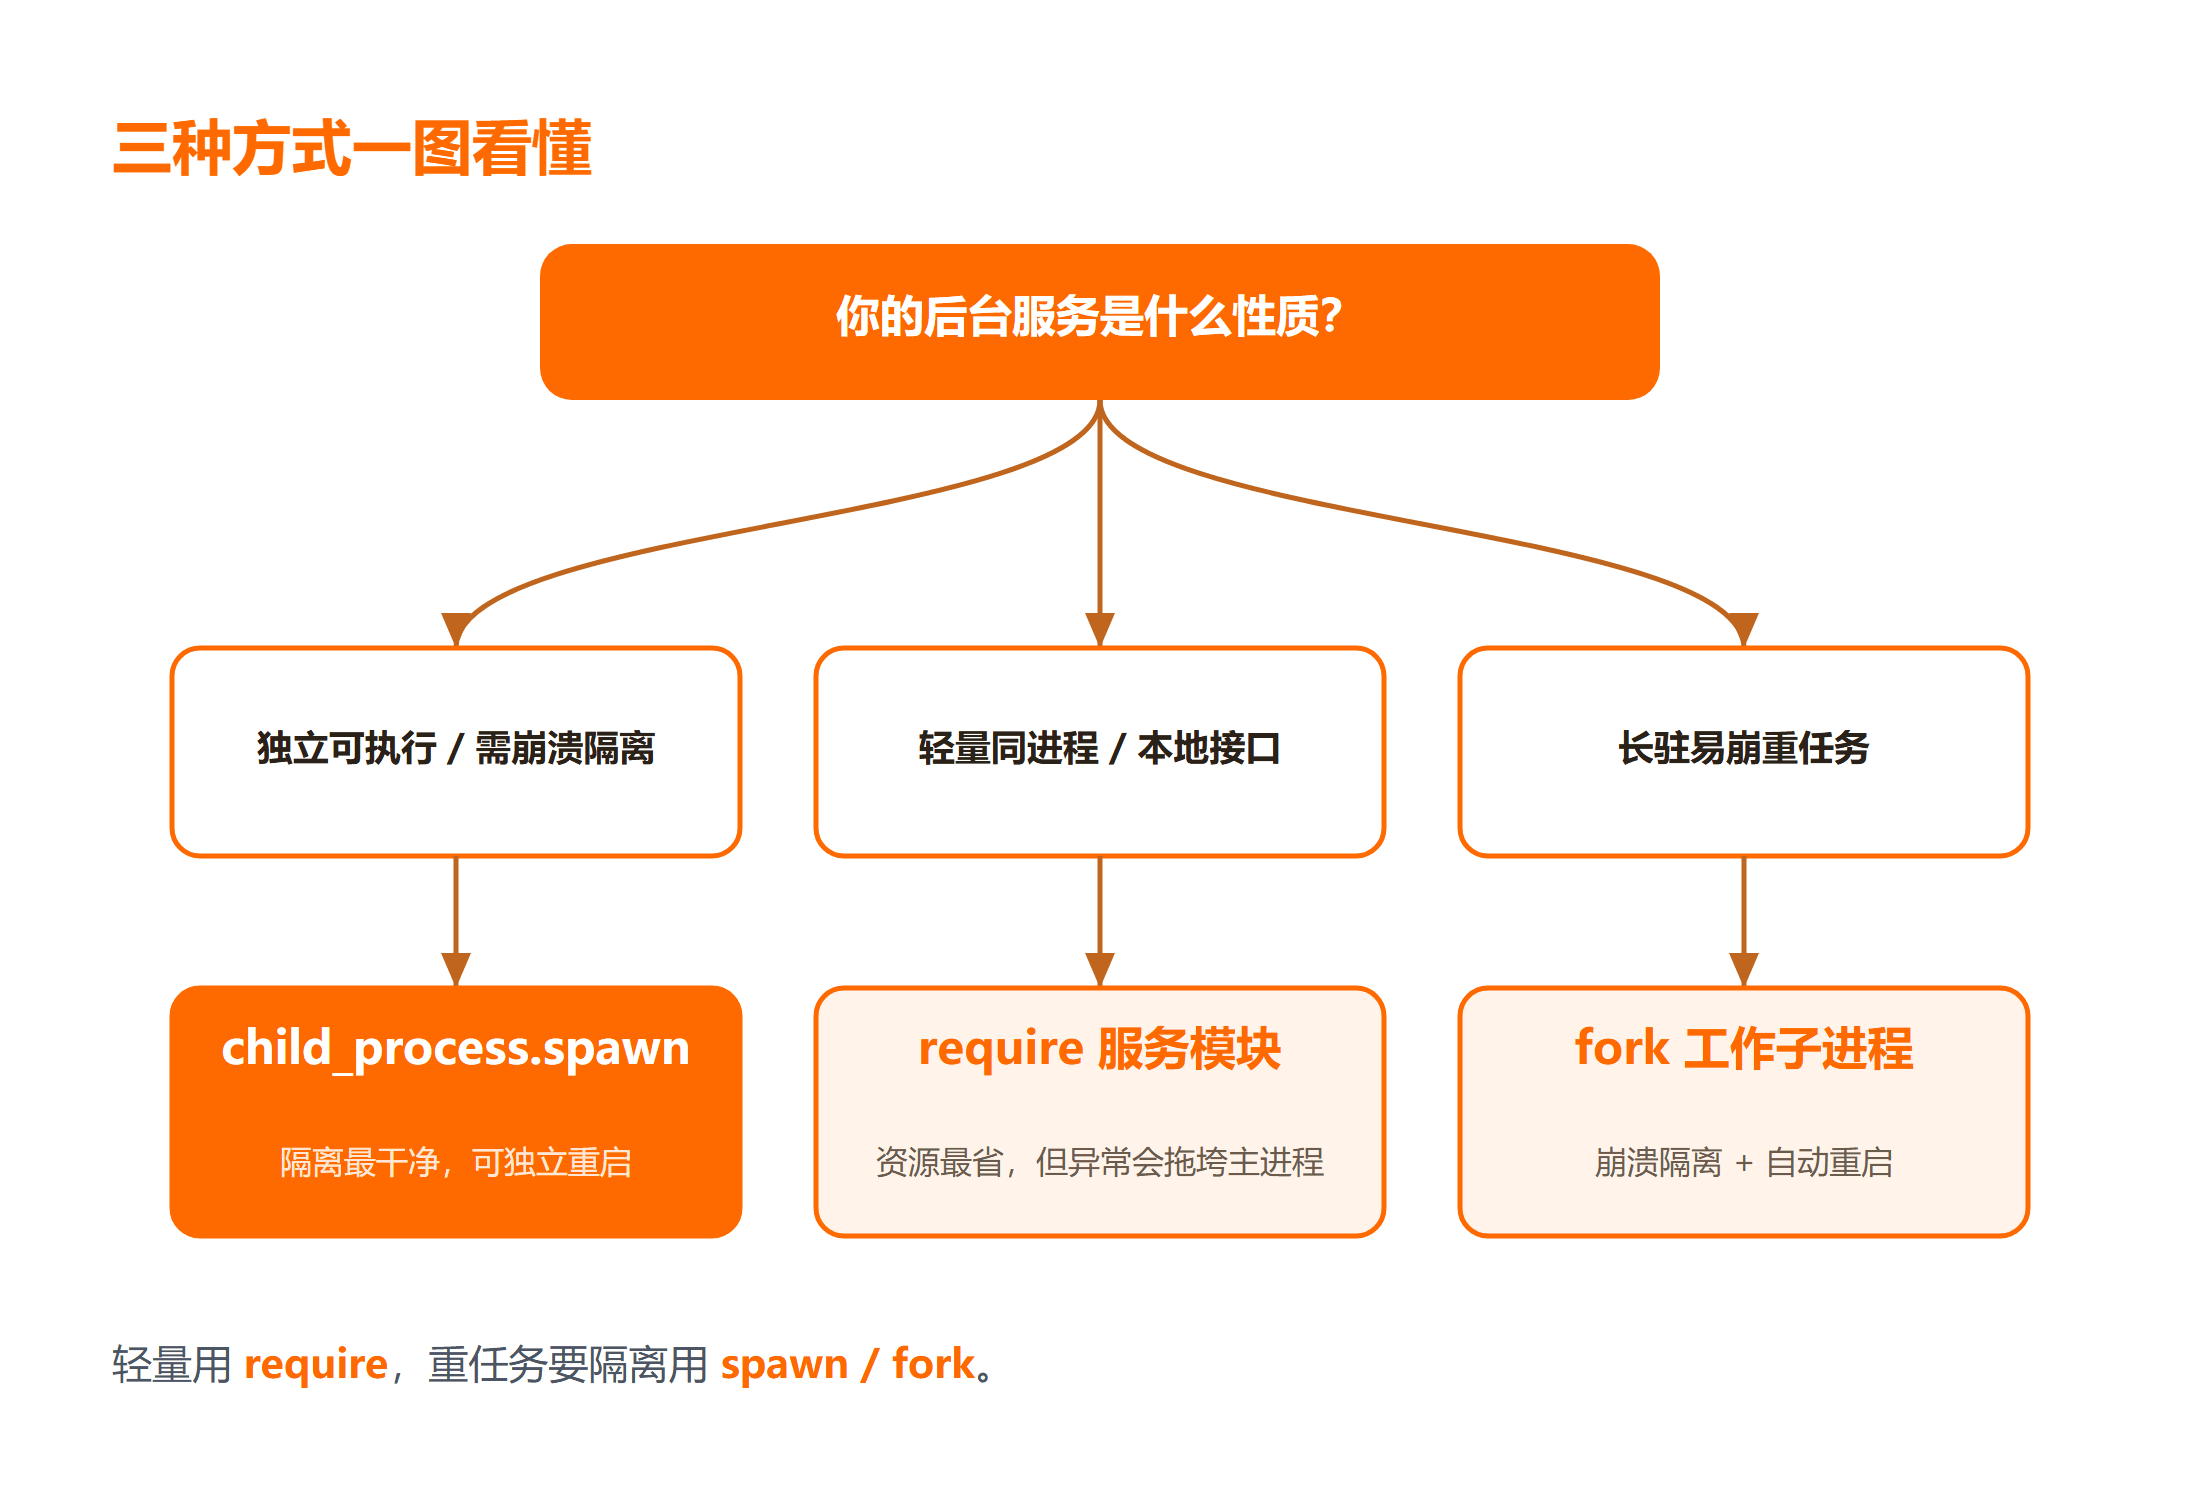
拉起后台服务有三种主流做法:一是用 child_process.spawn 拉起一个独立可执行或脚本,隔离最干净;二是主进程直接 require 一个 Node 服务模块,同进程最省资源;三是用 IPC 把后台任务交给专门的工作子进程,便于崩溃隔离。选型的本质是权衡隔离性、资源占用和通信复杂度,单一页面级工具用方式二,长驻重任务用方式一或三。
一、最小场景与前置准备
前置只有一步:用 Electron 创建一个最小窗口应用,代码写在主进程 main.js 里。很多困惑来自把后台服务和渲染进程逻辑混在一起。如果你还没搭好主进程骨架,可以先看 Electronmanual 教程 把主进程与渲染进程的关系理顺,再回来集成后台服务。
下面给出方式一的骨架,主进程用 spawn 拉起一个 Node 脚本:
const { spawn } = require('child_process');
const child = spawn('node', ['server.js'], { stdio: 'inherit' });
child.on('exit', (code) => console.log('后台服务退出码', code));
这段代码的语义是:主进程启动一个子进程运行 server.js,后台服务就此拉起,标准输入输出直接继承主进程,便于在终端里观察日志。理解了这个骨架,后面两种方式只是在“谁来运行 server.js”上做变化。
二、方法一:child_process.spawn 拉起独立进程
最稳妥的方式一,是把后台服务编译成独立可执行或脚本,由主进程用 spawn 拉起。它的适用边界非常清晰:服务可以独立崩溃、独立重启,不会拖垮整个 Electron 应用。代价是进程间通信要靠 IPC 或本地端口,复杂度略高。
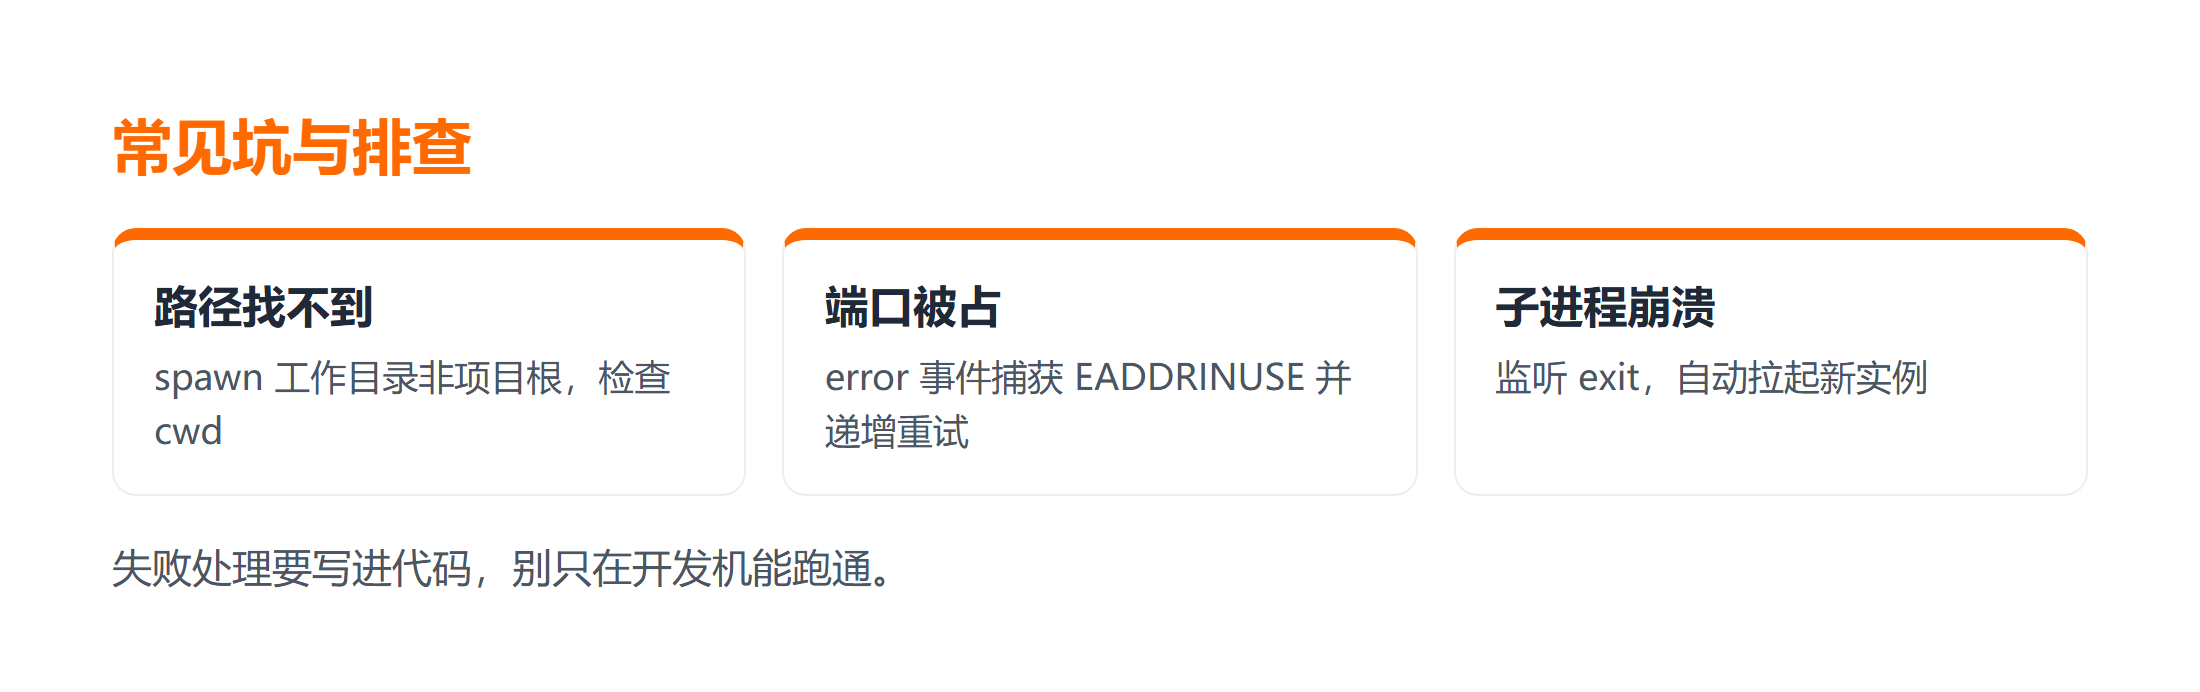
方式一的性能取舍在于:每个后台服务都是一个独立进程,资源占用比同进程高,但隔离性最好。常见失败是路径问题——spawn 的工作目录不是项目根,导致 server.js 找不到。失败处理要在 exit 事件里判断退出码,非 0 时弹出“后台服务启动失败”的提示,而不是静默卡死。另一个边界是跨平台差异:Windows 下 node 可能要在 PATH 里才能直接 spawn,Linux/macOS 通常没问题,打包后还需用 process.resourcesPath 定位二进制。
三、方法二:主进程内 require Node 服务模块
如果后台服务很轻量,比如只是一个本地接口或内存缓存,方式二更合适:主进程直接 require('./server') 启动一个 Node 服务。这种方式没有额外进程,资源占用最低,通信也最简单,主进程拿到的是同一个对象引用。
方式二的边界是:服务代码一旦抛未捕获异常,会连主进程一起带走,隔离性差。验证方法:在 main.js 里 require 后调用一次 server.listen(3000),启动应用打开页面,预期控制台打印“listening on 3000”;若端口被占则应在 error 事件里捕获并提示换端口。想深入 Node 侧能力,可以参考 Node.js 教程 里的 http 模块章节,理解 listen 背后的事件模型。
四、方法三:用 IPC 交给工作子进程并做校验
方式三适合长驻、易崩的重任务:主进程 fork 一个工作子进程,通过 child.send 和 child.on('message') 做主进程通信,后台服务跑在子进程里。它的价值是崩溃隔离——子进程挂了主进程还在,可以自动重启。
所谓后台服务,本质是一段寄生在 Electron 进程里的常驻逻辑:它要么和主进程同生共死,要么作为独立子进程被主进程托管。理解 Electron 进程与主进程之间的边界,才能选对隔离粒度,避免把一次性脚本写成了拖垮整个应用的长驻负担。另一个边界是消息协议要固定结构,子进程发来的字段主进程必须能解析,否则重启逻辑会陷入死循环。
失败处理与校验是关键:子进程启动后先 send 一个就绪信号,主进程收到才认为后台服务可用;超时未收到就判定启动失败并重试。另一类失败是消息协议不一致,子进程发了主进程不认识的字段,要在两端约定固定的消息结构。版本差异在于 Electron 不同大版本对 fork 的预加载脚本处理略有变化,升级时要核对迁移说明。未在本机执行,上述为 Electron 官方文档描述的预期行为。
从可复现角度补一步:先 安装 好 Node 与 Electron, 配置 好主进程入口,再 运行 npm start 启动应用;用任务管理器或日志 检查 子进程是否拉起,预期看到监听类日志;若 失败 则 修复 spawn 的路径参数,重新 验证 直到服务稳定。把安装、配置、运行、检查、修复、验证固化,排查效率会明显提升。
动手核对清单
- 安装:确认 Node 与 Electron 依赖已安装就绪。
- 配置:写好主进程入口与子进程启动参数。
- 运行:执行
npm start,确认窗口能正常打开。 - 检查:检查子进程是否拉起、端口是否监听。
- 预期:预期日志打印监听成功或就绪信号。
- 失败:进入错误分支提示用户,必要时自动重启。
- 修复:按退出码修复路径或端口问题后重新验证。
- 适用边界:轻量同进程用 require,重任务要隔离用 spawn 或 fork。
总结
Electron 拉起后台服务没有唯一正解:轻量同进程用 require,重任务要隔离用 spawn 或 fork。无论哪种方式,都要把“启动失败怎么提示、崩溃怎么重启”写进代码,后台服务才能真正稳定,而不是只在开发机器上跑得通。
常见问题
Q:spawn 和 fork 该选哪个?
答:spawn 拉起任意可执行,通信靠 IPC 或端口,适合独立服务;fork 专用于 Node 子进程,自带 message 通道,适合要做主进程通信的工作进程。按是否需要结构化消息选。
Q:后台服务端口被占用怎么办?
答:在 error 事件里捕获 EADDRINUSE,提示用户或自动递增端口重试;不要吞掉错误,否则用户会看到“启动成功”却连不上。
Q:子进程崩溃会拖垮主进程吗?
答:不会。spawn/fork 出来的子进程独立运行,崩溃只触发它的 exit 事件,主进程照常工作,正好可以借机自动拉起新实例。



