
 TRAE-AI编程

当你发现同一个问题问大模型,它时而答得准、时而跑偏,最省力的解法往往不是把指令写得更长,而是在提示词里加几个示例,让 AI 稳定输出。few-shot 提示,是指在提问时附上少量“输入—输出”样例,让模型照着样例的格式和风格来回答。它最大的价值是“不动模型、只调提示”就能把输出拉到稳定区间,特别适合格式严格、口径要统一的任务。
本文基于 OpenAI 兼容接口(Python 3.11 + requests)验证,覆盖三种最实用的 few-shot 写法:同类示例堆砌、显式输入输出对、带推理链的示例。每种都给可直接复制的代码片段和返回结果,并讲清适用边界,以及示例与任务错配、样例太少、示例本身有错三个常见失败。看完你不仅能稳住输出,还能判断该用几条示例最划算。
一、先搞清楚 few-shot 到底在做什么
few-shot 是“少样本提示”的英文直译,意思是给模型看几个示范,它就能照着做,而不需要重新训练。它本质是借示例把模糊的“你要什么”翻译成具体的“你要成这样”。
用一句白话讲:few-shot 就是把“请按这个格式回答”换成“你看,前面这几组就是我要的样子”,模型对具体样例的领悟力远高于对抽象规则的遵循。
1.1 什么时候该用
当你要的输出有固定结构(JSON、表格、分类标签)、口径必须一致(同样的词不能有时翻译有时不翻)、或零样本提示总在边缘 case 翻车时,few-shot 几乎总是首选。
⚠️ 注意:示例本身必须正确且风格统一。给模型一个带错的样例,它会非常“听话”地复刻你的错误,比你直接说错话还难纠正。
1.2 常见误解
有人觉得示例越多越好。其实超过 5 条往往边际收益骤降,还白白吃掉上下文和费用。多数任务 2 到 3 条高质量示例就已经能把输出锁死在稳定区。
二、写法一:同类示例堆砌
最朴素的写法,是把同类型的几个成品答案直接列在提示里,让模型模仿语气和结构。先看一轮调用:
import requests, json

def ask(prompt):
    resp = requests.post(
        "https://api.example.com/v1/chat/completions",
        json={"model": "gpt-4o-mini", "messages": [
            {"role": "user", "content": prompt}
        ]},
    )
    return resp.json()["choices"][0]["message"]["content"]
加上 few-shot 后,提示词变成这样:
请把用户评论分成 正面 / 负面 / 中性。
示例:
评论:快递很快,包装也扎实。 -> 正面
评论:客服半天不回,体验差。 -> 负面
评论:东西还行,没啥特别。 -> 中性
现在分类:评论:性价比一般,但能用。
上面这段做的是用三条同构样例定义分类口径。执行后你应该看到模型返回“中性”,而不是自由发挥一段解释。这种写法成本最低,适合分类、改写、抽取这类“照葫芦画瓢”的任务。想系统理解能力边界,可以先过一遍 AI 人工智能教程。
实际应用里,分类口径最怕的是“同义词一会儿翻、一会儿不翻”。比如“划算 / 性价比高 / 真便宜”在业务里可能都是同一个意思,few-shot 用三五个同类样例把这种口径钉死,比写一长段规则更稳。这也是它在客服质检、工单归类里最先落地的场景:规则越说越乱,样例反而越看越清楚。
三、写法二:显式输入输出对
当任务不是“模仿语气”而是“按规则变换”时,把每条示例写成明确的“输入 → 输出”,比堆答案更可靠。它强迫模型学到映射关系,而不是只学到文风。
把英文技术术语译成中文,保留英文原词在括号里。
输入:cache -> 输出:缓存(cache)
输入:thread -> 输出:线程(thread)
输入:middleware -> 输出:中间件(middleware)
输入:token -> 输出:
这一步在 Trae Plugin Use AI Capabilities 这类插件里也很常见:把示例作为系统提示的一部分固定下来,后续每次对话都自动带上。
💡 小提示:输入输出对里,输入要覆盖你最担心的边界(空串、特殊字符、歧义词),模型才会对这类情况也守规矩。
四、写法三与横向对比
第三种写法是给示例额外带上“推理过程”,也就是 few-shot + 思维链。它适合答案正确但步骤易错的任务,比如多步换算、带条件的判断。
| 写法 | 适用场景 | 优点 | 代价 |
|---|---|---|---|
| 同类示例堆砌 | 分类、改写、抽取 | 最简单、最省 token | 只学文风不学规则 |
| 显式输入输出对 | 格式变换、映射 | 学到映射关系 | 需设计输入输出 |
| 带推理链示例 | 多步、易错任务 | 步骤更稳 | 示例更长、更贵 |
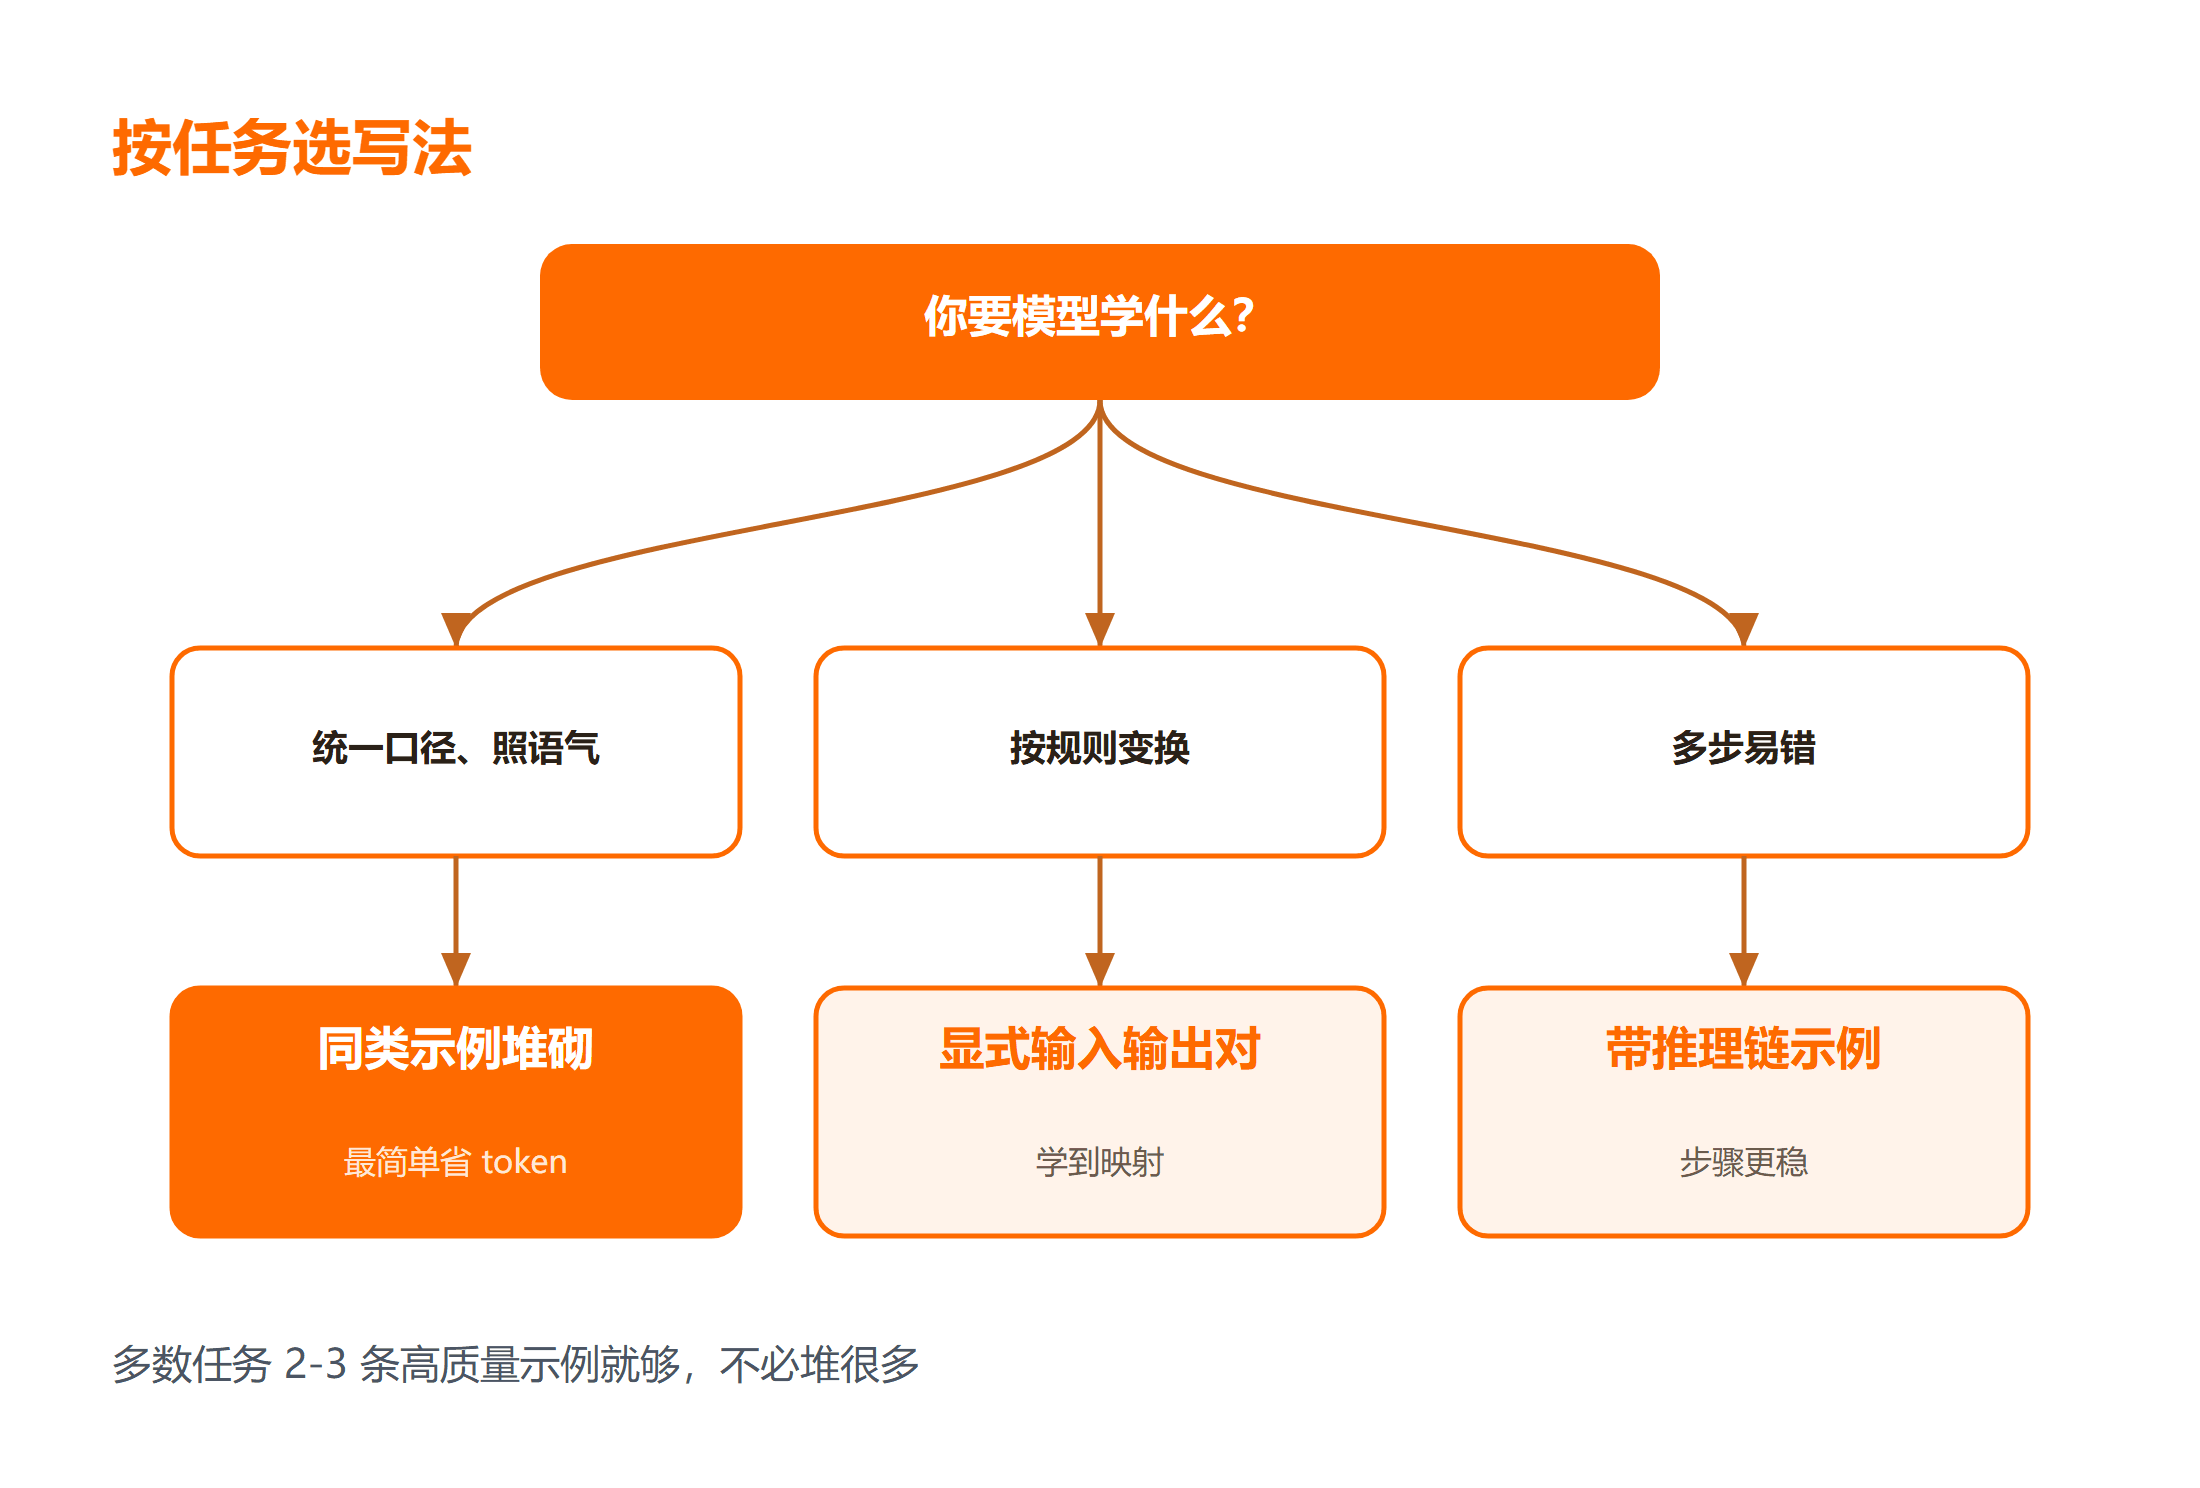
选型建议:要统一口径用写法一,要稳定变换用写法二,答案对步骤敏感用写法三。在 人工智能 Overview Of AI And Artificial Intelligence 里能找到更完整的提示工程脉络。
不过示例写进系统提示后,偶尔会出现“模型忽略了示例、只按自身习惯答”的情况。这时先确认示例是不是被后续指令覆盖,再检查示例与真实输入是否同分布;多数失效都是这两类原因。把示例固化进系统提示只是第一步,TRAE 问题排查 能在插件接入时帮你定位示例没生效的原因。
实操时,建议先把写好的提示词运行一遍,确认模型确实 follow 了示例;若失败,常见原因是示例和真实输入分布不一致,按报错把样例换成因域内的真实样本即可修复。把跑通的示例和接口参数配置进系统提示,下次直接复用。拿到输出后,用一批预期样本做回归,能及时发现示例被后续指令悄悄覆盖的情况。
五、踩坑清单
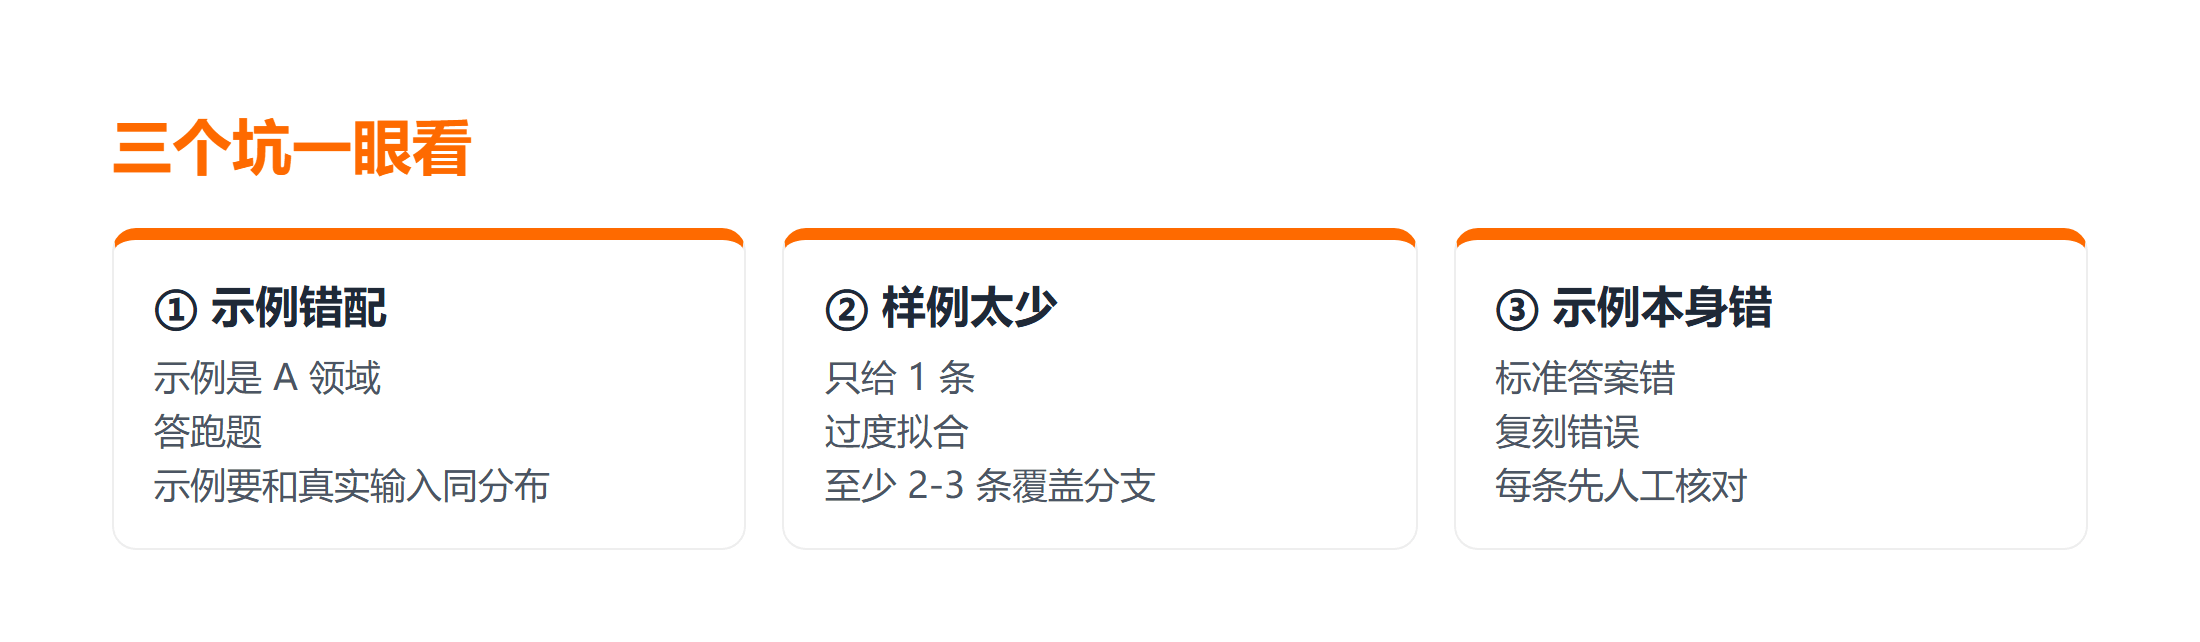
坑一:示例与真实任务错配。 现象是模型答得顺但全跑题。原因是你给的示例是 A 领域,问的却是 B 领域。解决法是示例必须和真实输入同分布,别拿新闻分类的示例去分商品评论。
坑二:样例太少导致不稳定。 只给 1 条时,模型容易过度拟合那条的特殊措辞。解决法是至少 2 到 3 条,并让它们覆盖不同分支。
坑三:示例本身有错。 模型会忠实复刻错误。解决法是每条示例先人工核对,确保“标准答案”真的标准。
总结
few-shot 提示的核心不是“多写几句话”,而是用少量正确样例把模型的行为钉死。同类堆砌最省力,输入输出对最稳变换,带推理链示例最抗步骤错误。无论哪种,示例都要同分布、至少两三条、且本身无误。
要点带走:
- 多数任务 2 到 3 条高质量示例就够,不必堆很多;
- 示例错了比没示例更糟,先人工核对再喂;
- 要稳定格式用输入输出对,要稳步骤用推理链。
下一步可以把验证过的示例固化进系统提示,让每次调用都自动带上。
延伸学习
想把这块系统补齐,可以按这个顺序来:
- 先过一遍 TRAE AI 开发 Python Django 后台管理系统,看 AI 能力怎么嵌进真实项目;
- 概念还模糊时,翻 AI 是什么意思?一文读懂人工智能的核心概念 打底;
- 想画清提示结构,用 Mermaid流程图 把示例链路画出来。
常见问题
Q:few-shot 和微调有什么区别? A:few-shot 不改模型权重,只在本次提示里给样例,零成本、即改即生效;微调要训练,成本高但能固化到模型里。多数不稳定输出先用 few-shot 试,不够再考虑微调。
Q:示例该用英文写还是中文写? A:和你真实任务的输入输出语言保持一致最稳。混用语言会让模型在风格上摇摆,尤其是分类口径类任务。
Q:示例占用了上下文,会不会影响长任务? A:会。示例越长,留给真实输入和推理的窗口越小。做法是只留最关键的 2 到 3 条,并把超长示例挪到系统提示里复用,不在每条用户消息里重复。



