 免费 AI IDE

Node.js 异步任务既不能一律串行,也不能无上限 Promise.all。存在依赖时串行,数量少且彼此独立时并行,批量网络或文件任务则设置并发上限,并明确失败、超时、重试与取消策略。真正的 Node.js 并发控制不是追求“同时启动最多任务”,而是在吞吐、远端限额和本机资源之间找到可验证的上限。
本文使用 Node.js 标准 Promise、async await 与 AbortSignal,从同一批任务分别实现串行、全量并行和并发限流。你会得到可运行的工作池、结构化失败结果、超时传播方式,以及一套比较总耗时和峰值并发的验证方法。
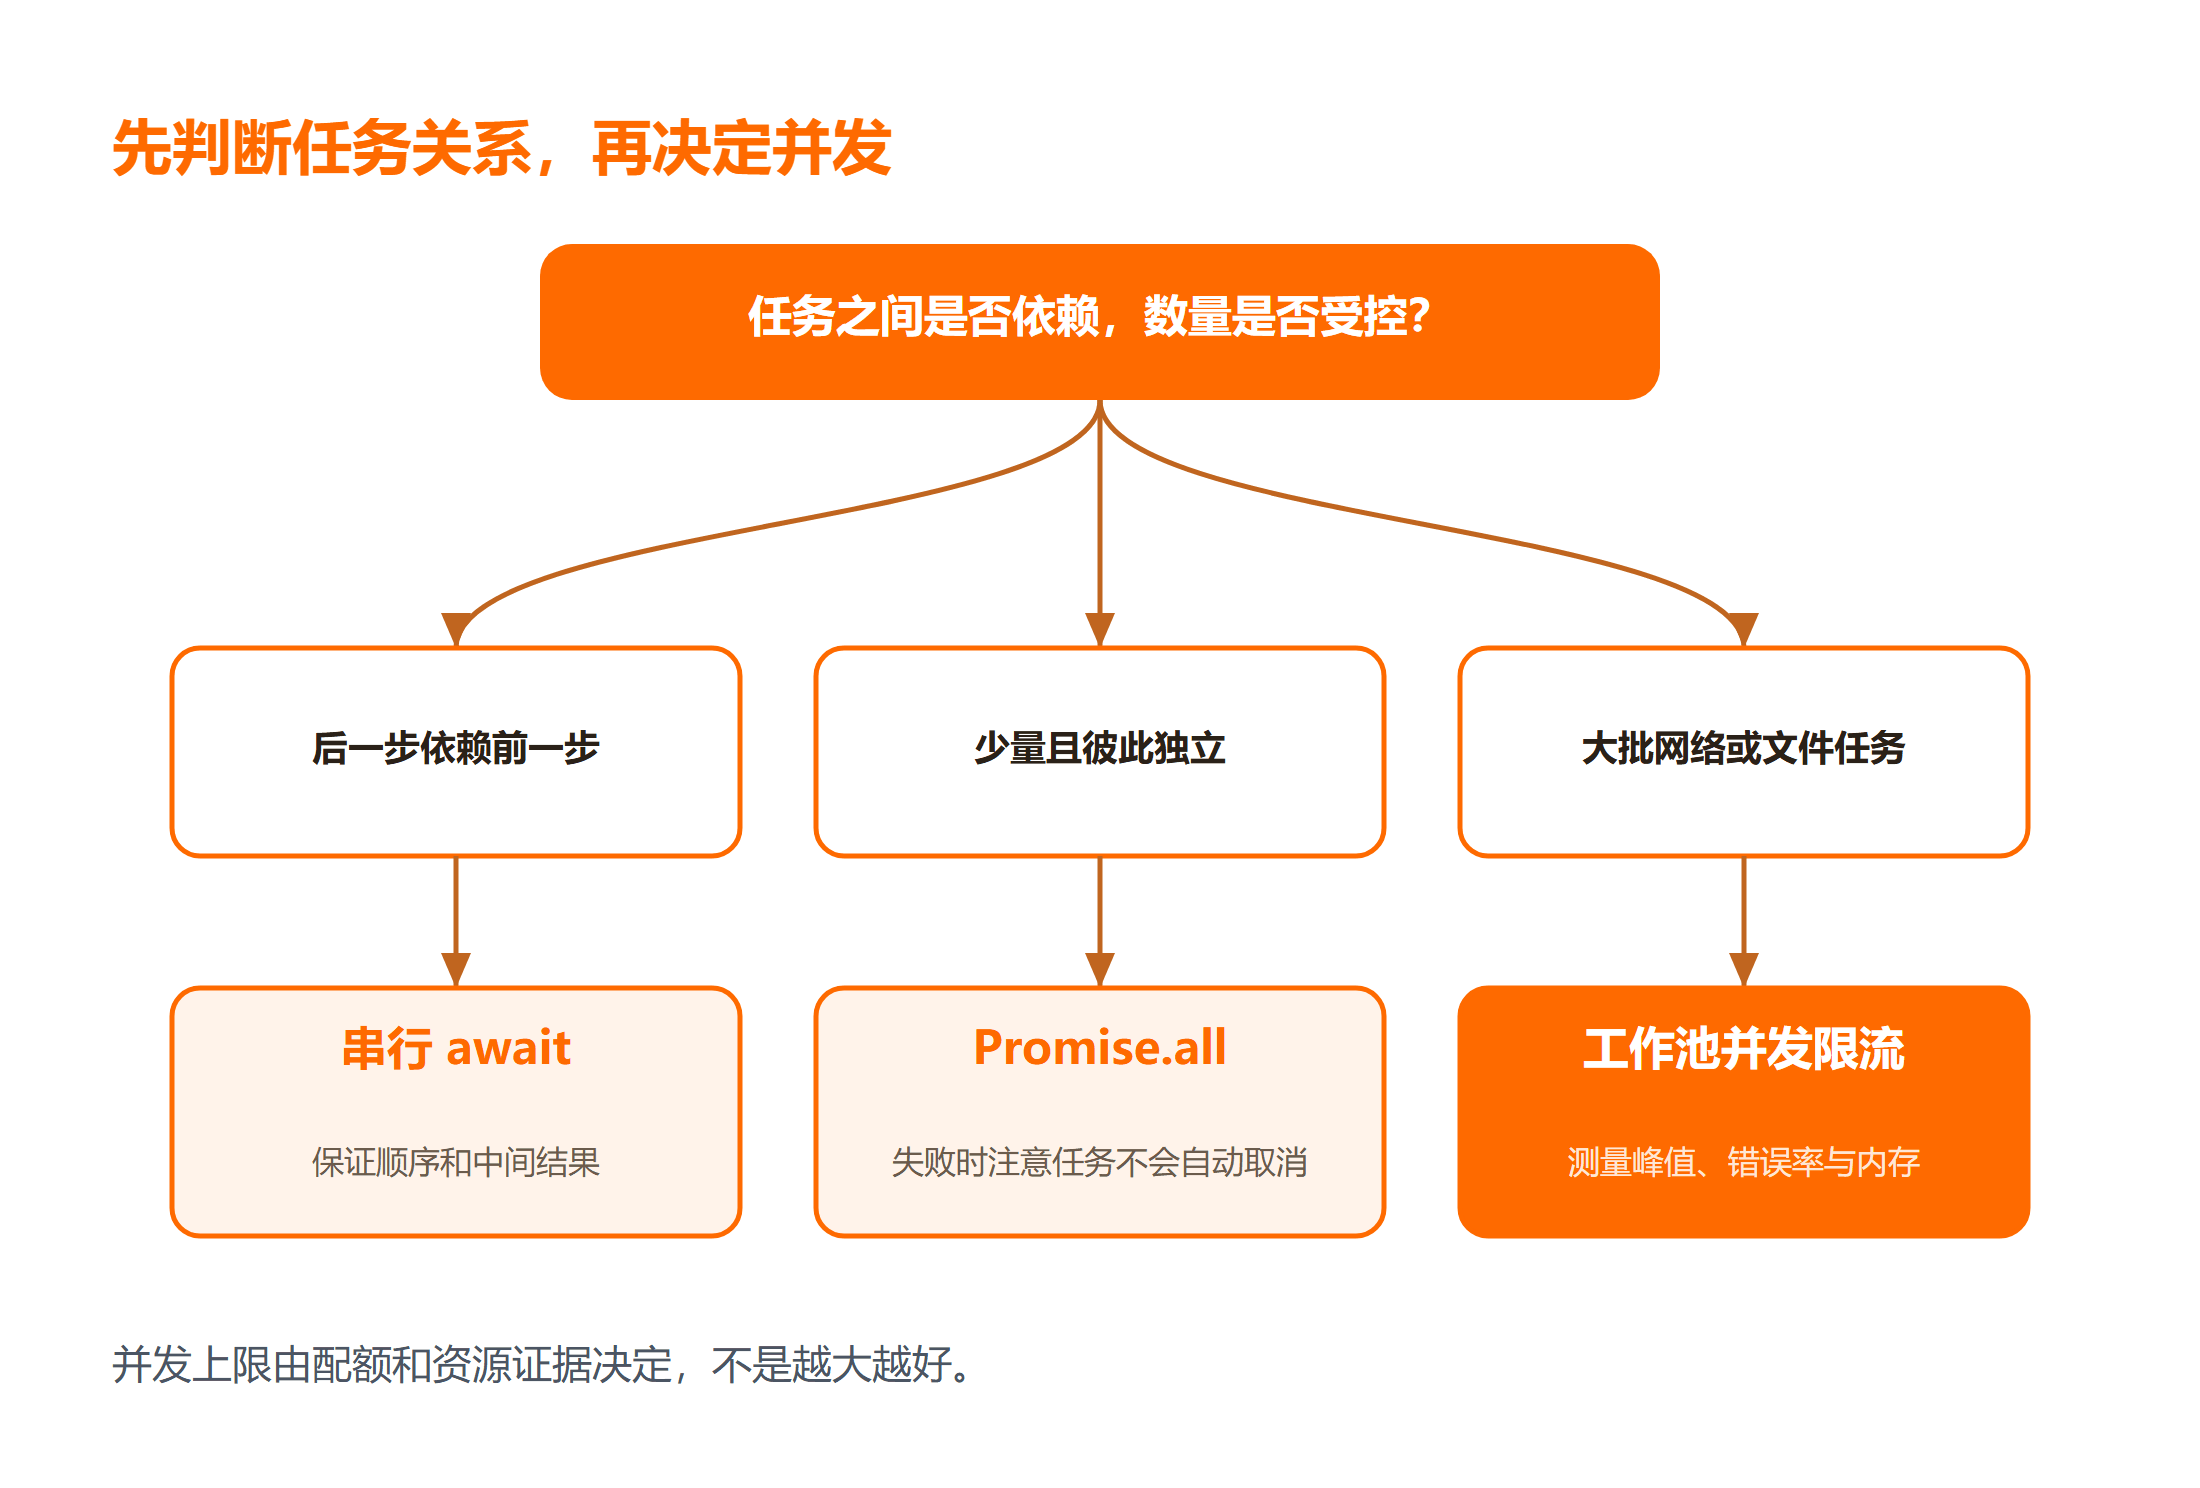
一、先看结论:串行、并行、限流怎么选
| 任务关系 | 推荐策略 | 典型写法 | 失败行为 |
|---|---|---|---|
| 后一步依赖前一步结果 | 串行 | for...of + await |
立即停止或按业务处理 |
| 少量独立任务,数量可控 | 全量并行 | Promise.all |
任一拒绝整体拒绝 |
| 需要收集所有结果 | 全量并行 | Promise.allSettled |
不中断,逐项处理 |
| 批量网络/文件任务 | 并发限流 | 工作池 mapLimit |
可配置为部分成功或整体失败 |
| 强一致流程 | 串行或事务 | 数据库事务、补偿 | 失败回滚 |
一句话:有依赖串行,少量独立并行,批量任务限流;失败、超时、取消必须传到顶层。
二、前置条件:先判断任务有没有顺序依赖
对事件循环与 Promise 还不熟悉时,可先看 Node.js 教程;本文重点是任务调度,不重复讲基础语法。
示例要求 Node.js 18 及以上版本,并使用支持顶层 await 的 .mjs 文件。先执行 node --version 确认环境;低版本需要把代码包进 async 函数。本文操作顺序是先跑串行基线,再改并行,最后加入限流,不能跳过基线直接比较耗时。
// 等待指定毫秒数
const wait = ms => new Promise(resolve => setTimeout(resolve, ms));

// 模拟一个耗时 100ms 的异步任务
async function job(id) {
  await wait(100);
  return `job-${id}`;
}

// 串行执行:一个接一个,总耗时约 300ms
const serial = [];
for (const id of [1, 2, 3]) {
  serial.push(await job(id));
}
console.log(serial);
串行适合后一步依赖前一步结果。三个独立任务则可用 Promise.all([1,2,3].map(job)) 并行。Promise.all 任一拒绝就整体拒绝,但其他已经启动的任务不会自动取消;需要收集所有结果时使用 allSettled,并逐项处理 rejected。这个区别决定了失败后是否会继续占用连接和配额。
| 写法 | 失败行为 | 其他任务是否继续 | 适用场景 |
|---|---|---|---|
串行 for await |
立即抛出 | 后续不执行 | 有依赖、强一致 |
Promise.all |
任一拒绝整体拒绝 | 已启动的继续执行 | 少量独立任务 |
Promise.allSettled |
不抛出,返回状态数组 | 全部执行完 | 允许部分成功 |
先运行串行版本,理论耗时约 300 毫秒;再改成三个并行任务,理论耗时接近 100 毫秒。实际数字会受事件循环和系统负载影响,因此比较的是同一机器上的相对结果,而不是把某个毫秒数写成硬指标。
三、并行:Promise.all 与 allSettled 的区别
// 全量并行:三个任务同时启动
const parallel = await Promise.all([1, 2, 3].map(job));
console.log(parallel); // ['job-1', 'job-2', 'job-3']

// 收集所有结果,不因单个失败而中断
const settled = await Promise.allSettled([1, 2, 3].map(job));
console.log(settled);
// [
//   { status: 'fulfilled', value: 'job-1' },
//   { status: 'fulfilled', value: 'job-2' },
//   { status: 'fulfilled', value: 'job-3' }
// ]
Promise.all 适合“全部成功才算成功”的场景;Promise.allSettled 适合“部分成功也要保留结果”的场景。但两者都不会限制并发数,传入的 Promise 在调用时就已经启动。
| 方法 | 返回值 | 是否等待全部 | 失败时 |
|---|---|---|---|
Promise.all |
结果数组 | 是,直到全部成功 | 立即拒绝 |
Promise.allSettled |
状态数组 | 是,直到全部结束 | 不拒绝,逐项查看 |
Promise.race |
第一个完成的结果 | 否 | 第一个失败则拒绝 |
Promise.any |
第一个成功的结果 | 否 | 全部失败才拒绝 |
四、批量任务用工作池限制并发
/**
 * 并发执行异步任务,最多同时运行 limit 个
 * @param {Array} items - 待处理数据
 * @param {number} limit - 最大并发数
 * @param {Function} worker - 处理单个数据的异步函数
 * @returns {Promise<Array>} 按原始顺序返回结果
 */
async function mapLimit(items, limit, worker) {
  // 预分配结果数组,保持顺序
  const results = new Array(items.length);

  // 下一个待处理的下标
  let next = 0;

  // 单个 worker 循环领取任务
  async function run() {
    while (next < items.length) {
      const index = next++;
      results[index] = await worker(items[index]);
    }
  }

  // 启动 limit 个 worker,同时不超过 items.length
  await Promise.all(
    Array.from({ length: Math.min(limit, items.length) }, run)
  );

  return results;
}

// 最多同时运行两个任务
console.log(await mapLimit([1, 2, 3, 4, 5], 2, job));
这段代码最多同时运行两个任务,并保持结果顺序。它遇到首个异常会拒绝整体调用;已经进入 worker 的任务仍会继续到自身结束。若业务允许部分成功,应在 worker 内返回结构化结果,而不是吞掉异常。Node.js 速查手册 可随手查 Promise API。
// 在 worker 内部捕获异常,返回结构化结果
const settled = await mapLimit([1, 2, 3], 2, async id => {
  try {
    return { id, ok: true, value: await job(id) };
  } catch (error) {
    return { id, ok: false, error: error.message };
  }
});
这种结果适合图片处理、批量抓取等允许部分失败的任务。订单扣款或数据库迁移等强一致流程不能仅靠“继续执行并汇总”,而应在业务层设计事务、补偿或立即停止策略。
| 业务类型 | 推荐失败策略 | 结果记录 |
|---|---|---|
| 图片处理、批量抓取 | 部分成功,继续执行 | { id, ok, value/error } |
| 订单扣款、库存扣减 | 立即停止或事务回滚 | 抛出异常,回滚事务 |
| 数据迁移 | 记录失败项,支持重试 | 失败任务 ID + 错误原因 |
| 发送通知 | 允许部分失败,汇总报告 | 成功数、失败数、失败原因 |
五、超时要真正传播取消
AbortSignal 只有在底层操作接受 signal 时才会取消。给外层 Promise 做超时但不传 signal,网络请求仍可能在后台运行。
// 创建 AbortController
const controller = new AbortController();

// 2 秒后触发取消
const timer = setTimeout(() => controller.abort(), 2000);

try {
  // 把 signal 传给 fetch
  const response = await fetch('https://example.com', {
    signal: controller.signal
  });
  console.log(response.status);
} finally {
  // 无论成功失败,都要清除定时器
  clearTimeout(timer);
}
预期结果取决于网络;成功时输出状态码,超时时抛 AbortError。不要把超时当成普通空结果。需要复习运行模型,可看 Node.js 文档教程。
| API / 操作 | 是否支持 AbortSignal | 取消效果 |
|---|---|---|
fetch |
是 | 真正取消网络请求 |
文件读写(fs.promises) |
部分支持 | 取决于 API |
| 数据库客户端 | 看库实现 | 可能只停止等待 |
| 自定义异步函数 | 需手动检查 | 调用 signal.throwIfAborted() |
setTimeout |
否 | 需手动清除 |
只有底层 API 接收并响应同一个 signal,取消才会向下传播。自定义 worker 可以在耗时阶段调用 signal.throwIfAborted(),也可以把 signal 继续传给 fetch、文件或数据库客户端。若库不支持取消,超时只能让调用者停止等待,无法保证后台工作已经结束。
重试也要放在单个任务边界内,并限制次数。只重试临时网络错误或 429/5xx,参数错误和权限错误立即失败;每次重试使用指数退避与随机抖动,避免一批任务同时再次打满远端服务。
六、验证结果与失败处理要保留到任务边界
每个任务至少记录任务 ID、开始时间、结束状态和原始错误类型。不要在深层函数 catch 后返回 undefined;调用端会把失败误认为正常空值。进程退出前要 await 顶层任务,并设置非零退出码。
// 顶层任务必须 await,失败时设置非零退出码
try {
  const results = await mapLimit([1, 2, 3, 4, 5], 2, job);
  console.log('成功', results);
} catch (error) {
  console.error('任务失败', error);
  process.exitCode = 1;
}
验证时固定输入 [1,2,3,4,5],分别记录串行、全量并行和并发上限为 2 的总耗时。正常输出应包含五个结果且顺序完整;故意让 job(3) 抛错时,应得到非零退出码或结构化 rejected 记录。若进程提前结束,先检查顶层 Promise 是否真正被 await。
| 验证项 | 正常结果 | 异常结果 |
|---|---|---|
| 结果数量 | 5 条 | 少于 5 条或顺序错乱 |
| 退出码 | 0 | 非 0 |
| 错误记录 | 无 | 结构化 rejected |
| 顶层 await | 进程等待任务完成 | 进程提前退出 |
普通 JavaScript 语法可在浏览器控制台验证,Node 专属 API、顶层 await 与 AbortSignal 示例仍应保存为 .mjs 后在本地 Node 环境运行。
七、并发上限由资源证据决定
limit=2 只是演示值。真实并发限流应参考远端接口配额、本机文件描述符、数据库连接池大小、CPU 和内存。
| 资源因素 | 影响 | 建议 |
|---|---|---|
| 远端接口配额 | 429 限流、封禁 | 设置低于配额的并发数 |
| 文件描述符 | 打开文件过多报错 | 限制并发文件操作 |
| 数据库连接池 | 连接耗尽 | 并发数不超过池大小 |
| CPU | 事件循环阻塞 | CPU 密集任务用 Worker Threads |
| 内存 | 队列堆积 | 限制排队任务数量 |
网络等待型任务可以适当提高并发,CPU 密集任务即使写成 async await 也不会自动并行,反而可能阻塞事件循环;这类工作应评估 Worker Threads 或独立进程。
用计数器记录当前并发与峰值,可以验证工作池是否真的守住上限:
// 记录当前并发数和峰值
let active = 0;
let peak = 0;

// 包装任务,统计并发
async function measuredJob(id) {
  active += 1;
  peak = Math.max(peak, active);

  try {
    return await job(id);
  } finally {
    active -= 1;
  }
}

// 最多并发 2,预期 peak 为 2
await mapLimit([1, 2, 3, 4, 5], 2, measuredJob);
console.log({ peak });
再分别用 1、2、4、8 作为上限,记录吞吐、错误率和内存。若并发翻倍但耗时不再下降,或 429 与超时明显增加,就已经越过合理区间。不要只看最快的一次运行。
生产任务还要处理优雅退出。收到终止信号后停止领取新任务,通知支持取消的 worker,等待已开始任务在限定时间内结束,然后以明确退出码退出。若直接调用 process.exit(),尚未刷新的日志、文件写入和网络请求可能被截断。
队列很长时不要一次创建几十万个 Promise 再交给工作池,这仍会占用大量内存。更合适的方式是从异步迭代器、数据库游标或分页接口按需取下一批;工作池空出位置后再读取新任务。并发限流既限制“正在执行的数量”,也应限制“已经排队等待的数量”。
最后把指标与任务 ID 一起记录:成功数、失败数、重试数、超时数、峰值并发和总耗时。只记录平均耗时会掩盖少量极慢任务;只记录错误文本又无法判断是否超过配额。用这些证据调整 Node.js 并发控制,才能在下一次数据量增加时解释为何改变上限。
总结
控制 Node.js 异步流程的关键是任务关系和资源上限。串行保证依赖,并行缩短少量独立任务耗时,并发限流保护远端服务与本机资源;错误、重试和取消必须一直传播到顶层。最后用峰值计数、退出码和结构化结果验证,而不是看到 Promise resolved 就认为任务完整成功。
延伸学习
- Node.js 事件循环 解释调度基础;
- Node.js 调度器比较 可继续理解任务安排。
-
零基础入门Node.JS 从浅入深的系统的学习Node.JS。
常见问题
Q:Promise.all 会限制并发数吗?
A:不会。传入的 Promise 通常已经启动,批量任务需要显式工作池或限流器。
Q:allSettled 适合所有批处理吗?
A:不适合强一致任务。它适合允许部分成功且需要完整结果清单的场景。
Q:setTimeout 能取消 fetch 吗?
A:单独不能。必须把 AbortSignal 传给 fetch,并在超时时调用 abort。
Q:CPU 密集任务用 async await 能并行吗?
A:不能。async await 只处理异步等待,CPU 密集任务仍会阻塞事件循环,应使用 Worker Threads 或独立进程。