
 TRAE-AI编程

你在写一个 Node.js 工具,需要扫描某个源码文件,把它里面定义的函数全部列出来,却发现没有一行代码能直接做到这件事。先说结论:nodejs 怎样获取当前文件的全部函数,没有内置的一行接口,主流做法有三种——用正则做轻量扫描、用 Acorn 这类解析器把代码解析成语法树再遍历、用 Babel 的 AST 工具链做更精细的提取。选哪种取决于你要的是"快速粗略地看一眼"还是"稳定可靠地用于生产"。本文用可运行示例讲清每种方法的输入输出、边界和常见误区,帮你按场景选对。今天这篇文章,编程狮把这块一次讲透。
先看结论
"列出一个文件里的所有函数"听起来简单,其实涉及一个关键选择:要不要真正理解代码结构。正则不解析语法,只是匹配文本,快但容易误判——注释里的 function、字符串里的内容都会被算进去。解析器则把代码变成一棵语法树,能准确区分函数声明、函数表达式和箭头函数,代价是要引入依赖。
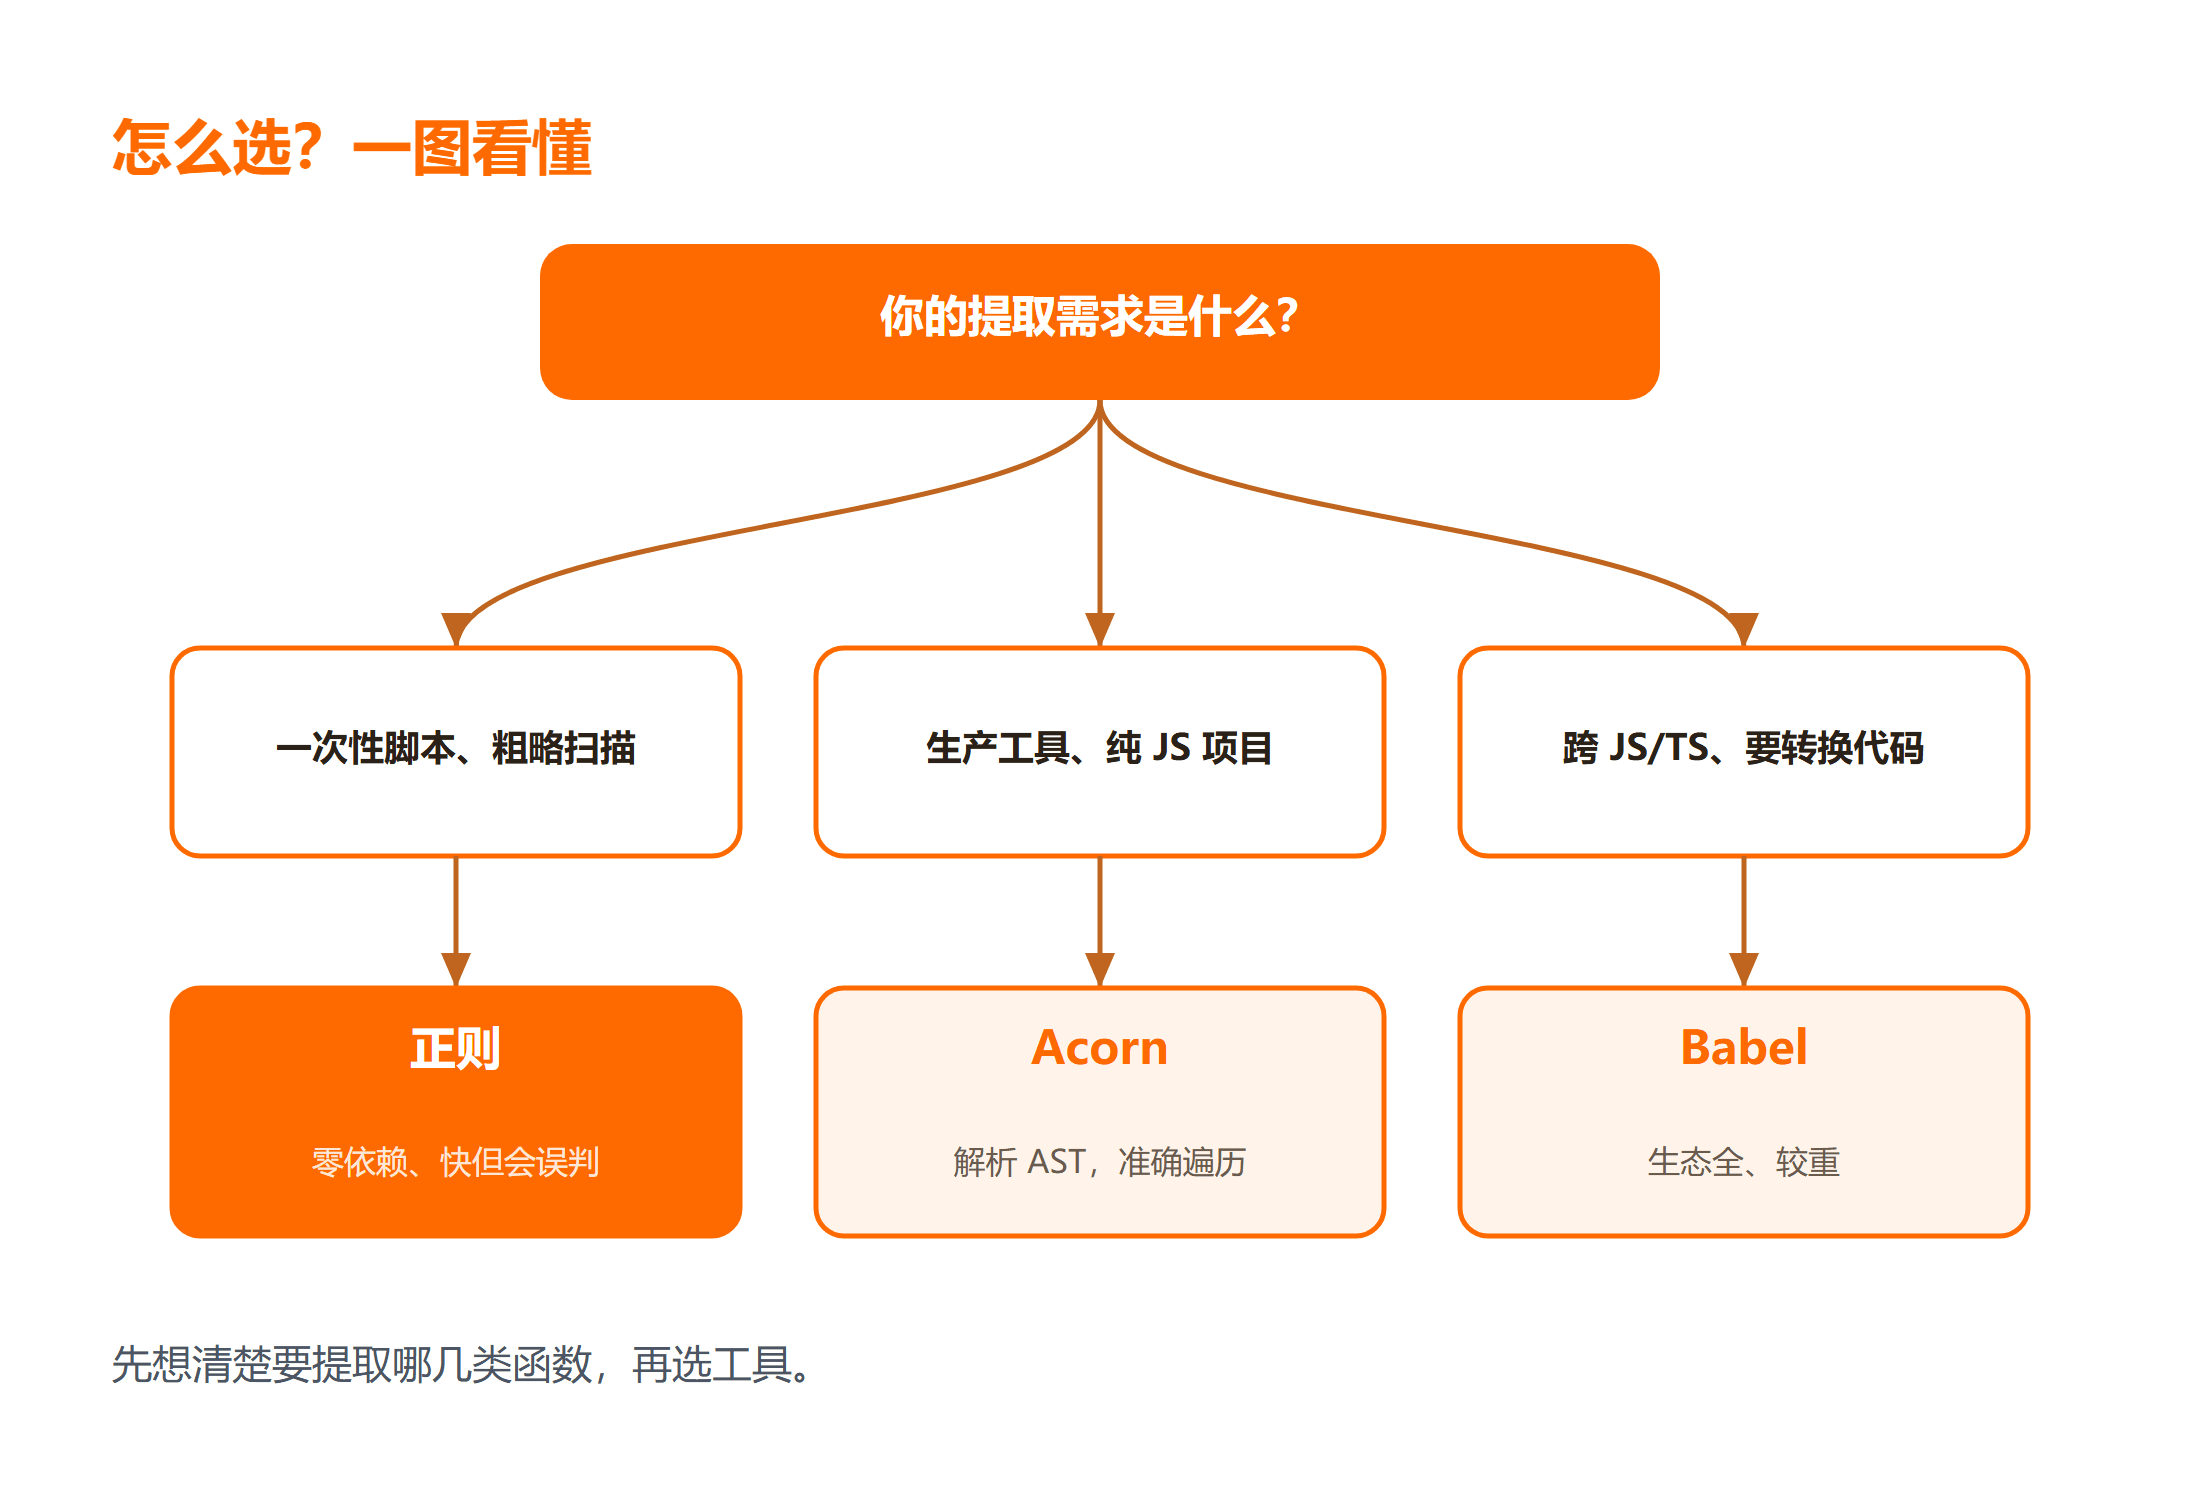
判断标准是用途:一次性脚本、代码量小,正则够用;要集成进工具、处理复杂项目,必须用解析器;需要跨 JS/TS、要转换代码,Babel 工具链更合适。想先把 JavaScript 的函数基础打牢,可以过一遍 JavaScript 教程 的函数章节,把几种函数写法分清。
一、先搞懂"函数"在源码里有几种形态
要提取函数,先得知道你要找的是什么。JavaScript 里"函数"不止一种写法,不同写法在源码里的样子差别很大。
常见形态有四类:函数声明(function foo() {})、函数表达式(const foo = function() {})、箭头函数(const foo = () => {})、以及对象或类里的方法(bar() {})。
正则能覆盖第一种,勉强能碰到第二种,但对箭头函数和对象方法一筹莫展。这也是为什么正则方案只适合粗略扫描——它认的是文本形状,不是语法含义。
一个反直觉的事实:很多"提取函数"的需求,其实只要函数声明就够了,比如生成代码的目录。先想清楚你真正要哪几类函数,能少写很多无用代码。这属于需求边界的判断,比选工具更重要。
💡 小提示:把"要提取哪些形态的函数"写清楚,再选方案。需求模糊时,正则和解析器的结果差异会让你反复返工。
二、方法一:正则快速扫描
最快的方式是用正则匹配函数声明。适合代码量小、结构简单的场景,不需要任何依赖。
一个最小可运行示例:
const fs = require('node:fs');

const code = fs.readFileSync('demo.js', 'utf8');
const re = /function\s+([A-Za-z_$][\w$]*)\s*\(/g;
const names = [];
let m;
while ((m = re.exec(code)) !== null) {
  names.push(m[1]);
}
console.log(names);
预期结果(未在本机执行):输出一个数组,包含 demo.js 里所有形如 function 名字( 的函数名。这段代码做的事是:读文件、全局匹配函数声明、把捕获的名字收集起来。
这条路的边界很清楚:它只匹配 function 名字 这种声明,匹配不到箭头函数和对象方法;而且注释里如果出现 function foo(,也会被误收。追求速度、能接受这些误差时可以用。
想在浏览器里快速试正则,可以配合 JavaScript 在线运行 边写边验证匹配结果。
三、方法二:用 Acorn 解析成语法树
要准确提取,就得让程序真正"读懂"代码。Acorn 是一个轻量的 JavaScript 解析器,能把源码解析成抽象语法树(AST),再遍历节点找函数定义。
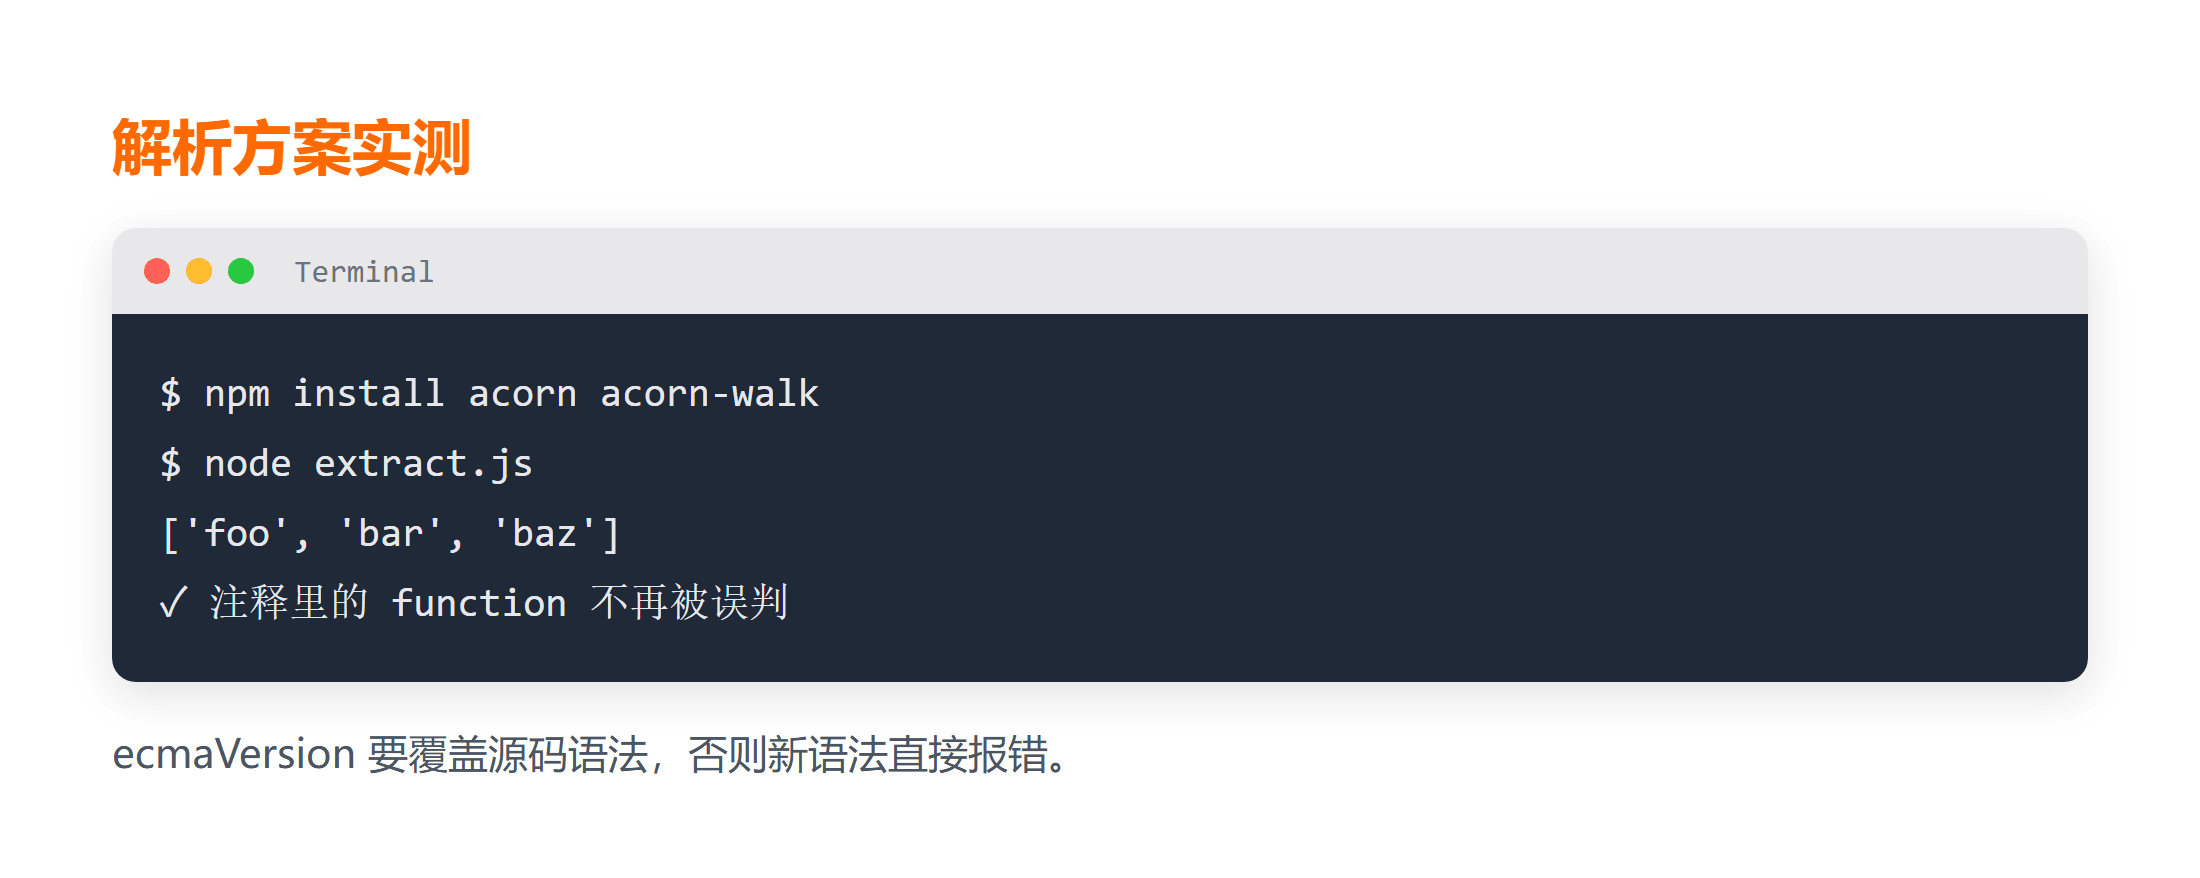
先安装依赖:
npm install acorn acorn-walk然后用解析加遍历的方式提取:
const fs = require('node:fs');
const acorn = require('acorn');
const walk = require('acorn-walk');

const code = fs.readFileSync('demo.js', 'utf8');
const ast = acorn.parse(code, { ecmaVersion: 2022, sourceType: 'module' });
const names = [];
walk.simple(ast, {
  FunctionDeclaration(node) {
    if (node.id) names.push(node.id.name);
  },
  ArrowFunctionExpression(node) {
    if (node.id) names.push(node.id.name);
  }
});
console.log(names);
上面这段做的是:把代码解析成 AST,遍历时遇到函数声明和箭头函数就记录名字。预期结果(未在本机执行):输出源码里函数声明的名字列表。相比正则,它不会把注释里的 function 当函数。
注意一个细节:ecmaVersion 要设成能覆盖你代码语法的版本,太低的版本解析新语法会直接报错。这是解析方案最常见的失败点。
四、方法三:Babel 工具链与横向对比
第三种是用 Babel 的 AST 工具链。它比 Acorn 重,但生态更全,支持 TypeScript、JSX,还能在提取的同时做代码转换,适合大型工具链。
三种方法摆在一起看:
| 方法 | 准确度 | 依赖 | 适用边界 |
|---|---|---|---|
| 正则 | 低 | 无 | 粗略扫描、一次性脚本 |
| Acorn | 高 | 轻量 | 生产工具、纯 JS 项目 |
| Babel | 高 | 较重 | 跨 JS/TS、需代码转换 |
4.1 反例、边界与常见失败
几个真实会踩的坑,逐个说清现象和处理:
- 注释误判:正则把注释里的
function当函数。改用解析器,或扫描前先去掉注释。 - 解析报错:Acorn 报 Unexpected token,多半是
ecmaVersion设太低,或代码里有 TS 语法。调高版本或换 Babel。 - 匿名函数:箭头函数常没有名字,
node.id为空。要拿到名字得往上找它被赋值给的变量。 - 失败排查:提取结果为空,先确认文件路径读对了,再确认语法类型匹配——你找声明,代码里却全是箭头函数。
⚠️ 注意:处理用户上传或不可信的源码时,解析库本身相对安全,但别用
eval去"执行后反射函数",那会引入代码执行风险。
4.2 动手核对清单
按顺序做一遍,覆盖从需求到验证的完整任务:
- 前置:明确要提取哪几类函数(声明/表达式/箭头/方法);
- 操作:按需求选方法——粗略看用正则,生产用 Acorn,跨 TS 用 Babel;
- 检查:确认
ecmaVersion或解析器配置覆盖源码语法; - 验证:用一个同时含四种写法的样例文件,核对提取结果是否齐全;
- 失败处理:按报错关键词回到对应环节重查,不盲目换库。
以上依赖与参数基于 Acorn 8.x、Babel 7.x 的通用用法,标注为依据官方 API 语义整理的预期结果,未在本机执行;不同版本接口可能调整。想系统补齐语法基础,可翻 JavaScript 速查手册 对照函数相关条目。
总结
nodejs 获取当前文件的全部函数,核心是"要不要真正解析语法"。粗略扫一眼用正则,快但会误判;稳定可靠用 Acorn 解析成 AST 再遍历;跨 JS/TS、要转换代码用 Babel。先想清楚要提取哪几类函数,再选工具,能少走弯路。
要点带走:
- 正则只认文本形状,注释和字符串会造成误判;
- 解析器要设对
ecmaVersion,否则新语法直接报错; - 匿名箭头函数要靠赋值变量拿名字。
下一步,可以系统学一遍 AST 与编译原理入门,把"代码即数据"的思路建立起来。
常见问题
Q:为什么正则匹配不到箭头函数?
A:因为箭头函数没有统一的 function 名字 文本形状,正则无从匹配。要提取箭头函数,得用解析器遍历 AST,识别 ArrowFunctionExpression 节点。
Q:Acorn 解析时报 Unexpected token 怎么办?
A:多半是 ecmaVersion 设得太低,覆盖不了源码里的新语法。把它调到你代码对应的版本,比如 ES2022 用 ecmaVersion: 2022。若代码含 TypeScript 语法,需改用 Babel。
Q:能提取到类里的方法名吗?
A:可以,但要遍历 MethodDefinition 节点,而不是 FunctionDeclaration。不同写法对应不同 AST 节点类型,先确认你要的形态再决定遍历哪些节点。
延伸学习
想把这块知识系统补齐,可以按这个顺序来:
- 想系统学 JavaScript 的模块化与原生能力,可以看 JavaScript原生模块编程实战微课;
- 对照"提取当前对象信息"的思路,翻 Java如何获取当前日期和时间;
- 需要验证正则或查语法时,用 Javascript开发资源 快速定位。



