
 TRAE-AI编程

你接好了 DeepSeek 的输出过滤规则,怎么确认它真的在生效,而不只是配置页面上看起来打开了?最直接的答案是:构造一条必然被拦的输入和一条必然放行的输入,分别走"原始模型输出"和"经过过滤层"两条路径,对比响应差异,再核对命中标记。本文用一份可复制的 Python 脚本把这套验证跑通,覆盖误杀、漏放和接口失败三类分支,帮你把"应该生效"变成"有证据的生效"。全文基于 Python 3.9+ 与 Chat Completions 接口,版本差异和适用边界在文末一并说明。今天这篇文章,编程狮把这块讲透。
先看结论
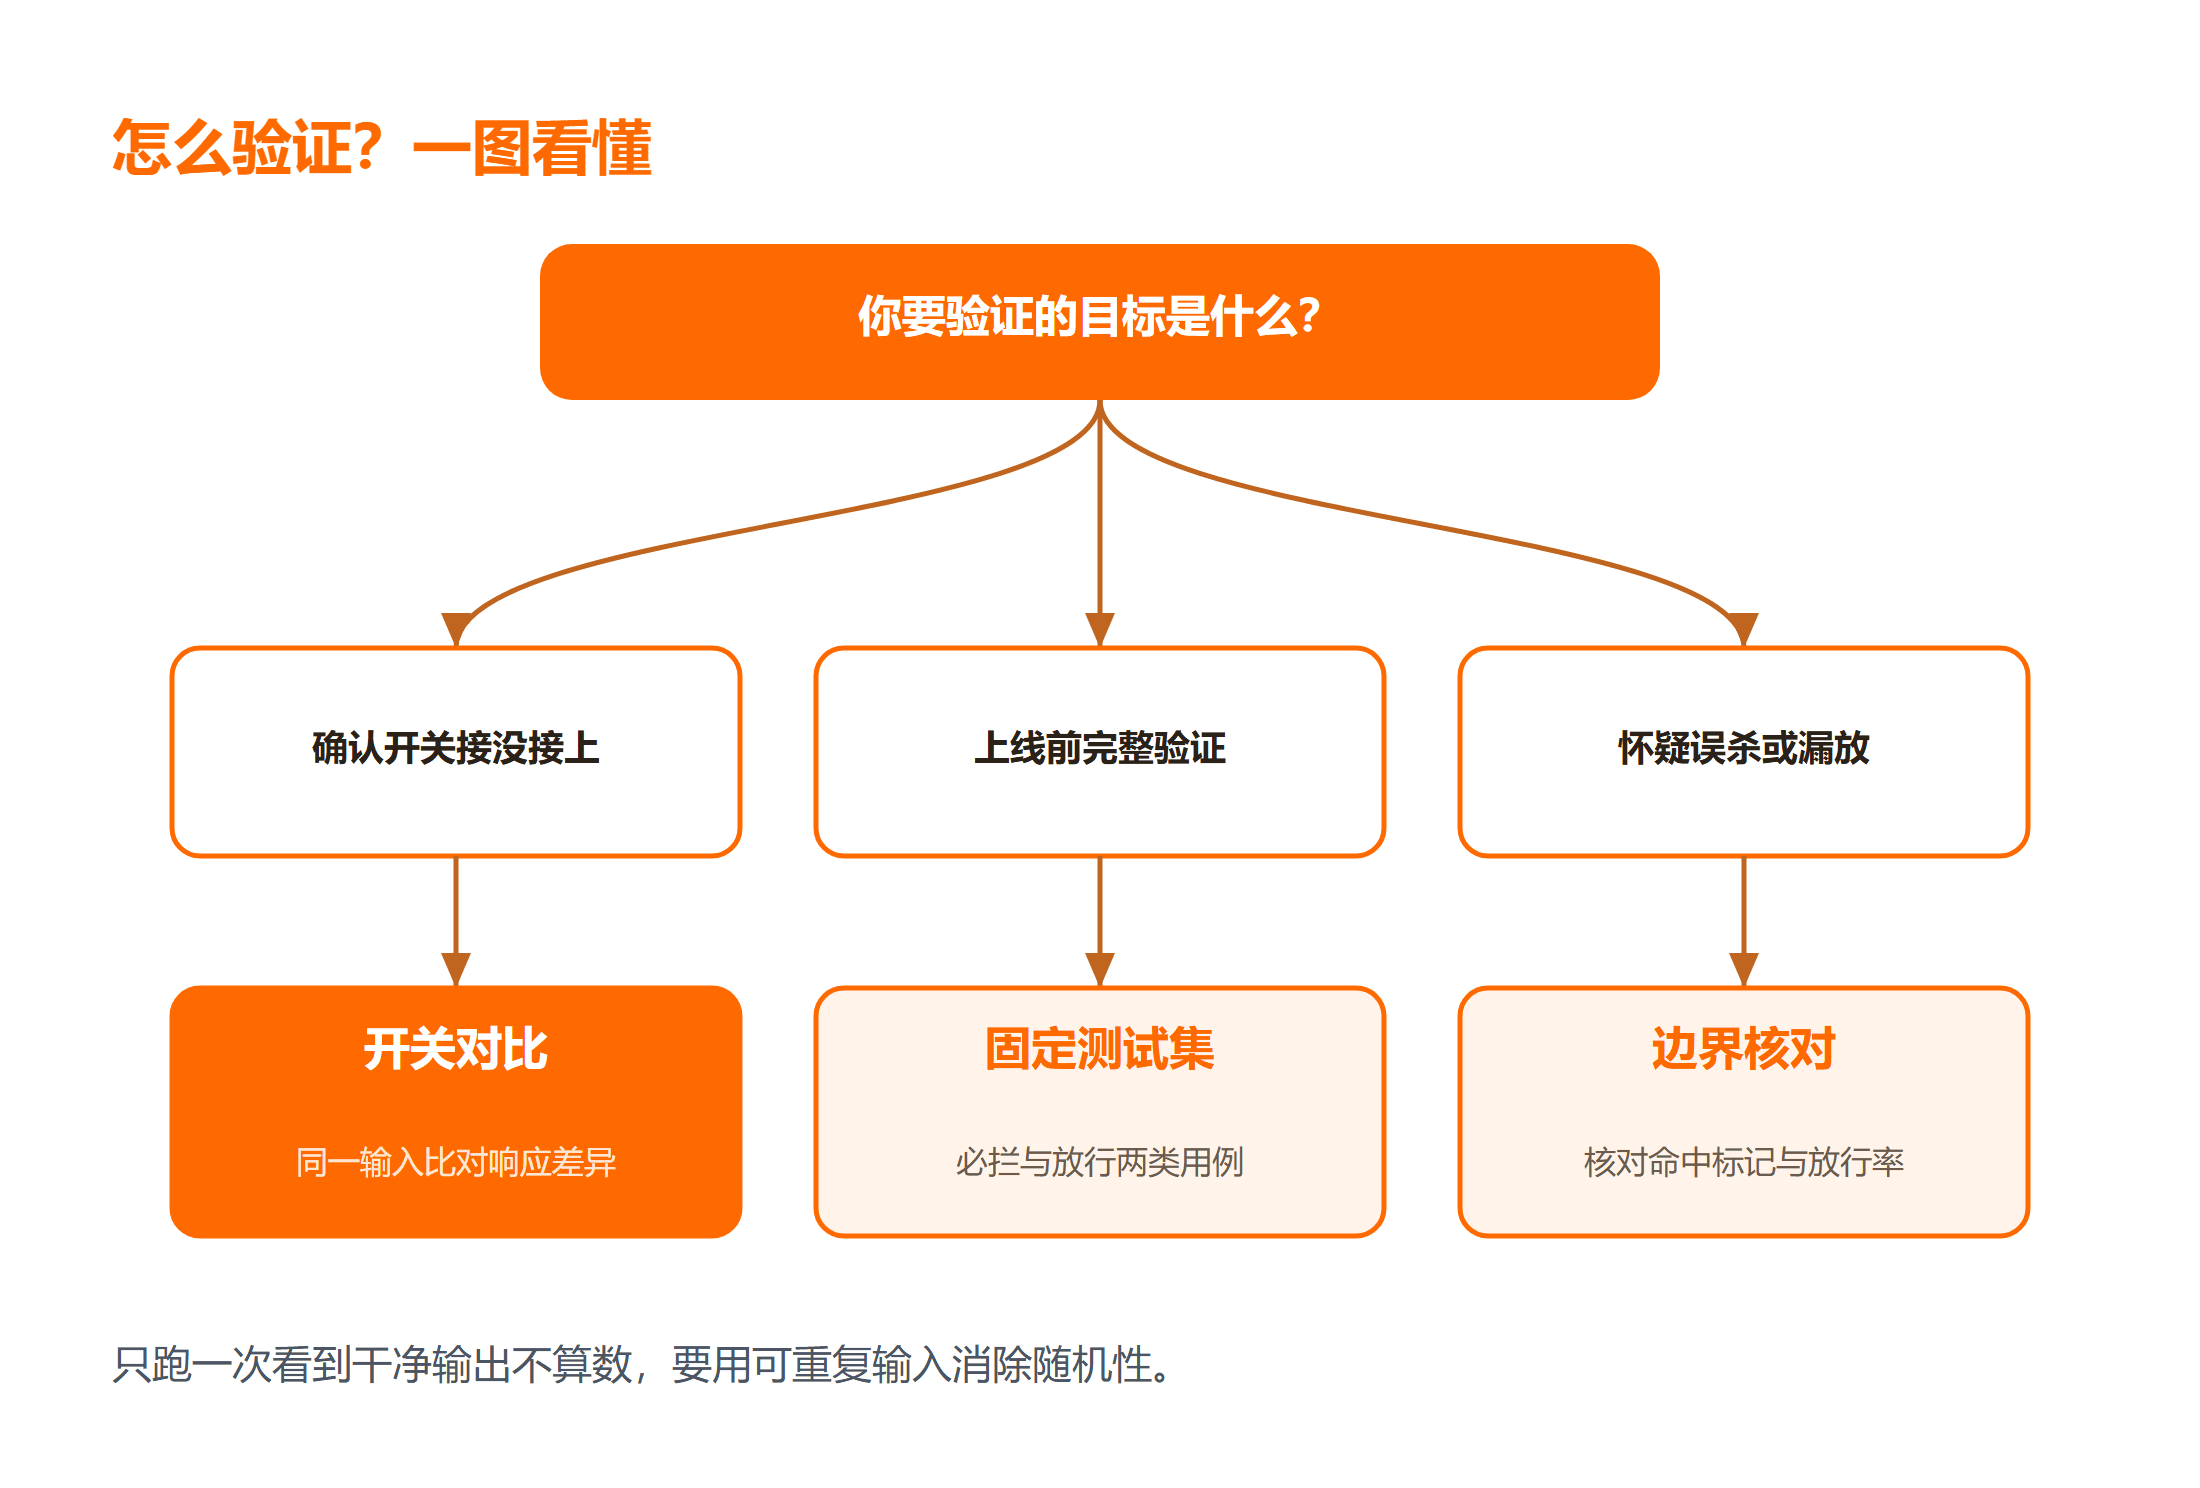
输出过滤是否生效,不能只靠"我配了规则"这句主观判断,要看三个可观察的证据同时成立:第一,同一条输入在关掉过滤时能得到原始输出,打开过滤后响应出现差异(被替换、被拦截或带上命中标记);第二,命中记录能说明是哪条规则起作用,而不是碰巧模型那次没生成敏感内容;第三,正常内容不被误伤,放行率和预期一致。
判断用哪种验证深度也很简单:只是想快速确认开关有没有接上,做一次"开/关对比"就够;要上线到真实业务,就必须补一套固定测试集,把误杀和漏放两个方向都跑一遍。想先把 DeepSeek 的接口调用弄熟,可以过一遍 DeepSeek 中文教程 的入门章节。
一、先弄清要验证的对象:过滤发生在哪一层
动手之前先定位过滤层,否则你验证的可能是另一个环节。常见的位置有三个:模型服务端自带的内容安全策略、你在应用代码里加的关键词或正则过滤、以及前置代理网关的审核模块。三者的输出表现不同——服务端策略通常返回固定的拒答文案,应用层过滤由你的代码决定替换逻辑,网关层则多在响应头或状态码里留下痕迹。
本文以"应用层输出过滤"为验证对象,因为它最可控、也最容易写出可复现脚本。所谓输出过滤,指的是模型已经生成内容、但还没展示给用户之前,你的代码对这段文本做一次检查:命中敏感词就拦截或替换,未命中就原样放行。它和输入过滤是两回事,输入过滤拦的是用户提示词,输出过滤拦的是模型回答,验证时不要混在一起。
一个高频误区:把"模型这次没输出敏感内容"当成过滤生效。模型生成有随机性,同一提示词多次调用结果可能不同。只跑一次看到干净输出,无法区分是过滤起作用还是模型恰好没生成。所以后面所有验证都强调"开/关对比"和"固定测试集",本质是用可重复的输入消除随机性干扰。
二、准备可复现的最小验证环境
先装依赖、配密钥,再写脚本。命令和环境如下(Python 3.9+,requests 2.28+):
python -m pip install "requests>=2.28"
export DEEPSEEK_API_KEY="你的实际密钥"
配置密钥时注意两点:不要把密钥硬编码进脚本,用环境变量读取;验证用的密钥建议单独申请或在控制台设低额度,避免测试流量影响生产账单。检查配置是否生效,可以先跑一条最小请求确认能拿到响应。语法细节可对照 Python 速查手册。
三、跑通三步验证:原始输出、过滤后、命中标记
核心脚本做三件事:调用接口拿原始输出、对输出跑过滤函数、打印对比结果。把下面内容存为 verify_output_filter.py:
# verify_output_filter.py —— 验证输出过滤是否生效
import os
import requests

API = "https://api.deepseek.com/chat/completions"

# 演示用的占位词,实际项目替换为你的业务词表
SENSITIVE = ["占位敏感词一", "占位敏感词二"]

def call_model(prompt: str, key: str) -> str:
    resp = requests.post(
        API,
        headers={"Authorization": f"Bearer {key}"},
        json={"model": "deepseek-chat",
              "messages": [{"role": "user", "content": prompt}]},
        timeout=30,
    )
    resp.raise_for_status()
    return resp.json()["choices"][0]["message"]["content"]

def output_filter(text: str, words: list) -> dict:
    hits = [w for w in words if w in text]
    return {"pass": not hits, "hits": hits}

if __name__ == "__main__":
    key = os.environ["DEEPSEEK_API_KEY"]
    prompt = "请复述下面这句话:占位敏感词一"
    raw = call_model(prompt, key)
    result = output_filter(raw, SENSITIVE)
    print("原始输出:", raw)
    print("测试结果:", result)
运行命令与预期结果(未在本机执行,标注为预期):
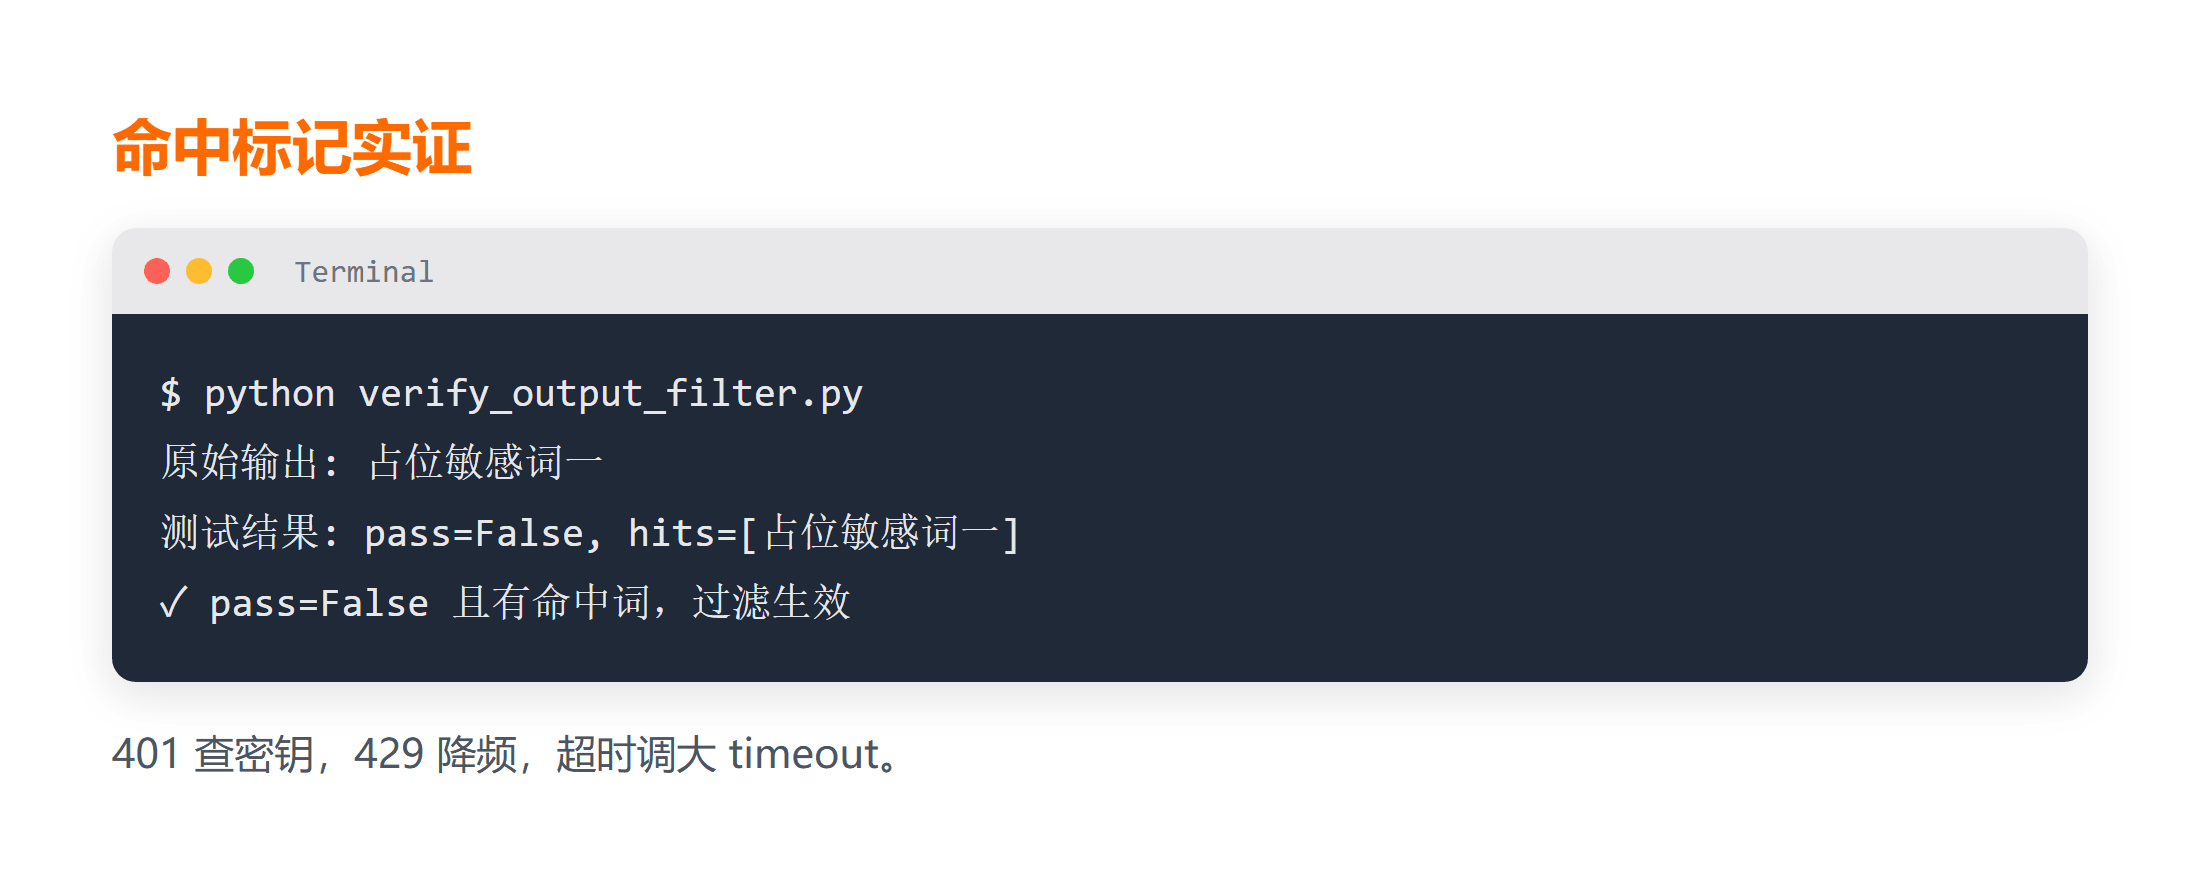
python verify_output_filter.py
# 预期输出(过滤生效时):
# 原始输出: 占位敏感词一
# 测试结果: {'pass': False, 'hits': ['占位敏感词一']}
看到 pass 为 False 且 hits 列出命中词,说明过滤函数确实拦住了这条输出。这就是"原始输出"和"过滤后"的差异证据。
3.1 失败分支怎么处理
真实调用不会每次都顺利,三类常见失败要能定位:
- 401 未授权:密钥错误或环境变量没读到。检查
DEEPSEEK_API_KEY是否导出成功,重新执行一次echo $DEEPSEEK_API_KEY确认非空。 - 429 限流:测试请求太密。把调用间隔拉到 2 秒以上,或降低测试频次后重试。
- 超时或连接失败:网络或服务端临时波动。脚本里
timeout=30已经兜底,捕获异常后按指数退避重试,不要立刻狂刷。
修复的原则是"先复现、再定位、后改配置",每次只改一个变量,否则无法判断是哪处改动让验证通过了。
四、边界、误杀与漏放:信息增量在这里
一个只测"必拦输入"的验证是不完整的,因为它证明不了正常内容能顺利通过。补一组反向测试用例:把提示词换成完全中性的内容(例如"用一句话解释什么是数组"),跑同样的脚本,预期 pass 为 True、hits 为空。如果出现正常内容被拦,就是误杀,通常是词表过宽或匹配方式太粗暴(比如把子串匹配用在了短词上)。
漏放是另一个方向:输入里带敏感内容,但经过模型改写后绕过了你的词表。这类问题说明纯关键词过滤的能力边界——它只能匹配字面,无法理解同义改写。适用场景要讲清楚:关键词过滤适合规则明确、变体少的场景;变体多、语境复杂的审核,需要引入语义模型,性能开销和延迟都会上升,这是取舍,不是 bug。
| 验证方向 | 输入类型 | 预期结果 | 失败意味着 |
|---|---|---|---|
| 必拦 | 含占位敏感词 | pass=False | 过滤没接上或词表没命中 |
| 放行 | 中性内容 | pass=True | 误杀,词表过宽 |
| 漏放 | 改写后的敏感内容 | 按业务定义 | 需语义审核,超关键词边界 |
对比三类结果,你才能对过滤效果下结论。若你还用 OpenClaw 等工具做代理层审核,验证思路一致:看响应差异和命中标记,只是检查位置从应用代码换到网关日志。
总结
验证输出过滤是否生效,核心是"对比"和"可重复"两件事:用同一条输入对比开/关过滤的响应差异,用固定测试集消除模型随机性。三步走完——构造必拦与放行用例、运行脚本对比原始输出与过滤结果、核对命中标记与失败分支——你就能拿到可复现的证据,而不是靠一次干净的回答自我安慰。记住关键词过滤有边界:变体多的审核要上语义模型,这是性能与准确率的取舍。
常见问题
Q:只跑一次看到没有敏感词,能算过滤生效吗?
A:不能。模型生成有随机性,一次干净输出无法区分是过滤起作用还是模型恰好没生成。必须用固定输入做"开/关对比",并至少跑必拦和放行两类用例。
Q:测试调用会不会产生真实费用?
A:会。Chat Completions 按 Token 计费,验证请求同样计入。建议用低额度测试密钥、控制用例数量,跑完及时核对控制台账单,避免把测试流量混进生产统计。
Q:关键词过滤和语义审核该怎么选?
A:规则明确、变体少的场景用关键词过滤,实现简单、延迟低;变体多、依赖语境的审核用语义模型,准确率更高但成本和延迟上升。先用关键词过滤覆盖明确规则,剩下的边界再考虑语义方案,是常见的分步策略。
延伸学习
想把这块知识系统补齐,可以按这个顺序来:
- 想把 DeepSeek 用进真实业务场景,可以看 AI智能客服系统(DeepSeek+豆包AI+Node.JS);
- 对照"生成结果怎么运行"的写法,翻 DeepSeek生成HTML代码怎么运行;
- 想在 IDEA 里接入同类能力时,用 IDEA中使用DeepSeek 做参照。



