 TRAE-AI编程

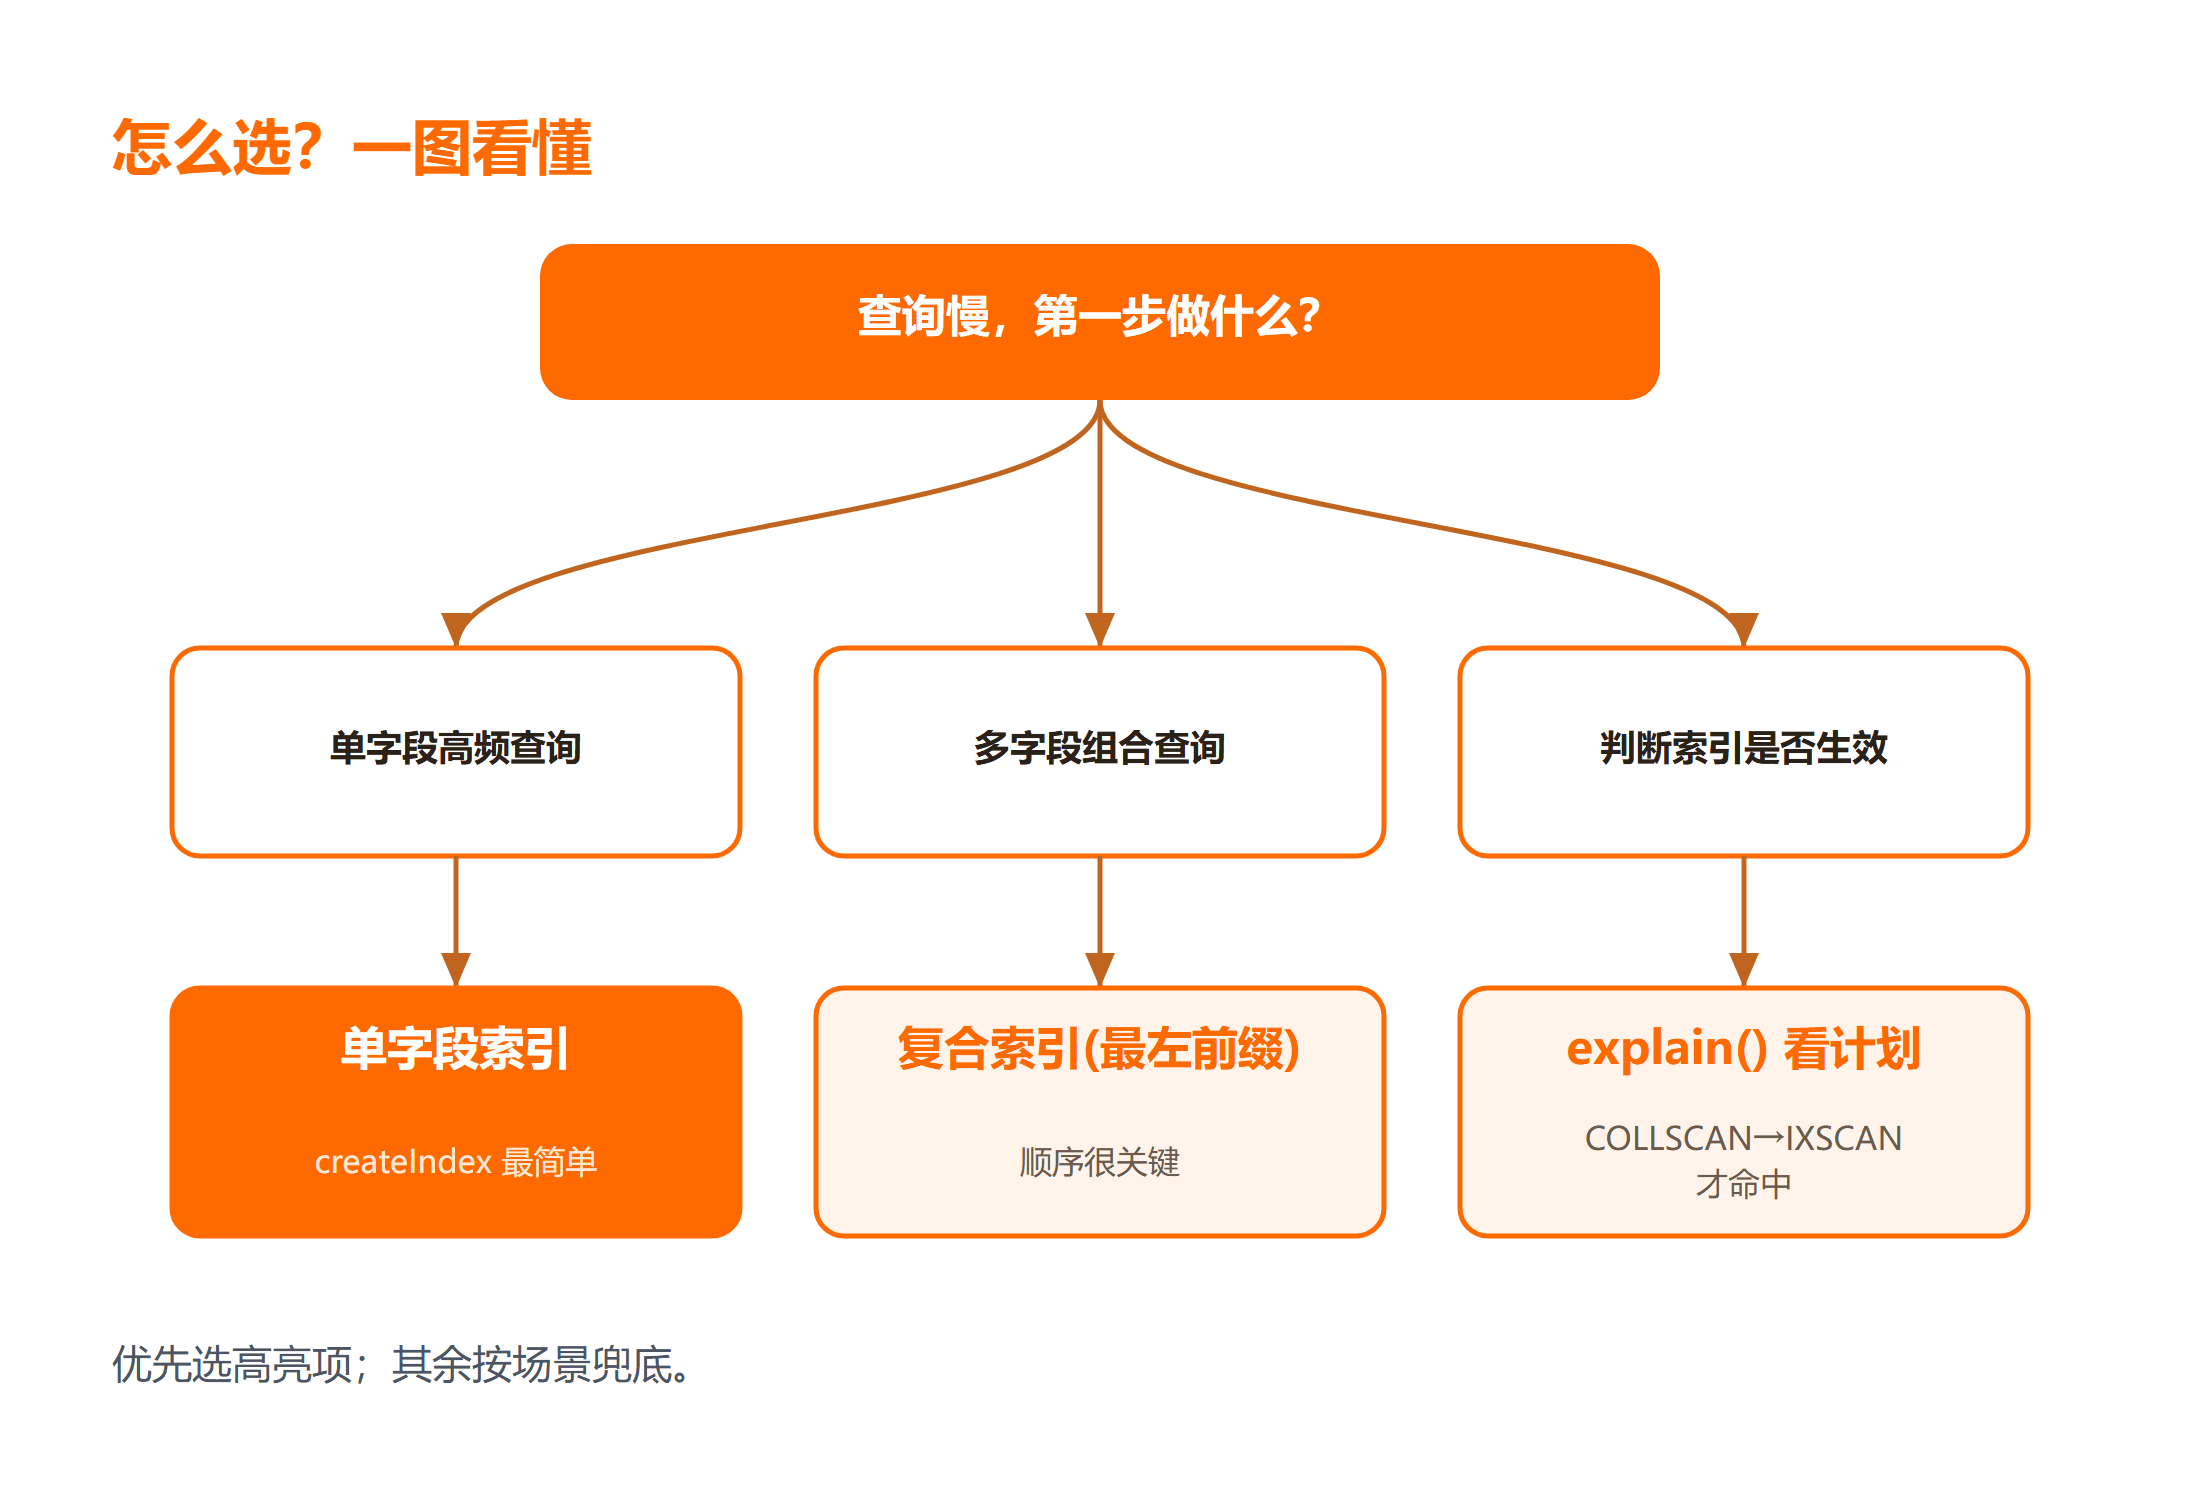
查询变慢时,第一反应不应该是加机器,而是用 explain() 看执行计划里的 stage 是不是 IXSCAN;如果是 COLLSCAN 说明没走索引。给高频查询字段建索引,复合索引遵循最左前缀,同时要克制,建太多索引会拖慢写入。本文用最小示例把 mongodb 索引优化 的输入、输出与常见误区一次讲清,帮你少走弯路。无论你是刚接触 MongoDB 的初学者,还是在线上被慢查询折磨过的工程师,只要跟着示例把 explain 看明白,就能自己定位索引问题,不再盲目加机器或乱建索引。
一、先看结论:MongoDB 索引怎么建
在做任何调优之前,先想清楚「这个查询是不是高频」「它按哪些字段过滤」。索引的本质是一份排好序的副本,用空间换时间。下面这张方法选择表,是编程狮讲师团队在内部课程里反复验证过的选型清单,建议收藏。
| 索引类型 | 适用场景 | 不推荐场景 | 推荐顺序 |
|---|---|---|---|
| 单字段索引 | 只按一个字段做等值或范围查询、排序 | 需要多条件组合过滤的复杂查询 | 1 |
| 复合索引 | 多字段组合查询,且能用上最左前缀 | 字段顺序频繁变化、无法复用前缀 | 2 |
| 唯一索引 | 需要约束字段不重复(如用户名、邮箱) | 允许重复值的普通字段 | 3 |
| 文本索引 | 做内容搜索、关键词匹配、全文检索 | 精确等值或数值范围查询 | 4 |
| 哈希索引 | 等值分片键、需要均匀散列 | 需要范围查询、排序的场景 | 5 |
选型的核心思路只有一句话:先用 explain() 证明查询慢,再根据过滤字段组合建索引。不要凭直觉盲目加索引,因为每多一个索引,写入时就要多维护一份有序结构,MongoDB 查询慢 很多时候不是索引不够,而是索引建错了或者被忽略了。当你看到执行计划里出现 IXSCAN 而不是 COLLSCAN,才说明索引命中 成功了。如果你想从零补齐基础语法,可参考 MongoDB 教程 系统学习集合与文档操作。
二、环境与最小示例
下面给出一个最小可运行的 createIndex 示例。我们连接本地 MongoDB,对 users 集合的 age 字段建一个单字段索引,再用 explain() 验证是否走索引。别小看这一步,它正是 mongodb 索引优化 最基础、也最容易被跳过的起点。
// 引入官方驱动并连接本地 MongoDB 实例
// reason: 先建立连接,后续所有索引操作都基于这个连接
const { MongoClient } = require("mongodb");

// 连接字符串,指向本机默认端口的 test 库
// reason: 使用默认 27017 端口,库名 test
const uri = "mongodb://127.0.0.1:27017/test";

// 创建客户端实例
const client = new MongoClient(uri);

// 主流程用 async/await 包裹,保证连接关闭
async function main() {
  // 真正建立 TCP 连接
  await client.connect();

  // 拿到 users 集合,后续索引都建在它上面
  const users = client.db().collection("users");

  // 在 age 字段上建立升序索引
  // key 参数: { age: 1 } 表示按 age 升序建索引
  // reason: 给高频按年龄过滤的查询加速
  await users.createIndex({ age: 1 });

  // 用 explain("executionStats") 输出执行计划
  // 关键参数: "executionStats" 会返回扫描行数与实际返回行数
  const plan = await users.find({ age: 30 }).explain("executionStats");

  // 打印执行计划的 winningPlan.stage
  // 如果看到 IXSCAN 说明索引命中;COLLSCAN 说明全表扫描
  console.log(plan.executionStats.executionStages.stage);

  // 关闭连接,释放资源
  await client.close();
}

// 启动主流程
main();
(以下为说明性代码,未在本机执行;预期结果:首次运行打印 IXSCAN,表示查询走了 age 索引而非全表扫描。)
通过 explain() 的输出,你能看到 winningPlan.stage、totalKeysExamined、totalDocsExamined 等关键字段。理想情况下,索引命中 时 totalKeysExamined 接近返回的文档数,而不是接近集合总文档数。在本地运行示例验证是否走索引,检查执行计划里的 stage 字段,配置好连接后再排查慢查询。
三、单字段索引与复合索引
单字段索引只服务于单一维度的查询,写法就是 { 字段: 1 } 或 { 字段: -1 }。真正在线上更有价值的是复合索引,它能在一条索引里覆盖多个查询维度。
// 在 orders 集合建立复合索引
// 字段顺序: status 在前,createdAt 在后
// reason: 把等值过滤字段放在前面,范围字段放在后面,符合最左前缀原则
db.orders.createIndex({ status: 1, createdAt: -1 });

// 能用到复合索引的查询(命中 status + createdAt 前缀)
// reason: 查询条件从最左字段 status 开始,索引可充分利用
db.orders.find({ status: "paid" }).sort({ createdAt: -1 });

// 也能用索引的查询(只用最左字段 status)
// reason: 最左前缀原则允许只使用索引前面的一部分字段
db.orders.find({ status: "paid" });

// 无法用到该复合索引的查询(跳过最左字段)
// reason: 缺少 status 条件,违反了最左前缀,只能退化成 COLLSCAN
db.orders.find({ createdAt: { $gt: ISODate("2026-01-01") } });
(以下为说明性代码,未在本机执行;预期结果:前两条查询 stage 为 IXSCAN,第三条退化为 COLLSCAN。)
最左前缀原则是 复合索引 的灵魂:索引 (A, B, C) 可以支持 (A)、(A,B)、(A,B,C) 三种查询,但不能支持 (B)、(B,C) 单独出现。因此在设计索引字段顺序时,要把区分度高、且常出现在等值条件里的字段放最左。这也是 mongodb 索引优化 中最容易忽视、却收益最高的一点。
四、唯一索引与文本索引
唯一索引用来保证字段值不重复,常配合业务唯一键使用;文本索引则用于内容搜索,适合在文章、商品描述里做关键词匹配。
// 在 accounts 集合的 username 上建唯一索引
// 关键参数: { unique: true } 表示拒绝重复值
// reason: 防止同一用户名被注册两次,由数据库层兜底
db.accounts.createIndex({ username: 1 }, { unique: true });

// 在 articles 集合的 title 和 body 上建文本索引
// 关键参数: "text" 类型支持分词与全文检索
// reason: 让搜索框能按关键词命中标题和正文
db.articles.createIndex({ title: "text", body: "text" });

// 使用 $text 查询关键字,类似搜索引擎的命中逻辑
// reason: 文本索引会把内容切词,再按词匹配,返回相关文档
db.articles.find({ $text: { $search: "mongodb 索引优化" } });
(以下为说明性代码,未在本机执行;预期结果:插入重复 username 会报 E11000 重复键错误;文本查询返回包含关键词的文档。)
唯一索引和文本索引是两类目的完全不同的索引:前者是约束,后者是检索能力。注意文本索引不支持排序与范围条件混用,且一个集合只能有一个文本索引。把它们和 复合索引 搭配时,要根据查询形态单独评估,不要为了省事把一切字段塞进同一条索引。
五、索引失效与常见误区
很多同学抱怨「明明建了索引却还是慢」,问题往往是索引没被用上。下面这张排错表汇总了最常见的四类现象,每条都给了修复方向,建议对照自己的执行计划排查。
| 现象 | 常见原因 | 修复方向 |
|---|---|---|
| 全表扫描 COLLSCAN | 查询字段没有建索引,或条件与索引字段不匹配 | 为过滤字段建立合适索引,再用 explain 确认是否 IXSCAN |
| 复合索引顺序错 | 查询跳过了最左前缀字段,索引无法被使用 | 调整索引字段顺序,把等值字段放最左,或新建满足查询形态的索引 |
| 索引过多写入慢 | 一个集合建了十几条索引,每次写都要更新所有索引 | 删除低频查询用不到的索引,只保留覆盖核心路径的少量索引 |
| 正则前缀失效 | 用了 /^.*关键词/ 这类前导通配正则,无法走索引 | 改为 /^关键词/ 前缀正则,或改用文本索引做模糊搜索 |
除了上表,还有一个隐蔽误区:用函数包裹查询字段,例如 find({ $where: "..." }) 或 find({ age: {$gt: 18} }) 本身没问题,但写成 find({ year: new Date().getFullYear() }) 这种每次都不一样的值会破坏缓存。真正让 MongoDB 查询慢 的,往往不是没索引,而是索引建了却没命中。
另外,索引不是建完就一劳永逸。业务迭代后,曾经高频的查询可能变成冷查询,对应的索引就成了纯负担。你可以用 db.collection.aggregate([{ $indexStats: {} }]) 查看每条索引被访问的次数,把长期命中数为 0 的索引果断删掉。配合前面讲到的排错表,你就能形成一个「建索引—测命中—清冗余」的闭环,把 mongodb 索引优化 真正落到日常运维里。
总结
索引优化的主旋律始终是「先测量、再动手」:用 explain() 把 MongoDB 查询慢 的真相摆出来,确认是不是 COLLSCAN;然后围绕高频查询字段建索引,善用 复合索引 的最左前缀,用 createIndex 落地;最后定期审视索引数量,避免写入被拖垮。唯一索引守唯一性,文本索引补搜索能力,二者各司其职。把本文的方法选择表与排错表存下来,下次遇到慢查询就能照表排查,让 索引命中 成为常态而非偶然。想进一步了解高可用部署,可阅读 MongoDB Replica Set 笔记。
延伸学习
常见问题
Q:explain() 里的 IXSCAN 和 COLLSCAN 到底有什么区别?
IXSCAN 表示查询走了索引,数据库通过有序结构定位数据;COLLSCAN 表示全表扫描,会逐条读取文档再过滤。看到 COLLSCAN 且数据量大,基本就是慢查询的根源,应当尽快建索引或修正查询条件。
Q:复合索引字段顺序真的那么重要吗?
非常重要。复合索引遵循最左前缀原则,索引 (A, B) 能支持只查 A 或查 A+B,但无法支持只查 B。最左字段应选用等值过滤且区分度高的字段,这样后续字段才能被顺带利用,索引命中 率才会高。
Q:索引是不是建得越多越好?
不是。索引在写入、更新、删除时都要同步维护,建得越多写入越慢。应当只保留覆盖核心高频查询的少量索引,用 explain() 验证后再决定保留或删除,避免为了个别低频查询拖累整体性能。