 TRAE-AI编程

你在做后台列表时,前端要第 2 页、每页 10 条,SQL 该怎么写才不会越翻越慢?SQL 分页查询有 3 种主流写法:用 LIMIT 配合 OFFSET 做偏移分页、用"上一页最大 ID"做键集分页、以及用窗口函数 ROW_NUMBER 做编号分页。选错方式最常见的问题是翻到后段时 OFFSET 越来越大、查询越来越慢,或者在有新增数据时漏掉或重复记录。本文以 MySQL 8 为例,从最小可运行示例讲到三种写法的边界、性能差别和常见失败,并给出一份实操清单,帮你按场景选对分页方式。
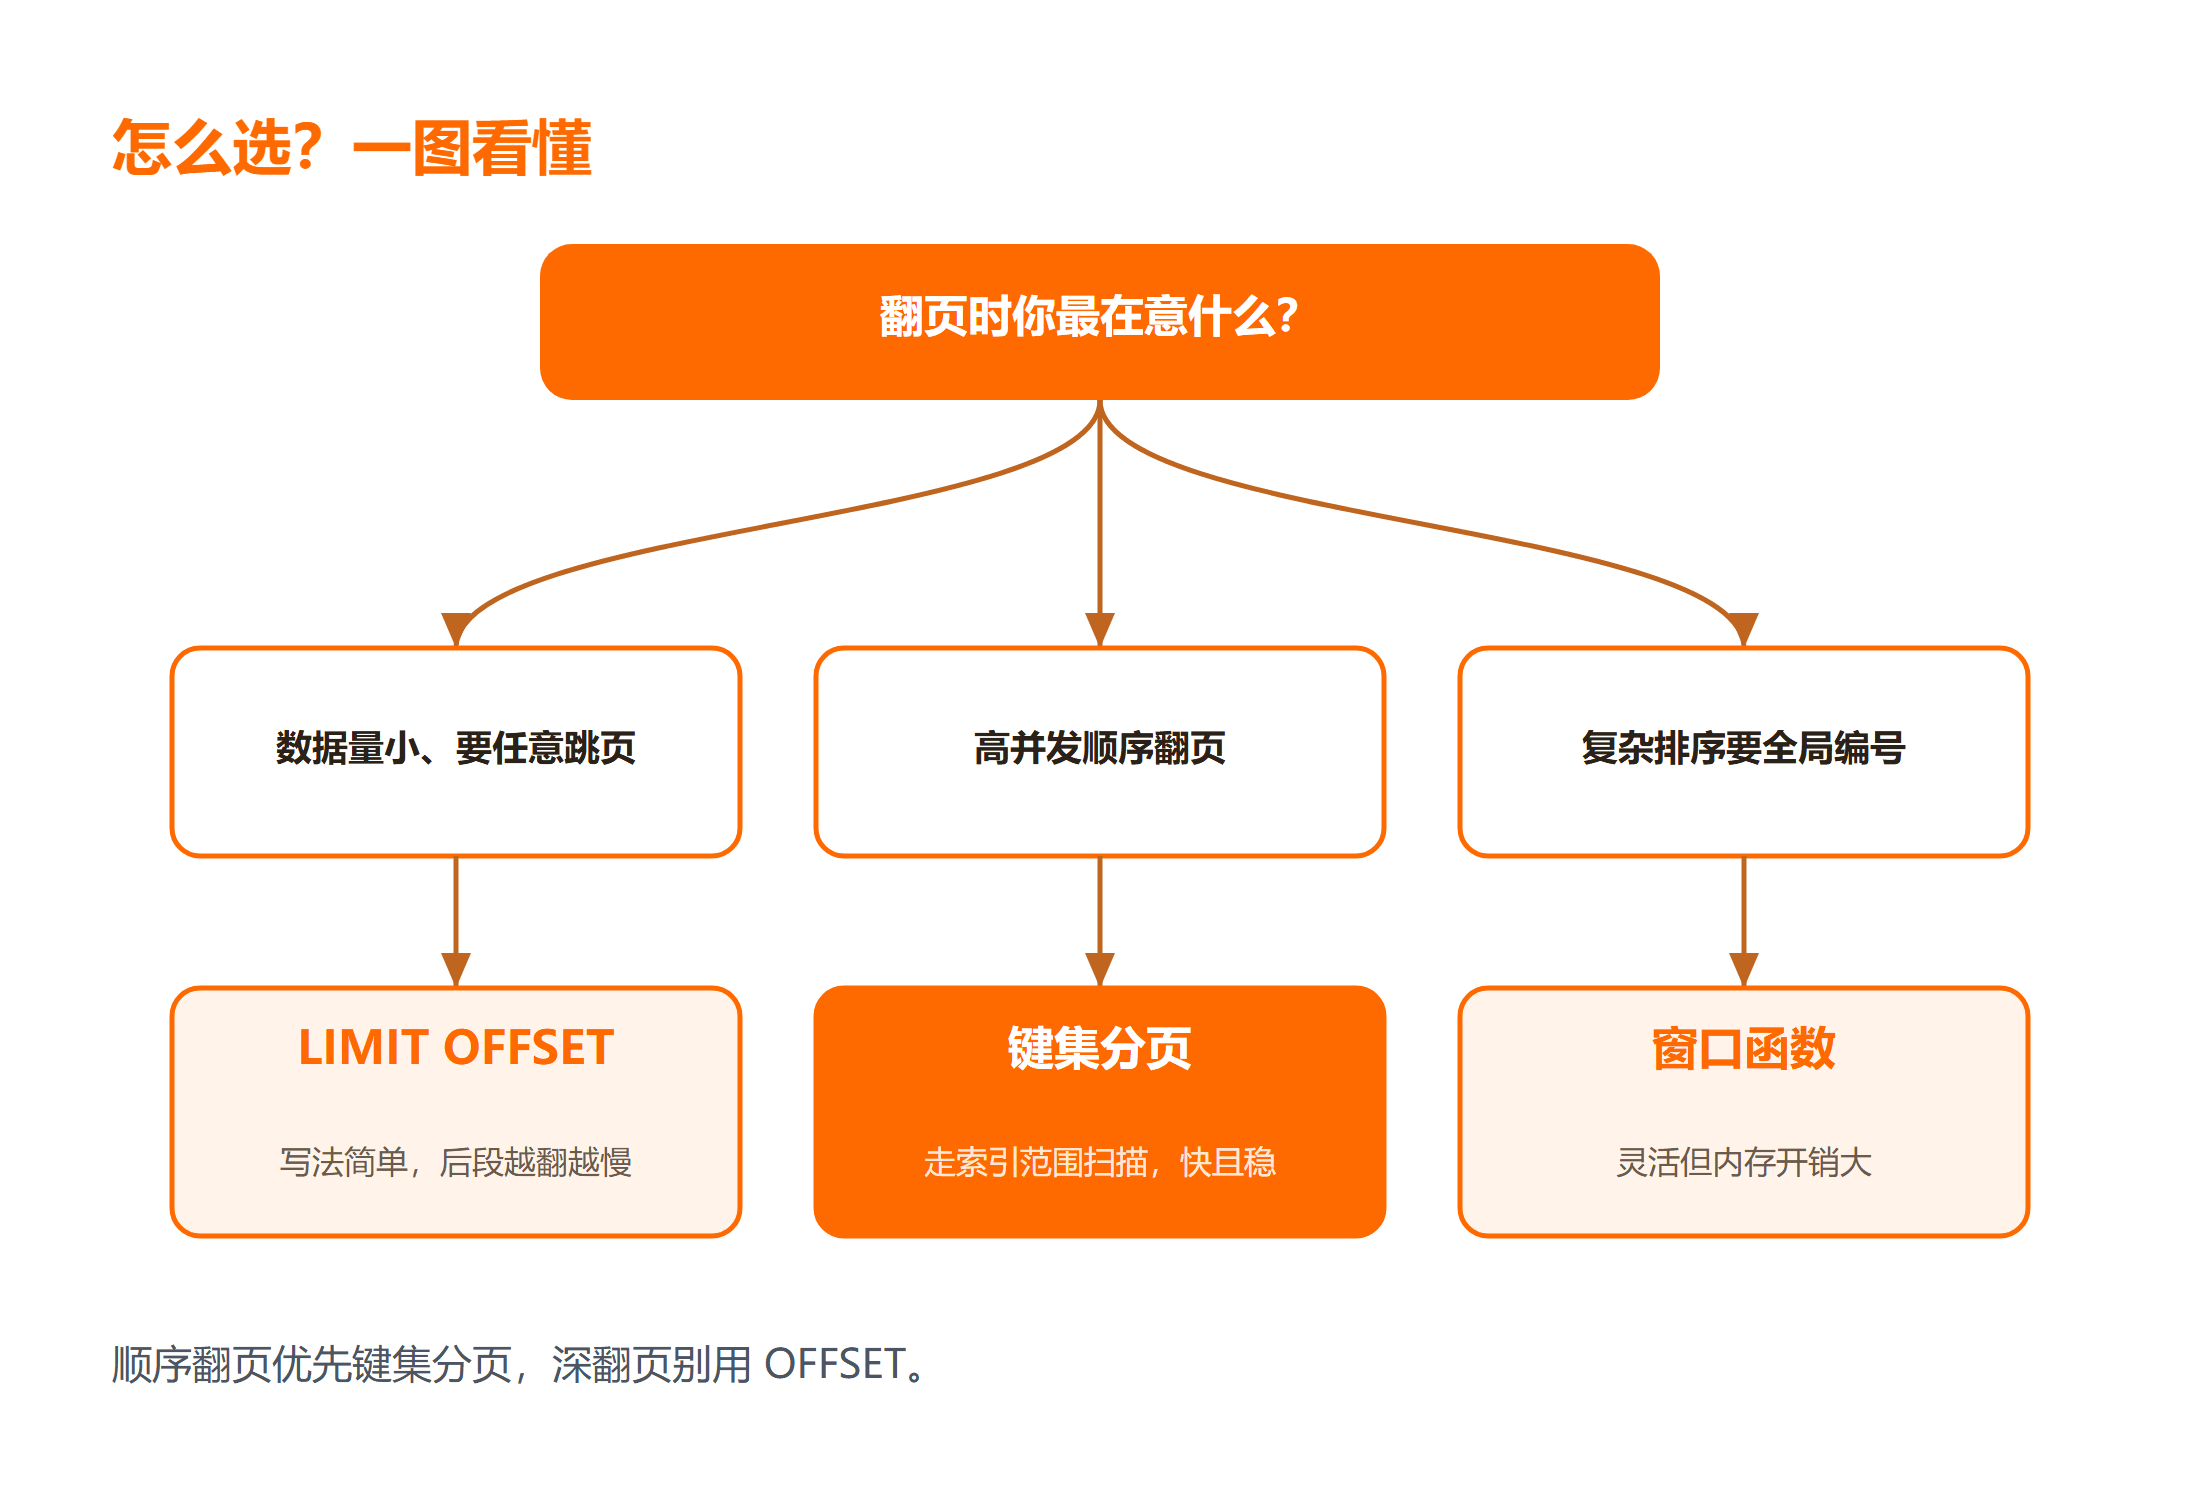
先看结论
| 你的场景 | 写法 | 关键点 |
|---|---|---|
| 少量数据、需要跳到任意页 | LIMIT OFFSET | 写法简单,但 OFFSET 越大越慢 |
| 按 ID 或时间顺序连续翻页 | 键集分页(WHERE id > ?) | 快且稳,依赖有序唯一键 |
| 既要排序又要全局序号 | 窗口函数 ROW_NUMBER | 灵活,但内存开销更大 |
一句话:数据量小、要跳页用 LIMIT OFFSET;高并发顺序翻页用键集分页;需要复杂排序并给每行编号用窗口函数。
一、最小场景与预期结果
先建一张订单表,灌入 100 条连续 id 的数据,后面三种写法都基于它。预期行为是:每页 10 条,第 2 页返回的是 id 为 11 到 20 的那 10 行。先过一遍 SQL 教程 里的基础查询语法,确保你对 SELECT 和 ORDER BY 已经熟悉。
CREATE TABLE orders (
  id INT PRIMARY KEY AUTO_INCREMENT,
  user_id INT NOT NULL,
  amount DECIMAL(10,2) NOT NULL,
  created_at DATETIME NOT NULL
);

INSERT INTO orders (user_id, amount, created_at) VALUES
 (1, 9.90,  '2026-01-01 10:00:00'),
 (2, 19.90, '2026-01-02 11:00:00'),
 (3, 29.90, '2026-01-03 12:00:00');
-- 其余数据省略,保证 id 从 1 连续到 100
实操清单:建表后先 SELECT COUNT(*) FROM orders,预期得到 100;确认排序字段有序,再进入下面的写法。这一步是后面所有分页写法的"地基"——如果排序字段没有稳定顺序,分页就会在翻页时漏行或重复,所以务必让 ORDER BY 命中一个有唯一性的列。想确认表上有哪些索引、键集分页能否命中索引,可随时回头查表结构。
二、方法一:LIMIT OFFSET 偏移分页
偏移分页是最直观的 SQL 分页查询写法,思路是"先跳过前 N 条,再取 M 条"。第 2 页就是跳过前 10 条、再取 10 条。结合 MySQL 教程 可以看到,LIMIT 后面的第一个数是"偏移量"、第二个数是"返回条数"。
SELECT id, user_id, amount
FROM orders
ORDER BY id
LIMIT 10 OFFSET 10;        -- 第 2 页:跳过前 10 条,取接下来 10 条

-- 等价写法:LIMIT 偏移量, 条数
SELECT id, user_id, amount
FROM orders
ORDER BY id
LIMIT 10, 10;命令与运行:在 MySQL 客户端执行后,预期返回 id 为 11 到 20 的 10 行,顺序与 ORDER BY 一致。检查:若返回行数不足 10,说明已到最后一页,属正常边界。失败处理:OFFSET 越大,数据库要先扫描并丢弃越多行;翻到第 100 页时 OFFSET 是 990,MySQL 仍要读出前 990 行再扔掉,越往后越慢。它还有一个隐蔽问题——翻页期间若有新数据插入到已翻过的区间,用不稳定的排序键会出现重复或漏行。
三、方法二:键集分页(Keyset Pagination)
键集分页也叫"游标分页",不用 OFFSET,而是直接告诉数据库"要比上一页最后一条的 id 更大"。它依赖一个有序且唯一的键(通常是自增 id 或时间戳加 id)。
-- 上一页最后一条的 id 是 20,则第 3 页这样取
SELECT id, user_id, amount
FROM orders
WHERE id > 20
ORDER BY id
LIMIT 10;
把 id > 20 改成前端传回的"上一页末 id"即可。运行预期:返回 id 21 到 30 的 10 行。检查:把结果第一条的 id 作为下一页游标回传,链路即可一直走下去。失败处理:若"上一页末 id"传错或前端没保存,就会跳过一段数据,所以前端必须忠实回传末行游标,不能自己推算。需要快速对照所有分页相关子句时,可以翻 MySQL 速查手册 里的 SELECT 章节。
键集分页最大的优点是快:它走的是索引范围扫描,不管翻到第几页,成本都接近"读 10 行"。代价是不能直接"跳到第 50 页",只能一页一页往后翻,因此非常适合信息流、评论列表这类场景。
四、方法三:窗口函数 ROW_NUMBER 与边界避坑
当你既要按某个字段排序,又想给每一行一个全局序号(比如"第 11 到第 20 名"),可以用窗口函数先编号再筛选。
SELECT *
FROM (
  SELECT id, user_id, amount,
         ROW_NUMBER() OVER (ORDER BY created_at DESC, id DESC) AS rn
  FROM orders
) t
WHERE rn BETWEEN 11 AND 20;
内层用 ROW_NUMBER() OVER (...) 给每一行按 created_at 倒序编号,外层取 11 到 20 的行。运行预期:返回编号落在该区间的 10 行。检查:编号连续且无重复即正确。失败处理:ROW_NUMBER 会对整个结果集编号,没有 WHERE 预过滤时,百万级数据会让临时表撑大,必要时先 WHERE 缩小范围再做编号。写完复杂嵌套 SQL,建议用 SQL 格式化工具把语句排版整齐,避免括号错位(在线格式化入口见文末延伸学习)。
边界、反例与常见失败一并放在这里:
- OFFSET 越大越慢:这是偏移分页的物理限制,不是写法错误,深翻页优先改键集分页。
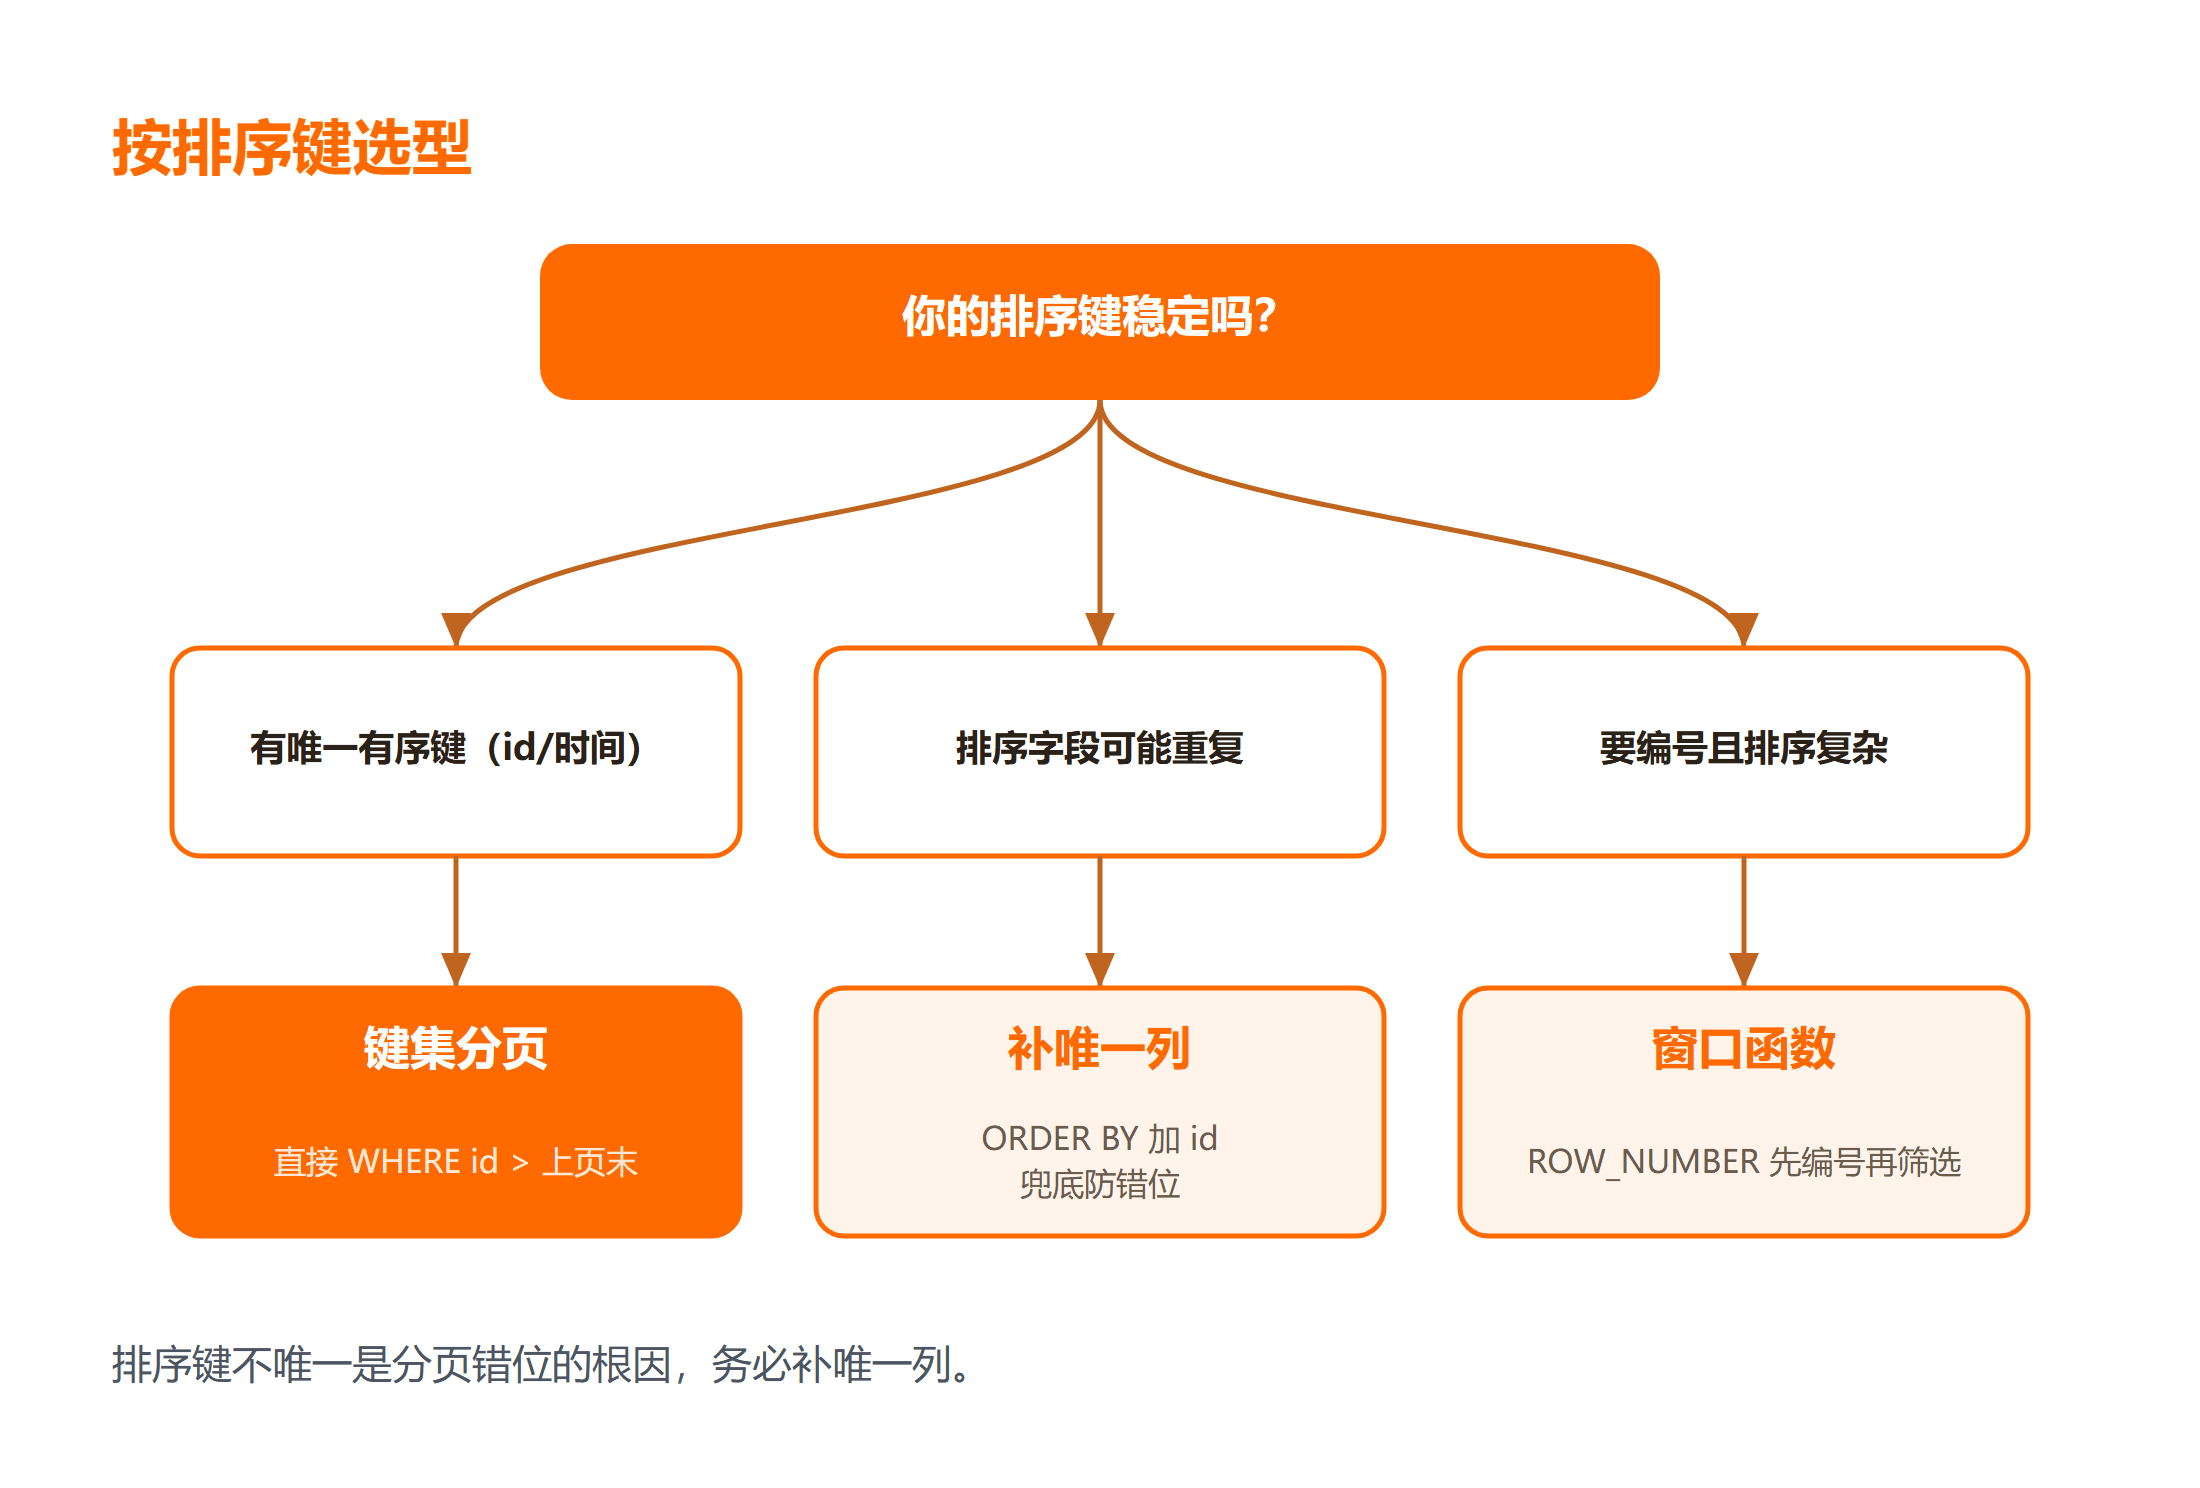
- 排序键不唯一导致错位:只写
ORDER BY created_at时,同一时间有多条记录,每次翻页顺序可能不同,造成同行在相邻页重复或丢失;务必补唯一列兜底,例如ORDER BY created_at DESC, id DESC。 - 键集分页漏页:上游游标传错会跳过数据,前端必须回传真实末行 id。
- 窗口函数内存暴涨:超大数据集慎用,先缩小结果集再编号。
总结
SQL 分页查询有三种主流写法,选型看场景:
- 数据量小、需要任意跳页,用 LIMIT OFFSET,但要知道它越往后越慢;
- 高并发的顺序翻页(信息流、评论),用 键集分页,靠有序唯一键换取稳定与速度;
- 需要复杂排序并给每行全局编号,用 窗口函数 ROW_NUMBER,灵活但注意内存。
想系统练手,可以先过一遍 SQL 教程,再用速查手册把 LIMIT、ORDER BY 和窗口函数的用法对照记牢,下次写分页就能直接套对写法。
延伸学习
想把这块知识系统补齐,可以按这个顺序来:
- 想跟着课程动手练,SQL 入门实战课程 是边学边写的形式;
- 看表结构相关的细节,MySQL 数据表结构笔记 讲了查看表结构的几种办法;
- 需要在线整理复杂 SQL,SQL 在线格式化工具 适合随时使用。
常见问题
Q:LIMIT OFFSET 和 LIMIT 10, 10 写法有区别吗?
A:没有语义区别,只是参数顺序写法不同。标准写法是 LIMIT 条数 OFFSET 偏移量,而 LIMIT 偏移量, 条数 是 MySQL 的简写,第一个数永远是偏移量。建议团队统一用带 OFFSET 的写法,可读性更高。
Q:键集分页为什么不能跳到第 5 页?
A:因为它没有"全局偏移"概念,只知道"比上一页末 id 更大"。要跳第 5 页就得先拿到第 4 页的末 id,所以天然适合连续翻页,不适合任意跳页。需要跳页又怕慢时,可以给常见跳转目标预计算游标。
Q:排序字段有重复值时分页为什么会错位?
A:当 ORDER BY 的字段存在相等值,数据库不保证相等行之间的先后次序,两次查询可能给出不同顺序,于是同一行出现在两页或漏掉。解决方法是排序键补一个唯一列(如主键 id),让顺序完全确定。