
 TRAE-AI编程

让 AI 给函数补一套单元测试,几秒钟就生成十几条用例,跑一遍还全绿——于是很多人直接提交。但这些"全绿"的测试可能只是在验证函数把返回值原样返回,真正该拦的边界条件一条没测。AI 生成的单元测试能不能直接用?结论是:先核断言、再补边界、后进回归,三步都过才能进代码库。本文用一个真实的 Python 函数演示怎么判断,并给出断言恒真、边界缺失、测了实现细节三类问题的排错清单。
一、先看结论:能不能直接用
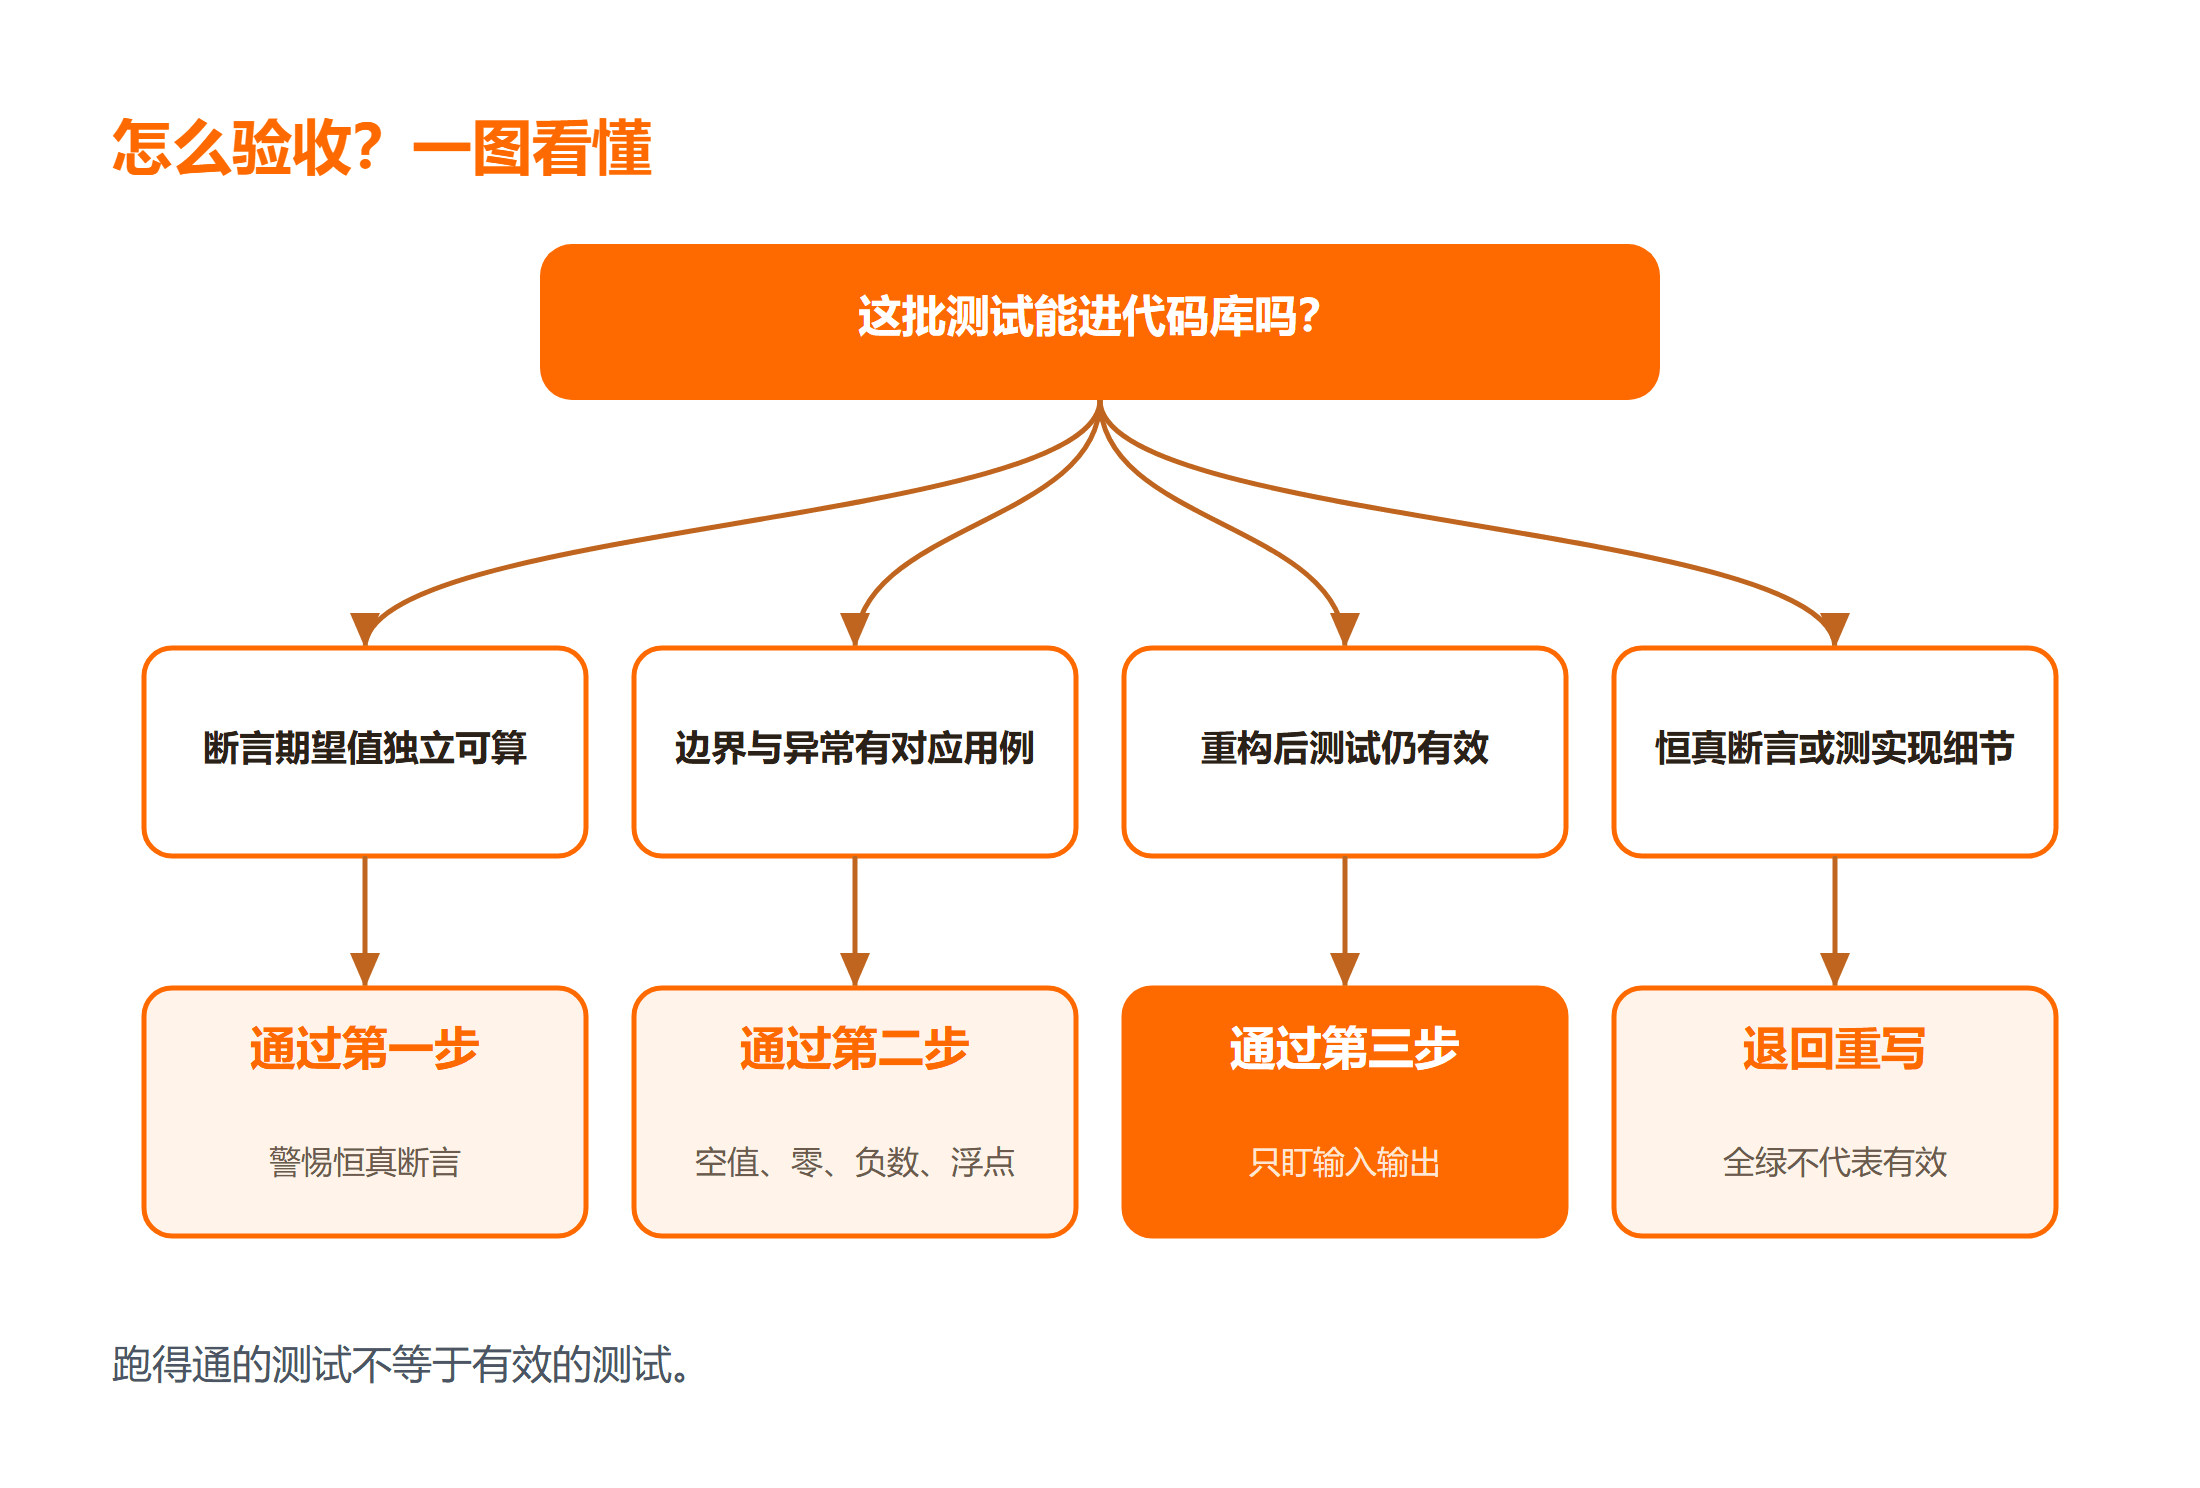
先给判断表。AI 生成的测试按这三步验收,任何一步不过就退回处理,不要硬塞进代码库。
| 检查步骤 | 通过标准 | 不通过的典型表现 |
|---|---|---|
| 核对断言 | 断言里的期望值是你算出来的,不是 AI 抄函数返回的 | 断言恒真,测了等于没测 |
| 补边界用例 | 空值、零、极大、异常路径都有对应用例 | 只测"正常能跑通"的路径 |
| 进入回归 | 测试不依赖实现细节,重构后仍有效 | 改个内部变量名测试就红 |
为什么不能直接用?因为 AI 生成测试的默认策略是"让测试通过":它看到函数实现后,常把函数的现有行为直接抄成期望值,函数算错它也跟着测错。三步验收里,第一步拦"假测试",第二步拦"覆盖不全",第三步拦"脆测试"。对刚接触单元测试的新手,建议把这张表贴在手边,每次让 AI 生成后逐行对照,两周就能形成直觉。
二、准备阶段:跑通 AI 给的测试环境
判断之前,先让 AI 生成的测试在你本机真正跑起来——跑不起来的测试无从判断。本文示例基于 Python 3.8+ 与 pytest,先确认环境:
# 确认 pytest 可用(没有就先安装)
python -m pytest --version

# 跑 AI 生成的测试文件,先看能不能整体通过
python -m pytest test_calc.py -v
被测函数用一个小而典型的例子:一个"除法带默认值"的工具函数,边界问题最容易藏在里面:
# calc.py:被测函数,除法失败时返回默认值
def safe_divide(a, b, default=0):
    # b 为 0 时除法会崩,返回 default 兜底
    if b == 0:
        return default
    # 正常路径:直接返回商
    return a / b
把 calc.py 交给 AI 并要求"补全 pytest 单元测试"后,假设它生成了 test_calc.py。预期结果是全部用例通过(未在本机执行,按 pytest 官方文档推断)。不熟悉 pytest 的读者,建议先翻一遍 pytest 教程 的断言与夹具章节,再看 AI 生成的用例会顺畅很多。注意:全绿只说明测试能跑,不代表测试有效,判断从下一节开始。
三、第一步:核对断言与预期
打开 AI 生成的测试,逐条看断言里的期望值从哪来。判断标准只有一条:期望值应该是你独立算出来的,而不是和函数返回值"长得一样"。看一组典型对比:
# AI 常见写法:期望值像是从实现反推的
def test_safe_divide_normal():
    # 断言 6/2=3:这条本身没错,但要确认是你自己算的
    assert safe_divide(6, 2) == 3

# 危险信号:断言和实现互相抄,恒真
def test_safe_divide_self():
    # 用函数自己验证自己,永远通过,测了等于没测
    assert safe_divide(6, 2) == 6 / 2
第一条是对的写法:6/2=3 是你心算得到的独立预期。第二条就是"恒真断言"——拿 6 / 2 当期望值,等于用被测函数验证被测函数,哪怕函数实现错了测试照样绿。验收技巧是遮住函数实现,只看测试猜行为:猜得出来说明断言描述的是"需求",猜不出来的八成在抄实现。凡是 AI 自动生成的断言,逐条问一句"这个期望值我怎么知道的",答不上来的删掉重写。这一步拦掉的是最危险的一类测试:看起来在验证,实际在陪跑。
四、第二步:补边界与异常用例
AI 默认偏爱"正常路径",边界要你主动要求补。拿 safe_divide 来说,至少有四类边界:除数为零、浮点精度、负数、default 参数被显式传入。下面是一份补全后的边界用例:
# 边界用例:每类边界一条,覆盖 AI 容易漏的路径
def test_divide_by_zero_returns_default():
    # 除数为 0:应返回默认值 0,而不是抛异常
    assert safe_divide(10, 0) == 0

def test_divide_by_zero_custom_default():
    # 显式传入 default:兜底值应可自定义
    assert safe_divide(10, 0, default=-1) == -1

def test_negative_numbers():
    # 负数除法:符号处理要正确
    assert safe_divide(-6, 2) == -3

def test_float_precision():
    # 浮点精度:0.1+0.2 类问题要用近似比较
    assert safe_divide(1, 3) == pytest.approx(0.3333333, abs=1e-6)
注意最后一条用了 pytest.approx 做近似比较——浮点数相等判断是新手最常踩的坑,1/3 不可能精确等于某个小数。这些边界用例都可以丢进 在线代码实例 里单独跑一遍,确认行为与注释一致。要求 AI 补边界时的提问模板:「请针对空值、零、负数、浮点精度、异常路径分别补充用例,每条用例注明测的是哪类边界」。生成后对照函数逐条核:每个 if、每个提前 return、每种可能抛的异常,都该有至少一条用例对着它。缺哪类,让 AI 定向补哪类,而不是笼统地说"再多来几条"。
五、第三步:接入回归与防误报
前两步都过了,还要看这批测试"脆不脆"。脆测试的标志是:重构函数内部实现(不改行为),测试就红了。典型原因是测试盯上了实现细节:
# 脆测试:盯住实现细节,重构就碎
def test_uses_if_statement():
    # 检查源代码里有没有 if 字样——这测的是写法不是行为
    import inspect, calc
    assert "if" in inspect.getsource(calc.safe_divide)

# 健壮测试:只盯输入与输出
def test_behavior_only():
    # 无论内部怎么实现,除零都应返回 default
    assert safe_divide(10, 0) == 0
接入回归的收尾动作是把测试跑进日常流程:本地提交前跑一次,团队项目再挂到持续集成里自动执行。跑不动或误报时按下面的清单排查:
| 现象 | 常见原因 | 修复方向 |
|---|---|---|
| 重构后测试大面积变红 | 测试依赖实现细节 | 改写成只验证输入输出的行为测试 |
| 全绿但线上还是出错 | 边界用例缺失 | 回到第二步补边界与异常路径 |
| 测试偶尔失败偶尔通过 | 用例依赖时间、随机或网络 | 固定输入,mock 掉不稳定依赖 |
| AI 生成的测试文件跑不起来 | 缺 pytest 或 import 路径错 | 先修环境:确认 pytest 版本与包路径 |
到这里三步走完:断言可信、边界齐全、测试健壮,这批单元测试才能算"能用"。之后每次让 AI 生成测试,都按这个节奏验收,速度会越来越快。想把回归与测试策略补得更系统,可以参考 软件测试教程 里的测试分级思路,再把 AI 纳入其中一环。
总结
AI 生成的单元测试能不能直接用?答案是先过三步验收:第一步核对断言,期望值必须是你独立算出的,警惕恒真断言;第二步补齐边界,空值、零、负数、浮点精度、异常路径逐类对着函数检查;第三步确认健壮,测试只盯输入输出、接入日常回归。AI 是高效的用例生成器,但"测试是否有效"的判断权必须留在你自己手里——这条边界守住了,单元测试才真正成为你的安全网,而不是全绿的装饰品。
延伸学习
常见问题
Q:怎么快速识别一条断言是"恒真"的?
A:用一个笨但有效的办法:把断言里的期望值换成任意错值,比如把 == 3 改成 == 999,跑一次测试。如果测试居然还能通过,说明这条断言根本没被执行(比如写在了永不运行的分支里);如果测试按预期变红,再把期望值改回来。另一个信号是期望值里出现了被测函数本身或它的衍生计算——用函数验证函数的断言永远不可能失败,等于没测。
Q:AI 生成的测试应该测到什么覆盖率才够?
A:覆盖率是参考不是目标,行覆盖率八成以上、且每个分支和异常路径都有用例,对小工具函数就够用了。比数字更重要的是覆盖质量:一行被五条用例重复覆盖、另一行没人覆盖,比整体 70% 危险得多。实操上别让 AI 追求 100%——为了凑数生成的用例常常在测 getter、setter 这类无需验证的代码,反而稀释了真正有用断言的信号。边界与异常路径优先,数字其次。
Q:测试里该不该用 mock?AI 很爱生成 mock,怎么把握?
A:该用,但只对"不稳定的依赖"用:数据库、网络请求、系统时间、随机数这些,用 mock 固定住,测试才可重复。AI 的问题是容易过度 mock——把被测函数的核心逻辑也 mock 掉了,最后测的是 mock 自己。把握标准:mock 边界上的依赖(函数外面调了什么服务),不 mock 函数内部的计算过程。如果你读一条测试时发现被测函数本身被 mock 了大半,这条测试直接删掉重写。
Q:让 AI 补测试的提问怎么写效果最好?
A:给足三样:被测函数完整代码、你手算好的关键预期值、要求覆盖的边界清单。比如「为这个 safe_divide 补 pytest 用例,期望值我已算好:safe_divide(6,2)=3、safe_divide(10,0)=0;请覆盖除零、负数、浮点精度三类边界,断言不许用被测函数自身的返回值当期望」。预期值由你提供,AI 就没法用"抄实现"的方式糊弄;边界清单列明,它就不会只写正常路径。生成的结果仍按三步验收,但一次到位的比例会明显提高。



