
 TRAE-AI编程

Chrome 插件用 JavaScript 去抓取页面里的指定元素,却经常拿到 null 或读不到内容,多数不是选择器写错,而是执行时机、页面结构和运行环境三处没对齐。本文把最常见的三个错误拆开讲,并给出能直接落进 Manifest V3 扩展的代码示例,照着改就能稳定拿到目标元素。无论你是刚接触扩展开发,还是已经上线过几个插件,先把这三类错误记牢,都能省下大量对着控制台发呆的调试时间;文中的示例均基于 Manifest V3,对应目前主流的 Chrome 扩展规范。
先看结论
- 内容脚本执行时目标元素还没渲染出来,拿到的是 null,应先等 DOM 就绪或等元素出现。
- 单页应用是动态渲染、或元素藏在 Shadow DOM 里,静态
querySelector会扑空,要用等待或穿透根节点。 - Manifest V3 下 content script 与页面主世界隔离,跨域 iframe 和页面内部变量都读不到,需要换注入方式。
一、错误一:脚本跑在元素渲染之前
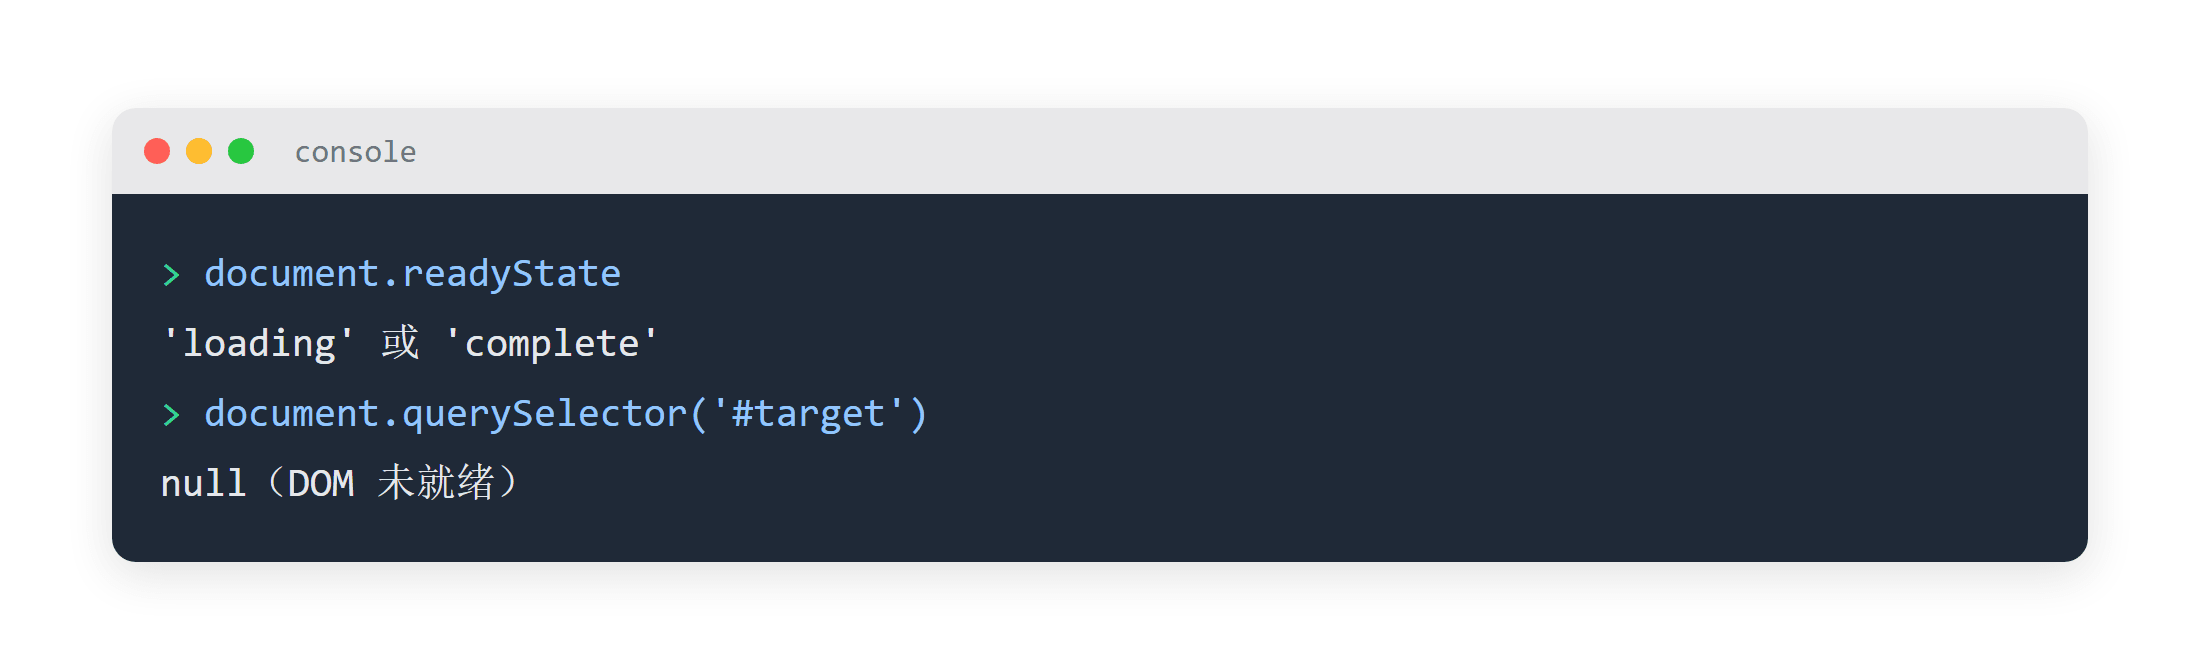
最常见的原因是内容脚本注入时机早于 DOM 就绪。扩展在页面加载早期就执行,此时你要的节点还没挂到文档上,document.querySelector 自然返回 null。解决办法是监听 DOMContentLoaded,或直接判断 document.readyState。
document.addEventListener('DOMContentLoaded', () => {
  const el = document.querySelector('#target');
  if (el) console.log(el.textContent);
});
更稳妥的是不假设时机,直接轮询或观察:
function waitFor(sel, cb, t = 0) {
  const el = document.querySelector(sel);
  if (el) return cb(el);
  if (t > 5000) return;
  setTimeout(() => waitFor(sel, cb, t + 200), 200);
}
调试这类时机问题,用 Chromedevtools 教程 在扩展背景页里打断点最直观,能看到脚本到底是在哪个阶段执行的。需要提醒的是,如果页面本身用了大量异步数据,DOMContentLoaded 也可能早于数据节点出现,这时必须配合 waitFor 而不是只等文档就绪。这套 waitFor 写法在真实扩展里可以抽成工具函数,配合 clearTimeout 在拿到元素后及时停掉轮询,避免无谓的持续调用;超时则返回空并给出日志,便于快速判断是时机问题还是选择器本身写错。
二、错误二:单页应用或 Shadow DOM 让静态选择器扑空
很多现代站点用框架做动态渲染,元素在脚本执行后才由 JavaScript 插入;还有些组件把结构藏进 Shadow DOM,默认 querySelector 进不去。这两类都会让静态选择器读不到内容。
// 等待动态元素
waitFor('.lazy-item', el => console.log(el.textContent));

// 穿透 Shadow DOM 读取
function deepQuery(root, sel) {
  if (!root) return null;
  const el = root.querySelector(sel);
  if (el) return el;
  const hosts = root.querySelectorAll('*');
  for (const h of hosts) {
    const r = h.shadowRoot;
    if (r) { const f = deepQuery(r, sel); if (f) return f; }
  }
  return null;
}
判断选择器是否写对,可以对照 JavaScript 教程 里关于 DOM 查询的章节,确认你用的语法和当前文档结构匹配。动态渲染场景一定要等元素出现,而不是一次性查询。deepQuery 虽然能穿透 open Shadow Root,但对 closed 模式无能为力,这类场景只能由页面脚本主动暴露接口。
三、错误三:MV3 的隔离与权限限制
Manifest V3 改变了内容脚本的运行方式:它与页面主世界隔离,无法直接读取页面脚本里的局部变量,也读不到跨域 iframe 的内部 DOM。如果你写的是 chrome.scripting.executeScript,还要注意 host_permissions 是否已声明目标站点。
// manifest.json 必须声明可访问的站点
{
  "manifest_version": 3,
  "host_permissions": ["https://example.com/*"],
  "permissions": ["scripting"]
}
// 注入到页面主世界才能访问页面内部
chrome.scripting.executeScript({
target: { tabId },
world: 'MAIN',
func: () => document.querySelector('#target')?.textContent
});
遇到“明明在控制台能取到、扩展里却取不到”,基本就是隔离或权限问题,而不是选择器错误。这里的适用边界是:只在确实需要读页面内部变量或跨域 iframe 时才用 world: 'MAIN',因为它会绕过隔离、带来一定安全风险,普通 DOM 查询仍优先用默认隔离世界即可。这种主世界注入适合读页面私有变量,但会绕过隔离,只在确有必要时使用。
四、三种错误的对比与适用场景
把三类原因对照看:DOM 未就绪用等待,动态渲染或 Shadow DOM 用深度查询与观察,隔离与权限用 world: 'MAIN' 和 host_permissions。定位时先确认元素是否存在、再确认脚本是否进得去、最后确认权限,顺序不要乱。
现象                  根因                 修复
拿到 null             DOM 未就绪            等 DOMContentLoaded
控制台有、扩展无       动态渲染/Shadow DOM    等待或穿透根节点
跨域 iframe 读不到     运行世界隔离            world:MAIN + 权限
性能取舍上,MutationObserver 比定时轮询更省 CPU,适合元素出现时间不确定的场景;轮询只作为兜底。把这三套手段按“先等、再穿透、最后换世界”的顺序排查,Chrome 插件拿不到指定元素的问题基本都能定位到根因。
动手验证清单
安装与前置
确认扩展为 MV3:manifest.json 里 manifest_version 为 3;在 chrome://extensions 打开开发者模式并加载解压的扩展。
命令
在内容脚本里先打印 document.readyState 与 document.body,确认脚本执行时文档状态。
运行与检查
访问目标站点,触发内容脚本,观察控制台是否输出元素文本;若为 null,按上文三类逐一排查。
预期输出
元素存在且脚本执行时机正确时,textContent 应输出目标文本,而不是 undefined 或 null。
失败处理
仍为 null 时,先用 waitFor 排除时机问题;再检查是否有 Shadow DOM;最后确认 host_permissions 与 world 是否配置到位。
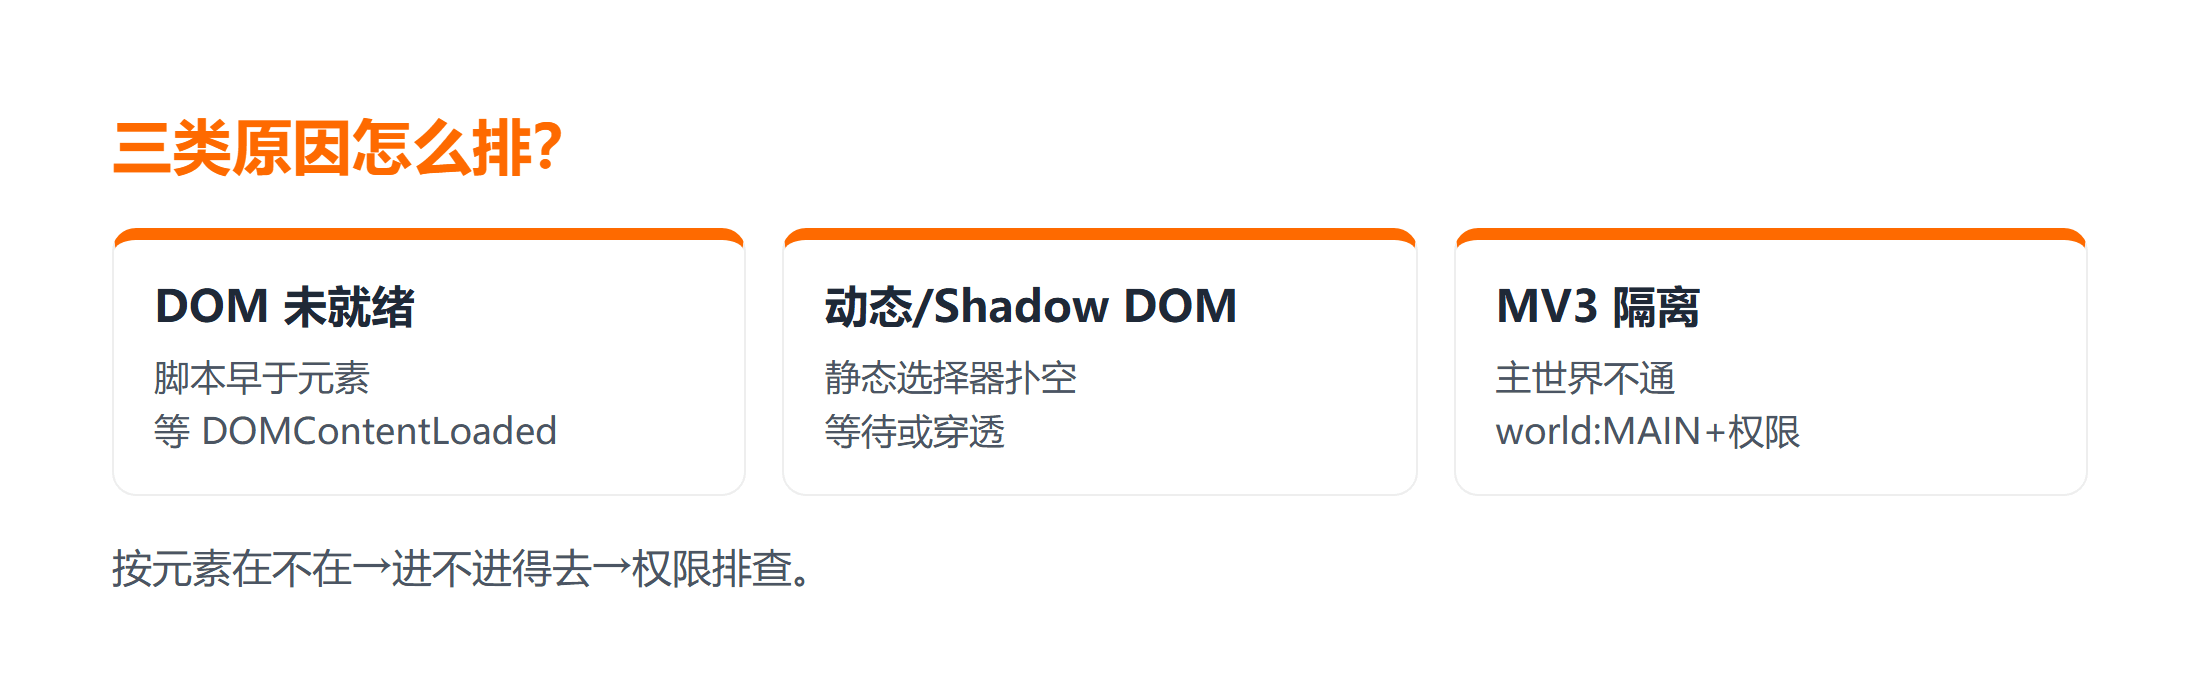
实际排错时建议按优先级走:先用 waitFor 排除时机问题,再用 deepQuery 排除 Shadow DOM,最后用 world: 'MAIN' 排除隔离。把这三步做成可复用函数,每次新扩展都能直接套用。另外要注意,内容脚本对 file:// 页面默认不生效,需要在 manifest.json 里显式声明 matches 包含 file:///*;而跨域抓取接口数据时,若对方没有 CORS 头,扩展侧也只能绕到后台用 fetch 代发,不能指望内容脚本直接读取。把这些边界写进扩展的检查清单,能避免反复踩同一个坑。
总结
Chrome 插件读不到指定元素,绝大多数落在时机、结构和隔离三处。排查时按“元素在不在 → 进不进得去 → 有没有权限”的顺序推进,并用等待、穿透和主世界注入三套手段分别应对,就能让扩展稳稳拿到页面内容。
常见问题
Q:为什么我在控制台能取到、扩展内容脚本里却取不到?
控制台运行在页面主世界,而 MV3 的内容脚本默认在隔离世界,两者 DOM 视图和变量不互通。需要读页面内部时,用 chrome.scripting.executeScript 并把 world 设为 MAIN。
Q:动态渲染的页面一定要用轮询等待吗?
轮询是兜底方案。更优雅的是用 MutationObserver 监听文档变化,元素一插入就回调;只在元素出现时间极不确定时才用带超时的轮询。
Q:Shadow DOM 里的元素能被普通选择器查到吗?
默认不能。开放式的 open Shadow Root 需要手动递归进入 shadowRoot 再查询;closed 模式则无法从外部读取,需要改由页面脚本配合暴露接口。



