
 TRAE-AI编程

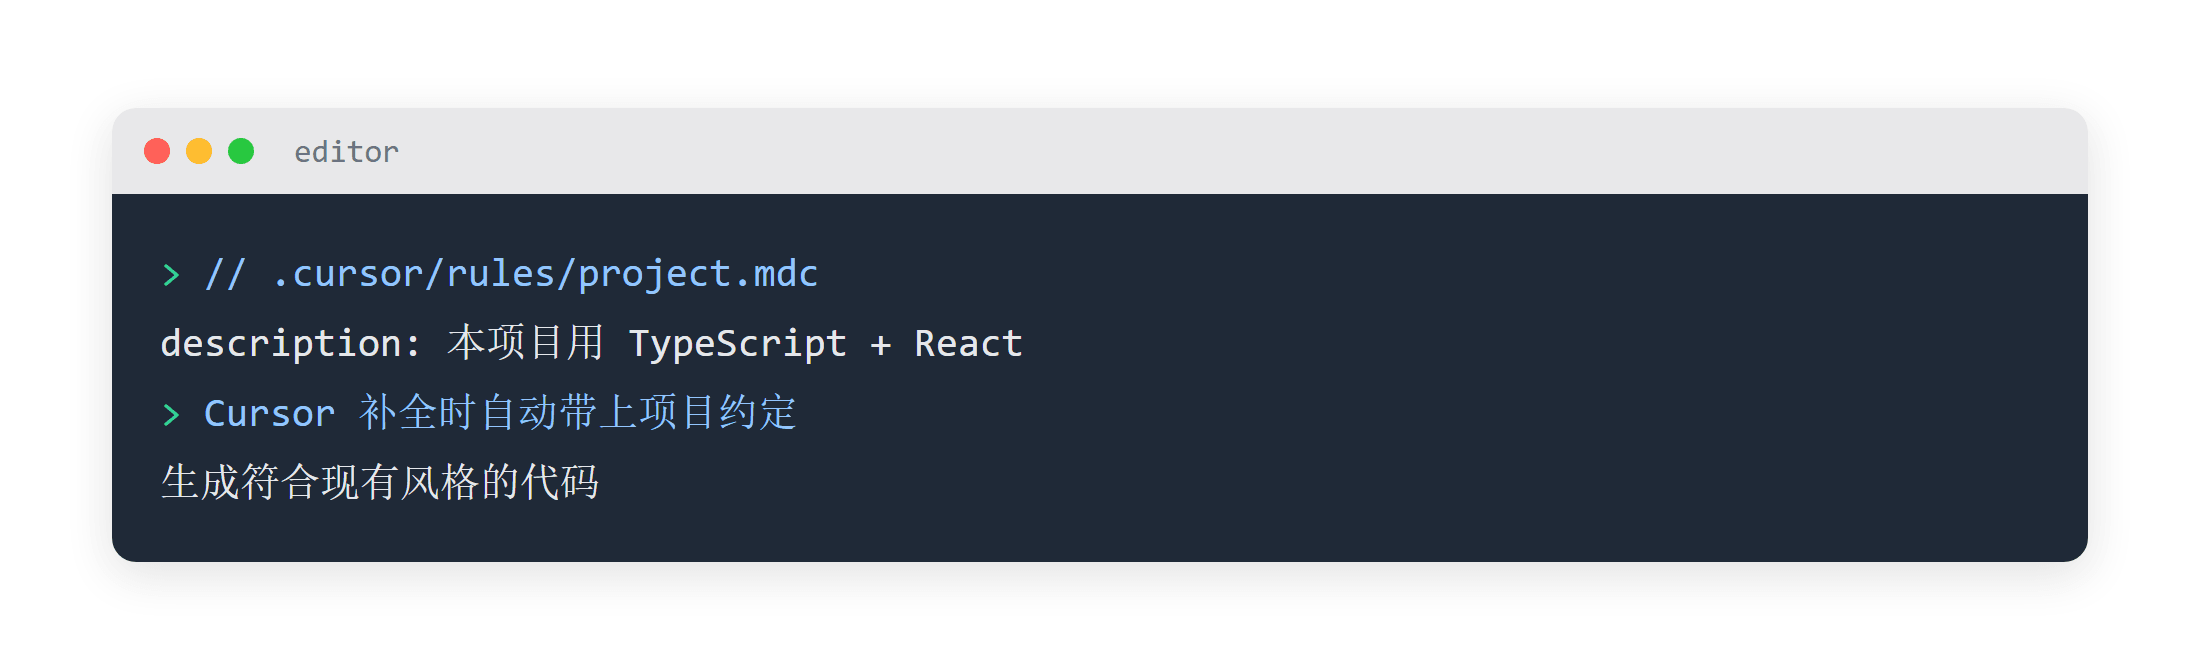
Cursor 的代码补全之所以有时很贴、有时很离谱,关键不在模型,而在你有没有给它写一份 Cursor 规则文件。Cursor 规则就是写给 AI 的“项目说明书”:它告诉编辑器你的技术栈、目录约定、命名风格,以及明确不该碰的边界。写好规则后,补全会主动带上项目上下文,少做无谓猜测。本文基于 Cursor 0.4x 版本实测,先讲清楚规则文件放在哪、怎么被读取,再给出三段配置模板与三个写前必确认的点,并附可直接复制的示例。无论你用 TypeScript、Python 还是 Go,只要项目里能沉淀出约定,这套方法都能让代码补全更贴项目。先把“要不要写规则”想清楚,比急着堆提示词更重要。
一、规则文件放在哪、怎么被读取
Cursor 规则分两种:项目级规则放在仓库的 .cursor/rules/ 目录,用 .mdc 文件描述;用户级规则作用于所有项目,写在个人配置里。项目级规则会随仓库走,最适合团队协作,因为新人克隆下来就能拿到同样的补全约束,不用每人手动配置一遍。用户级规则适合放你个人的通用偏好,比如“注释用中文”“不要用 var”。
.mdc 文件与普通 Markdown 的区别在于头部有一块 YAML 前置信息,用来声明这条 Cursor 规则何时生效、覆盖哪些文件。最常用的三个字段是 description(规则的一句话说明,也参与命中)、globs(文件匹配模式)和 alwaysApply(是否对所有文件生效)。当 alwaysApply 为 false 时,规则只在 globs 命中的文件上出现;为 true 时,它会被塞进每一次请求的上下文,请谨慎使用,否则会迅速把上下文填满。
当你在编辑器里触发代码补全或让它改代码时,Cursor 会把命中的规则拼进上下文。命中靠的是文件匹配(glob)和描述里的关键词。也就是说,规则不是“永远生效”,而是“在合适的文件上生效”。理解这一点,才能避免规则写得太多反而互相打架。除了 Cursor,想了解同类思路也可以看 OpenClaw 中文教程,它同样把项目约定显式喂给模型,而不是指望模型自己猜。
二、三段配置:范围、上下文、边界
一条好用的 Cursor 规则通常由三段组成。第一段写“范围”,用 glob 限定它只在哪类文件上生效,比如 **/*.tsx 只管前端组件,**/*.py 只管 Python 模块。第二段写“上下文”,把项目的编码规范、目录职责、依赖约定直接贴进去,让模型不用猜。第三段写“边界”,明确告诉它“不要做的事”,例如不要改测试文件、不要引入新依赖。
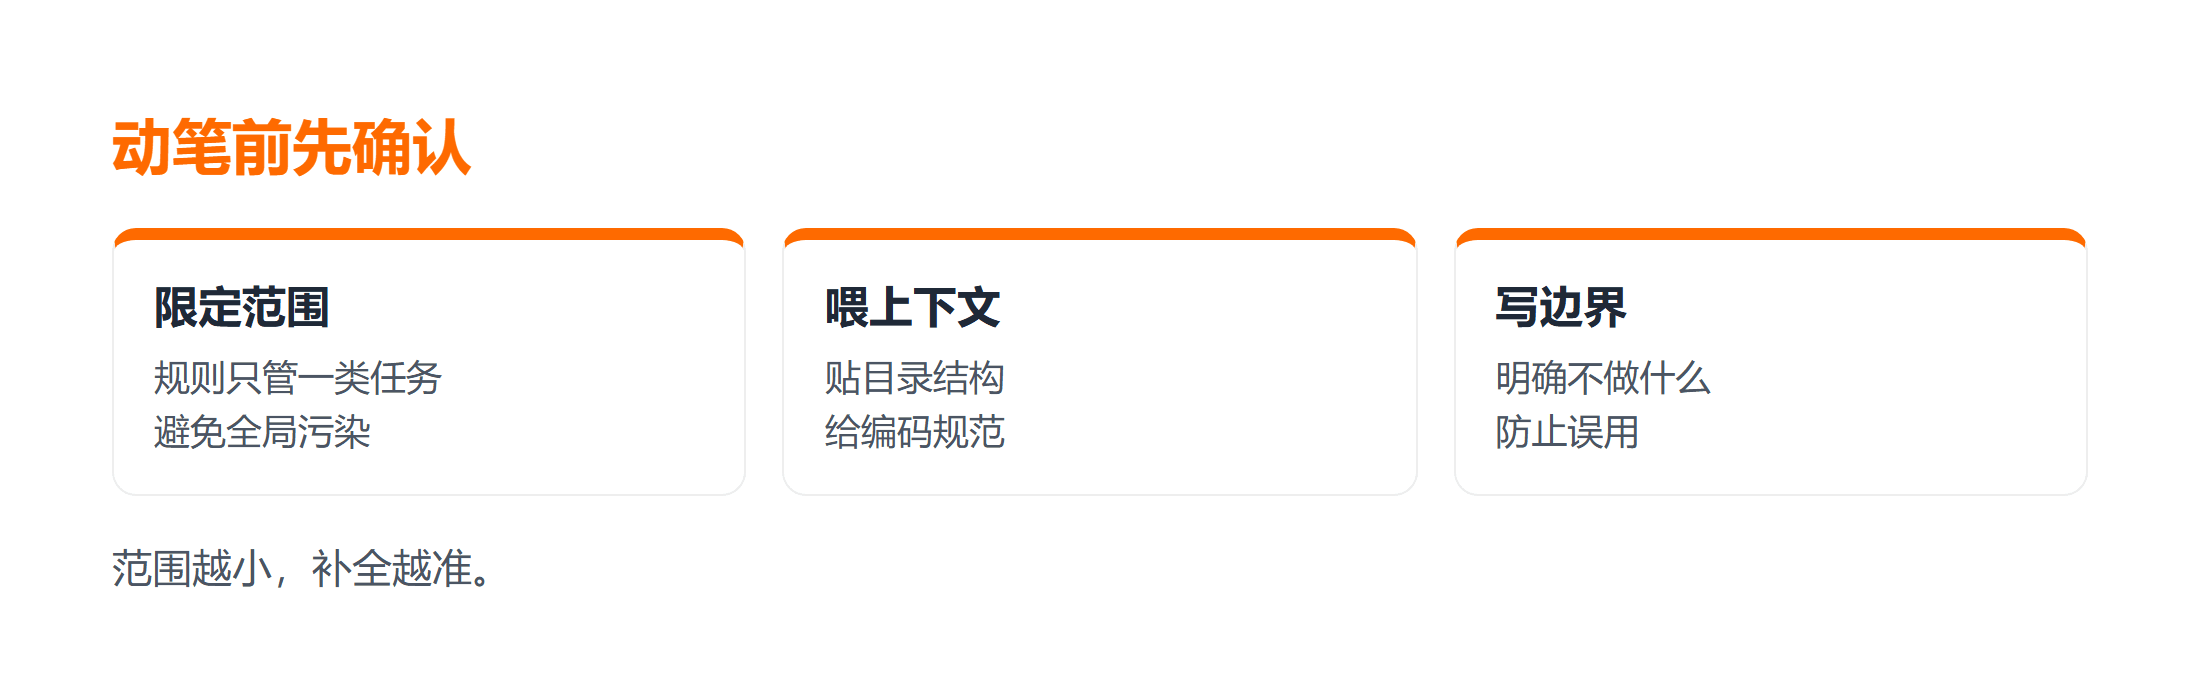
范围越小,补全越准。很多新手把规则写成“全局真理”,结果在后端文件里也被塞进前端约定,反而更乱。我的习惯是:每个 Cursor 规则只解决一类任务,文件名也起得能一眼看懂,例如 react-components.mdc、api-layer.mdc、python-style.mdc。
在写上下文这一段时,直接把真实的目录结构和命名约定贴进去最有效。比如你的项目约定“所有接口放在 src/api/ 下,按资源分文件,导出函数以 fetch 开头”,就把这句话原样写进规则。模型读到之后,生成代码就会自动遵循,而不是凭训练里的通用习惯乱来。规则里表达匹配条件常用 glob 和正则,写错一个字符就整条不命中。若你对 glob 语法不熟,可以先过一遍 正则表达式教程 把通配和正则的基础补齐,再回来写条件,能少踩很多坑。
同类做法也见于其他 AI 编程工具,它们同样强调把项目约定显式喂给模型,而不是指望模型自己猜。可见给 AI 喂上下文是这一类工具的共同思路。
三、写前先确认的三件事
动笔之前,先回答三个问题。第一,这条规则服务的范围是否足够小?范围过大是规则失效的头号原因,宁可多写几条小规则,也不要一条规则管全栈。第二,我有没有把项目里真正约定俗成的东西写进去,而不是泛泛而谈“写干净代码”?泛泛的套话模型本来就会做,写了等于没写。第三,边界是否写清了“不做什么”,防止模型自作主张去改你不想动的代码或加你不要的依赖。
同类思路也出现在其他 AI 编程工具里,比如 TRAE 编程中文教程,它也在强调“给模型喂上下文”这件事,可见 Cursor 规则的本质是上下文工程,而不是提示词堆量。把这三件事确认完,再写规则,成功率会高很多。
四、可复制示例与常见误区
下面是一条前端组件规则的骨架,直接复制改路径即可用:
---
description: React 组件补全约定
globs: "**/*.tsx"
alwaysApply: false
---
本项目的 React 组件遵循以下约定:
1. 使用函数组件与命名导出;
2. 样式走 CSS Modules,文件名为 Component.module.css;
3. 状态优先用 useState,禁止在组件里直接操作 DOM;
4. 不修改 __tests__ 目录下的文件。
这条 Cursor 规则只在 .tsx 上生效,明确列出命名导出、CSS Modules、状态管理和禁改测试四件事。补全时 Cursor 会据此生成贴合现有风格的代码,而不是天马行空。
再给一条 Python 规则的例子,说明上下文写法同样适用后端:
---
description: Python 服务层约定
globs: "**/*.py"
alwaysApply: false
---
本项目的 Python 代码遵循以下约定:
1. 依赖统一从 requirements.txt 安装,禁止在代码里硬编码版本;
2. 日志用 logging 模块,不要用 print;
3. 数据库访问走 repository 层,不要在 handler 里直接写 SQL。
常见误区有三类。误区一是把规则当文档堆砌,写了几百行却无范围,结果处处生效、处处打架。误区二是只写“做什么”不写“不做什么”,模型容易越界改你不希望动的代码。误区三是频繁改规则又不验证,不知道哪条在起作用。建议每次加完一条规则,就用一个真实补全场景确认它是否被正确引用,再决定是否保留。
如果你还在用多个 AI 编程工具来回切,CodeBuddy IDE 配置 MCP 讲了怎么把上下文能力接进 IDE,思路与 Cursor 规则相通,可以对照着看。
五、动手落地:前置、操作、验证与失败处理
前置(前置条件):确认你用的是 Cursor 0.4x 以上、项目已用 Git 管理、且能说清自己的技术栈与目录约定——这三条不齐,Cursor 规则写了也难命中。
操作(操作步骤):在项目根目录新建 .cursor/rules/<name>.mdc,按「范围 / 上下文 / 边界」三段填入,保存后无需重启,下次补全即生效。
验证(验证是否生效):故意在一个匹配文件里写一段违背约定的代码,看 Cursor 补全是否主动纠正,预期它会自动带上项目上下文;若没出现,回到第二步修复规则的 glob 与范围,再打开 Rules 面板确认该条目处于启用且被引用状态。
失败处理(不生效怎么排查):若规则没被引用,多半是 globs 写错或 alwaysApply 理解反了;先补 glob 基础再检查是否因全局规则互相打架。必要时把这条 Cursor 规则单独拎出来,用一次真实补全确认它在起作用,再决定是否并入其他规则。
总结
Cursor 的代码补全贴不贴项目,取决于你有没有把“项目说明书”写清楚。Cursor 规则文件放在 .cursor/rules/,用 .mdc 描述,靠 glob 和描述命中。一条好规则要有范围、上下文、边界三段,范围越小越准。动笔前先确认范围够小、约定写真、边界写清三件事,再用真实场景验证。把规则当上下文工程来做,而不是提示词堆量。
常见问题
Q:Cursor 规则文件一定要写吗?不写会怎样?
A:不写也能用,但补全只能靠通用训练知识猜测你的项目风格,容易出现命名不一致、误改不应动的代码。项目越有自己约定,写规则的收益越大。
Q:规则写太多会不会互相冲突?
A:会。范围重叠或全局生效的规则多了之后会互相打架,让模型无所适从。建议每条规则只管一类文件,并优先用 glob 精确限定,避免一上来就全局适用。
Q:规则里的 glob 和正则写错了怎么排查?
A:最直接的是打开 Rules 面板看条目是否启用、补全时是否引用了它。glob 对通配字符很敏感,写之前先把正则和通配基础补齐,能减少大半低级错误。



