
 TRAE-AI编程

golang 解析 RSS 并返回 JSON 最稳的做法,是用成熟解析库先把源归一化成统一结构,再 json.Marshal 输出;源格式杂就上 gofeed,要极简依赖就手写 encoding/xml。服务端想把某个 RSS 订阅源的内容喂给前端、做聚合或定时推送时,第一步就是 golang 解析 RSS 并返回 JSON。RSS 本质是 XML,但不同站点可能是 RSS 2.0 也可能是 Atom,字段命名还不一致,直接硬解析很容易踩格式差异的坑。本文把三种做法摆在一起对比,并讲清各自的取舍与 3 个常见错误。golang 解析 RSS 这条链路的主线永远是「先归一化、再序列化」,选错工具只会把格式差异的坑带到业务代码里。
先看结论
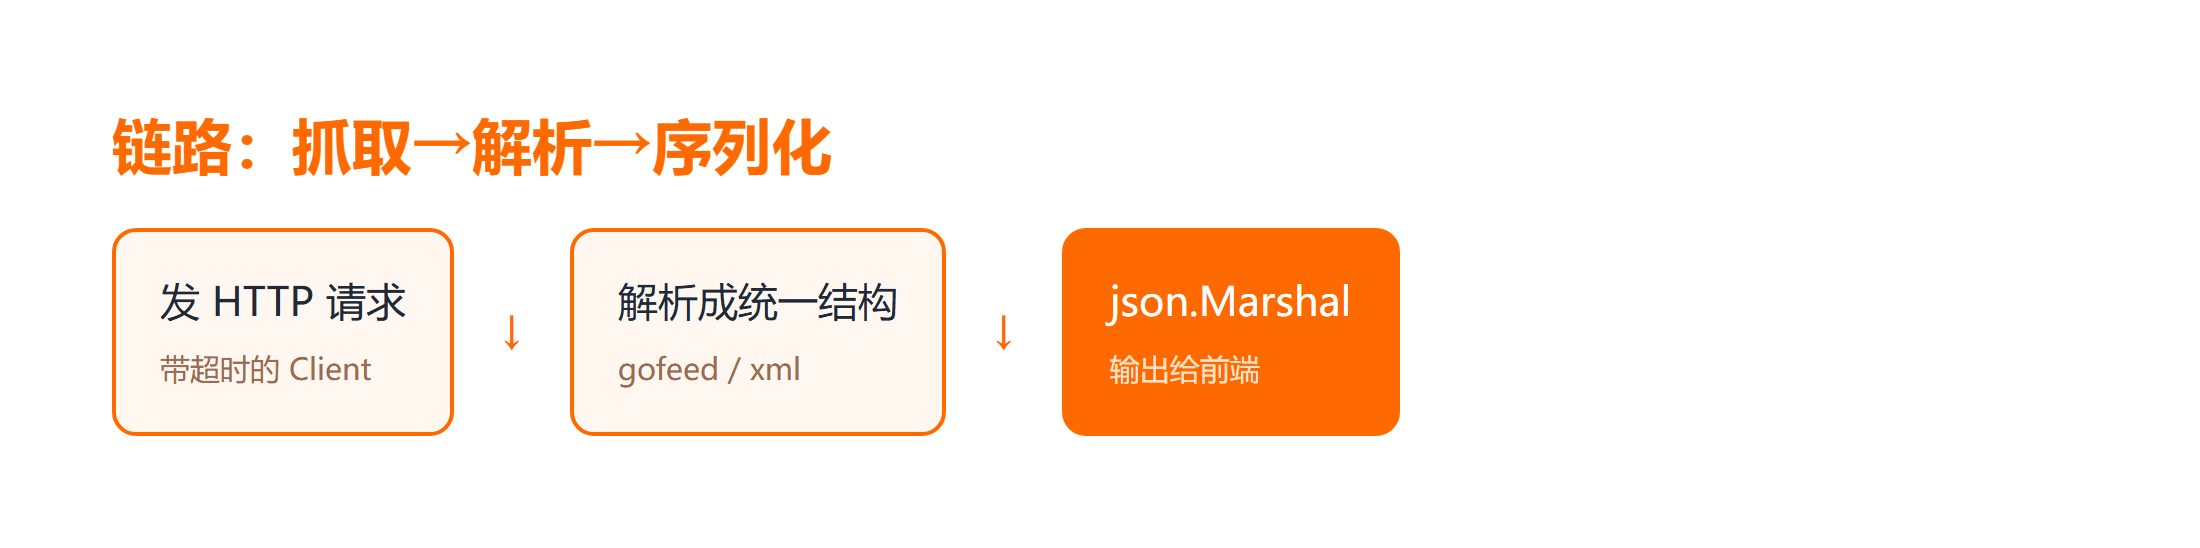
解析 RSS 转 JSON,优先用 gofeed 这类现成解析器:它同时认 RSS 2.0 和 Atom,省去格式判断。对体积、依赖有极致要求,或只要两三个字段时,手写 encoding/xml 结构体更轻。至于用正则直接抠标签,除非是一次性脚本,否则不要用在长期维护的代码里。先归一化、再序列化,是这条链路不变的主线。
一、最小场景:抓一个 RSS 源转成 JSON
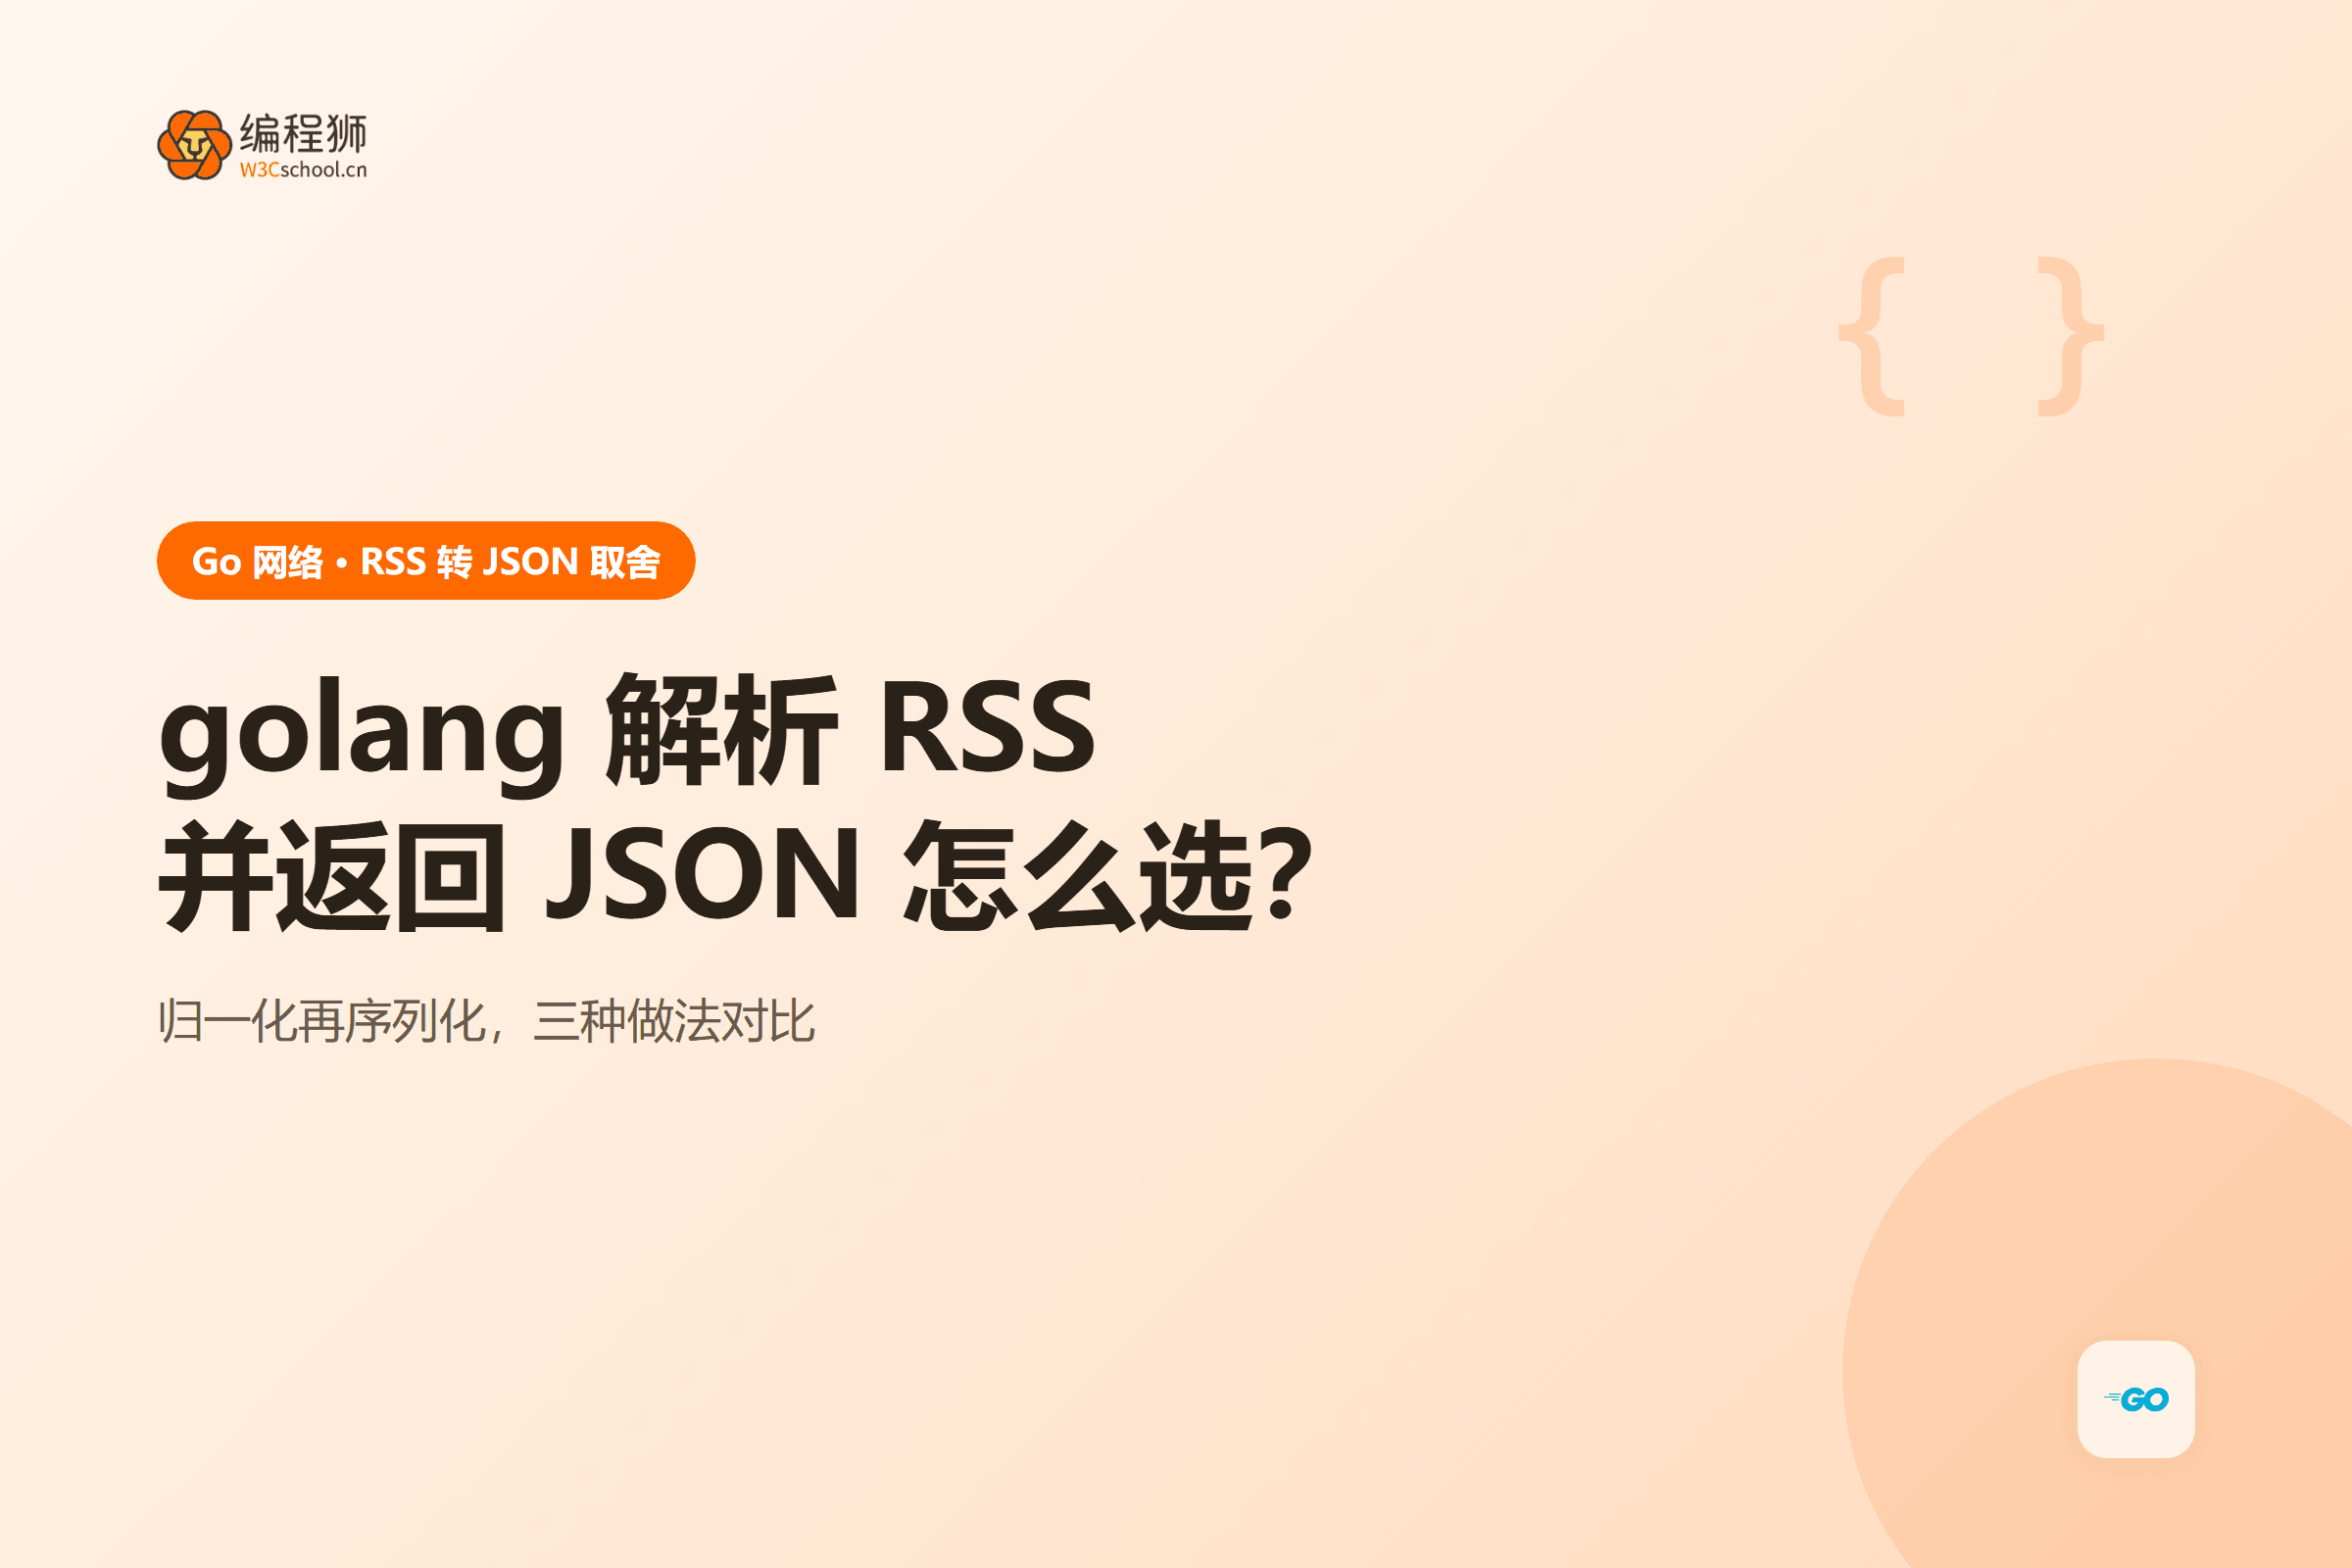
最典型的流程就三步:发 HTTP 请求拿到字节流、解析成统一结构、序列化成 JSON。先准备好请求客户端,再决定用哪种解析方式。Go 的 Web 框架生态可以先看 Golang Gin 教程 了解怎么把这个结果通过接口返回。
package main

import (
    "encoding/json"
    "fmt"
    "net/http"
    "time"
)

func fetchRSS(url string) ([]byte, error) {
    client := &http.Client{Timeout: 10 * time.Second}
    resp, err := client.Get(url)
    if err != nil {
        return nil, err
    }
    defer resp.Body.Close()
    return json.Marshal(resp.Header), nil // 占位:实际这里应解析而非序列化 Header
}
上面只是骨架,真正的解析在下面三种做法里展开。配置阶段要确认目标源是 RSS 还是 Atom,这一步判断错了,手写解析会直接拿到空列表。
二、三种做法的取舍
| 做法 | 健壮性 | 依赖 | 可控性 |
|---|---|---|---|
| gofeed 解析器 | 高,认 RSS/Atom | 引入第三方包 | 中,结构由库定 |
| encoding/xml 手写 | 中,需自己适配格式 | 仅标准库 | 高,字段自己定 |
| 正则扫描 | 低,结构一变就崩 | 无 | 低 |
2.1 gofeed:开箱即用的解析器
用 gofeed 这个库,一行就能把 RSS 或 Atom 解析成统一结构,不必关心源是哪种格式:
import (
    "encoding/json"
    "github.com/mmcdole/gofeed"
)

func main() {
    fp := gofeed.NewParser()
    feed, err := fp.ParseURL("https://example.com/feed.xml")
    if err != nil {
        panic(err)
    }
    out, _ := json.MarshalIndent(feed.Items, "", "  ")
    _ = out // 这就是 RSS 转 JSON 的结果
}
gofeed 把 RSS 转 JSON 的过程完全封装,你拿到的是统一的 feed.Items,字段命名一致,前端不用再关心源格式。性能上,gofeed 多了一层抽象,但在多数聚合场景里这点开销可以忽略。
2.2 encoding/xml:手写结构体
不想引入第三方包、且只关心少量字段时,用标准库 encoding/xml 配合结构体标签最轻量:
import "encoding/xml"

type Rss struct {
    Channel struct {
        Items []Item `xml:"channel>item"`
    } `xml:"channel"`
}
type Item struct {
    Title string `xml:"title"`
    Link  string `xml:"link"`
}
代价是要自己处理 RSS 与 Atom 的标签差异,字段对不上时得写多套结构。这种 XML 解析方式适合内部源、格式固定的场景,依赖压到最小。
2.3 正则扫描:不推荐
用正则抠 <title>...</title> 看起来最快,但 XML 属性的顺序、自闭合、CDATA 都会让正则失效,源站一改版就崩。只适合一次性临时脚本,长期代码别用。对比三种做法,正则扫描的脆弱性是结构性的,无法靠调正则修复。
💡 小提示:解析结果如果只在浏览器里用,JavaScript 教程 里的
fetch+ DOM 解析也能做,但服务端聚合、定时任务还是 Go 更合适,可对照 API 细节。
三、什么时候该用哪种(适用边界)
抓取少量、格式固定的内部源,手写 encoding/xml 完全够用,还能把依赖压到最小。要对接五花八门的公开订阅源、还得兼容 Atom,gofeed 省下的适配成本远高于那一个依赖。正则扫描只出现在「我只要临时看一眼标题」的场景,绝不要进生产。边界就是:源的多样性越高,越该把解析交给成熟库。适用边界想清楚,golang 解析 RSS 这条链路就不会被格式差异拖垮。
如果想对照前端消费这份 JSON,JavaScript 速查手册 里列出了常用数据处理的 API,可以作为下一步参考。
四、3 个常见错误
4.1 忽略 Atom 与 RSS 格式差异
很多站点实际是 Atom(<entry> 而非 <item>),手写结构体只认 item 就会解析出空列表。要么用 gofeed 自动识别,要么同时定义两套结构并按根节点切换。失败排查时先看源站根节点是 rss 还是 feed,基本能定位问题。
4.2 网络请求没设超时
直接 http.Get 不设 Timeout,源站卡住时 goroutine 一直挂着,连接池被拖垮。务必用带超时的 http.Client,并把超时写成可配置项。预期结果是慢源超时返回错误而不是无限挂起,这样 worker 池才不会被个别慢源堵死。
4.3 把第三方库的 Item 直接序列化
gofeed 的 Item 字段很多,直接 json.Marshal 会带出一堆前端不需要的字段。最好先映射到自己的精简结构体,只保留标题、链接、发布时间,再序列化,输出更干净。验证方法是打印序列化后的字节,确认没有多余字段泄漏到接口里。
⚠️ 注意:RSS 的时间字段格式不统一(RFC1123Z、RFC3339 都可能),解析后建议统一转成
time.Time再输出,避免前端再踩时区坑。
总结
golang 解析 RSS 并返回 JSON,主线是「归一化再序列化」:源格式杂就上 gofeed,要极简依赖就手写 encoding/xml,正则只留给临时脚本。三个坑记住——别忽略 Atom 与 RSS 差异、网络请求必须设超时、序列化前先映射到精简结构。把解析交给合适的工具,这条链路能稳稳跑在长期服务里。
要点带走:
- 公开源优先 gofeed,自动兼容 RSS/Atom;
- 请求一定带超时,防止源站拖垮连接池;
- 输出前映射到自己的结构体,字段更干净。
下一步可以给结果加一层缓存,避免每次请求都重复抓取源站。
常见问题
Q:gofeed 和手写 encoding/xml 哪个性能更好?
A:手写结构体在只取少量字段时内存和分配更少;但 gofeed 省下的格式适配成本通常更值钱,性能差异在多数业务场景里感知不到。
Q:解析出来的时间字段怎么统一?
A:优先用库自带的解析(gofeed 已转成 time.Time),手写时按源站实际格式用 time.Parse 显式指定布局,不要依赖默认解析。
Q:需要同时抓很多源怎么办?
A:用带并发上限的 worker 池批量 ParseURL,单源失败不影响整体,并把超时和重试都配上,避免个别慢源堵塞。
延伸学习
想继续把 Go 工程化这块补齐,可以按这个顺序:
- 代码风格与可维护性可以参考 Go 代码技巧;
- 用 AI 辅助搭一个完整后台时,TRAE AI 开发 Python Django 后台管理系统 能边学边写;
- 前端消费这份 JSON 的细节可以查 JS 开发资源。



