
 TRAE-AI编程

报错堆栈不用怕,核心是先看清「哪一行是你的代码、哪一行是库内部、错误类型是什么」。先给结论:把堆栈从下往上读,最底下通常是根因触发点,最顶上是崩塌位置;用 DeepSeek 时,把完整的 traceback 连同出错前的几行代码一起贴给它,让它先定位到文件和行号,你再对照官方文档确认边界,比盲目搜索快得多。很多人只截最后一句话就去问,结果 AI 也只能猜。下面按「先抓错误类型 → 再定位文件行号 → 用 DeepSeek 拆解 → 对照文档验证 → 回归复现」的顺序走一遍,照做基本能把八成的常见报错在十分钟内查清,避免来回试错浪费一下午。
先看结论
- 堆栈从下往上读,最底部才是根因,别只盯最后一行。
- 把完整 traceback 加出错前 5 行代码一起给 DeepSeek,定位最准。
- 让它给「文件:行号 + 触发条件」,你再查官方文档确认版本边界。
- 修完必须复现一次,确认同样的输入不再崩,才算真正修好。
一、先抓错误类型
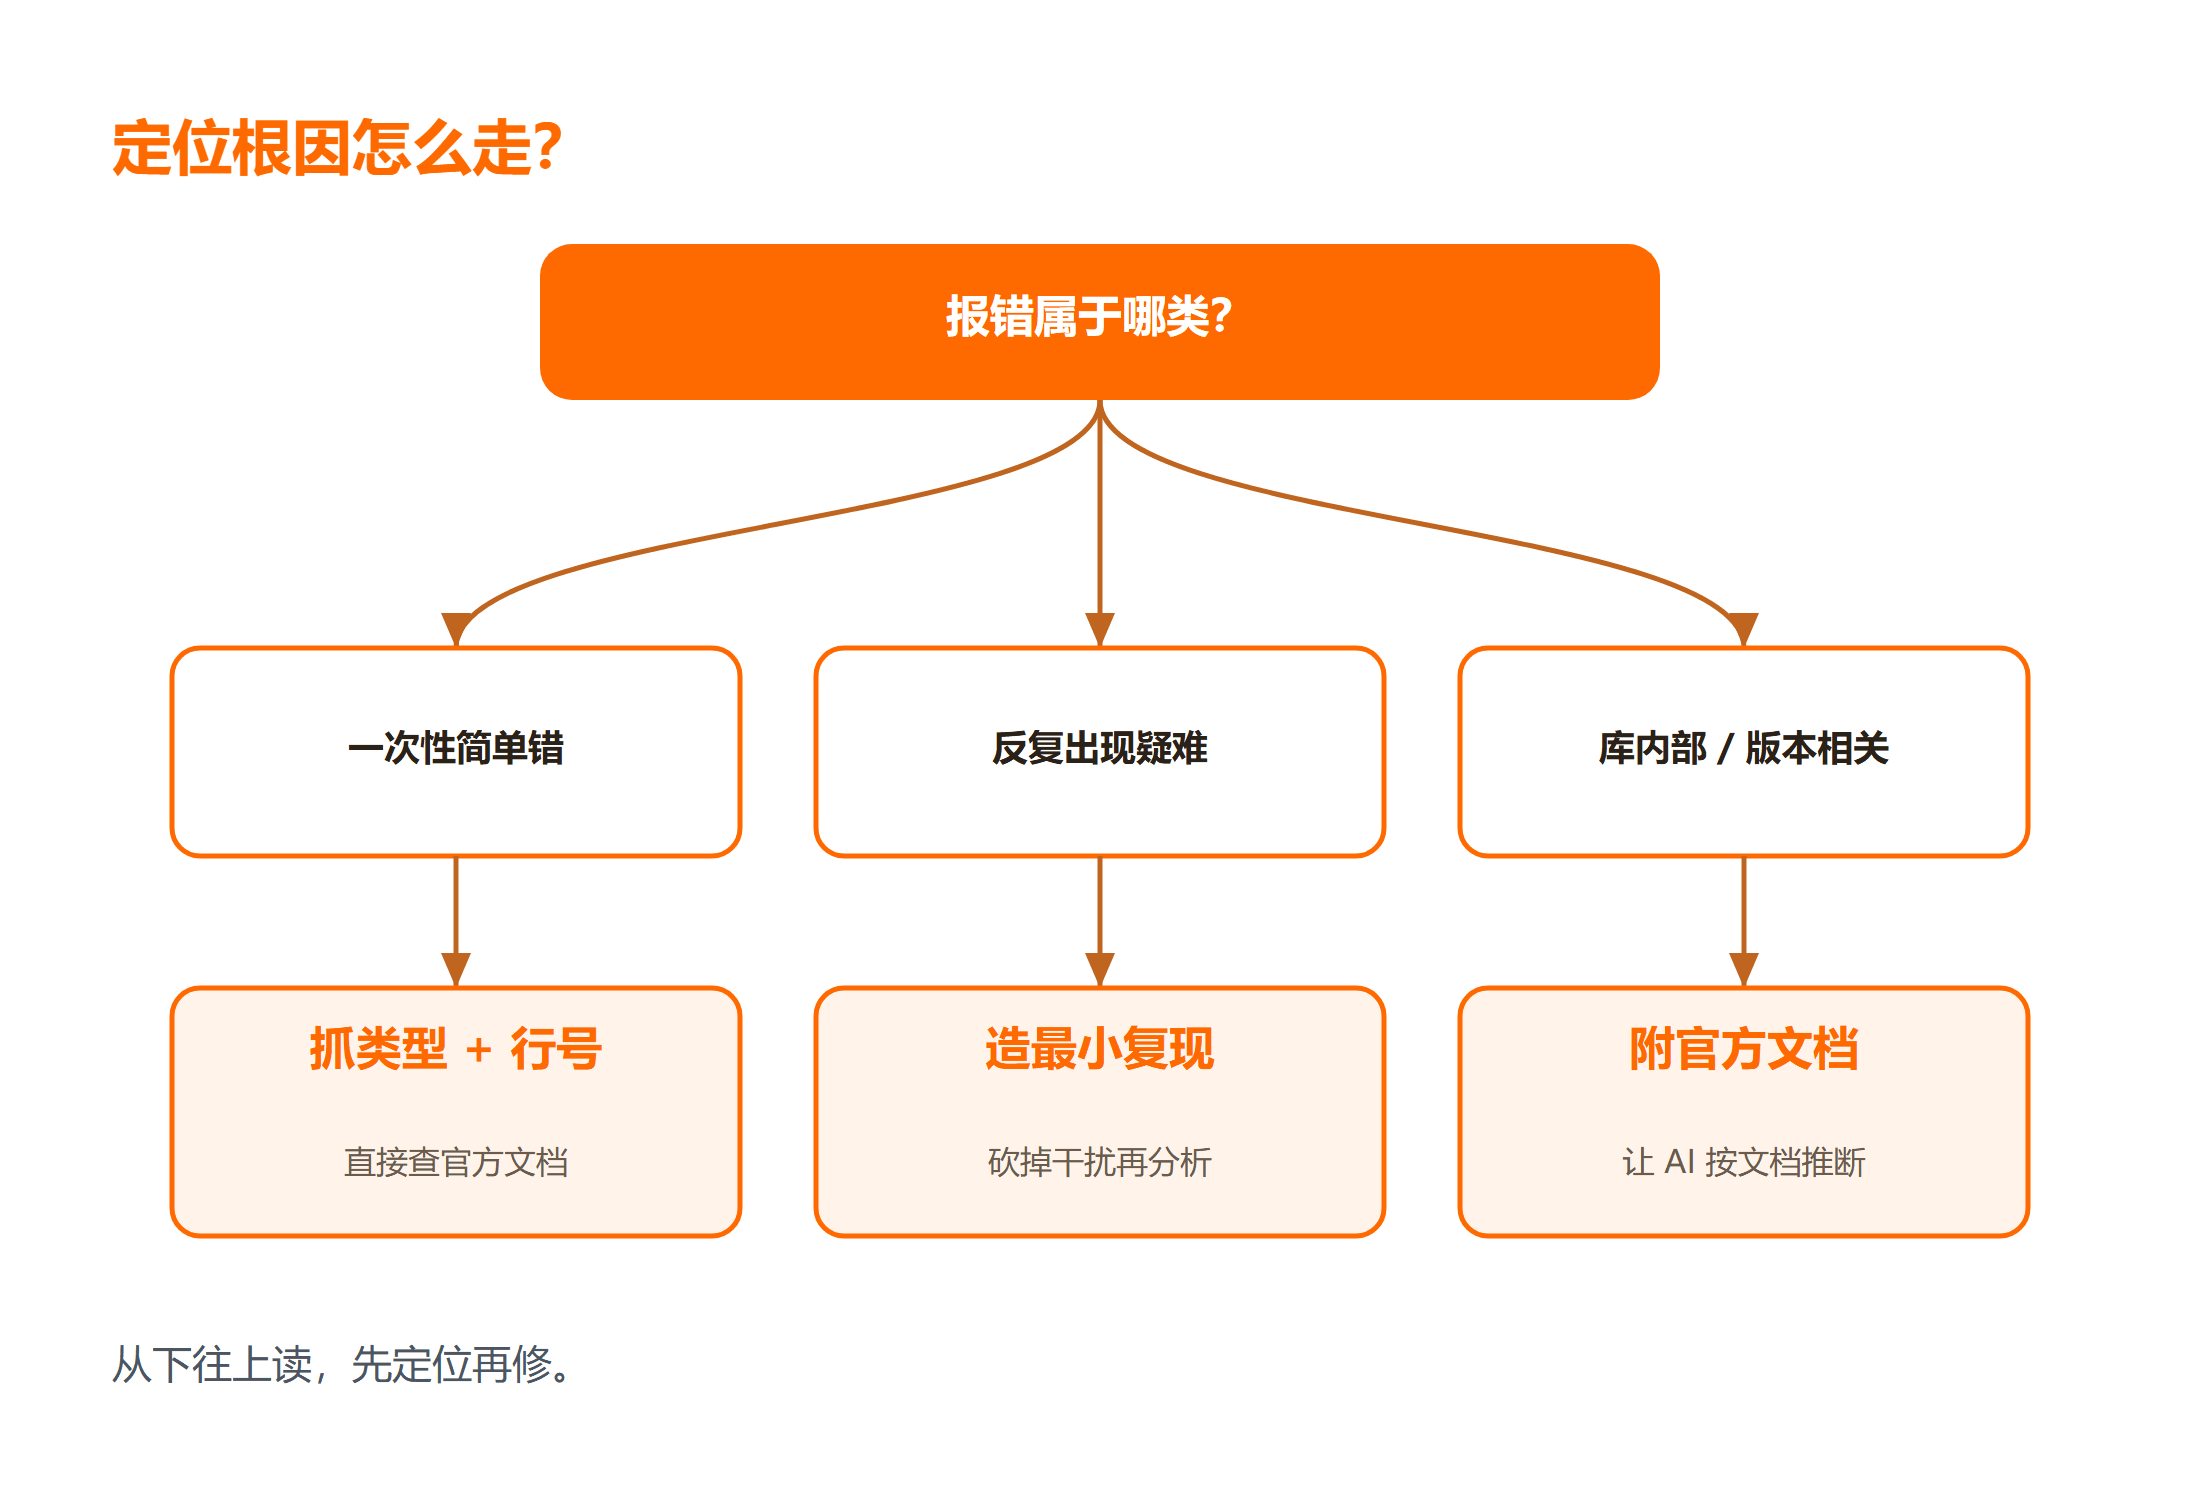
第一步是别被一堆红字吓住,先找错误类型那一列。Python 里常见的是 TypeError、ValueError、KeyError、IndexError;Java 多现 NullPointerException;前端常是 TypeError 或 ReferenceError。错误类型决定了排查方向:KeyError 基本是字典缺键,TypeError 多半是类型传错,IndexError 是越界。先把类型记下来,再去读后面那一长串调用链。
一个常见失败是只把最后一句「Exception has occurred」截图发给 AI,AI 没有上下文只能泛泛而谈。正确做法是用下面这条命令把完整信息落到文件,再贴给 DeepSeek:
# 把 Python 完整 traceback 重定向到日志,方便整段贴给 AI
python main.py 2> err.log
cat err.log
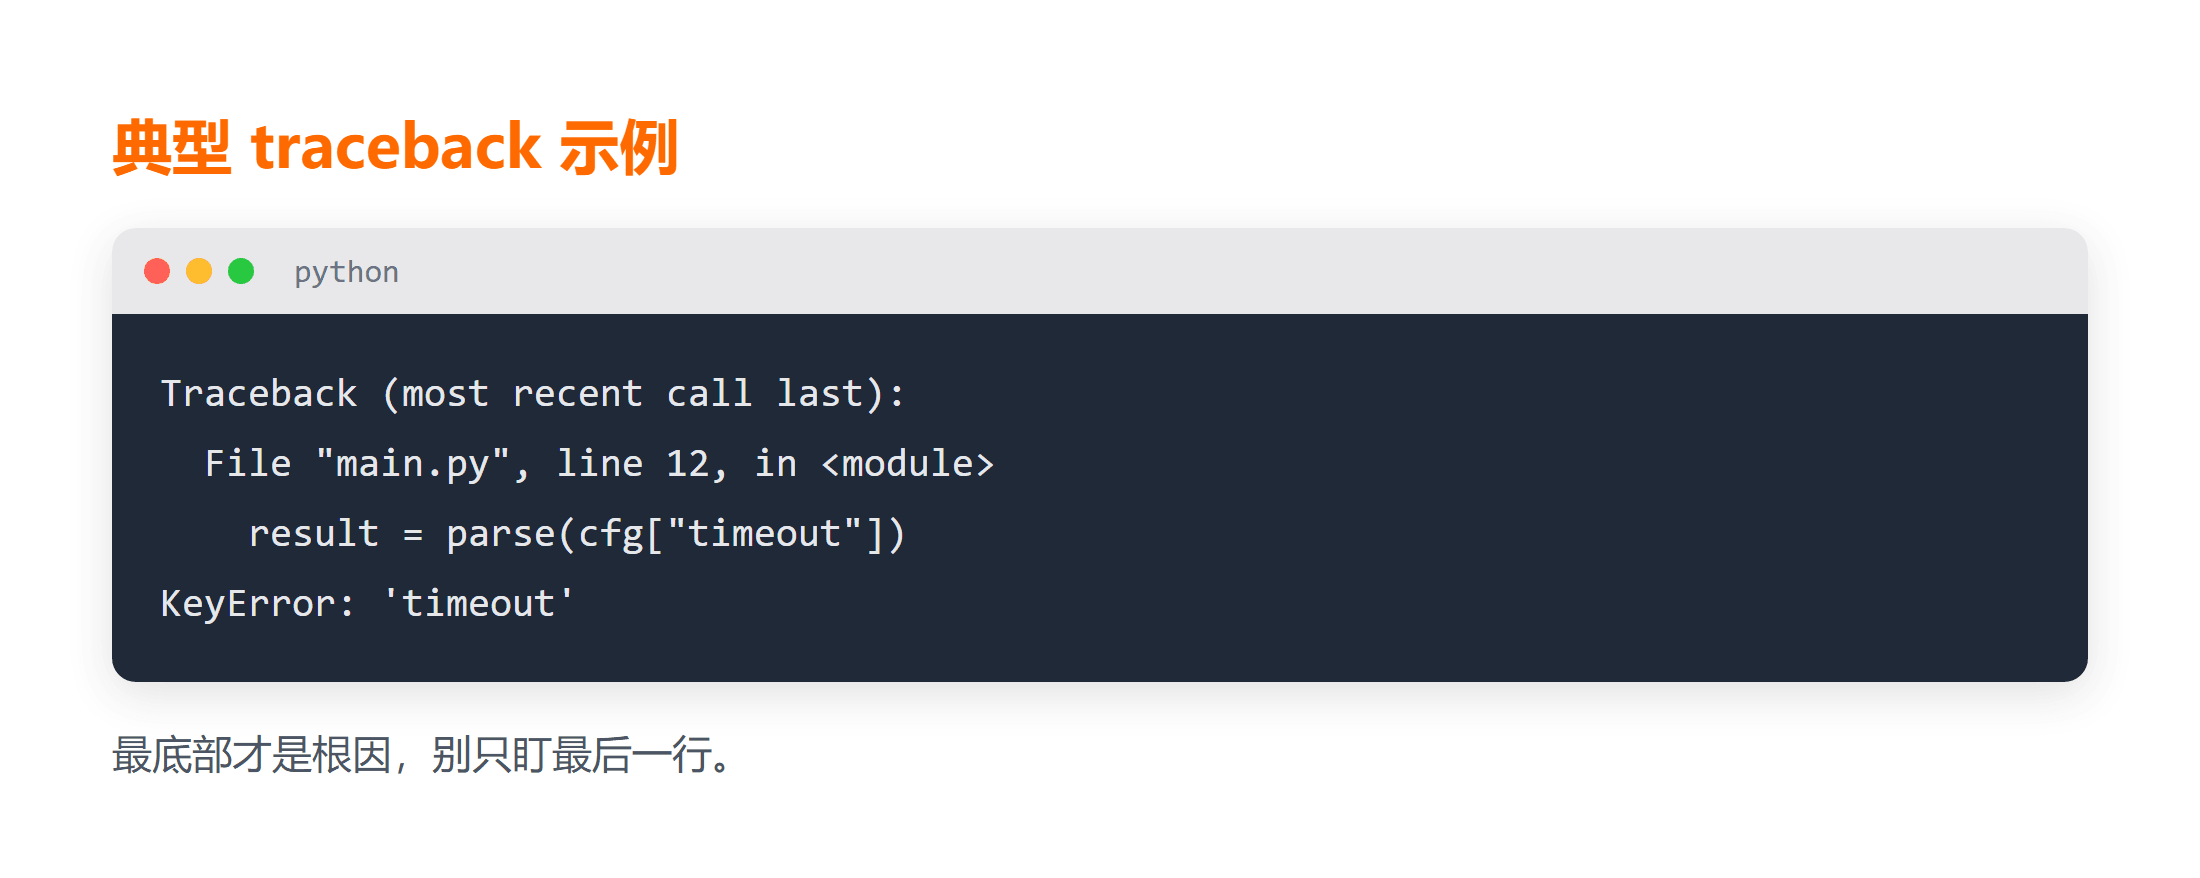
Traceback (most recent call last):
File "main.py", line 12, in <module>
result = parse(cfg["timeout"])
KeyError: 'timeout'上面这段是最典型的一类:报错类型 KeyError,位置在 main.py 第 12 行,触发条件是访问了不存在的键 timeout。类型确定后,排查范围立刻缩小到「配置加载」这一步。对模型调用原理想补基础,可以先过一遍 DeepSeek 中文教程,把提示词与上下文怎么影响输出讲清楚。
错误类型看熟了之后,可以建一份自己的速查笔记:把团队最常遇到的几类报错、各自的高频诱因、对应的排查动作列成表,下次再遇到直接对照,不用每次从头分析。新人尤其受益,能把平均排错时间从半小时压到几分钟。这份笔记本身就是你排错能力的积累,越用越值钱。
二、再定位文件与行号
堆栈里的「文件:行号」是你和 AI 的共同坐标。注意看哪个文件是你的项目代码、哪个是第三方库;根因几乎总在你自己的代码调用库的那一层,而不是库内部。如果行号指向 site-packages 里的库文件,说明是你传参不对,而不是库有 bug,别急着去给库提 issue。
定位时把出错前的几行代码也一并给 DeepSeek,它才能判断「当时变量长什么样」。比如上面 KeyError,光给一行不够,要给 cfg 是怎么来的那段:
import json
cfg = json.load(open("config.json"))   # 这里没做键存在性检查
result = parse(cfg["timeout"])          # 缺 timeout 键直接崩
这样 DeepSeek 能直接指出:config.json 缺少 timeout 字段,应该在读取后做默认值兜底。上下文越完整,AI 的定位越准,你也少走弯路。想看看同类工具怎么组织上下文,可以翻 OpenClaw 中文教程,它的智能体处理方式有对照价值。
定位文件行号时,还要留意「异步调用」带来的行号偏移:在回调、await、Promise 链里,报错显示的所在行常常是框架内部,真正的调用点要顺着堆栈往回找两三层。把相关代码整段给 DeepSeek,比只给标红那一行更容易让它还原真实执行路径。
三、用 DeepSeek 拆解根因
把「完整 traceback + 出错前代码 + 你期望的行为」三件套一起贴给 DeepSeek,并明确要求它先给定位再给修法。比只说「帮我修 bug」有效得多。让它输出「根因 / 触发条件 / 修复方案 / 验证方式」四段,你就能快速判断它有没有读懂。
有一个适用边界要记住:DeepSeek 擅长解释已知模式和给出修法,但不该替你做生产环境的破坏性改动。涉及数据库删除、权限变更的操作,先让它给命令,你再人工核对。对模型能力边界想更系统了解,可看 TRAE 编程中文教程,里面也有把 AI 用在排错工作流的例子。
拆根因时,要求它输出「根因 / 触发条件 / 修复方案 / 验证方式」四段,本身也是一种强制结构化:一旦它答不出某一格,你就知道它的理解有缺口,该补上下文而不是盲信。验证方式尤其不能省,它能逼着 AI 给出可操作的复现或回滚步骤,而不是停在「建议检查」这类空话。
四、对照官方文档验证
AI 给出的修复不一定贴合你的版本,必须对照官方文档确认。比如 dict 取值,Python 3.10+ 支持 cfg.get("timeout", 10),更早版本也能用同样的写法,但某些库的 API 在不同版本差异很大,盲目照抄会踩版本坑。文档能告诉你:这个方法在哪个版本引入、参数含义、返回值类型。
# 对照文档后的稳妥写法:缺键给默认值,避免 KeyError
timeout = cfg.get("timeout", 10)
result = parse(timeout)
这段改动把崩溃点从「取值」挪到了「解析」,风险更可控。版本差异、默认值行为都以文档为准,不要只看 AI 一句话就上线。参数与字段细节可随时查 Python 速查手册,确认内置函数用法。
总结
DeepSeek 读懂报错堆栈,关键在「给它完整的、带行号的、有前后代码的信息」,而不是一句报错摘要。顺序是先抓错误类型、再定位文件行号、用 DeepSeek 拆解根因、对照官方文档确认版本边界、最后复现验证。做好这五步,大半常见报错能在十分钟内查清,既省搜索时间,也养成「先看证据再动手」的排错习惯。
常见问题
Q:只把最后一行错误发给 AI 为什么总答不准?
因为最后一行只是崩塌位置,真正根因在堆栈底部。没有完整调用链和出错前代码,AI 只能基于错误类型泛泛推断,命中率低。整段 traceback 加前后代码才是有效输入。
Q:AI 给的修复能直接上线吗?
简单取值、类型转换这类低风险改动,验证通过即可用。但涉及删数据、改权限、外部调用的,必须先看官方文档确认版本与边界,再在测试环境跑通,别直接动生产。
Q:堆栈指向第三方库内部怎么办?
多半是你传参不对,不是库 bug。回到调用库的那一行,核对参数类型、数量和顺序,对照库的文档示例改你的调用方式,而不是去改库源码。
延伸学习
- Python 零基础到高薪就业(配套课程,把基础打扎实少踩坑)
- 将Python代码打包成.exe可执行文件的完整步骤(笔记,实战里常见的一类报错对照)
- Python代码格式化(在线工具,贴代码前先规范格式更利于排错)



