
 TRAE-AI编程

直接丢给大模型一个复杂问题,答案常常顾此失彼:该覆盖的点漏了,该核对的细节也错了。先给结论:Prompt 链把一个大任务拆成几个顺序执行的小步骤,每一步只做一件事,并把上一步的输出交给下一步,用「分步 + 校验」换取更高的准确性与覆盖率。本文用一个「提取要点再核对」的最小例子,讲清怎么拆、怎么传、怎么验,以及什么时候反而没必要拆。文中的写法基于通用提示工程实践,示例为编辑整理,未在本机实际运行。
先看结论
Prompt 链的本质是把一次 prompts 变成一条流水线。
第一,单步 prompt 的天花板很明显。任务一复杂,模型要么漏点、要么把两类要求混在一起做不好。想理解提示词怎么影响输出,可以先过一遍 AI 编程技能教程 的相关章节。
第二,拆分的依据是「一件事一步」。提取归提取,核对归核对,格式归格式,每步的输入和输出都明确,才谈得上稳定。
第三,链不是越长越好。每多一步就多一次调用、多一处失败点。任务简单时,一个写得好的 prompt 就够。
一、先看单步 prompt 为什么会漏
假设要让模型从一段访谈里提取人名、时间和事件,还要核对时间是否合理。塞进一个 prompt 会怎样:
请从下面文字里提取人名、时间、事件,并判断时间是否合理,用 JSON 输出:
【访谈原文】……
预期结果(未在本机执行):模型常常顾着凑 JSON 格式,漏掉某个字段,或者「判断合理」这一步做得很敷衍。原因是它同时要处理提取、判断、格式化三类要求,注意力被摊薄。
这就是覆盖率(该提的没提全)和准确性(判断出错)同时下降的典型场景。Prompt 链的做法,是把这三类要求拆开。
⚠️ 注意:模型不会因为你把要求写在一句里就自动分步。它没有隐式的任务调度,需要你显式安排步骤。
二、第一步:只做提取
链的第一步只管提取,不判断、不管格式:
你是一个信息提取器。只从文本中提取出现的人名、时间和事件,逐条列出。
不要解释,不要判断是否合理。
【访谈原文】……
预期结果(未在本机执行):得到一份比较完整的原始清单。因为只做一件事,覆盖率通常比单步高。想在线试跑不同写法,可以用 Python 在线运行 配合接口调试。
关键点是「不要解释、不要判断」这类否定约束要写清楚。否则模型会自作主张地加入评价,污染下一步的输入。
💡 小提示:把每一步的输出约定成固定结构(如每行一条),下一步才好解析。结构化是链条能自动衔接的前提。
三、第二步:只做核对
把第一步的输出原样交给第二步,这一步只核对,不重新提取:
下面是提取结果。请逐条核对时间是否合理(不早于 2000 年、格式完整),
输出「条目 + 合理/存疑 + 原因」。不要新增条目。
【第一步输出】……
预期结果(未在本机执行):得到一份带判断的清单,且条目数没有凭空增加。「不要新增条目」这条约束很关键,它防止模型在这一步「顺手补充」其实原文里没有的信息。
第三步如果需要,再专门做格式化(比如转成 JSON)。把格式化单独拆出,是为了让前两步的判断不被格式要求干扰。
四、适用边界与失败分支
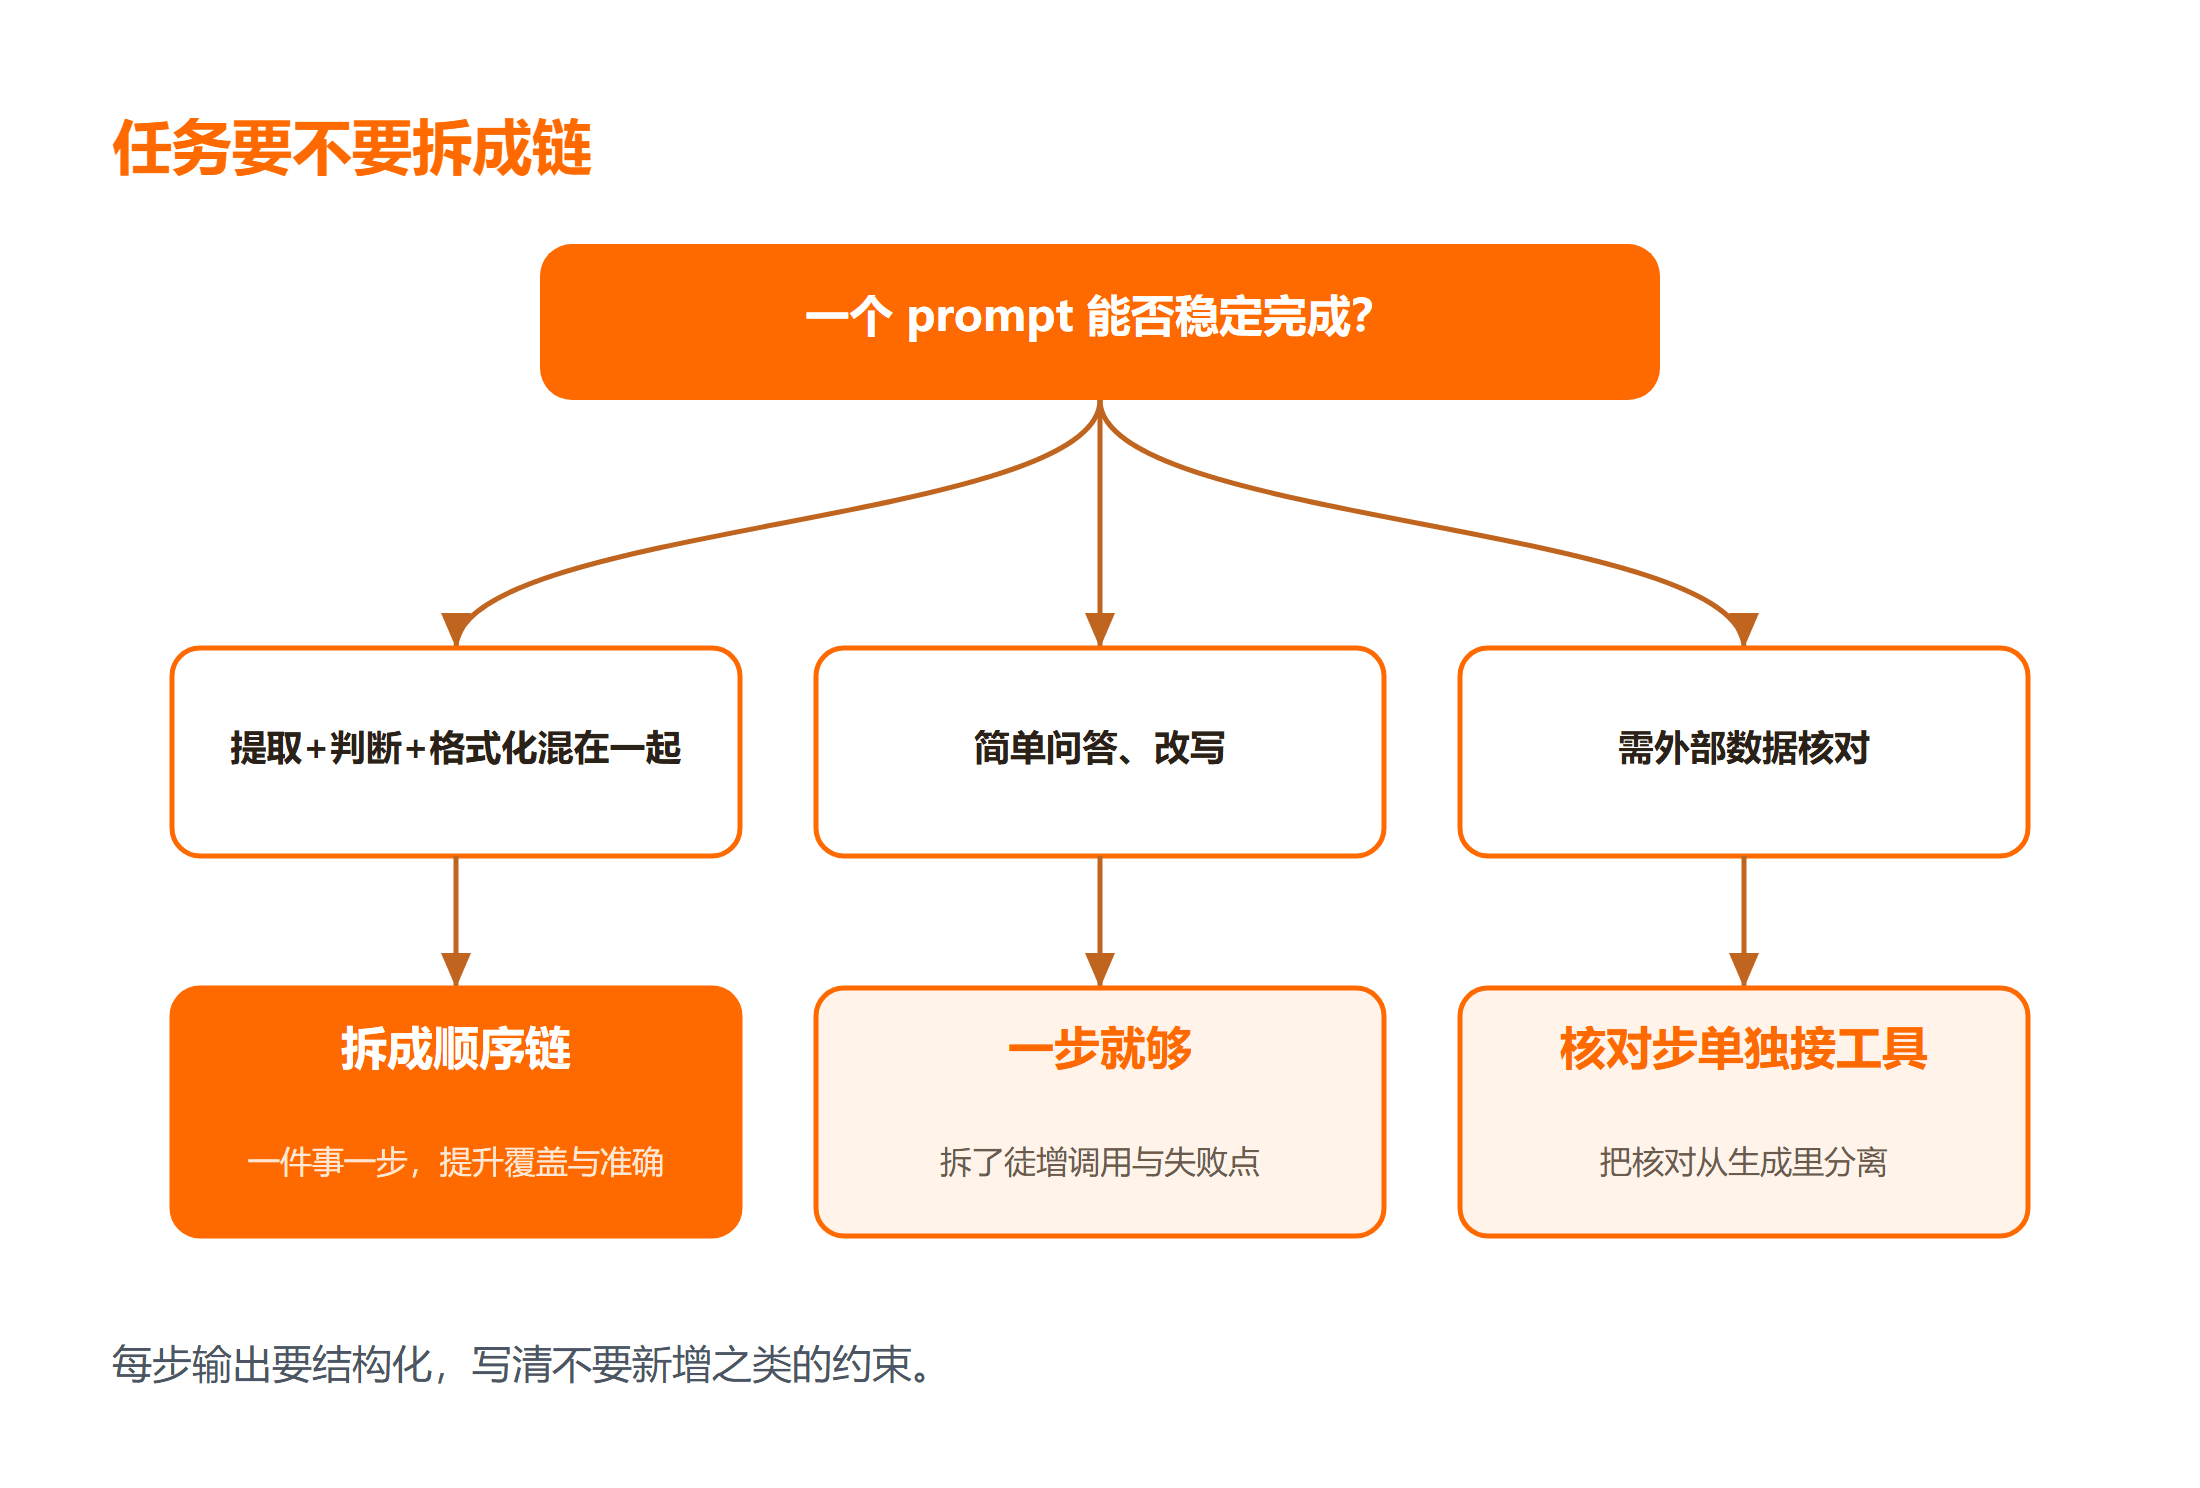
把拆与不拆的取舍放在一起看:
| 场景 | 是否拆成链 | 原因 |
|---|---|---|
| 简单问答、改写 | 不必 | 一步就够,拆了徒增开销 |
| 提取 + 判断 + 格式化 | 建议拆 | 分步能同时提升覆盖率与准确性 |
| 需要外部数据核对 | 建议拆 | 核对步骤可单独接工具 |
4.1 反例与失败分支
几个真实会踩的坑:
- 无固定输出格式:第一步输出是自由文本,第二步没法解析。先约定结构化格式,链条才接得上。
- 步骤间重复提取:第二步又从头提取一遍,等于没拆,错误还会叠加。明确写「不要新增条目」。
- 链条过长:拆成七八步,调用成本和失败概率都上升,整体准确性反而下降。够用就好。
- 性能取舍:每一步都是一次模型调用,延迟和费用随步数线性增加。能用一步稳定完成的,就别拆。
4.2 动手核对清单
按顺序搭一遍,就能验证链条是否生效:
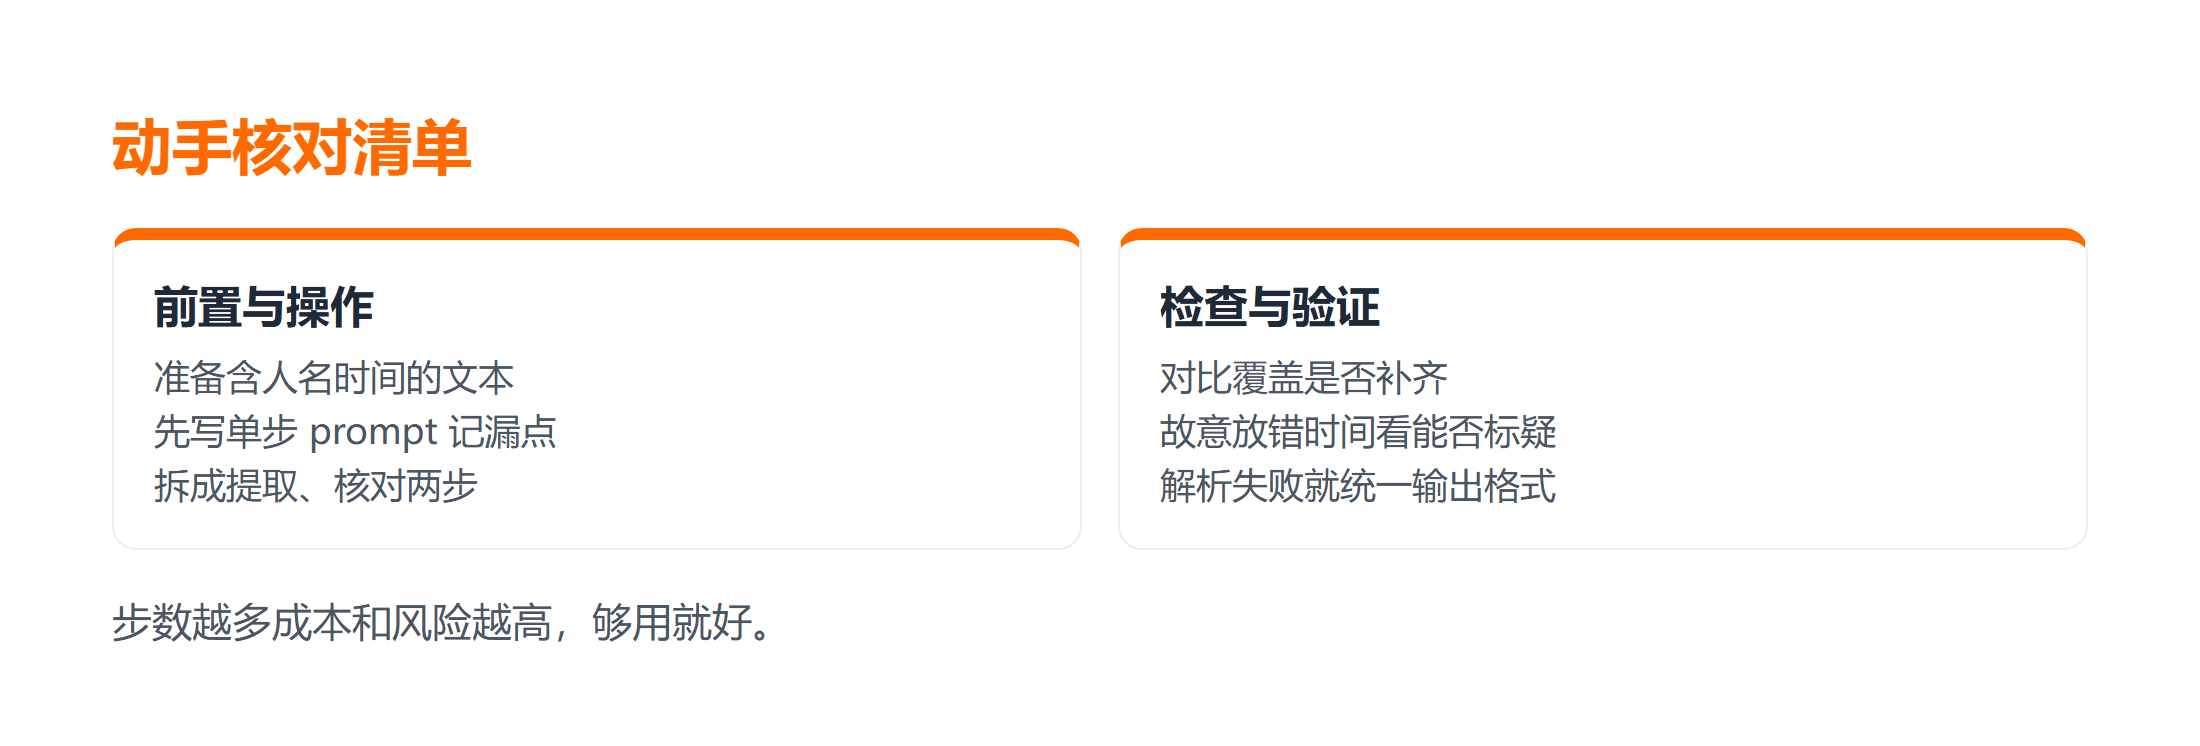
- 前置:准备一段有明确人名、时间、事件的文本;
- 操作:先写单步 prompt 记下漏点,再拆成提取、核对两步;
- 检查:对比两者的覆盖率,看单步漏掉的字段是否在链里补齐;
- 预期:第一步清单完整、第二步核对有判断,条目不凭空增加;
- 验证:故意放一个不合理时间,看第二步能否标为存疑;
- 失败处理:解析失败就统一输出格式,判断敷衍就把核对要求写具体。
以上步骤基于通用提示工程实践整理,示例标为未在本机执行;不同模型的遵循能力不同,约束要按实际效果调整。
总结
Prompt 链把复杂任务拆成顺序执行的小步,每步只做一件事,把输出交给下一步。它用分步和校验同时提升覆盖率与准确性,但会增加调用成本和失败点。
要点带走:
- 拆分依据是「一件事一步」,先提取、再核对、最后格式化;
- 每步输出要结构化、写清否定约束,下一步才接得上;
- 简单任务别硬拆,够用就好,步数越多成本和风险越高。
常见问题
Q:怎么用 Prompt 链提升准确性与覆盖率?
A:把复杂任务拆成几个顺序步骤,每步只做一件事,并把上一步输出交给下一步。比如先只提取、再只核对、最后只格式化。每步输出约定成固定结构,并写清「不要新增」之类的约束,减少遗漏和臆造。
Q:Prompt 链是不是越长越好?
A:不是。每多一步就多一次模型调用和多一个失败点,成本与延迟都上升。简单任务写好一个 prompt 就够;只有提取、判断、格式化混在一起明显出错时,才值得拆成链。
Q:为什么第二步要写「不要新增条目」?
A:因为模型有「顺手补充」的倾向,核对时可能加进原文没有的信息,导致准确性下降。显式禁止新增,能把第二步限制在核对已有条目上,避免凭空捏造。
延伸学习
想继续补齐提示工程与大模型应用基础,可以按这个顺序看:
- 想系统学人工智能应用,可以看 AI 人工智能教程;
- 对照一份真实的语法基础题库查漏补缺,翻 Python基础语法题库:巩固知识;
- 想把提示词与解析代码排版整理干净,用 Python代码格式化 辅助核对。



