
 TRAE-AI编程

你在处理中文文本时遇到乱码,翻资料看到 encode 和 encoding 两个词,搞不清它们是不是一回事。先给结论:encode 是一个动作,指把字符串转换成字节;encoding 是这个动作所依据的编码规则,比如 UTF-8、GBK。一个是动词,一个是方案名,两者是「怎么做」和「按什么规则做」的关系。本文用最小 Python 代码把这两个概念彻底分开,再讲清常见的编码解码做法、什么时候该用哪一种,以及出错后怎么定位。看完你能分清方法名和参数名,也能在遇到乱码时判断是编码选错还是解码方式不对。示例基于 Python 3.x,为编辑整理,未在本机实际运行。
先看结论
encode 和 encoding 只差几个字母,指的是完全不同的东西。
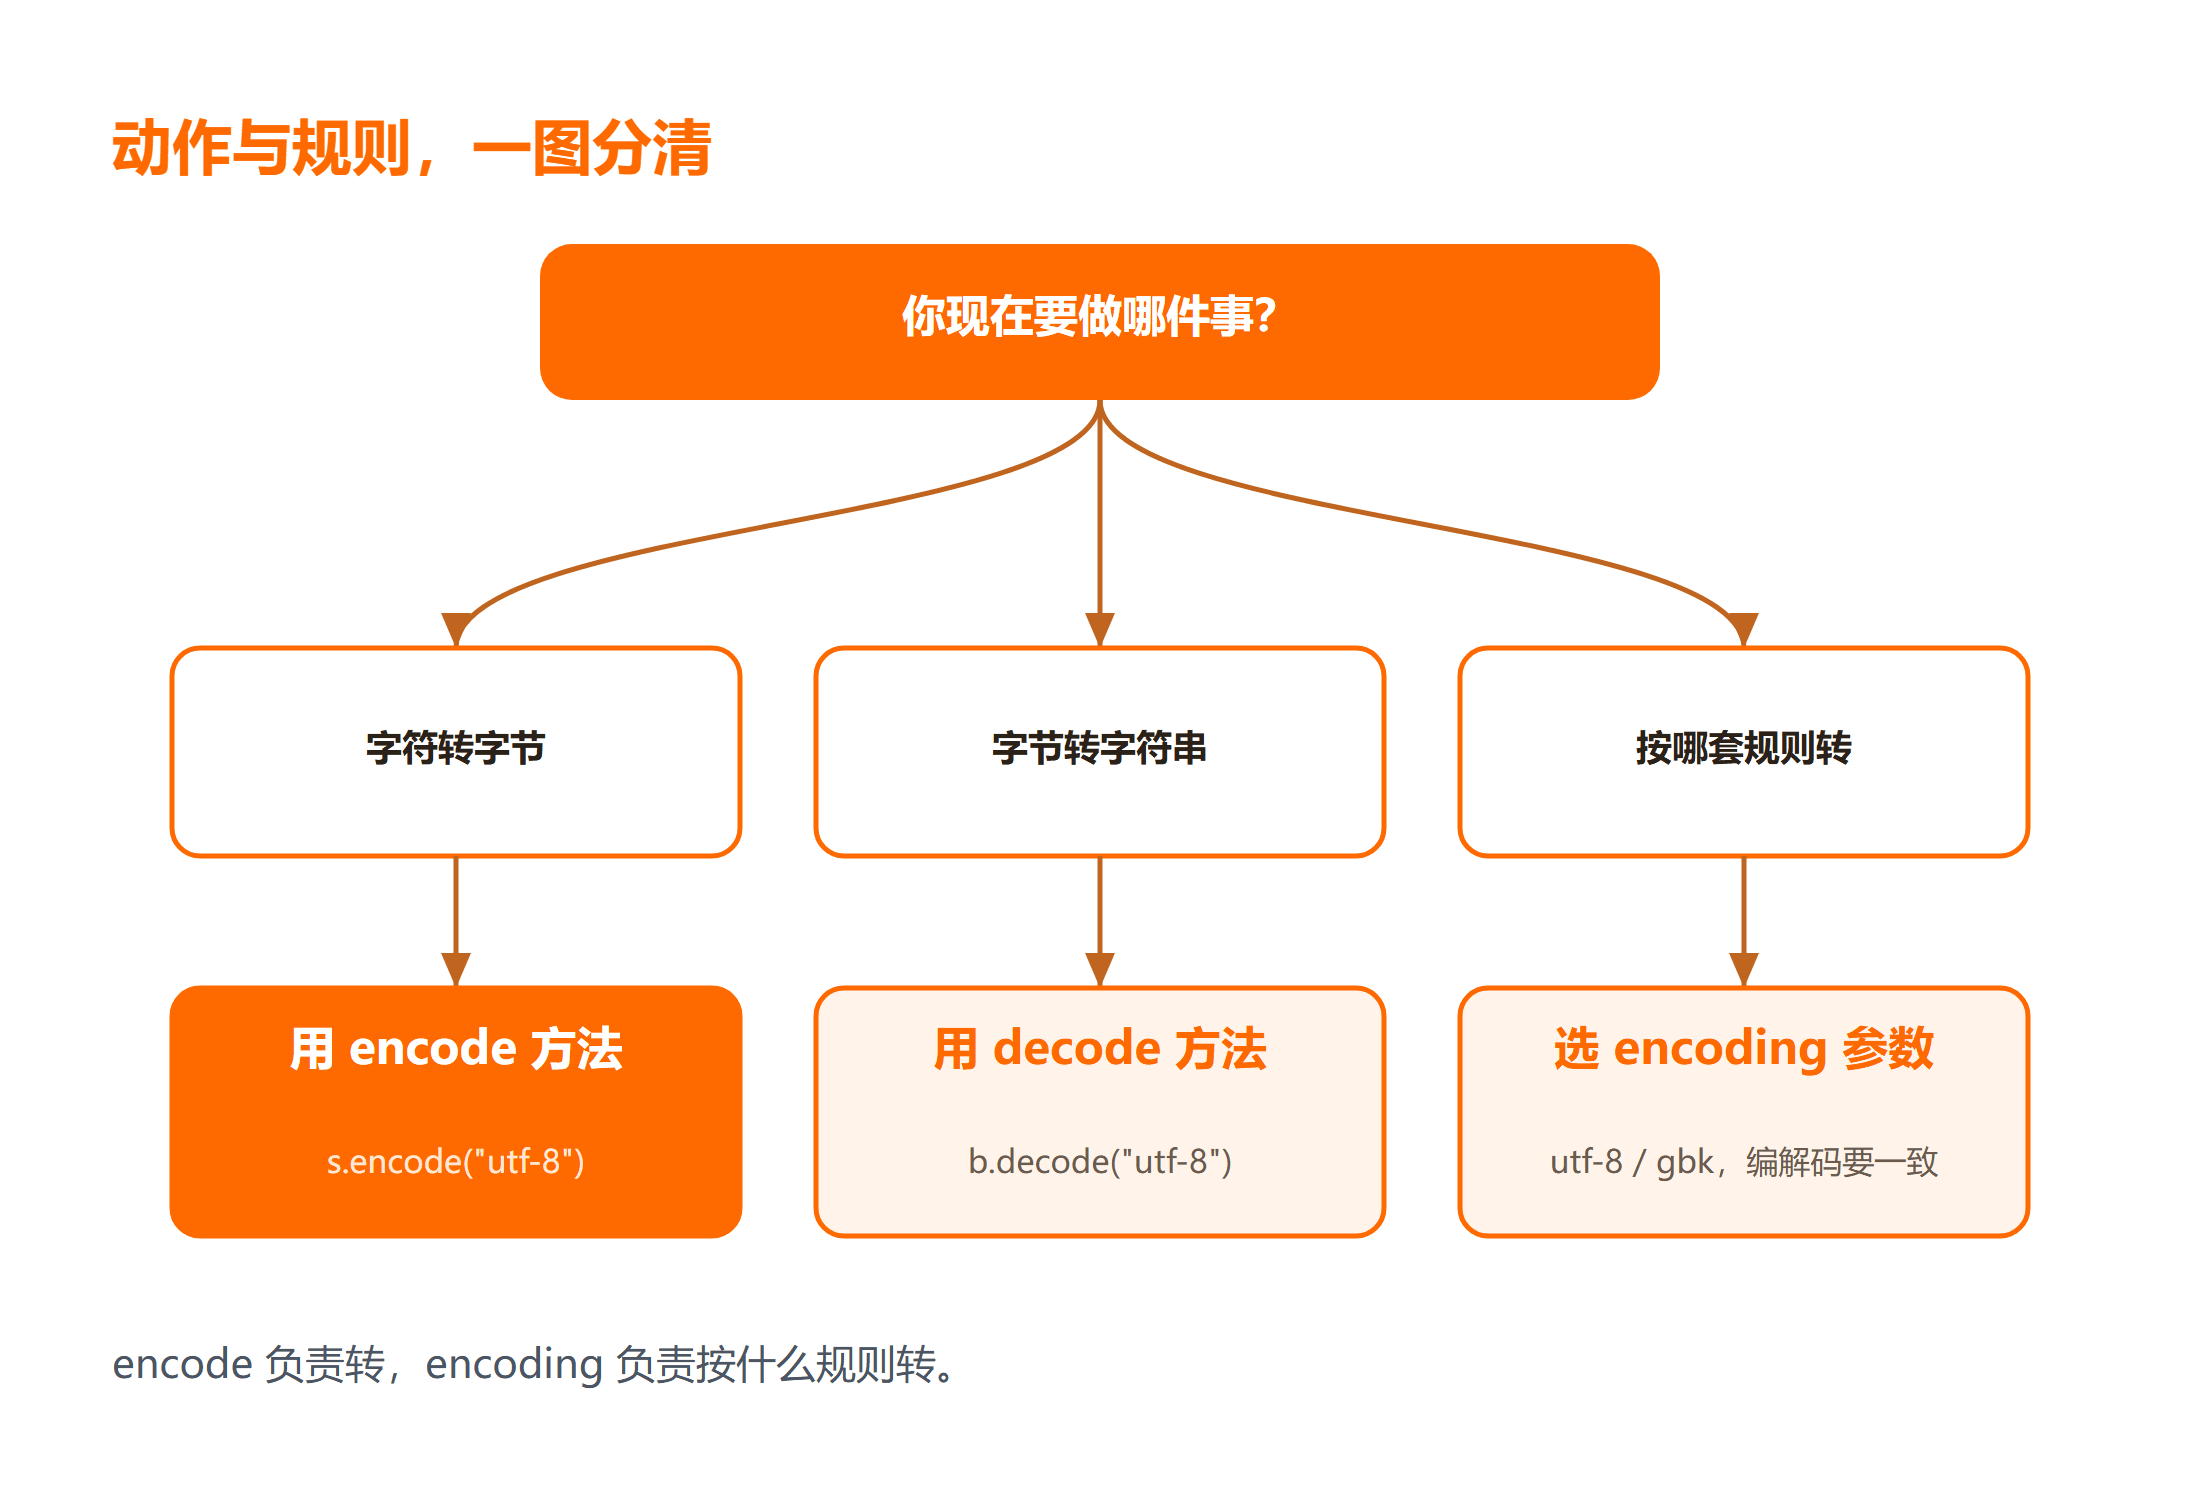
encode 是字符串对象上的一个方法,调用它会把字符转换成字节序列,也就是从「人能读的文字」变成「计算机存的字节」。反过来,把字节还原成字符串,用的是 decode 方法。
encoding 不是方法,而是一个编码方案的名字,通常作为参数传给 encode 或 decode,告诉 Python 按哪套规则转换。常见的取值有 utf-8、gbk、ascii 等。想补一遍字符串基础,可以过一遍 Python3 教程 的字符串章节。
一句话记住它们的分工:encode 负责「转」,encoding 负责「按什么规则转」。把这句话立住,后面所有乱码问题都能拆成两步判断——转换动作对不对,编码规则选对没有。
一、先分清方法名和参数名
第一件事是把两个词放回各自的语法位置。看这段最小代码:
s = "编程狮"
b = s.encode("utf-8")   # encode 是方法,utf-8 是 encoding 参数
print(b)
print(type(b))
预期结果(未在本机执行):第一行显示类似 b'\xe7\xbc\x96\xe7\xa8\x8b\xe7\x8b\xae' 的字节串,第二行显示 <class 'bytes'>。这里的 encode 是字符串对象的方法,括号里的 "utf-8" 才是 encoding——一个编码方案的名称。
再看它们的对应关系:
raw = b.encode("utf-8")     # 字符串 → 字节
text = raw.decode("utf-8")  # 字节 → 字符串,用同一套规则
预期结果(未在本机执行):text 重新变成「编程狮」。这里有一条关键经验:编码和解码要用同一套 encoding,用 utf-8 编码、却用 gbk 解码,得到的就是乱码。更多方法与参数速查,可以配合 Python 速查手册 核对。
⚠️ 注意:encode 的拼写是动词,encoding 是名词形态的参数值。写代码时别把两个词混用,写成
s.encoding(...)会直接报错,因为字符串没有这个方法。
二、常见编码方案怎么选
分清概念后,第二件事是选对 encoding 参数。不同方案覆盖的字符范围不同,选错是乱码的主要来源。
utf-8 是当前最通用的选择。它兼容 ASCII,能表示全球几乎所有字符,中文、 emoji 都支持,网络传输和文件存储几乎默认用它。没有特殊理由时一律选 utf-8。
gbk 是国内老系统常见的中文编码。如果你要读取一份早期系统导出的中文文件,对方用的是 gbk,你就得用 gbk 解码;用 utf-8 去读就会出现乱码或报错。
ascii 只覆盖英文和基本符号,遇到中文会抛 UnicodeEncodeError。看到这个错误,通常就是在用 ascii 编码中文,把 encoding 换成 utf-8 即可。
一个真实场景:从网页抓下来的字节是 utf-8,你却按 gbk 解码,结果每个中文字都变成几个奇怪符号。这不是数据坏了,是解码规则选错,换回 utf-8 重解一次就好。
三、编码解码的几种做法与取舍
实际开发里,处理编码有几种常见做法,各自的适用场景不同。
第一种是显式指定 encoding。每次调用 encode 或 decode 都写清楚用哪套规则,比如在文件读写里写 open(path, encoding="utf-8")。这是最稳的做法,因为不依赖系统默认值,换台机器结果一致。
第二种是依赖默认编码。有些场景下不写 encoding 参数,Python 会用系统默认编码。问题在于不同系统的默认值可能不同,同一段代码在 Windows 和 Linux 上行为不一致。这是跨环境乱码的隐形来源。
第三种是先探测再解码。面对来源不明的文件,先用工具判断编码,再按结果解码。适合处理历史数据,但探测本身不保证百分百准确。
| 做法 | 适用场景 | 代价 |
|---|---|---|
| 显式指定 encoding | 绝大多数场景 | 要多写几个字 |
| 依赖默认编码 | 临时脚本 | 跨环境结果不一致 |
| 先探测再解码 | 来源不明的历史数据 | 探测可能不准 |
4.1 反例与失败分支
几个真实会踩的坑,逐个说清:
- UnicodeEncodeError:用 ascii 编码中文会抛错,换成 utf-8 通常解决。
- UnicodeDecodeError:用 utf-8 解码 gbk 字节会中途报错,确认来源后换对规则。
- 乱码但不报错:编码解码用了两套不同的规则,程序不报错但内容是乱的,这类最隐蔽,要靠核对原始来源定位。
- 性能取舍:大文件逐行解码再拼接,比整体一次解码更省内存。数据量大时优先考虑分块处理。
4.2 动手核对清单
按顺序做一遍,能把绝大多数编码问题定位清楚:
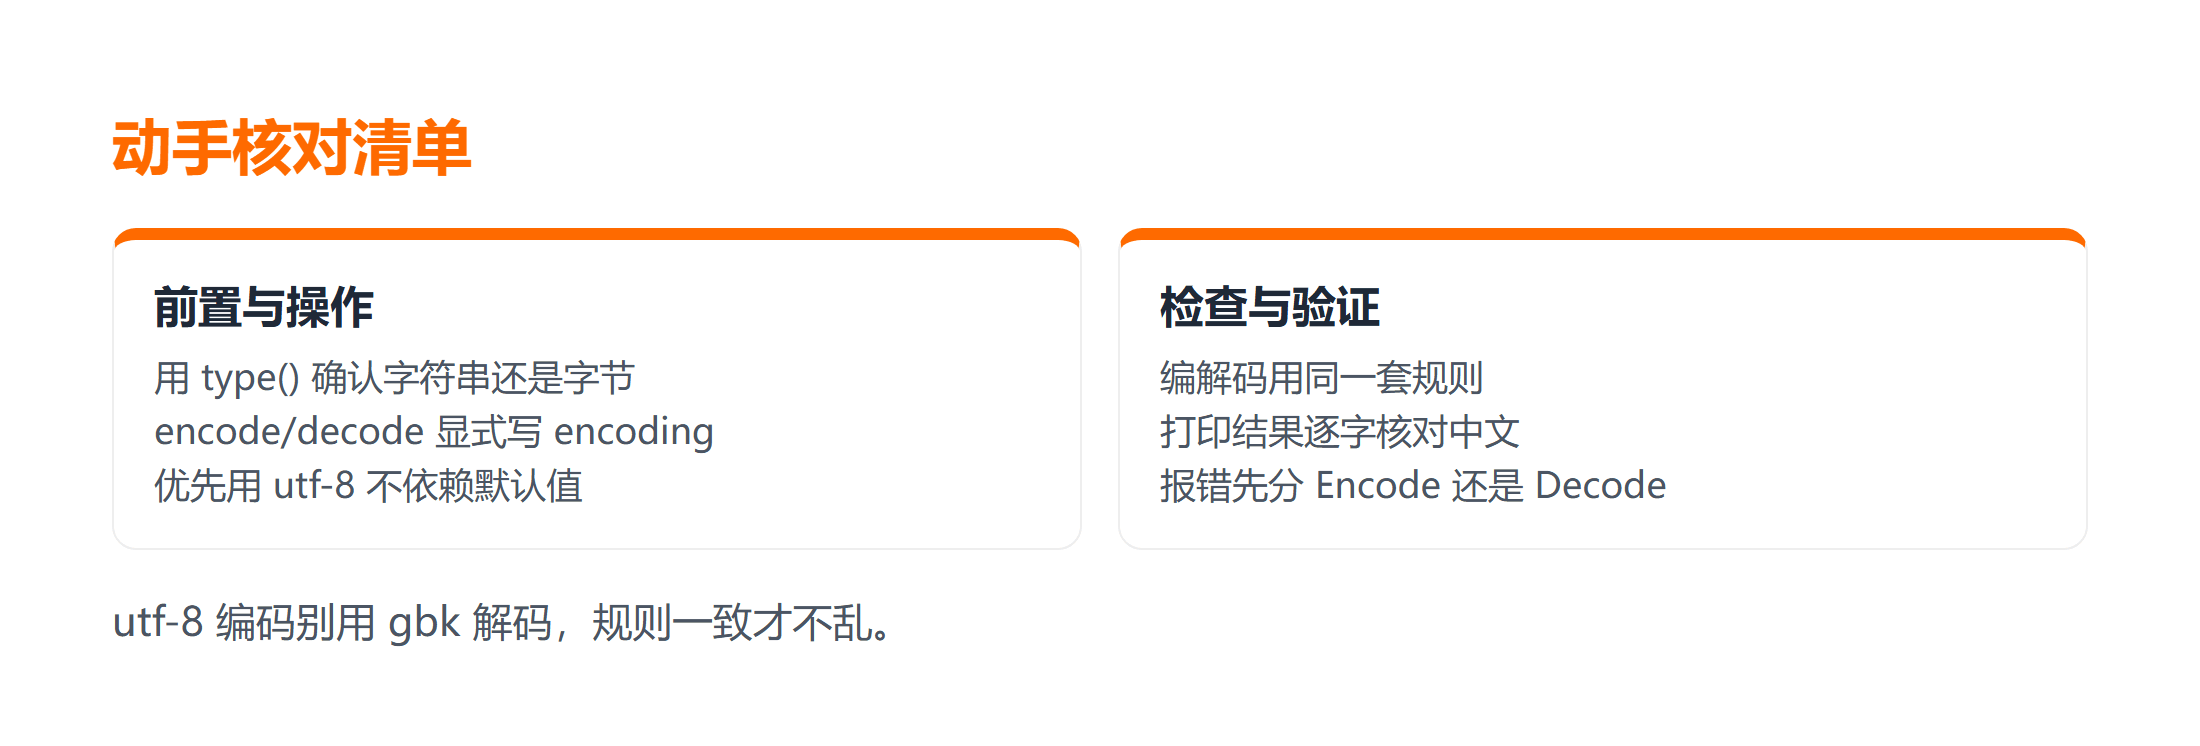
- 前置:确认要处理的是字符串还是字节,用
type()看一眼类型; - 操作:字符串转字节用 encode,字节转字符串用 decode,每次都显式写 encoding;
- 检查:确认编码和解码用的是同一套规则,utf-8 与 gbk 不要混用;
- 验证:把结果打印出来,和原始内容逐字核对,中文是否完整显示;
- 失败处理:报错先看错误类型是 Encode 还是 Decode,再回到对应一端换规则。
想在线验证转换结果,可以用 编码解码工具 把字节粘进去对照检查,快速判断是规则选错还是数据本身有问题。
以上步骤基于 Python 3.x 通用编码机制整理,标为编辑推断,未在本机实际运行;不同版本个别行为以实际为准。
总结
encode 和 encoding 的关系,一句话就能记住:encode 是转换动作,encoding 是转换规则。前者是字符串方法,后者是传给方法的参数值。
要点带走:
- 字符串转字节用 encode,字节转字符串用 decode,两者要配对;
- encoding 优先显式写 utf-8,不依赖系统默认,跨环境才一致;
- 出错先分清是 Encode 还是 Decode 阶段,再回对应一端核对规则。
把方法名和参数名的分工立清楚,再看任何乱码问题都不会无从下手。
常见问题
Q:encode 和 encoding 到底有什么区别?
A:encode 是字符串对象的方法,执行「字符转字节」这个动作;encoding 是编码方案的名字,比如 utf-8、gbk,作为参数告诉 encode 或 decode 按哪套规则转换。一个是动词动作,一个是规则名称。
Q:Python 里出现 UnicodeDecodeError 该怎么处理?
A:这说明字节用当前指定的规则解不开。先确认数据的真实编码来源,是 gbk 就别用 utf-8 解。编码和解码必须用同一套 encoding,规则对上了错误自然消失。
Q:为什么同一段代码在 Windows 和 Linux 上结果不一样?
A:多半是因为没有显式指定 encoding,代码依赖了系统默认编码,而两个系统的默认值不同。在所有 encode、decode 和文件读写的地方都写清楚 encoding="utf-8",行为就一致了。
延伸学习
想系统补齐编码与字符串知识,可以按这个顺序:
- 想系统学一遍 Python 数据处理,可以看 TRAE AI 开发 Python Django 后台管理系统;
- 对照在线工具理解编码解码的实际效果,翻 URL 在线编码解码工具是什么?怎么用(附在线工具);
- 需要频繁验证转换结果时,用 URL编码解码工具 快速核对。



