 TRAE-AI编程

存在则更新、不存在则插入,这就是 mysql插入或更新 的核心需求;日常首选 INSERT ... ON DUPLICATE KEY UPDATE,它只在唯一键冲突时更新指定列。只有当需要整行替换时才用 REPLACE INTO,但它本质是删后插,有副作用。很多新手分不清二者,把 REPLACE 当普通更新用,结果自增 id 跳号、触发器误删数据。本文用一张选择表、最小示例和逐行注释,把三种写法一次讲清,并附排错表与高频问答,帮你在编码和上线时少踩坑。顺便说一句,当你在业务里反复做「查重后写入」的动作,本质就是在做数据去重写入,选型不对会让去重变「删重」。
一、先看结论:MySQL 插入或更新怎么选
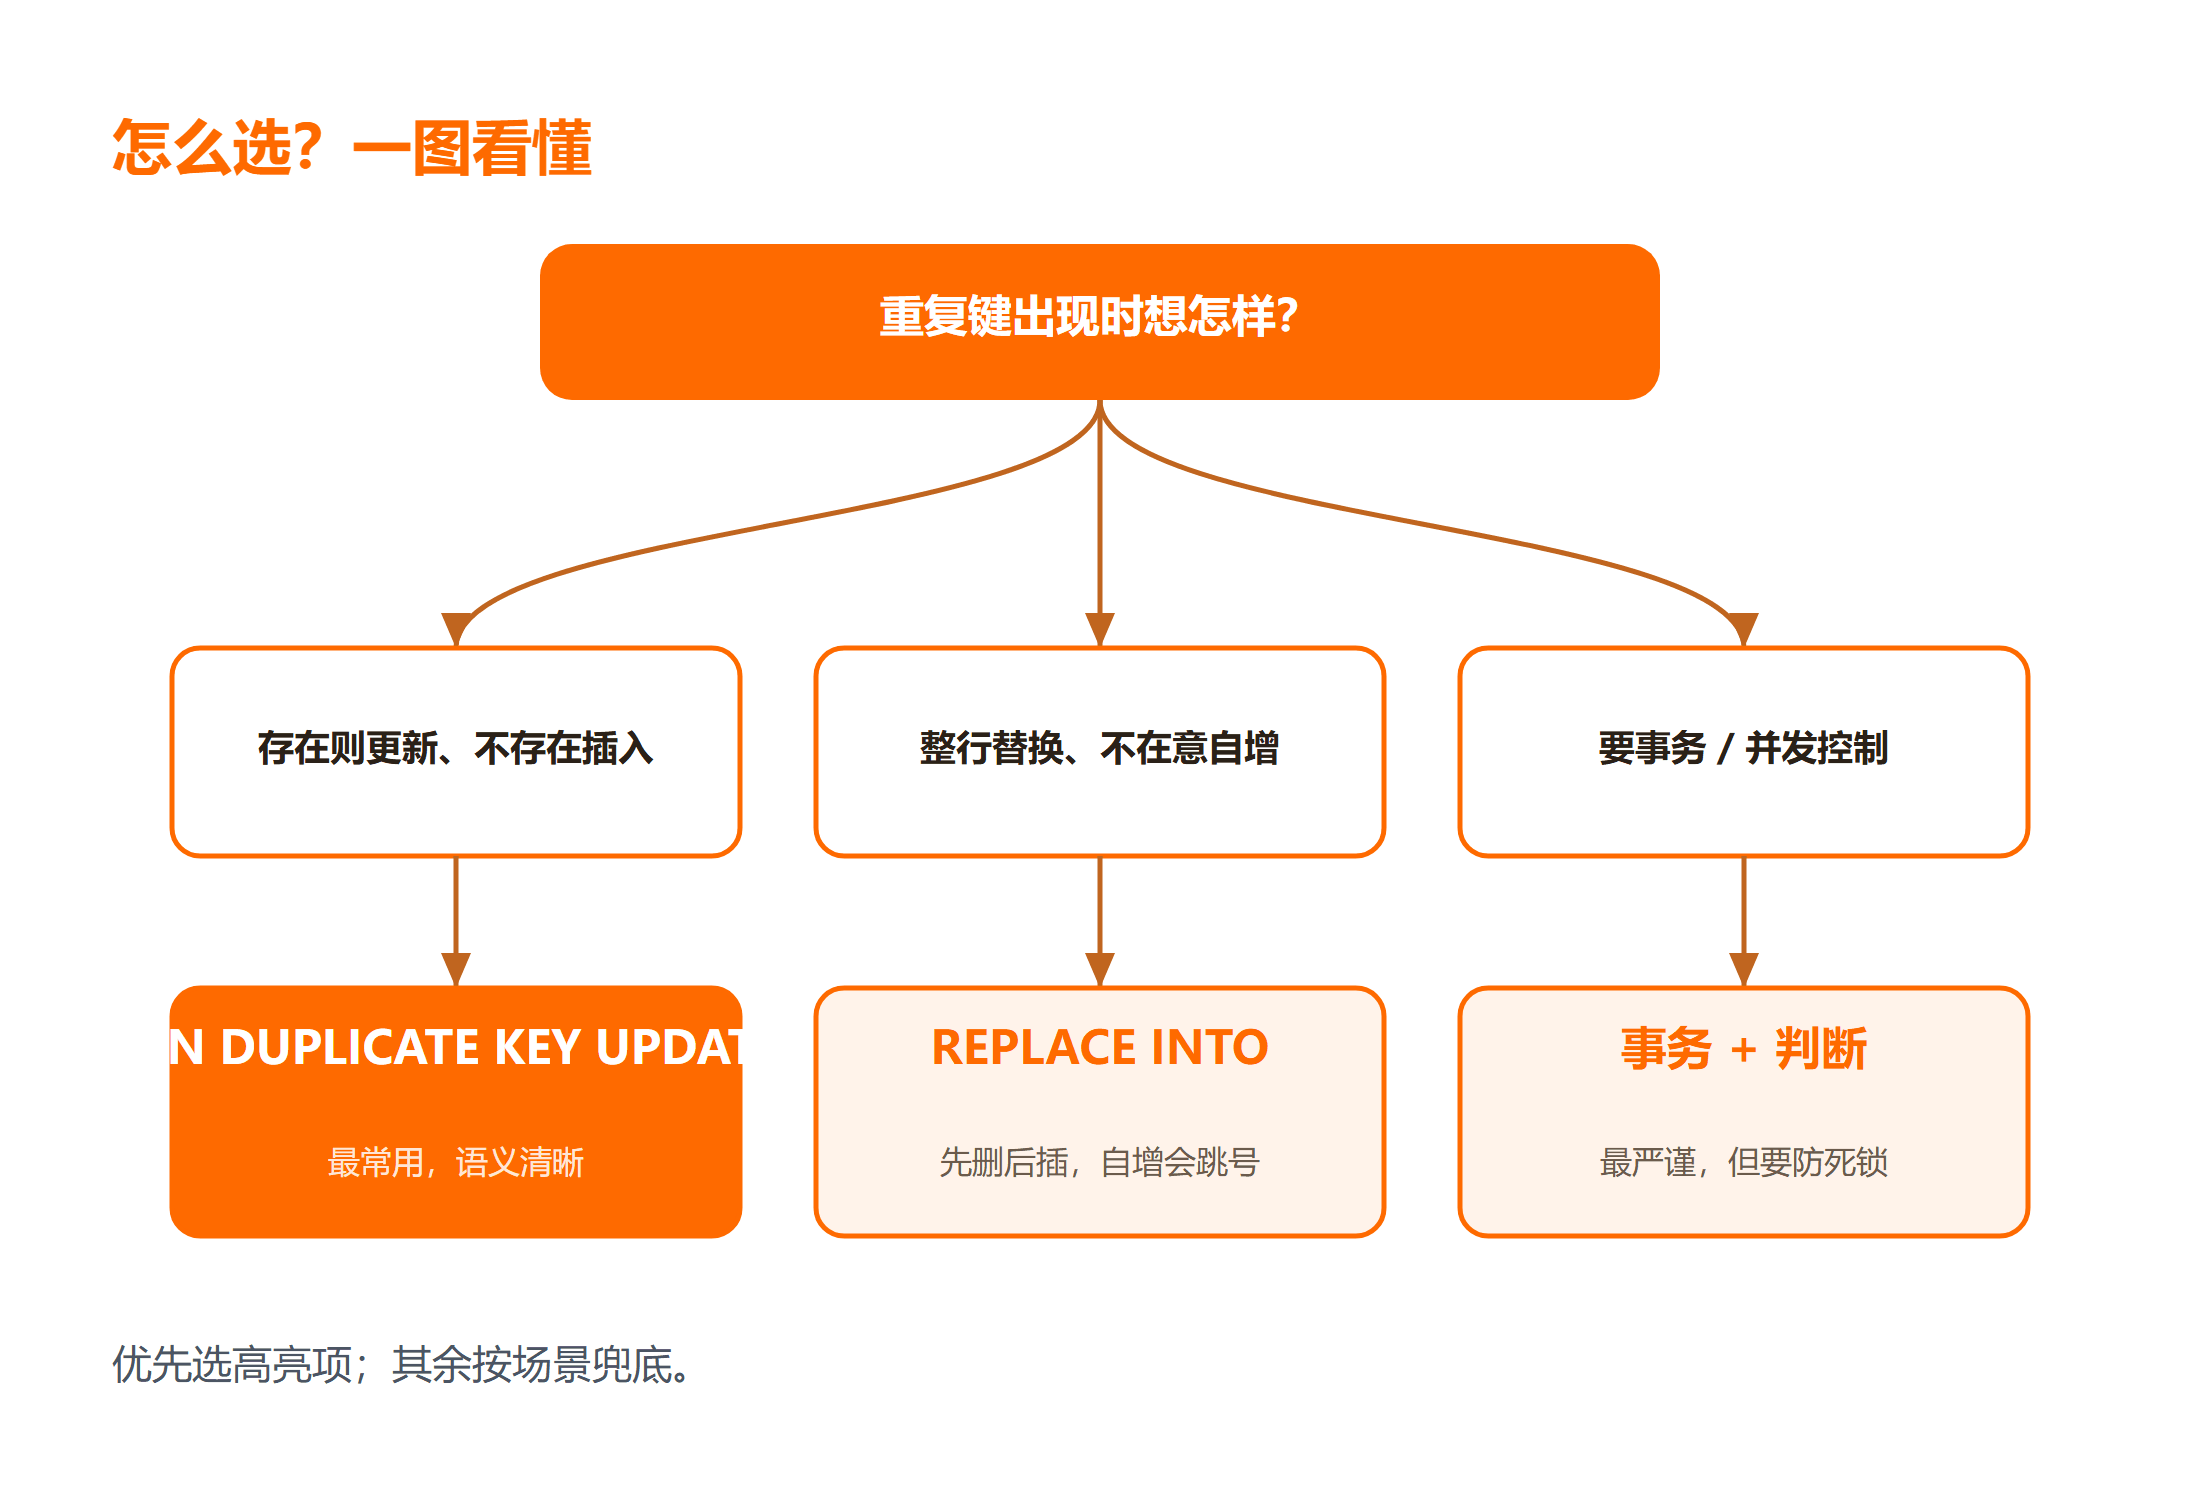
一张表先帮你定方案,10 秒内就能选对写法。下面这张方法选择表覆盖了绝大多数业务场景,也标出了不推荐的场景,避免你踩到 REPLACE 的副作用。
| 方式 | 适用场景 | 不推荐场景 | 推荐顺序 |
|---|---|---|---|
| INSERT ... ON DUPLICATE KEY UPDATE | 命中唯一键或主键时只更新部分列,保留其他列与行身份,性能高且原子 | 更新逻辑依赖跨表复杂条件、表上根本没有唯一约束 | 1(首选) |
| 先 SELECT 再 INSERT/UPDATE | 更新值要先查出来算、需要灵活分支判断、表暂无唯一键也能用 | 高并发单行写入、追求极致原子性能和最少往返 | 2(灵活) |
| REPLACE INTO | 必须整行替换、且不在乎自增 id 变化、无外键与触发器牵连 | 有外键、有触发器、自增 id 不能跳号、只想改一两列 | 3(兜底) |
结论再强调一次:mysql插入或更新 的完整语义是「存在则更新、不存在则插入」,最稳的实现是 INSERT ON DUPLICATE 这一族;REPLACE 只是看起来像 upsert,其实是删除再插入。真正严谨的 MySQL upsert 应该把「冲突时改哪些列」写清楚,而不是无脑整行替换。想系统学语法可先看 MySQL 教程,写代码时随手翻速查手册也很快。
二、环境与最小示例
下面用一张用户积分表建立直觉。注意:以下为说明性代码,未在本机执行;预期结果:首次执行插入一行 user_id=1001、score=10,再次执行把 score 累加为 20,且 id 与行身份保持不变。
-- 建一张用户积分表,user_id 作为唯一键,保证同一用户只有一行
CREATE TABLE user_score (
  id         INT PRIMARY KEY AUTO_INCREMENT,                       -- 主键自增,是行的唯一标识
  user_id    INT NOT NULL UNIQUE,                                  -- 业务唯一键,也是 upsert 的触发条件
  score      INT NOT NULL DEFAULT 0,                               -- 积分值,冲突时只更新这一列
  updated_at DATETIME DEFAULT CURRENT_TIMESTAMP
             ON UPDATE CURRENT_TIMESTAMP                          -- 命中更新时自动刷新时间,便于排查
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;                          -- InnoDB 支持事务与行锁,upsert 更稳

-- 最简 upsert:user_id=1001 不存在就插入,存在就把 score 加 10
INSERT INTO user_score (user_id, score)
VALUES (1001, 10)                                                 -- 先尝试插入这一行
ON DUPLICATE KEY UPDATE score = score + 10;                       -- 命中 user_id 唯一键冲突时改为累加
这个最小示例已经把 mysql插入或更新 的骨架讲完了:靠 UNIQUE 约束决定「是否存在」,靠 ON DUPLICATE KEY UPDATE 决定「存在时做什么」。如果你之前用应用层先查再写,现在可以用这一条语句把它变成单条原子操作,避免并发下重复插入。在数据库里运行这条语句验证 score 是否累加,配置好唯一键后再检查触发分支,确认更新行为符合预期。
三、方式一:INSERT ... ON DUPLICATE KEY UPDATE
这是最推荐的写法。它的触发前提是表上必须存在唯一索引或主键,否则永远只会插入、不会更新。冲突发生时,MySQL 只执行 UPDATE 子句里列出的列,没有列出的列保持原值,行本身(包括主键、创建时间)不变。
下面示例演示「签到活动」场景:同一用户每天一条记录,重复签到就累加签到天数并刷新最后签到时间。以下为说明性代码,未在本机执行;预期结果:第一次插入 sign_days=1,后续每次命中唯一键把 sign_days 加 1。
-- 建签到表,用 (user_id, sign_date) 联合唯一键锁定「一人一天一行」
CREATE TABLE user_sign (
  id        INT PRIMARY KEY AUTO_INCREMENT,                       -- 自增主键,行身份
  user_id   INT NOT NULL,                                         -- 用户 id
  sign_date DATE NOT NULL,                                        -- 签到日期
  sign_days INT NOT NULL DEFAULT 1,                               -- 连续签到天数,冲突时累加
  UNIQUE KEY uk_user_date (user_id, sign_date)                    -- 联合唯一键,upsert 的冲突判定依据
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;                          -- 用 InnoDB 保证行锁与一致性

-- 用户 1001 在 2026-09-23 签到:不存在就建首签记录,存在就天数 +1
INSERT INTO user_sign (user_id, sign_date, sign_days)
VALUES (1001, \\\'2026-09-23\\\', 1)                                    -- 尝试插入首签(sign_days 默认 1)
ON DUPLICATE KEY UPDATE
  sign_days = sign_days + 1;                                      -- 命中 uk_user_date 时只把天数加 1
几个关键点:第一,ON DUPLICATE KEY UPDATE 后面的列用的是「表中当前值」,所以 sign_days = sign_days + 1 是累加而非覆盖;第二,如果表上有多个唯一键,只要任意一个冲突就会触发更新;第三,它不会重置未列出的列,这正是它比 REPLACE 安全的地方。想深入语法细节,搭配 MySQL 速查手册 的章节一起看会更顺。
四、方式二:REPLACE INTO
REPLACE INTO 看起来也是「存在则更新、不存在则插入」,但机制完全不同:它先尝试插入,若碰到唯一键或主键冲突,就先删除旧行、再插入新行。这意味着整行被替换,自增主键会变、创建时间会变、依赖该行的外键会被级联删除、DELETE 触发器会被真正触发。
下面示例对比 INSERT ON DUPLICATE 与 REPLACE 的差异。以下为说明性代码,未在本机执行;预期结果:REPLACE 之后该行 id 从 1 变成 2,原 id=1 那行已不存在。
-- 沿用上面的 user_score 表,当前已有一行:id=1, user_id=1001, score=10

-- 用 REPLACE 整行替换 user_id=1001 的记录
REPLACE INTO user_score (user_id, score)
VALUES (1001, 50);                                               -- 尝试插入;命中 user_id 唯一键

-- 上一步内部实际发生:DELETE id=1 那一行,再 INSERT 新行(新 id 自增为 2)
-- 所以执行后查到的行是 id=2, user_id=1001, score=50,原 id=1 已消失
SELECT id, user_id, score FROM user_score WHERE user_id = 1001;  -- 验证:返回 id=2 而非 1
副作用清单要记牢:其一,自增 id 会跳号,因为旧行被删、新行重新分配 id,做数据去重写入时若下游用 id 关联就会断链;其二,若表上有 DELETE 触发器,REPLACE 会真实地触发它,可能误删关联数据;其三,若被外键引用,删除旧行可能级联删掉子表记录。所以 REPLACE 只在「整行都要换、且不在乎身份」时兜底使用,日常 mysql插入或更新 请优先方式一。
五、方式三:先 SELECT 再 INSERT/UPDATE 及排错
当更新值需要先查出来算、或表暂时没有唯一键时,可以用「应用层先 SELECT 判断,再决定 INSERT 或 UPDATE」的写法。它最灵活,但并发下要小心。下面示例演示用事务 + 行锁避免重复插入。以下为说明性代码,未在本机执行;预期结果:并发两个请求只有一个插入成功,另一个走更新分支,不会出现两行同 user_id。
-- 开启事务,并对要判定的行加排他锁,防止两个请求同时读到「不存在」
START TRANSACTION;                                               -- 开启事务,保证读和写原子

SELECT id, score FROM user_score
WHERE user_id = 1001 FOR UPDATE;                                -- 加行锁,其他事务需等待,避免并发竞态

-- 若上一步没查到,就插入;查到了就更新(下面以查到为例)
UPDATE user_score SET score = score + 10 WHERE user_id = 1001;  -- 查到后直接更新,省一次插入往返

COMMIT;                                                          -- 提交事务,释放行锁
这种方式把「是否存在」的判断权交给你,因此能处理复杂分支;代价是多了一次 SELECT 往返,高并发写场景要加上 FOR UPDATE 或唯一键兜底,否则会出现并发重复插入。
排错表覆盖四个最常见现象:
| 现象 | 常见原因 | 修复方向 |
|---|---|---|
| 死锁(Deadlock found) | 多个事务以不同顺序对多行加 FOR UPDATE,形成循环等待 |
统一加锁顺序、缩小事务范围、降低单事务持锁时间 |
| 自增 id 跳号 | 用了 REPLACE 先删后插,或事务回滚释放了预占 id | 改用 INSERT ON DUPLICATE KEY UPDATE;勿用 REPLACE 做普通更新 |
| 唯一键缺失不触发更新 | 表上没有主键/唯一索引,ON DUPLICATE 永远走插入 | 补建唯一键或主键,让冲突能被检测到 |
| 并发重复插入 | 先 SELECT 再 INSERT 没加锁,两个请求同时读到「不存在」 | 加 FOR UPDATE 行锁,或在数据库层补唯一键做最后兜底 |
总结
mysql插入或更新 的本质是「存在则更新、不存在则插入」,选型记住三句话:日常首选 INSERT ON DUPLICATE KEY UPDATE,它只在唯一键冲突时更新指定列、最安全也最原子;REPLACE INTO 是兜底,只用于整行替换且能接受删后插的副作用;先 SELECT 再写最灵活,但必须加锁或补唯一键防并发重复。把「数据去重写入」理解成保留行身份的更新,而不是删除重建,就能避开绝大多数线上事故。真正严谨的 MySQL upsert 永远把「冲突时改哪些列」写清楚。
延伸学习
常见问题
Q:INSERT ON DUPLICATE KEY UPDATE 和 REPLACE INTO 到底差在哪?
核心差在「是否删行」。前者命中冲突时只执行 UPDATE 子句、保留行身份与未列列;后者先删旧行再插新行,自增 id、创建时间、触发器、外键级联都会受影响。日常 mysql插入或更新 用前者,整行替换才考虑后者。
Q:为什么我的 ON DUPLICATE KEY UPDATE 从来不触发更新,只在一直插入?
大概率是表上没有主键或唯一索引。该语法靠唯一约束判定「是否存在」,冲突检测不到就会一直插入。去补一个 UNIQUE KEY(或联合唯一键),更新分支才会生效。
Q:高并发下先 SELECT 再 INSERT 出现了两行相同 user_id,怎么根治?
两个请求同时读到「不存在」就会都插入。根治办法有两层:应用层对判定行加 SELECT ... FOR UPDATE 行锁;数据库层补唯一键做最后兜底,即使代码漏判也会因唯一约束报错而失败,保证数据去重写入 不出重行。