 TRAE-AI编程

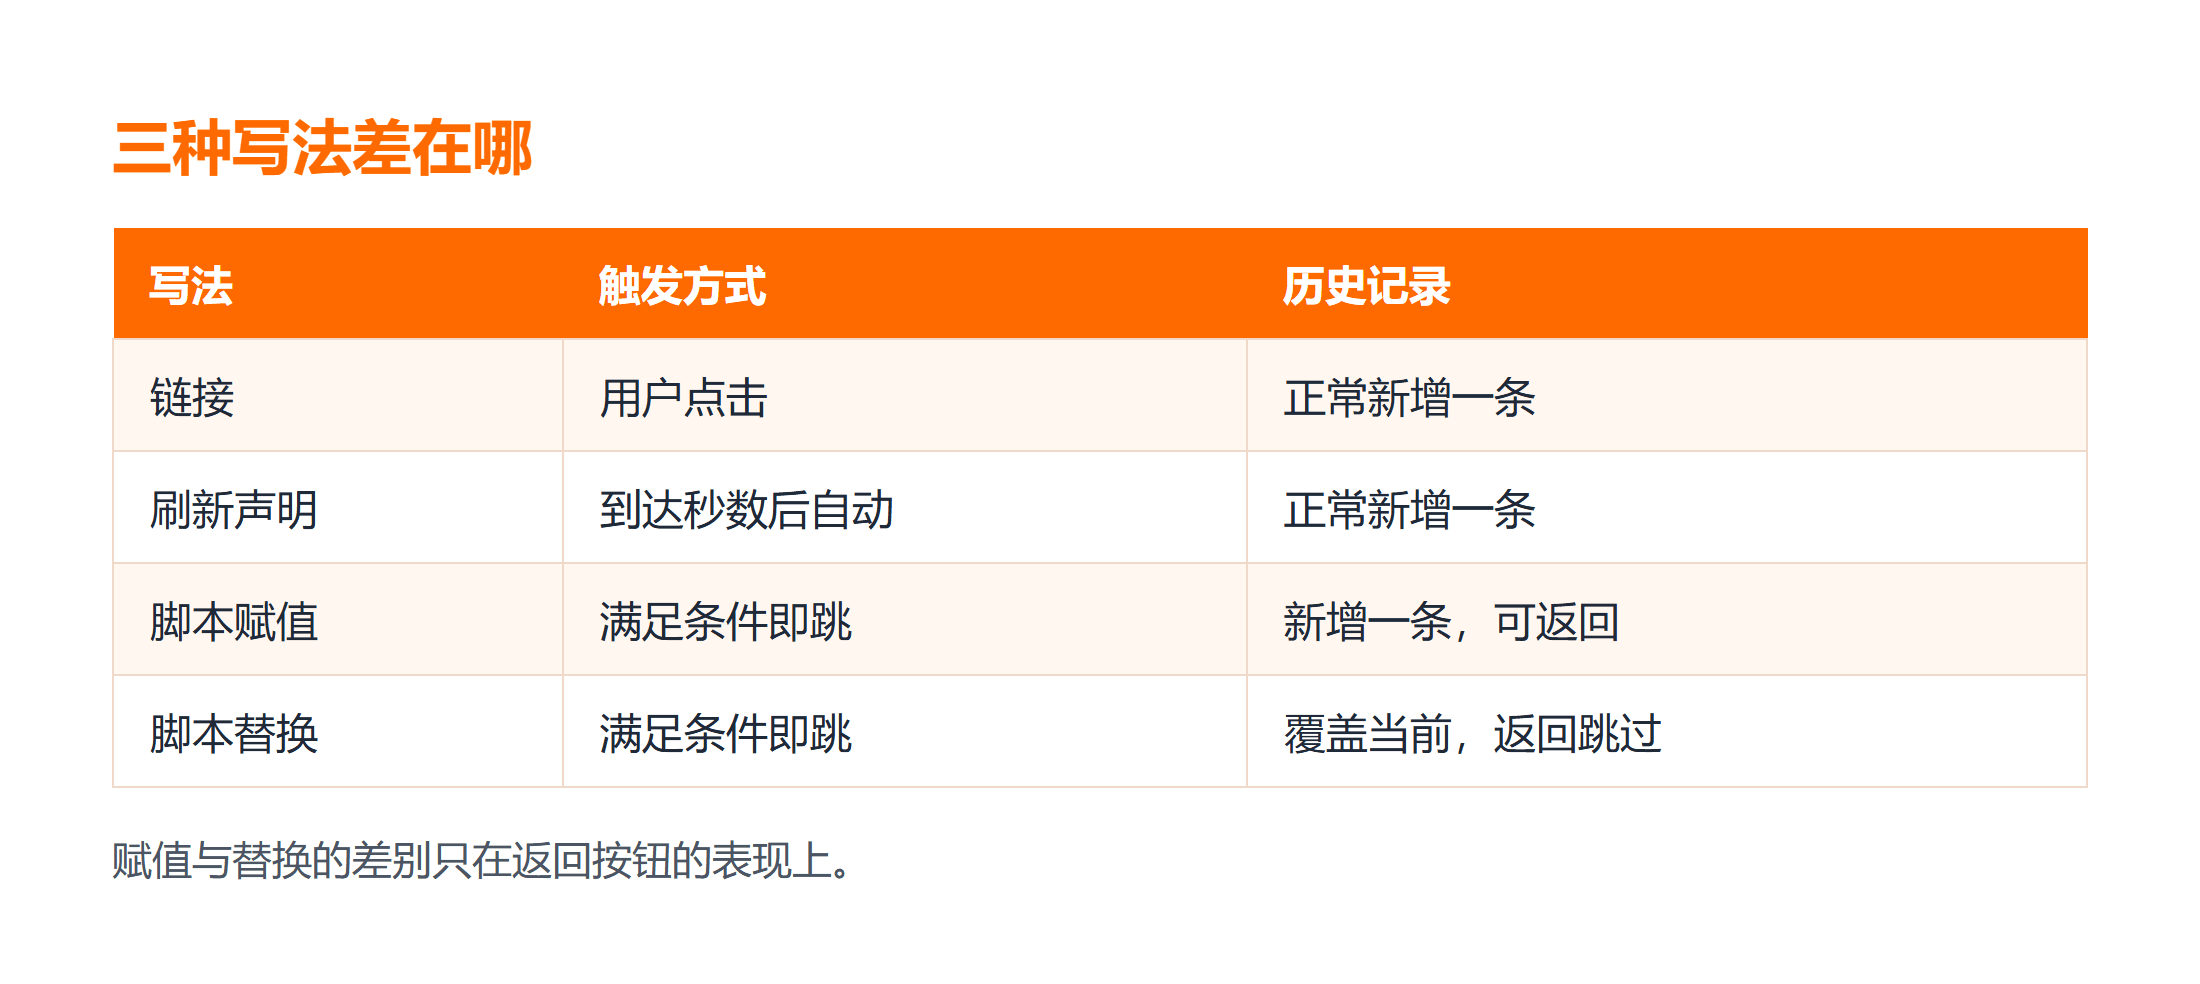
先给结论:HTML 页面跳转只有三类写法——链接由用户点击触发、页面头部的刷新声明做延迟跳转、脚本里给地址赋值做条件跳转。选哪种不看喜好,看三件事:要不要用户参与、要不要延迟、以及跳走之后还能不能退回来。
新手最容易的误用是把这三种混着用:既写了刷新声明,又在脚本里再跳一次,结果用户点返回时被反复弹回原页面。
本文把三种写法的最小示例、各自默认值、以及四个高频边界问题讲清楚。示例为通用浏览器行为,不涉及任何框架。
先看结论
- 页面跳转要用户点就用链接:语义最清楚,也最利于被搜索引擎理解。
- 要延迟就用刷新声明:写在页面头部,秒数是必填项,省略等于立即跳转。
- 要条件判断就用脚本:能按登录状态分流,也能控制是否留下历史记录。
一、三种写法的最小示例
把问题定死:一个活动结束后要跳到新地址,同时保留一个手动入口。页面跳转的三种写法,就对应三种不同的触发条件。
第一种是链接,由用户点击触发:
<a href="https://example.com/new" target="_blank" rel="noopener">
  前往新地址
</a>
这段做的是给一个可点击的入口,新窗口打开并断开来源引用。预期结果(未在本机执行):点击后新标签页打开目标地址。
第二种是页面头部的刷新声明,用来做延迟跳转:
<meta http-equiv="refresh" content="3;url=https://example.com/new">这段做的是声明三秒后自动跳走,这种写法常被称为 meta refresh。这里的秒数是必填的,写成只给地址不给秒数会被当作立即跳转,不同浏览器的处理并不完全一致。
第三种是脚本里的地址赋值,可以按条件分流:
<script>
  if (!localStorage.getItem('token')) {
    window.location.replace('/login');
  }
</script>
这段做的是未登录时用替换方式跳走。关键点在方法选择:赋值地址会留下一条历史记录,用替换则不会,用户点返回的表现完全不同。
标签属性记不清时,查 HTML 参考手册 最稳妥。
二、默认值与边界
页面跳转的几个默认值都藏在细节里,逐条确认一遍能省掉很多返工。
2.1 刷新声明的秒数不能省
秒数和地址之间用分号隔开,顺序写反会失效。秒数为零时等于立即跳转,但不同浏览器对零值的处理有差异,建议至少写一秒。
2.2 赋值与替换的历史差异
给 location.href 赋值会新增一条浏览器历史记录,用户点返回能回到上一页;用替换则是覆盖当前记录,返回会跳到更早的页面。做登录后回跳时这个差异直接影响体验。
2.3 新窗口要断开来源引用
带新窗口属性打开外部地址时,目标页面能读到来源信息。加上关系声明可以切断这条链路,也是安全上的默认动作。写法细节可以对照 HTML 速查手册。
三、四个高频坑
页面跳转的坑基本都出在触发时机与历史记录上,下面四个最高发。
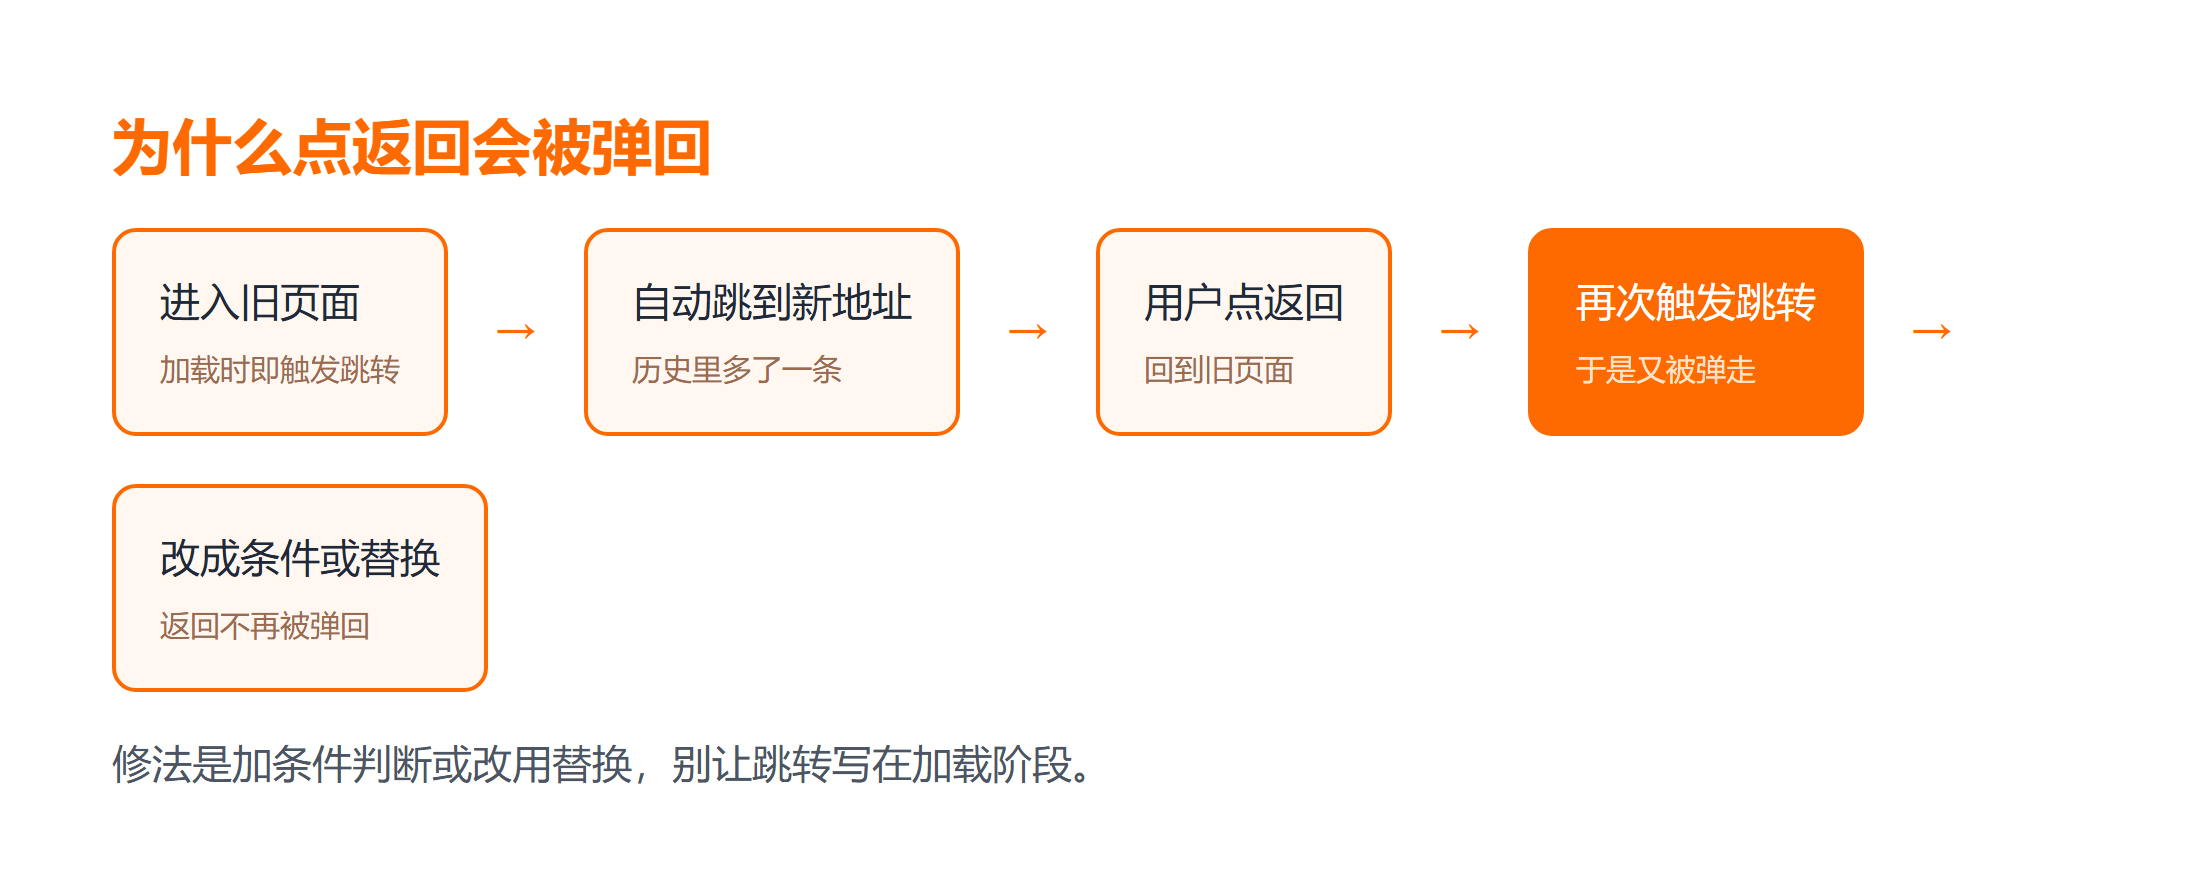
3.1 返回时被反复弹回
因为跳转写在了页面加载时,返回后又触发一次。修法是加条件判断,或者用替换方式避免留下历史记录。
3.2 页面跳转被当成作弊
纯自动跳转对搜索引擎不友好。有实际内容要展示时,优先给一个可点击的入口,把自动跳转作为兜底。
3.3 地址写成了相对路径
相对路径以当前页面为基准,目录一变就跳错。对外跳转一律写完整地址。
3.4 跳转前没给用户提示
延迟跳转至少要告诉用户还有几秒,否则会被当成页面出错了。写法细节可以对照 HTML 教程 里的头部章节确认。
3.5 单页应用里别让原生跳转抢路由
用了前端路由的项目,页面跳转最好走路由自身的导航方法。直接给地址赋值会跳过路由、整页重新加载,用户在前端页面里点一下就丢了已加载的状态。需要跳到外部站点时才用原生地址赋值,站内导航交给路由处理。
四、验证清单
4.1 逐个检查触发条件
确认链接是点击触发、刷新声明是延迟触发、脚本是按条件触发,三者没有互相叠加。
4.2 重点测返回按钮
跳走之后点返回,观察是否回到预期页面,这是最容易出问题的一环。
4.3 换目录再验一遍
把页面挪到子目录,确认相对地址没有失效。
4.4 验证清单
- 检查:确认页面跳转只有一处生效,没有重复叠加
- 运行:等待延迟结束,观察是否自动跳走
- 预期:跳到目标地址,并给出倒计时提示
- 失败:返回时被弹回,说明跳转写在了加载阶段
- 修复:改成替换方式,或加条件判断
- 验证:点击返回按钮两次,确认不会再被弹回
总结
页面跳转不难,难的是想清楚触发方式、延迟与历史记录这三件事。把这三件定下来,写法自然就确定了。
三条要点带走:
- 用户触发用链接,延迟用刷新声明,条件分流用脚本;
- 赋值留下历史记录,替换不留,登录回跳场景尤其要注意;
- 自动跳转要配提示与可点击入口,别让用户以为是页面坏了。
下一步建议把跳转逻辑集中在一处,避免多处叠加。属性细节可以对照 HTML5 教程 再核一遍。
常见问题
Q:延迟跳转的秒数可以省略吗?
A:不建议。省略后不同浏览器的处理不一致,有的立即跳转有的不跳。明确写上秒数最稳。
Q:为什么点了返回又被弹回来?
A:跳转逻辑写在页面加载阶段,返回后再次触发。加条件判断,或者用替换方式跳走。
Q:赋值地址和替换有什么区别?
A:赋值会新增一条历史记录,替换是覆盖当前记录。登录后不想让用户退回登录页,就用替换。
Q:页面跳转会影响收录吗?
A:纯自动跳转体验差也不利于收录。有内容要展示时,务必同时保留一个可点击的入口。
Q:相对路径什么时候会出错?
A:基准是当前页面地址,页面挪到子目录后就会跳错。对外跳转一律写完整地址。
延伸学习
想把这个知识点补扎实,可以按这个顺序来:
- 想把标记基础补系统,HTML入门课程(含HTML5) 可以跟一遍;
- 读一篇相关笔记 HTML5 跳转小程序写法,看别人踩过的坑;
- 想随手验证一段代码,用 HTML 在线运行 跑一遍最快。