 TRAE-AI编程

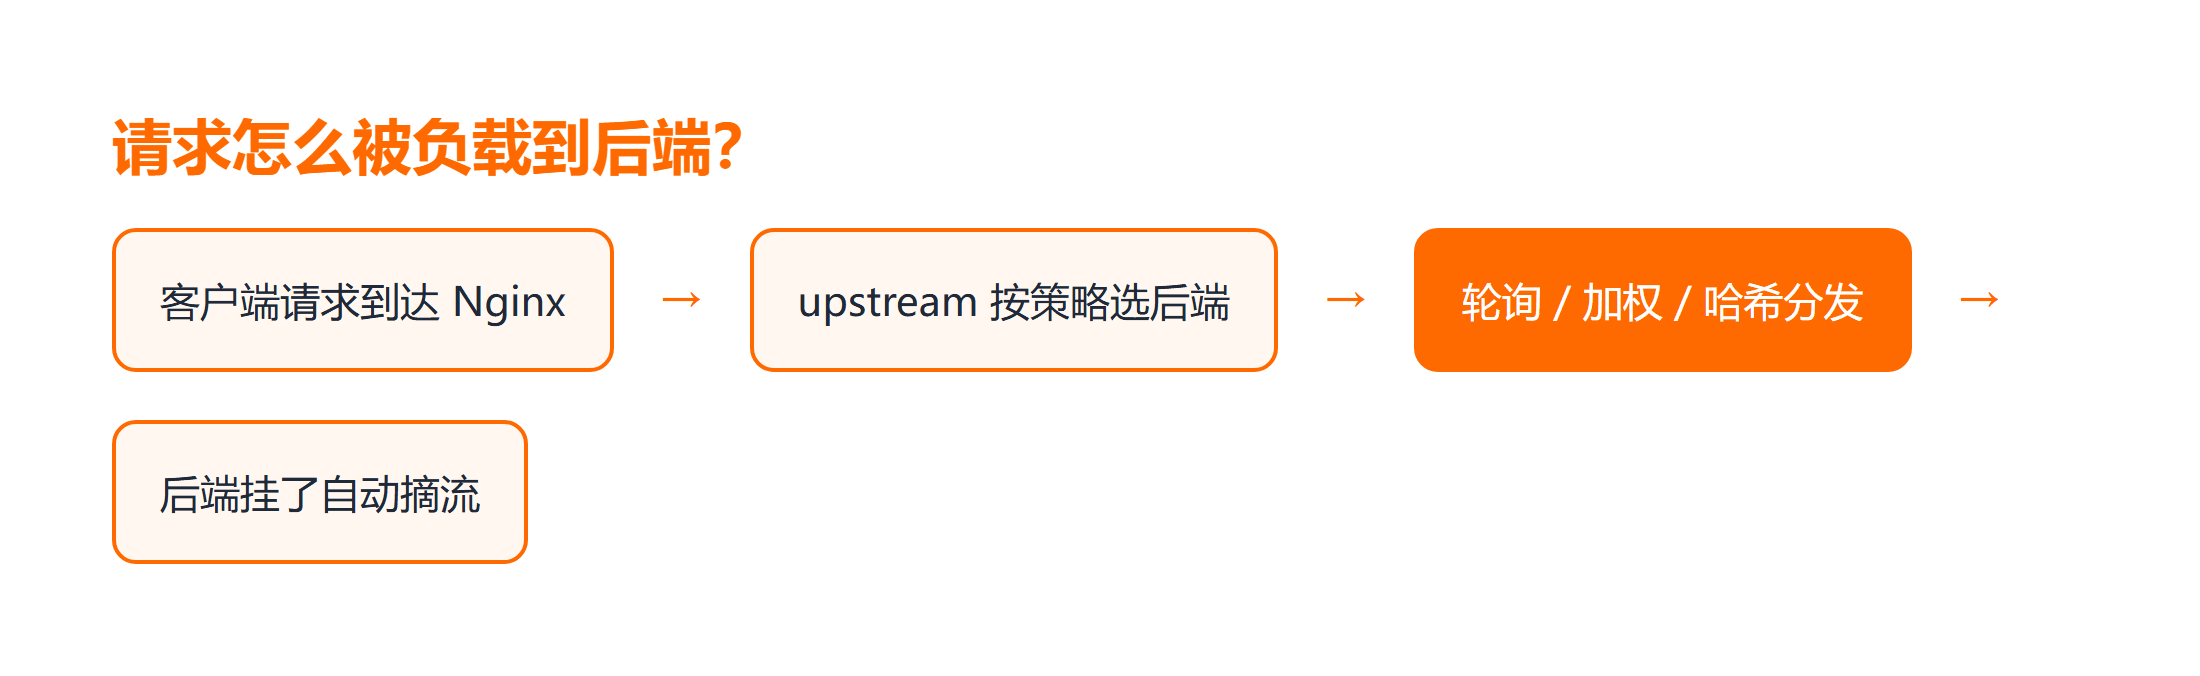
你后端只挂一台机器时,流量一高就顶不住。核心答案一句话:Nginx 负载均衡在 upstream 块里定义一组后端,再用轮询、加权轮询、IP 哈希、最少连接四种策略把请求分发出去;配好健康检查,某台挂了能自动摘流。本文以 Nginx 稳定版为例,讲清四种负载均衡策略的写法、适用场景,以及 upstream 健康检查和会话保持这两个上线前必须想清楚的点。看完你不仅能配出可用的负载均衡,还能按业务特征选对分发策略。今天这篇文章,编程狮就把这块讲透。
先看结论
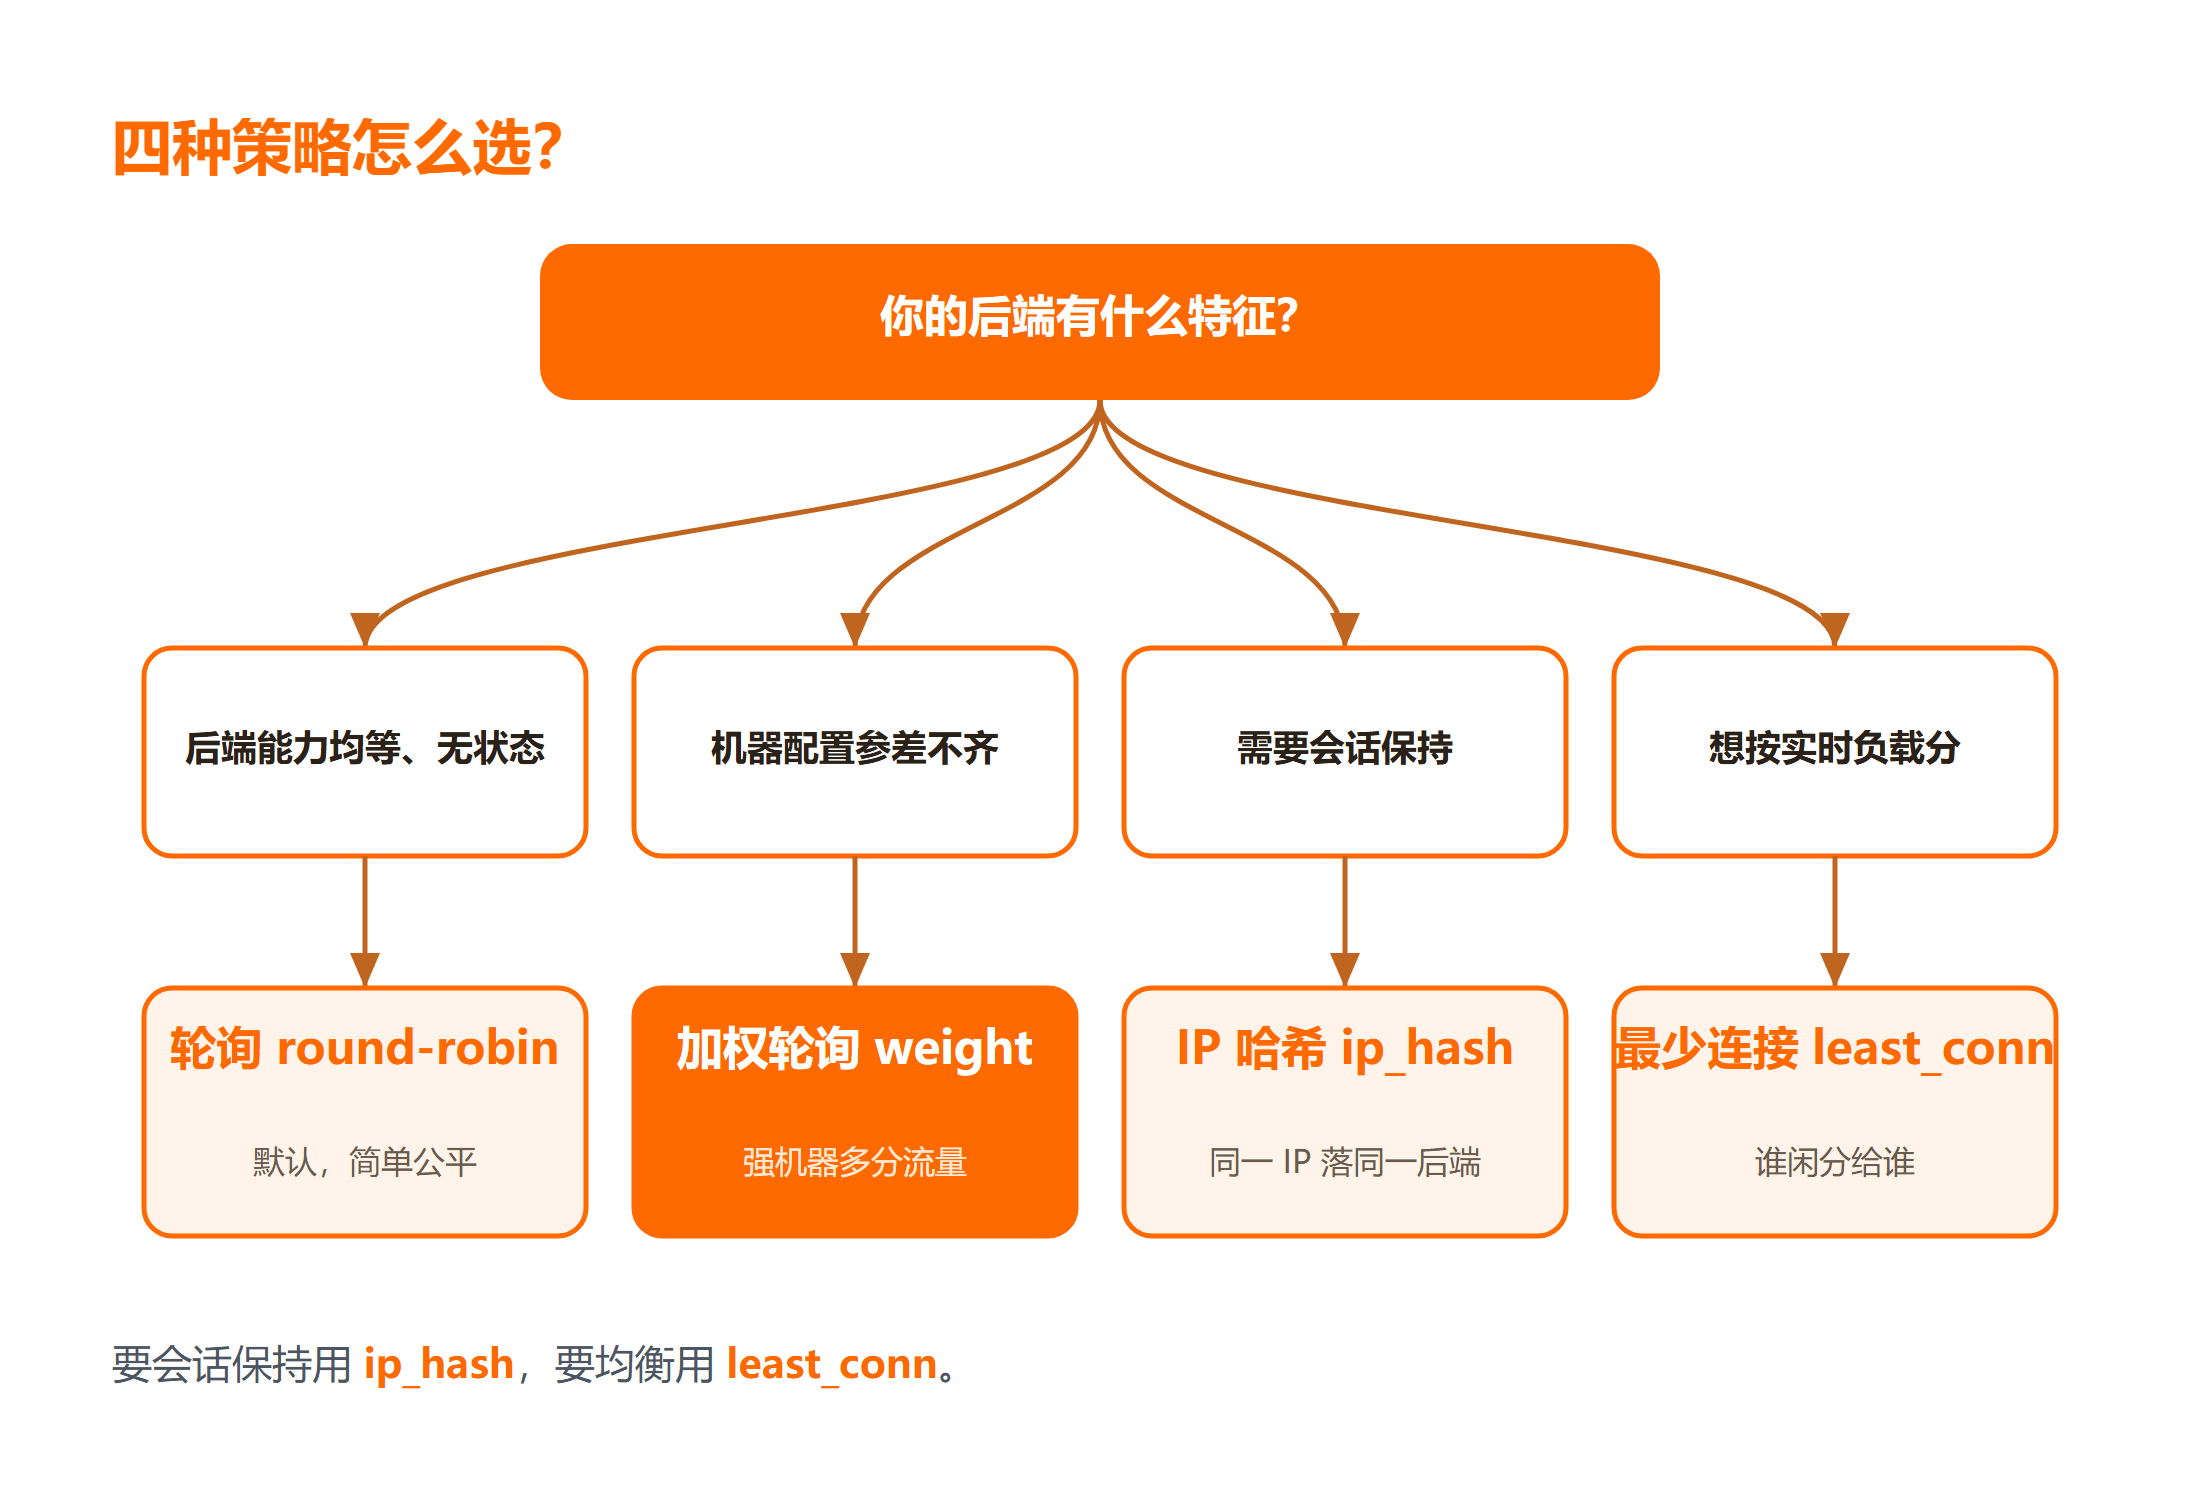
四种策略对应不同的后端特征,先看清机器再选:
| 你的场景 | 首选策略 | 一句话理由 |
|---|---|---|
| 后端性能一致、无状态 | 轮询 | 默认最简单 |
| 机器配置不均 | 加权轮询 | 强机器多分流量 |
| 需要同一用户落同一台 | IP 哈希 | 保持会话不串 |
| 请求耗时差异大 | 最少连接 | 谁闲分给谁 |
一、Nginx 负载均衡到底在做什么
单台后端服务器有性能天花板,流量一大就会成为瓶颈。负载均衡的本质是把请求分摊到多台后端上,让整体吞吐随机器数量线性增长,同时某台故障时还能把流量切走。Nginx 在反向代理的基础上,用 upstream 块把多台后端组织成一组,再决定怎么分请求。要系统学基础,可以先过一遍 Nginx 入门指南,把 upstream 的配置结构铺平。
负载均衡和反向代理是递进关系:反向代理解决「请求转给谁」,负载均衡解决「转给哪一台」。理解了这一层,后面的策略才好选。
⚠️ 注意:把多台后端放进 upstream 后,不要忘了配健康检查。否则一台机器宕机,Nginx 仍会把请求转过去,表现为一部分请求稳定失败,这种故障很难从应用日志里直接看出来。
二、upstream 块:把后端组织成一组
负载均衡的第一步,是在 Nginx 里声明一个 upstream 块,把后端地址列进去。最简单的轮询写法长这样:
upstream backend {
    server 10.0.0.1:8080;
    server 10.0.0.2:8080;
}

server {
    location / {
        proxy_pass http://backend;
    }
}
上面这段做了「定义一个叫 backend 的 upstream,包含两台后端,再把根路径的流量转发到这组后端」。预期结果是请求被轮流打到 10.0.0.1 和 10.0.0.2 上。upstream 名字会代替具体地址出现在 proxy_pass 后面,这就是负载均衡和单点反代的唯一区别。
# 给机器标不同权重,强机器多分流量
upstream backend {
    server 10.0.0.1:8080 weight=3;
    server 10.0.0.2:8080 weight=1;
}
权重越大,分到的请求越多,这正是加权轮询的核心。
三、四种负载均衡策略怎么选
第一种是轮询,默认策略,把请求依次轮流分给每台后端,适合机器性能一致、服务无状态的场景。第二种是加权轮询,给不同机器配不同 weight,强机器多扛,适合配置不均的集群。第三种是 IP 哈希,按客户端 IP 算哈希决定落点,同一用户始终打到同一台,适合没做共享会话、需要会话保持的业务。第四种是最少连接,谁当前连接少就分给谁,适合单请求耗时差异大的场景。想从原理上理解负载均衡的收益,可以看 深入解析负载均衡。
| 策略 | 适用场景 | 优点 | 代价 |
|---|---|---|---|
| 轮询 | 同配无状态 | 默认零配置 | 不区分机器强弱 |
| 加权轮询 | 配置不均 | 强机多分 | 需手动估权重 |
| IP 哈希 | 需会话保持 | 用户不串机 | 机器变动会重分布 |
| 最少连接 | 耗时差异大 | 谁闲分给谁 | 需维护连接计数 |
踩坑清单
- 现象:加机器后流量没均分;原因:没配权重或用了 IP 哈希;修复:按场景换成轮询或加权轮询。
- 现象:一台挂了仍有请求失败;原因:缺健康检查;修复:加
max_fails与fail_timeout自动摘流。 - 现象:用户登录状态频繁掉;原因:请求被轮询到不同机器;修复:改 IP 哈希或把会话共享到 Redis。
- 现象:权重不生效;原因:weight 写在 server 行位置不对;修复:确认 weight 紧跟地址且 upstream 语法正确。
四、健康检查与会话保持:上线前必查
负载均衡能不能真扛住故障,关键在健康检查。Nginx 商业版有主动健康检查,开源版靠 max_fails 和 fail_timeout 做被动检查:某台后端在 fail_timeout 时间内失败 max_fails 次,就被暂时摘出,恢复后再慢慢放回。会话保持则是另一个维度——如果应用没把会话集中存储,用轮询就会让用户每次请求落到不同机器而掉登录,这时要么改 IP 哈希,要么把会话迁到 Redis 这类共享存储。两者配好,负载均衡才算真正可用。
总结
Nginx 负载均衡的选法很清晰:先声明 upstream 把后端编成一组,再按机器特征选轮询、加权轮询、IP 哈希或最少连接四种策略,最后补上健康检查和会话保持。记住最关键的一课:不配健康检查的负载均衡是「假高可用」,一台宕机仍会稳定失败,上线前务必用 curl 对每台后端逐一验证。
要点带走:
- upstream 块是负载均衡和单点反代的分界点;
- 无状态服务用轮询,不均集群用加权轮询,要会话保持用 IP 哈希;
- 健康检查必配,否则故障机器仍会收到流量。
下一步可以动手给 upstream 加上权重与健康检查,再用 curl 逐一打后端,直观感受流量分发与故障摘流。
动手验证清单
下面这组动作帮你在本机验证负载均衡配置,按你自己的环境执行,结果以实际输出为准(本文配置未在作者本机执行,仅给出预期形态):
- 安装:本机装好 Nginx,并起两台监听不同端口的测试服务;
- 配置:在 nginx.conf 写 upstream 块,列出两台后端地址;
- 命令:执行
nginx -t检查配置语法; - 运行:执行
nginx -s reload平滑加载; - 检查:用
curl连续请求多次,观察后端是否交替响应; - 预期:轮询下两次请求分别落到不同后端;
- 失败:若只打到一台,检查 upstream 是否漏写或权重异常;
- 修复:补齐 server 行后重新 reload 验证;
- 验证:停掉一台后端,确认剩余流量自动摘流不报错。
延伸学习
想把 Nginx 配置补完整,可以顺着这条线:
- 先过一遍 Nginx 快速入门指南,把基础铺平;
- 看实例读 Nginx 反向代理实战;
- 想深入负载技术再读 IPVS 高性能负载均衡。
常见问题
Q:轮询和加权轮询该怎么选?
A:后端机器配置一致、服务无状态时直接用默认轮询,零配置。如果机器强弱不一,就给强机器更高的 weight,让它按权重多分流量,避免弱机器先被打满。
Q:为什么加了负载均衡用户还会掉登录?
A:因为默认轮询会把同一用户的请求打到不同机器,而会话只存在单台内存里。解决办法是要么改用 IP 哈希让同用户落同一台,要么把会话集中到 Redis 这类共享存储。
Q:后端一台宕机,负载均衡会自动跳过吗?
A:开源版默认不会主动探测,要靠 max_fails 和 fail_timeout 做被动检查:某台在指定时间内失败到阈值就被暂时摘出。商业版则有更主动的健康检查指令,能更快发现并隔离故障机器。