TRAE-AI编程

用 AI 编程助手写代码时,很多人发现账单涨得比代码行数快得多。核心答案先放前面:Token 消耗主要花在「每次请求都重复发送的大段上下文」和「没有压缩的会话历史」上,而不是你亲手写的那几行代码。最快的省钱办法只有三招——精简上下文窗口、压缩复用会话摘要、用小模型做路由与校验。本文基于常见 CLI 形态与官方计费说明整理,覆盖这三种做法,并附横向对比和踩坑清单。看完你不仅能把 Token 消耗压下来,还能理解为什么每次都要重发整段上下文。今天这篇文章,编程狮就把这块讲透。
一、先搞清楚 Token 到底花在哪
用一句判断句给出定义:Token 消耗指的是你每次调用大模型时,输入与输出被切分成的最小计费单元总量,它直接决定 API 账单金额。
再用一个贴近生活的比喻降低理解门槛:把大模型想象成一个记性很差但收费很贵的同事,你每交代一次任务,都得把完整的背景资料从头念一遍他才肯动手;你念得越多,收费越高。这正是 Token 消耗的大头,和你的代码水平几乎没有关系。
1.1 触发条件
具体说明什么情况下会遇到高 Token 消耗:你把一个 800 行的文件整段贴进对话、开着十几个文件的「全仓库检索」插件、或者让助手在每次对话里都重写整个项目。只要单次请求的上下文体积降不下来,Token 消耗就压不住。
⚠️ 注意:不要把含密钥的配置文件整段发给云端助手,先脱敏再提问,避免凭证泄露。
1.2 常见误解
指出读者最容易搞错的一点:以为省钱就是「少问问题」。其实少问问题没用,真正该砍的是每次请求里重复发送的冗余上下文。想系统理解上下文窗口与记忆机制,可以先看 Codex 记忆管理教程 的基础章节,把「记忆」和「每次发送的上下文」区分开。
二、方案一:精简上下文,只喂必要信息
先说这个方案适合谁、代价是什么,再给步骤。它适合所有「助手读整文件」的场景,代价是你需要先想清楚真正相关的是哪几段。
- 第一步,只贴出错函数和调用栈,而不是整个文件;
- 第二步,用精确行号引用代替整文件粘贴;
- 第三步,把不相关的历史对话清空,再开新会话。
# 只把报错相关片段发给助手,而不是整仓库
sed -n '40,80p' src/parser.py | codex -q "这个解析函数为什么在空输入时报错?"
上面这段做的是把 parser.py 的第 40 到 80 行喂给 Codex 提问。运行后你应该看到它只针对这几行给出解释,而不是把你整个项目都读一遍,预期 Token 消耗能降一个数量级。检查本地是否装好了对应 CLI 并确认当前目录是项目根目录,再执行这类命令;如果想深入理解模型如何计费与选型,可以对照 Codex 模型选择教程。
三、方案二:压缩会话历史,复用摘要
说明与方案一的取舍差异。方案一只治「单次请求冗余」,方案二治「多轮对话越聊越贵」。做法是在长会话里定期让助手生成一段摘要,下一轮只发摘要加新问题,而不是把整段历史再发一遍。
| 环境 | 做法 | 说明 |
|---|---|---|
| 本地 CLI | 手动让助手输出 summary: 段落 |
简单可控 |
| 脚本调用 | 把上轮 summary 存成文件,下轮读取 |
适合自动化 |
| IDE 插件 | 开启上下文压缩选项 | 由工具托管 |
💡 小提示:摘要要包含「已做决策」和「未解决项」,否则下一轮又会重复探索。
四、方案三与横向对比
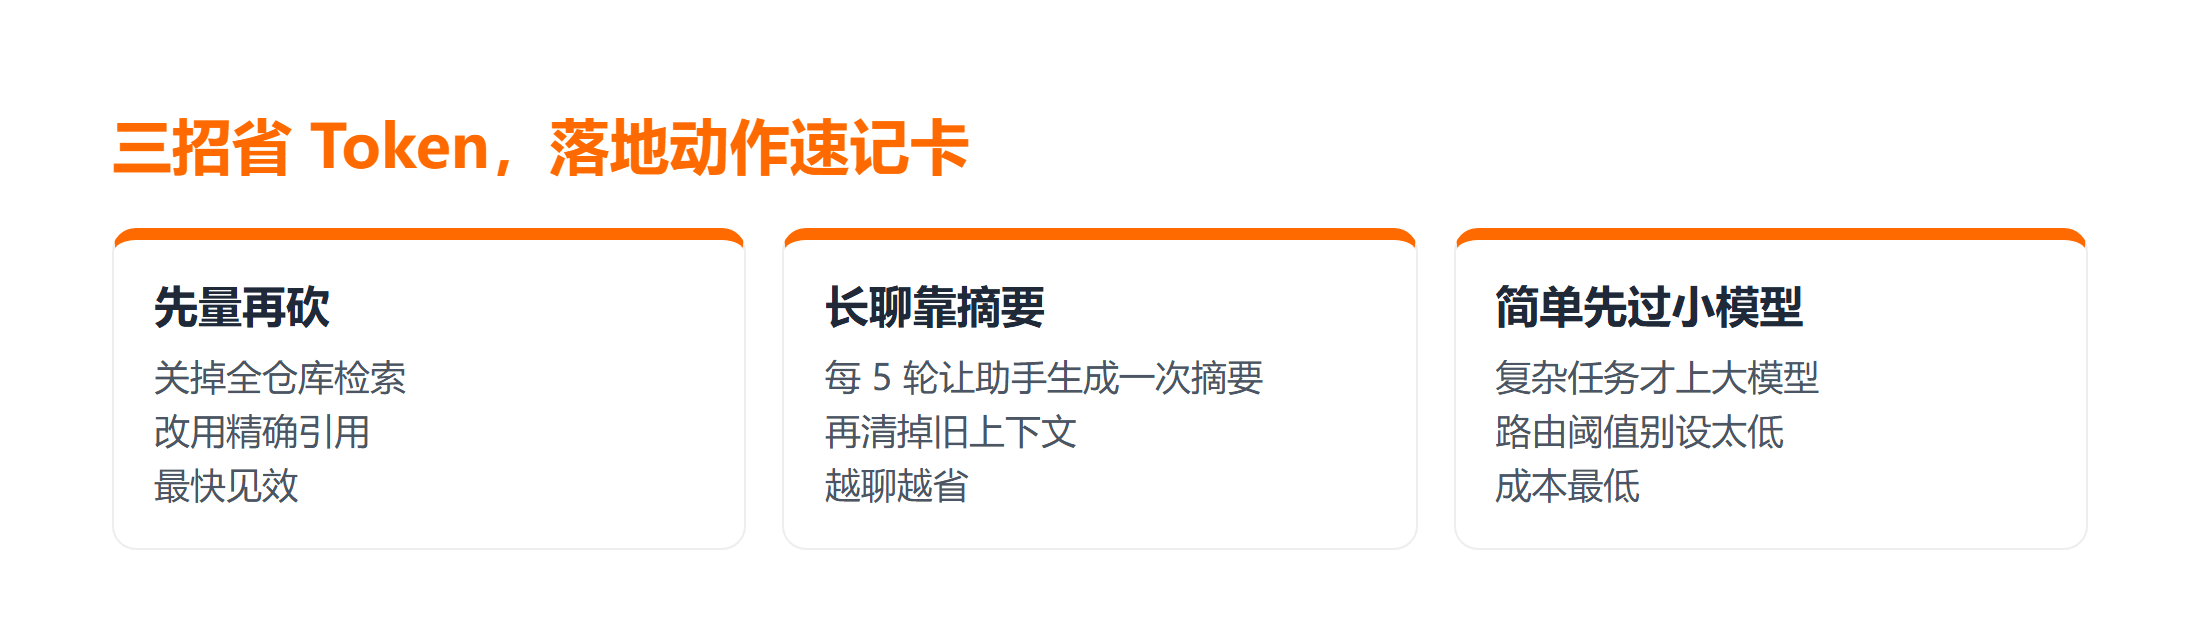
把三种方案摆在一起对比,给出选择建议。第三种是用更便宜的小模型做第一道路由与校验,只在真正复杂的任务上调用大模型。下面先用一张「速记卡」把三招的落地动作讲清楚,再用表格横向比一遍。
| 方案 | 适用场景 | 优点 | 代价 |
|---|---|---|---|
| 精简上下文 | 单次长文件提问 | 立竿见影 | 需手动选片段 |
| 压缩历史 | 多轮长对话 | 越聊越省 | 要维护摘要 |
| 小模型路由 | 批量简单任务 | 成本最低 | 需额外编排 |
验证路由是否生效的办法很简单:把一批简单任务先过小模型,统计被大模型接管的占比,占比越低说明路由越准。想了解提示词怎么写更省,可以读 Codex 提示词教程。
五、踩坑清单
把读者做完之后最可能卡住的三到四个点列出来,每个给出现象、原因、解决办法。
- 现象:明明只问了一句话,Token 消耗却很高。原因:助手默认读完了整个仓库索引。解决:关闭全仓库检索,改为精确引用。
- 现象:多轮对话后越来越慢也越来越贵。原因:历史没有压缩。解决:每 5 轮生成一次摘要,并清掉旧上下文。
- 现象:小模型答非所问。原因:路由阈值设得太低,复杂任务也被它接走。解决:只在明确简单的任务上用小模型,复杂任务直接上大模型。
总结
Token 消耗的大头是重复发送的冗余上下文,而不是你写的那几行代码;用「精简上下文 + 压缩历史 + 小模型路由」三招组合,能把日常 AI 编程的 Token 消耗明显压下来。要点带走:
- 要点一:单次提问只喂相关片段,别整文件粘贴;
- 要点二:长对话定期生成摘要,下轮只带摘要;
- 要点三:简单任务用小模型路由,复杂任务才上大模型。
下一步该往哪走,用一句话指路:先把你最常用的那个助手的上下文设置调一遍,再回来对比账单。如果想系统打底,也可以从 AI 人工智能教程 入门 AI 编程,把概念和边界先搭起来。本文结论依据 OpenAI 及各家官方文档对 Token 计费与上下文窗口的说明整理,命令示例基于常见 CLI 形态,未在本机逐条执行;具体消耗以你所用平台的计费页为准。
常见问题
Q:Token 和「词」是一回事吗?
不是。Token 是模型切分后的最小计费单元,中文通常一个字算一个 Token,英文一个词可能拆成多个 Token,所以中英文混合提问时体积会更难预估。
Q:精简上下文会不会让助手答错?
概率很低,前提是你贴的片段确实包含报错栈和关键定义。宁可多贴报错栈,也别整仓库粘贴。
Q:小模型路由值得做吗?
只有当你每天有成百上千次简单调用时才划算,个人日常使用优先做前两种省法。
延伸学习
- AI 驱动的 Python 编程实战 — 想系统练 AI 编程的配套课程
- 词元是什么意思 — 先搞懂 Token 到底是什么
- AI 编程技能教程 — 官方 AI 编程能力总入口