
 TRAE-AI编程

当你想把一段英文代码注释翻成中文,又怕“async”“middleware”“idempotent”这类术语被翻错或翻飞时,问题通常不在模型能力,而在“你没把术语表交给它”。用 DeepSeek 翻译代码注释想保住术语,最稳的做法是先准备一份中英对照的术语表,再用明确指令让模型“只翻译自然语言部分、保留代码标识符与专有名词”,最后用少量样例校准输出风格。本文先给结论,再讲清为什么术语会翻飞、完整操作步骤、保术语的几种技巧,以及常见反例和边界,帮你把 DeepSeek 翻译代码注释从“机翻味很重”变成“可读又准确”。
先看结论
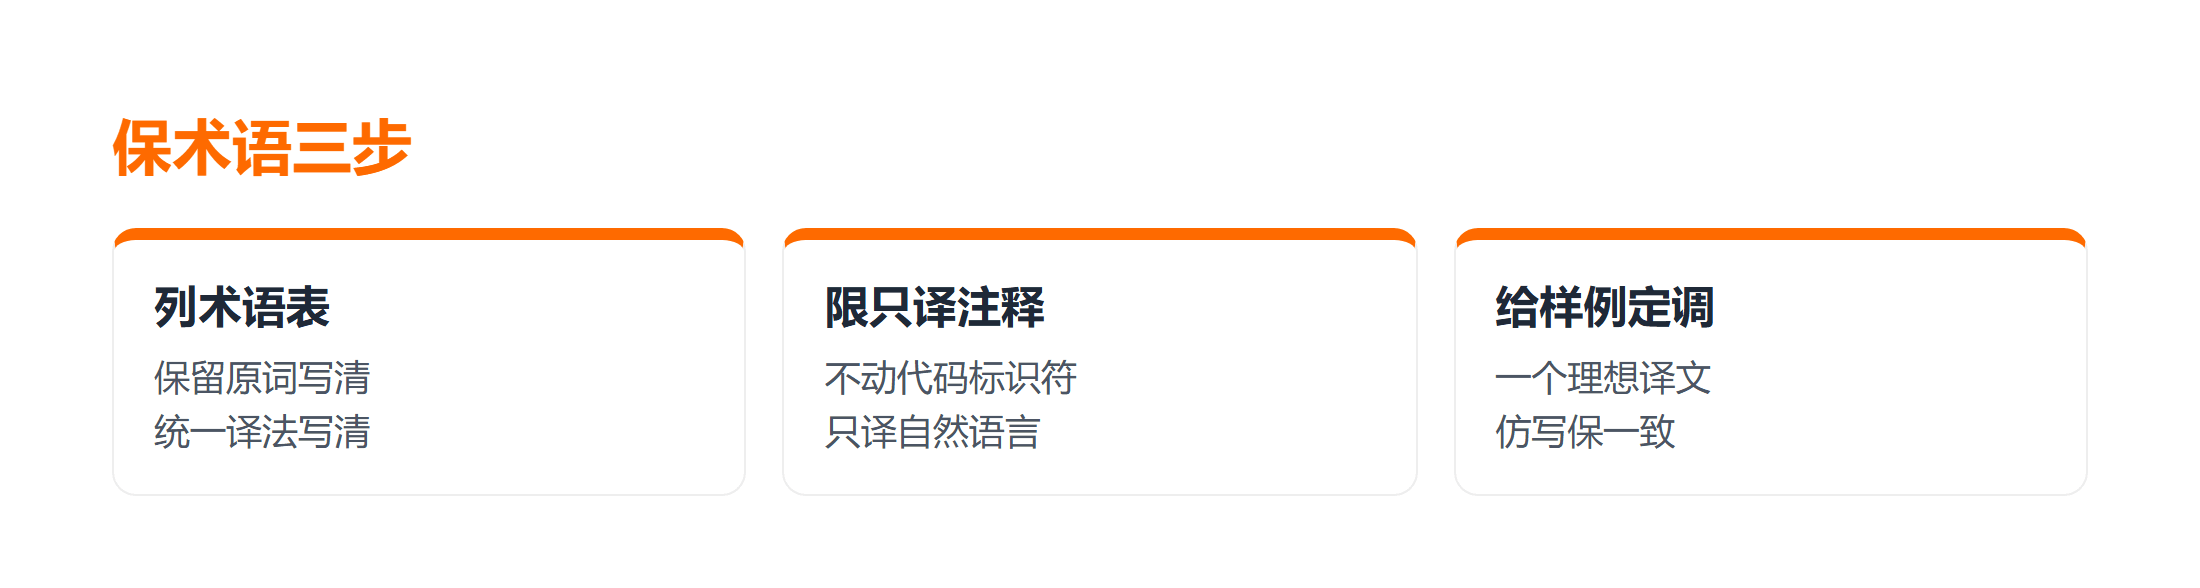
DeepSeek 翻译代码注释保术语的核心是“约束 + 样例”。三个要点:第一,给一份术语表,明确哪些词不翻译(如 Cookie、Token、RESTful);第二,指令里写清“只译注释文字,不动代码与标识符”;第三,先给一到两个已翻译样例定调,再批量跑。只要术语表在、约束在,AI 翻译代码就不会把专有名词拆碎。代码注释规范的前提是“人能读懂且术语统一”,DeepSeek 只是帮你提速,判断权仍在你。
一、先确认你要保住哪些术语
动手前先列一张小表,区分三类词:必须原样保留的(框架名 Django、协议 OAuth2、缩写 JWT)、可译但需一致的(一译“异步”、不译“非阻塞”)、以及纯自然语言(句子里的“处理”“返回”)。很多翻译翻飞,是因为没告诉模型哪些词是禁区。
还有一层常被忽略:同一英文词在不同团队意思不同。比如 cache 在有的团队指“缓存”,在有的指“高速存储层”;client 可能指“客户端”,也可能是某个具体服务名。术语表不能只列“不译词”,还要标“统一译法”和“歧义提示”。把这层写清,DeepSeek 翻译代码注释时才不会在你最在意的地方翻飞。建议术语表第一列放原文、第二列放约定译法、第三列放“仅当……时生效”的边界说明,比单纯堆词更可控。
比如下面这段注释,术语就不应被拆:
# retry with exponential backoff when rate limited by the gateway
def fetch(url):
    ...
exponential backoff 应译为“指数退避”而非“指数后退”,gateway 在这里保留“网关”更贴切。把这类约定写进术语表,DeepSeek 翻译代码注释时才不会各次翻得不一样。术语基础可参考 Python 速查手册 里常见概念的中文对应。
二、保术语的几种做法
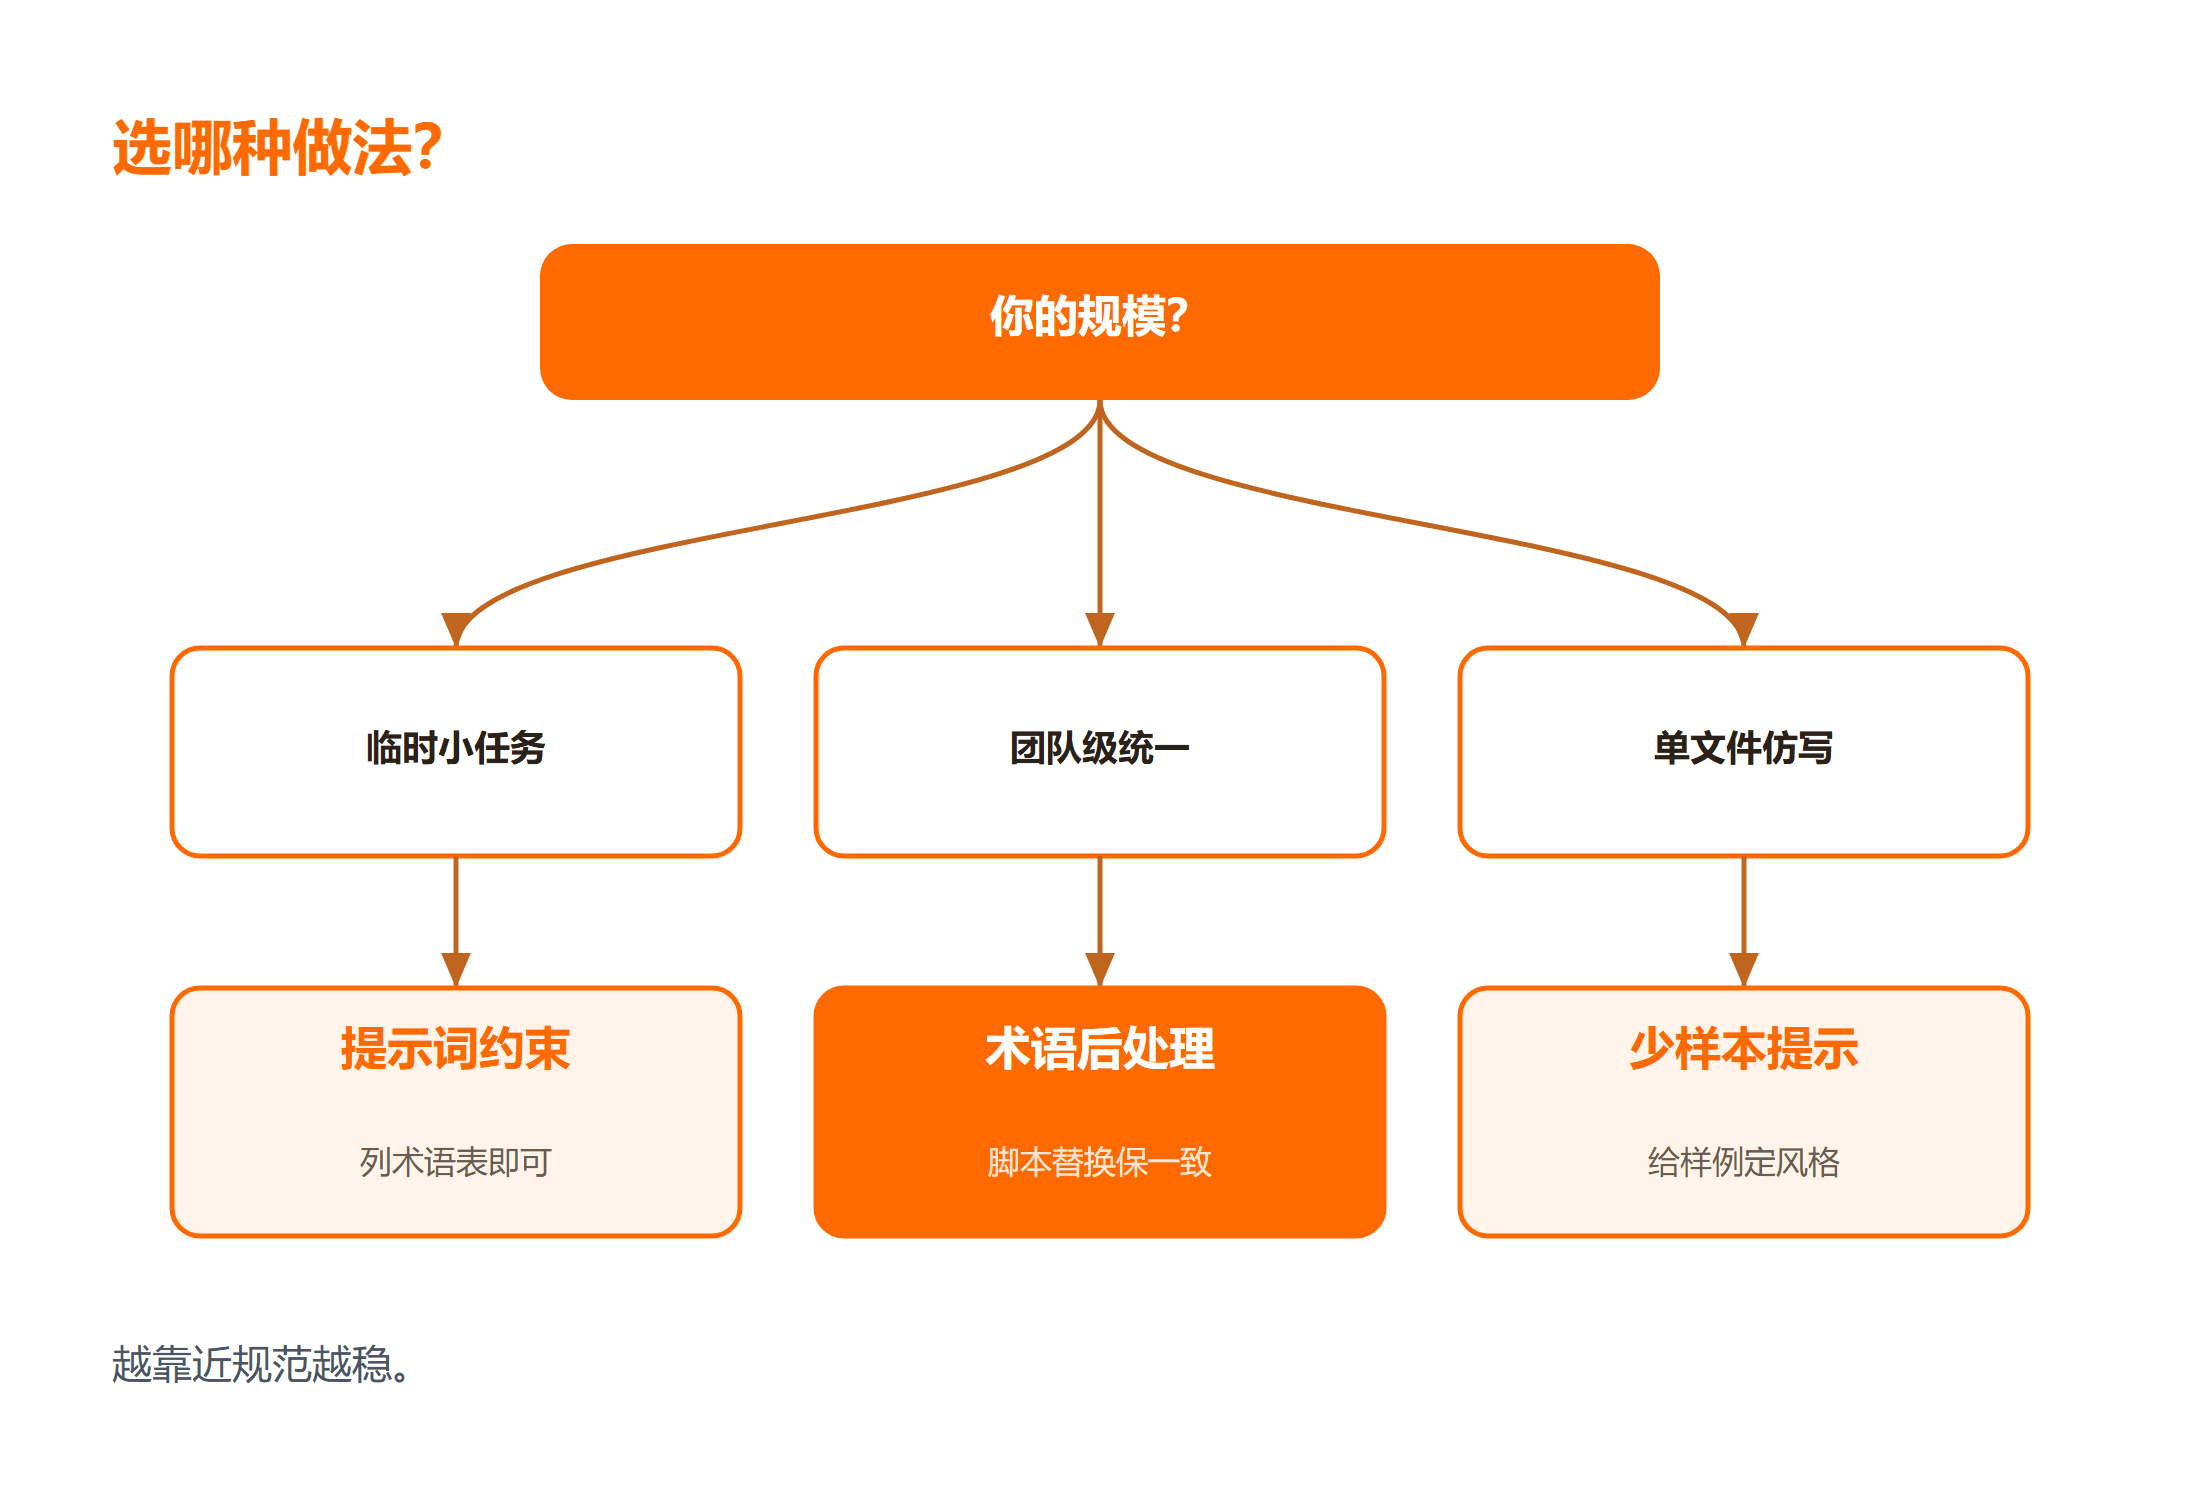
做法一:纯提示词约束。适合一次性小任务,指令里列出术语表加“保留专有名词”即可,但长文件容易前后不一致。
做法二:少样本提示(few-shot)。给一个“原文注释 + 理想译文”的样例,再让模型仿写。这是保术语最稳的轻量做法,能固定风格与用词。
做法三:外接术语库做后处理。把术语表做成映射,翻译完用脚本把残留英文术语替换回约定中文。适合大仓库批量场景。
三者区别在于“一致性保证的强度”。临时任务用做法一,团队级统一用做法三。无论哪种,DeepSeek 教程里的对话能力都来自 DeepSeek 中文教程,先把基础对话格式摸清。
选哪种,看团队规模与更新频率:单人项目做法一就够,半天上一次;多人协作但术语稳定,做法二定调后大家照抄;术语天天变、文件成百上千,必须上做法三,否则人工维护术语表会拖垮效率。关键不是“哪个最先进”,而是“哪条能长期坚持”。把术语表当成会演进的资产,而不是一次性贴给模型的提示词。
三、从零到跑通的完整步骤
第一步,整理术语表,存成 glossary.md:
# 注释翻译术语表
保留原词:JWT, OAuth2, middleware, idempotent
统一译法:retry→重试, backoff→退避, gateway→网关
第二步,构造提示词:
你是代码注释翻译助手。只翻译注释里的自然语言,保留代码、标识符与术语表中的原词。
术语表:JWT/OAuth2/middleware 不译;retry=重试, backoff=退避。
示例:# retry when rate limited → # 限流时重试
现在翻译:# purge expired sessions from the cache
预期输出是 # 从缓存中清除过期会话,cache 若不在术语表可译为“缓存”。这一步建议先拿一两个真实注释试跑,确认 DeepSeek 输出风格符合预期,再批量处理整个仓库,避免一次性翻完才发现格式跑偏。多工具协同时,同类术语约定也可放进 OpenClaw 文档 的项目说明,保证 TRAE 等工具行为一致。
四、常见反例与边界
反例一:直接说“把注释翻译成中文”。模型会把 middleware 翻成“中间件”(有时正确,但 idempotent 容易被翻成“幂等的”这种生硬词,或前后不一致)。必须给术语表。
反例二:把代码里的变量名也翻译了。指令必须强调“只译注释文字”。否则 userToken 变 用户令牌,代码直接报错。
边界:DeepSeek 能保住你列出的术语,但无法判断业务里某个缩写到底指什么——cache 在某些团队指“缓存”,在另一些指“高速存储”,这种语义仍要你定。翻译完可以顺手规整注释排版,让代码注释规范更统一。另外,术语表本身也要随项目演进:新引入的框架、新约定的缩写,都应及时补进 glossary.md,否则下次又会翻飞。
适用边界上,术语表只约束翻译、不替你判断业务缩写含义;和「直接机翻」对比,带术语表的输出一致性更高。实际操作时先运行翻译命令,检查 DeepSeek 输出,预期专有名词原样保留;若失败就补术语表修复,再验证一次译文是否统一。还要确认翻译结果是“可复现”的:同一段注释跑两次,译文应一致,如果不一致说明提示词里仍有歧义,需要把样例写死。把验证过的术语表与样例存进仓库,比把一次成功的翻译当终稿更可靠。
常见问题
Q:术语太多,提示词放不下怎么办?
把术语表写成文件,提示里引用“按 glossary.md 翻译”,或拆成多轮:先喂术语,再逐文件翻译。
Q:DeepSeek 把代码标识符也改了怎么救?
立即回退到原文,在指令加粗“严禁改动代码与标识符”,并用少样本样例定调,必要时做术语后处理。
Q:翻译后风格不统一怎么办?
固定一个样例当模板,所有文件都用同一提示词与同一术语表,别每次重写指令。
总结
用 DeepSeek 翻译代码注释保术语,关键在“术语表 + 约束 + 样例”。先列禁译词与统一译法,再限定只译自然语言,最后用样例定风格。术语越明确,AI 翻译代码越稳,注释可读性越高。



