
 TRAE-AI编程

默认情况下,TensorFlow 会占用 GPU 的几乎全部显存,即使你的模型很小。这在多人共用一张卡或同时跑几个任务时会造成浪费和抢占。先给结论:最省事的写法是在建模型前用 tf.config 设置显存增长或按固定比例分配;老项目可能用 per_process_gpu_memory_fraction。本文用可运行的最小例子讲清几种做法、各自适用什么场景,以及常见失败怎么修。根据文档整理,适用于 TensorFlow 2.x 主流版本,配置时机是全文最关键的注意点。
一、先理解默认行为为什么占满显存
TensorFlow 默认采用"预分配"策略:进程启动时就向 GPU 申请大部分显存,不管模型实际用多少。这样做是为了减少运行时的内存碎片、提升性能,但副作用是一张卡只能跑一个任务,别的进程没显存可用。
理解这一点,就知道"限显存"的本质是改变分配策略:要么让显存按需增长(用多少占多少),要么限定一个固定上限。两种方式各有权衡,下一节细说。
举个真实例子:一张 24GB 的卡,默认策略下即使你只跑一个几 MB 的小模型,也会被占去 22GB 以上,第二个人再想在同一张卡上调试就报 OOM。改成按需增长后,小模型可能只占几百 MB,两个人就能同时用一张卡。这也是很多团队共享 GPU 服务器时的第一项调优。要注意,限的只是显存占用,GPU 的计算时间仍会被多个任务共享,算力和显存是两回事。
动手前要确认环境能识别 GPU。用 tf.config.list_physical_devices('GPU') 查,返回空列表说明当前跑的是 CPU 版本或驱动没配好,限显存就无从谈起。配置环境时可参考 Python 速查手册 核对命令。
二、最稳实现:显存按需增长
最推荐的做法是开启显存增长,让 TensorFlow 按需申请,而不是一次占满。关键:必须在初始化 GPU 之前、也就是创建张量或模型之前设置。
import tensorflow as tf

gpus = tf.config.list_physical_devices('GPU')
if gpus:
    try:
        for gpu in gpus:
            tf.config.experimental.set_memory_growth(gpu, True)
        print("已开启显存按需增长")
    except RuntimeError as e:
        print("设置失败(GPU 已初始化?):", e)

# 之后再建模型
print(tf.config.list_physical_devices('GPU'))
预期结果(未在本机执行):打印"已开启显存按需增长",随后列出 GPU 设备。如果打印了 RuntimeError,说明设置时机太晚——GPU 已经被初始化过了,必须把这段代码挪到程序最前面。这是最常见的失败,也是本节要强调的重点。
设置后验证:用 nvidia-smi 观察进程显存占用,应该比默认小很多,且随模型规模变化。想在线试代码结构可用 Python 在线运行。
三、几种做法的区别与取舍
按需增长不是唯一方式。下面这张表把常见做法放在一起对比。
| 做法 | 适用场景 | 优点 | 代价 |
|---|---|---|---|
| set_memory_growth | 单任务、想省显存 | 简单、按实际用量占 | 可能有内存碎片 |
| set_virtual_device_configuration | 需要固定上限、多任务隔离 | 边界清晰、可控 | 设太小会 OOM |
| per_process_gpu_memory_fraction | TF1 老项目 | 兼容旧代码 | 2.x 需 compat 接口 |
| CUDA_VISIBLE_DEVICES | 指定用哪张卡 | 简单粗暴隔离设备 | 不控制单卡占比 |
方法二:设置固定显存上限。当你需要给每个进程划死一块显存、彼此不干扰时用这个。它通过虚拟设备配置把一个物理 GPU 切成显存受限的逻辑设备:
gpus = tf.config.list_physical_devices('GPU')
if gpus:
    tf.config.set_virtual_device_configuration(
        gpus[0],
        [tf.config.VirtualDeviceConfiguration(memory_limit=4096)]  # 4GB
    )
预期结果(未在本机执行):该进程最多用 4GB 显存。设得太小、模型装不下会报 OOM,要按模型规模留余量。
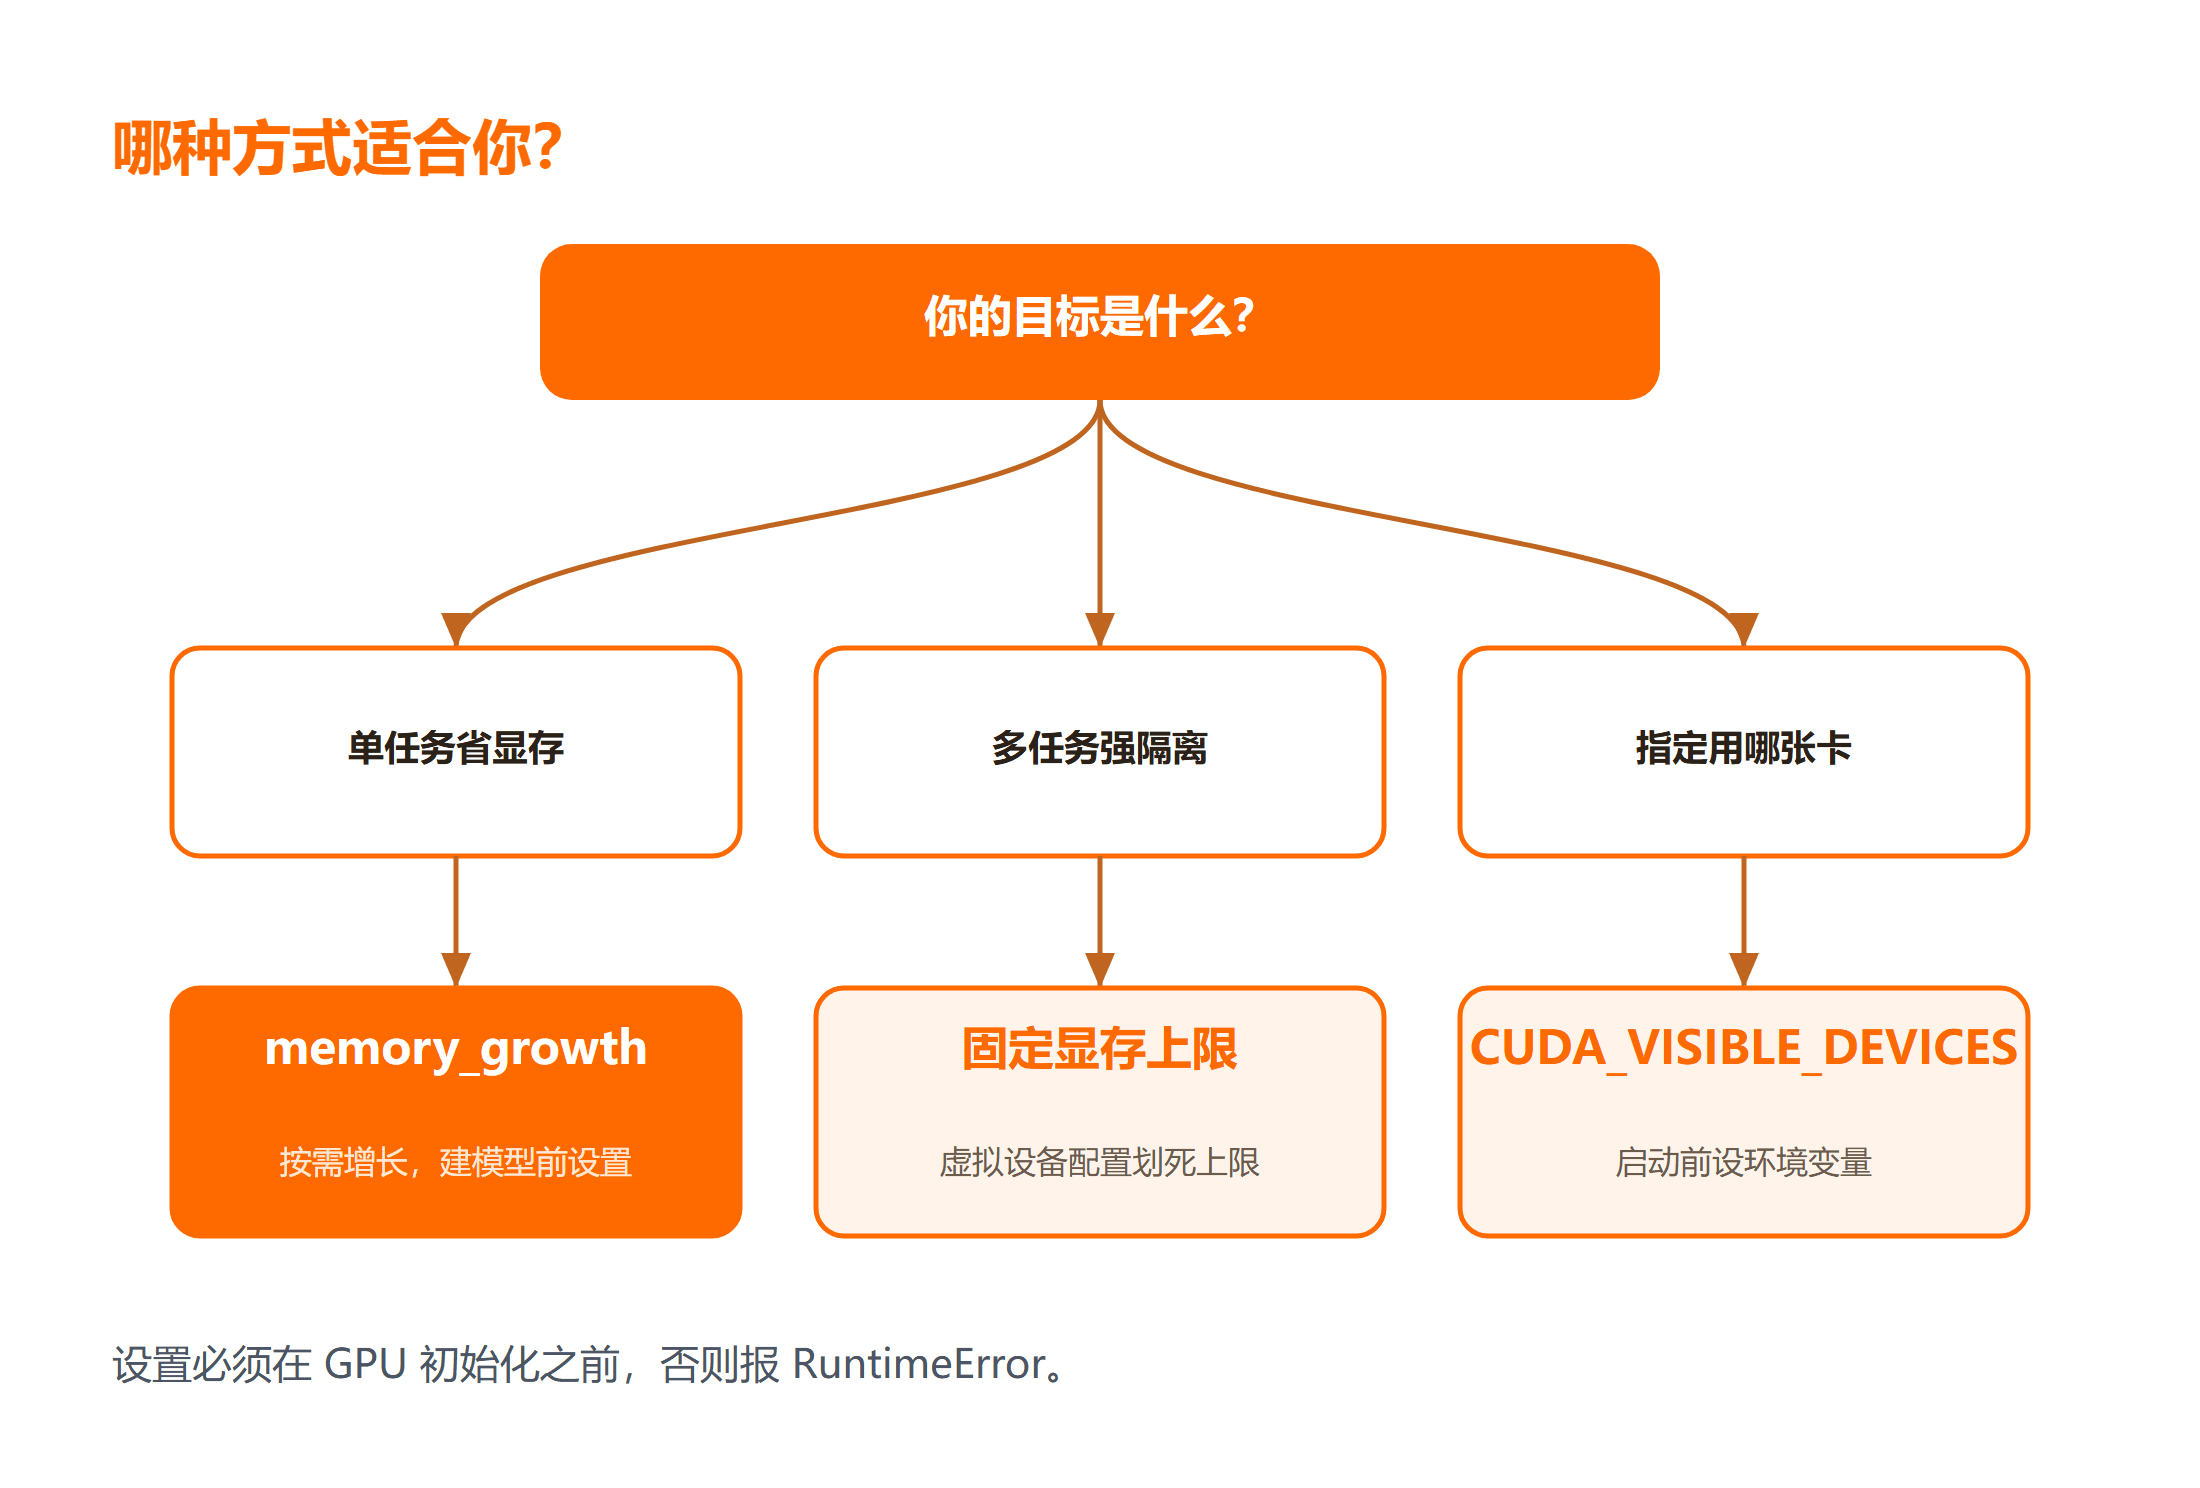
方法三与四:TF1 风格用 tf.compat.v1 下的接口;多卡机器想指定某张卡,启动前设环境变量 CUDA_VISIBLE_DEVICES=0 最简单。选择建议:单任务省显存用方法一,多任务强隔离用方法二,维护老代码用方法三。更多实践可翻 人工智能和机器学习系列(八) NumPy、TensorFlow 和 scikit-learn 这篇笔记。
四、常见失败与适用边界
把限显存的坑集中排查。
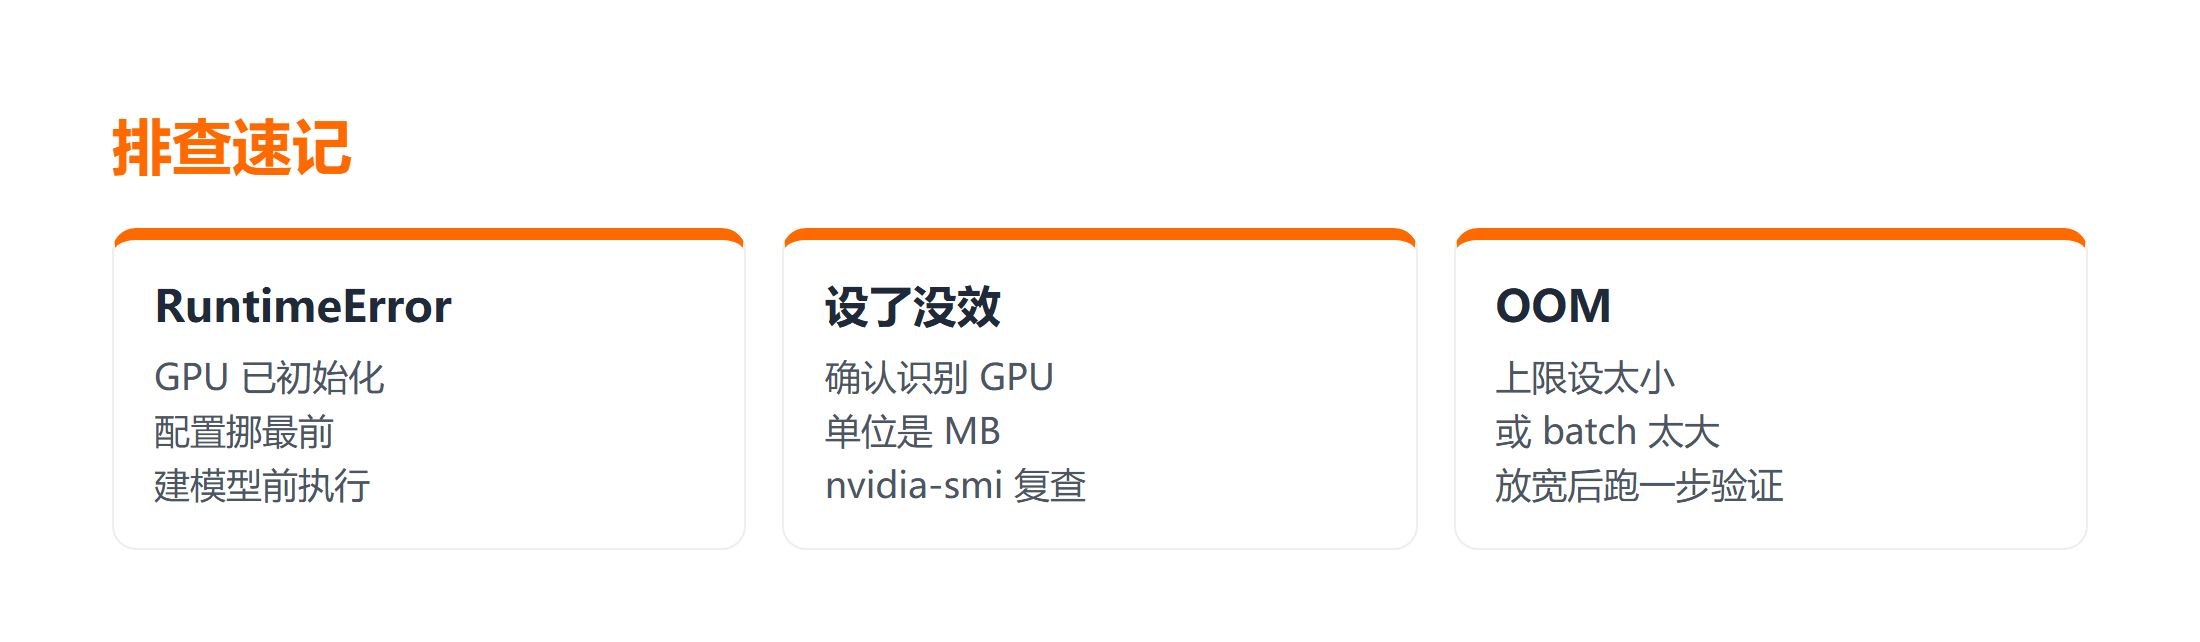
- 设置报 RuntimeError:GPU 已被初始化,设置必须在建模型、创建张量之前。检查代码顺序,把配置挪到 import 之后的第一件事。
- 设了没效果:确认 list_physical_devices 返回非空;如果用固定上限,检查数值单位是 MB。改完用 nvidia-smi 复查。
- 训练中报 OOM:显存上限设太小,或 batch size 太大。放宽上限或减小 batch,修复后重新跑一个 step 验证。
- 多进程互相抢:单靠 memory_growth 不够,用固定上限或 CUDA_VISIBLE_DEVICES 做硬隔离。
- 性能与适用边界:按需增长可能带来轻微内存碎片,固定上限则边界可控但怕设小。图省事用前者,强隔离用后者。显存限制不解决算力抢占——多任务抢的是 GPU 计算时间,那是另一回事。
- 版本与适用边界:2.x 用 tf.config 系列接口,1.x 用 compat.v1 下的旧接口;不同版本 API 名字略有差异。本文以 2.x 为主,老项目按对应版本调整。想系统学 AI 可翻 人工智能 Overview Of AI And Artificial Intelligence。
⚠️ 注意:限显存是为了共存和省资源,不是提升性能。设得过紧反而 OOM。落地前用 nvidia-smi 观察真实占用,按实际调整,别照抄别人的数值。
总结
TensorFlow 默认占满显存是为减少碎片,限制它有几种方式:单任务省显存用 set_memory_growth 按需增长;多任务强隔离用固定显存上限;老项目用 compat.v1 接口;指定用卡用 CUDA_VISIBLE_DEVICES。最关键的一条是设置必须在 GPU 初始化之前,否则报 RuntimeError。改完用 nvidia-smi 验证真实占用,按模型规模留余量。
要点带走:
- 默认预分配会占满,需主动改策略;
- 单任务用 memory_growth,多任务用固定上限;
- 配置必须放在建模型之前;
- 用 nvidia-smi 验证,别照抄数值。
常见问题
Q:设置显存时报 RuntimeError 怎么办?
A:因为 GPU 已经初始化了。把 tf.config 相关设置挪到程序最前面,在创建任何张量或模型之前执行。
Q:为什么设了限制,nvidia-smi 看着还是占很多?
A:确认 list_physical_devices 返回非空、配置生效;固定上限的数值单位是 MB。改完复查,若仍不生效检查是否有别的进程占用。
Q:设了上限后训练报 OOM?
A:上限设太小或 batch size 太大。放宽显存上限或减小 batch size,改完先跑一个 step 验证再继续。
延伸学习
- 想系统补 Python 基础,可以了解 Python 零基础到高薪就业;
- 想看 AI 学习路径与资源,翻 【 🔥算法(AI人工智能)】Python详细知识点学习路线(附学习资源) 这篇笔记;
- 想整理配置代码,可以用 Python代码格式化 工具。



