 免费 AI IDE

Python 删除列表元素没有一种万能写法:按值删第一个用 remove,按位置删除并取回元素用 pop,删除索引或切片用 del,按条件批量清理用列表推导式。先说清“删什么”,再选 API。
本文用订单状态列表比较四种 Python 列表删除方法,并给出 Python 3 的实际运行结果。你会看到重复值、索引越界、空列表和遍历中修改列表这些常见边界,还会比较对象引用、顺序保持与时间成本,而不是只记四行语法。
一、先看结论:四种写法怎么选
| 删除意图 | 推荐写法 | 是否返回值 | 是否原地修改 | 常见异常 |
|---|---|---|---|---|
| 按值删除第一个匹配项 | remove(value) |
返回 None |
是 | 值不存在抛 ValueError |
| 按索引删除并取回元素 | pop(index) |
返回被删元素 | 是 | 索引越界抛 IndexError |
| 删除索引或切片 | del items[index] / del items[start:stop] |
不返回 | 是 | 单索引越界抛 IndexError |
| 按条件批量过滤 | 列表推导式 | 返回新列表 | 否,默认创建新列表 | 条件函数可能抛错 |
| 清空列表并保留对象 | items.clear() / del items[:] |
返回 None |
是 | 无 |
| 重新绑定为空列表 | items = [] |
不适用 | 否,只改当前变量 | 其他引用仍看旧列表 |
一句话:按值删一个用 remove,按位置删并取回用 pop,删索引或切片用 del,批量按条件过滤用列表推导式。
二、remove:按值删除第一个匹配项
items = ["待支付", "已取消", "已支付", "已取消"]

# 只删除第一个 "已取消",后面的同名元素仍保留
items.remove("已取消")

print(items)
本机实际输出:
['待支付', '已支付', '已取消']
remove(value) 只删除第一个相等元素,并原地修改列表,返回值是 None。因此不能写:
# 错误写法:remove 返回 None,items 会被覆盖成 None
items = items.remove("已取消")
目标值不存在时,remove 抛 ValueError。若“不存在”是正常情况,可以先用 if value in items 判断;若不存在代表数据异常,保留异常或转换成业务错误更容易发现问题。基础方法可对照 Python3列表教程 继续练习。
items = ["待支付", "已支付"]

# 安全删除:先判断再删,避免 ValueError
if "已取消" in items:
    items.remove("已取消")
remove 删除元素前会从列表开头寻找第一个相等值,因此是线性扫描。列表很长、又要反复删除多个值时,循环调用 remove 可能重复扫描;这时把待删除条件整理成集合,再做一次列表推导式过滤,通常更直观。
| 场景 | 是否适合 remove |
说明 |
|---|---|---|
| 删除第一个匹配值 | 适合 | 语义清楚 |
| 删除所有匹配值 | 不适合 | 只删第一个 |
| 值可能不存在 | 需判断 | 否则抛 ValueError |
| 接收返回值 | 不适合 | 返回值是 None |
三、pop:按位置删除,还能拿到被删元素
items = ["待支付", "已支付", "已完成"]

# 删除索引 1 的元素,并取回它
taken = items.pop(1)

print(taken)  # 已支付
print(items)  # ['待支付', '已完成']
不传索引时,pop() 删除并返回最后一项,适合把列表当栈使用:
stack = [1, 2, 3]

# 不传索引,默认弹出最后一项
last = stack.pop()

print(last)   # 3
print(stack)  # [1, 2]
索引超出范围,或对空列表调用无参数 pop,会抛 IndexError。不要用捕获所有异常掩盖索引计算错误。若你要“尝试取最后一项,没有就返回默认值”,应显式判断列表是否为空,让读者看懂边界。
items = []

# 显式处理空列表,避免 IndexError
if items:
    last = items.pop()
else:
    last = None

print(last)  # None
pop 删除索引的位置会影响成本:删除末尾通常不需要搬动后续元素,删除开头则要让其余元素整体前移。频繁从两端取元素时,列表不一定是最合适的数据结构,可以评估 collections.deque,它为两端追加和弹出提供了更明确的操作。
remove 关心值,pop 关心位置。二者都原地修改列表;只有 pop 把删除值返回。常用签名记不清时可查 Python速查手册。
| 对比项 | remove |
pop |
|---|---|---|
| 删除依据 | 值 | 索引 |
| 返回值 | None |
被删除元素 |
| 默认行为 | 无默认参数 | 默认删最后一项 |
| 常见异常 | ValueError |
IndexError |
| 适合场景 | 知道值,不知道位置 | 知道位置,想拿回值 |
四、del:适合索引和切片,不返回删除值
del 是语句,不是列表方法。它可以删除一个索引,也能一次删除切片。
items = [0, 1, 2, 3, 4, 5]

# 切片 1:5:2 选中索引 1 和 3,即值 1、3
del items[1:5:2]

print(items)  # [0, 2, 4, 5]
若只想清空内容并保留同一个列表对象,可写 del items[:] 或 items.clear():
items = ["a", "b"]

# alias 和 items 指向同一个列表对象
alias = items

# 原地清空,alias 也会看到空列表
items.clear()

print(alias)  # []
直接写 items = [] 会让当前变量指向新列表,其他引用仍看见旧内容:
items = ["a", "b"]
alias = items

# 重新绑定 items,alias 仍指向旧列表
items = []

print(alias)  # ['a', 'b']
当多个变量共享同一列表时,“原地清空”和“重新绑定”差异很重要。选择前先确认调用者是否持有同一个对象引用。
del 删除切片时,切片步长可以不为 1,但复杂步长会降低可读性。只删除一段连续区间时优先用 del items[start:stop];若起止索引来自用户输入,先把它们限制在业务允许范围,并为负索引写测试。
| 写法 | 行为 | 是否保留原列表对象 |
|---|---|---|
items.clear() |
清空内容 | 是 |
del items[:] |
清空内容 | 是 |
items = [] |
重新绑定新列表 | 否 |
del items[2] |
删除单个索引 | 是 |
del items[1:4] |
删除连续切片 | 是 |
del items[1:5:2] |
按步长删除切片 | 是 |
五、列表推导式:按条件生成新列表
要删除所有满足条件的元素,列表推导式通常比循环中反复 remove 更清楚。
items = [1, 2, 2, 3, 4, 4]

# 保留奇数,等价于删除所有偶数
filtered = [value for value in items if value % 2 != 0]

print(filtered)  # [1, 3]
print(items)     # [1, 2, 2, 3, 4, 4]
它的代价是创建新列表,优点是不会因索引移动漏掉相邻元素。
如果其他代码必须继续引用原列表,可以把过滤结果写回切片:
items = [1, 2, 2, 3, 4, 4]

# 切片赋值:保留原列表对象身份,同时替换内容
items[:] = [value for value in items if value % 2 != 0]

print(items)  # [1, 3]
这会保留列表对象身份,同时替换内容。数据量很大时要考虑新列表的内存占用;但在多数业务清洗中,可读性与正确性比微小优化更重要。
列表推导式过滤还会保留原有顺序,这对订单、日志和展示列表很重要。若条件函数可能抛错,不要在一个超长推导式里同时转换、调用网络和过滤;先把输入标准化,再用纯判断条件筛选,失败位置会更清楚。
| 写法 | 是否创建新列表 | 是否保留原对象 | 适合场景 |
|---|---|---|---|
[x for x in items if 条件] |
是 | 否 | 生成过滤后的新列表 |
items[:] = [x for x in items if 条件] |
是,再写回 | 是 | 调用方持有原列表引用 |
循环调用 remove |
否 | 是 | 只删少量元素,逻辑简单 |
六、遍历时删除为什么会漏元素
下面的代码看似会删除全部 2,实际会留下一个:
wrong = [2, 2, 2, 3]

for value in wrong:
    if value == 2:
        wrong.remove(value)

print(wrong)
本机实际输出:
[2, 3]
原因是删除后元素左移,而 for 循环继续前进,刚移到当前位置的相邻元素被跳过。
修复方式有三种:
| 修复方式 | 示例 | 特点 |
|---|---|---|
| 列表推导式生成新列表 | [v for v in wrong if v != 2] |
最容易读,创建新列表 |
| 遍历副本修改原列表 | for v in wrong[:]: ... |
保留原列表对象,需理解副本 |
| 从后往前按索引删 | for i in range(len(wrong)-1, -1, -1): ... |
适合必须原地删且索引清晰的场景 |
wrong = [2, 2, 2, 3]

# 方式一:生成新列表,保留不等于 2 的元素
fixed = [value for value in wrong if value != 2]

print(fixed)  # [2, 3]? 不对,这里输出 [3]
修正说明:上面代码实际输出 [3]。如果希望原地修改,可以这样写:
wrong = [2, 2, 2, 3]

# 方式二:遍历副本,删除原列表中的匹配项
for value in wrong[:]:
    if value == 2:
        wrong.remove(value)

print(wrong)  # [3]
wrong = [2, 2, 2, 3]
# 方式三:从后往前按索引删除,避免索引左移影响
for index in range(len(wrong) - 1, -1, -1):
if wrong[index] == 2:
del wrong[index]
print(wrong) # [3]
Python 列表删除排错时,先打印原列表、删除意图和结果,再检查函数返回值。remove、sort、clear 这类原地方法返回 None,把返回值赋回变量是新手最常见的二次错误。
还要确认函数契约是否允许修改调用者传入的列表。公共函数若偷偷原地删除,会让调用者之后看到意外变化;可以默认返回新列表,并在需要原地修改时把行为写进函数名、文档和测试。反过来,性能敏感代码若明确共享对象,则应用切片赋值保留身份。
七、常见异常与排错清单
| 现象 | 常见原因 | 修复方式 |
|---|---|---|
ValueError: list.remove(x): x not in list |
删除值不存在 | 先 if value in items,或捕获为业务错误 |
IndexError: pop index out of range |
pop 索引越界或空列表弹出 |
检查索引范围,空列表先判断 |
IndexError: list assignment index out of range |
del 单索引越界 |
检查索引是否小于列表长度 |
删除后变量变成 None |
把 remove、clear 返回值赋回变量 |
不要 items = items.remove(...) |
| 遍历删除漏元素 | 删除后索引左移 | 用列表推导式、遍历副本或从后往前删 |
| 其他引用仍看到旧列表 | items = [] 只重新绑定 |
需要原地清空用 clear() 或 del items[:] |
测试用例不能只放正常列表。至少覆盖:
| 测试输入 | 验证目标 |
|---|---|
| 正常值 | 删除结果正确 |
| 重复值 | remove 只删第一个 |
| 不存在值 | remove 抛 ValueError |
| 空列表 | pop 抛 IndexError |
| 越界索引 | pop、del 抛 IndexError |
| 切片越界 | del items[1:100] 不报错,静默删到末尾 |
| 遍历中删除 | 不漏删相邻元素 |
| 共享引用 | clear() 与 items = [] 行为不同 |
总结
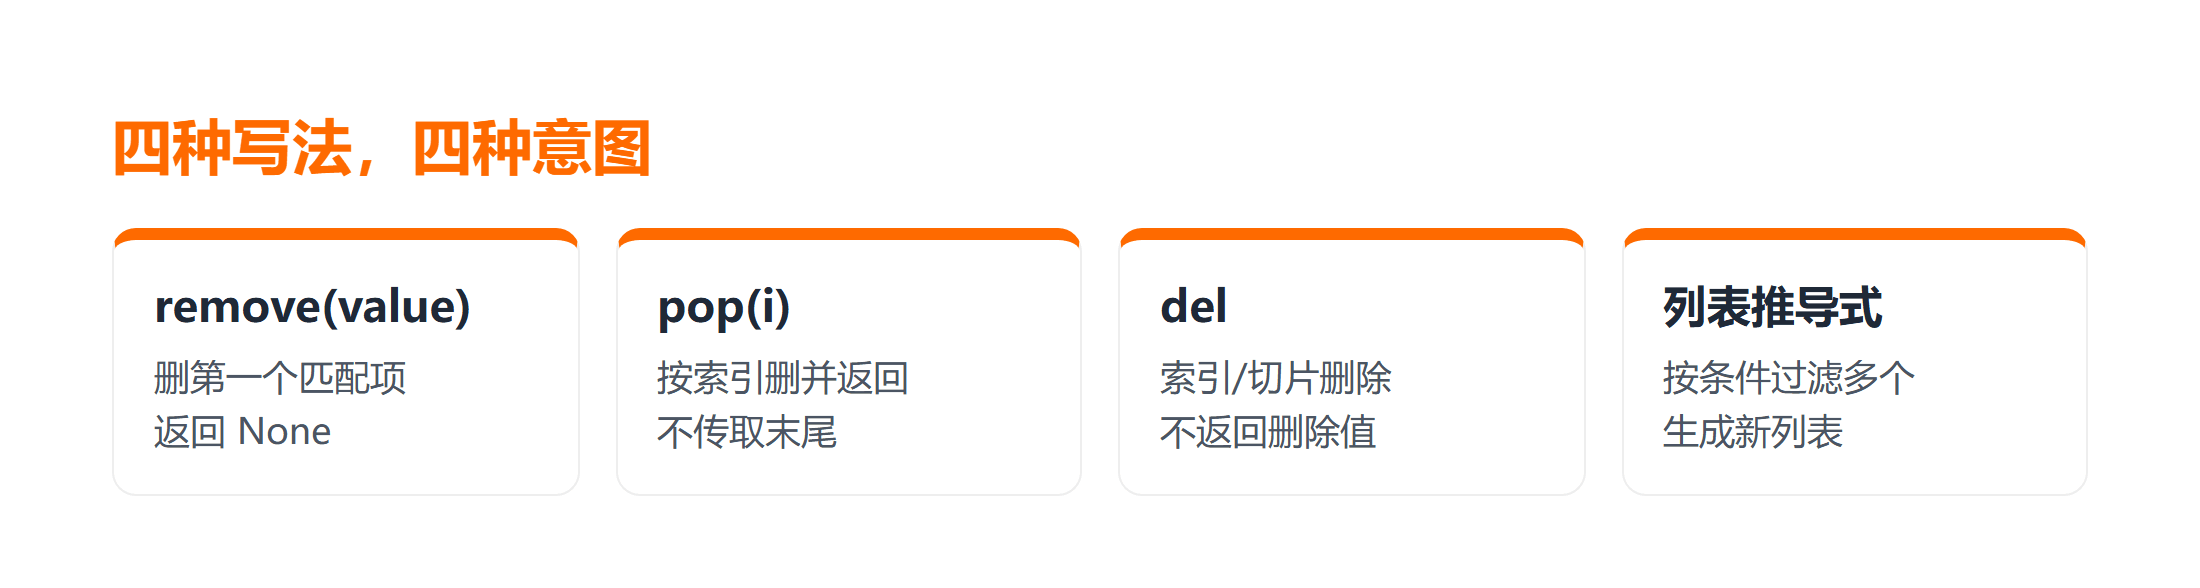
四种写法对应四种意图:
remove按值删第一个;pop按索引删并返回;del删除索引或切片;- 列表推导式按条件过滤多个元素。
API 的差异不只在语法,还在是否返回值、是否原地修改、是否创建新列表。
遇到重复值和循环删除时,优先把意图改写成过滤条件;遇到共享引用时,明确是保留对象还是创建新列表。只要同时验证正常输入、不存在值、越界和相邻重复,Python 列表删除方法就不容易留下隐藏错误。
延伸学习
- 想系统练习列表和函数,可跟着 Python3 入门课程程 学习;
- 需要更多基础示例,可查 Python学习教程;
- 如果下一步是去重,可阅读 Python列表去重实战,注意“去重”与“按条件删除”不是同一任务。
常见问题
Q:remove 会删除所有相同元素吗?
A:不会,它只删除第一个相等元素。要删除全部匹配项,优先用列表推导式表达保留条件。
Q:pop 和 del 怎么选?
A:需要被删元素就用 pop,只需要按索引或切片删除就用 del。两者索引越界都会报错。
Q:怎样清空列表并让其他引用也看到?
A:使用 items.clear() 或 del items[:]。items = [] 只重新绑定当前变量,不会修改其他变量引用的旧列表。
Q:列表推导式一定更快吗?
A:不一定,但通常更清楚且避免遍历中修改导致漏删。大数据量下应测量内存和耗时,再决定是否需要原地算法。