
 TRAE-AI编程

在 PyTorch 里做完 transpose 或 permute,再调用 view 常常报错,提示张量不是 contiguous。先给结论:contiguous() 的作用是返回一个内存布局连续的新张量;如果原张量本来就是连续的,它直接返回原对象,不额外复制。理解内存连续这件事,是避开后面所有报错的关键。这个报错的根因是 view 要求张量在内存里按行连续存放,而转置只改了「怎么看」,没改「怎么存」。本文用一个二维张量复现非连续状态,讲清 contiguous()、reshape 和 view 三种写法的差别与取舍,并给出验证步骤和失败分支。文中的行为基于 PyTorch 2.x,示例为编辑整理,未在本机实际运行。
先看结论
contiguous() 不改变张量的形状或数值,只调整内存布局,让它变得连续。
第一,什么时候需要它:当 transpose、permute 这类操作之后要接 view 时。这些操作返回的是「视图」,共享原数据但内存不连续,view 看不懂这种布局就会报错。想补一遍张量存储的基础,可以先从最基础的张量概念看起。
第二,它不会白复制:is_contiguous() 为 True 时,contiguous() 原样返回,不做拷贝。想理解张量在内存里连续存放这件事,可以配合 人工智能概述 先把基础概念过一遍。
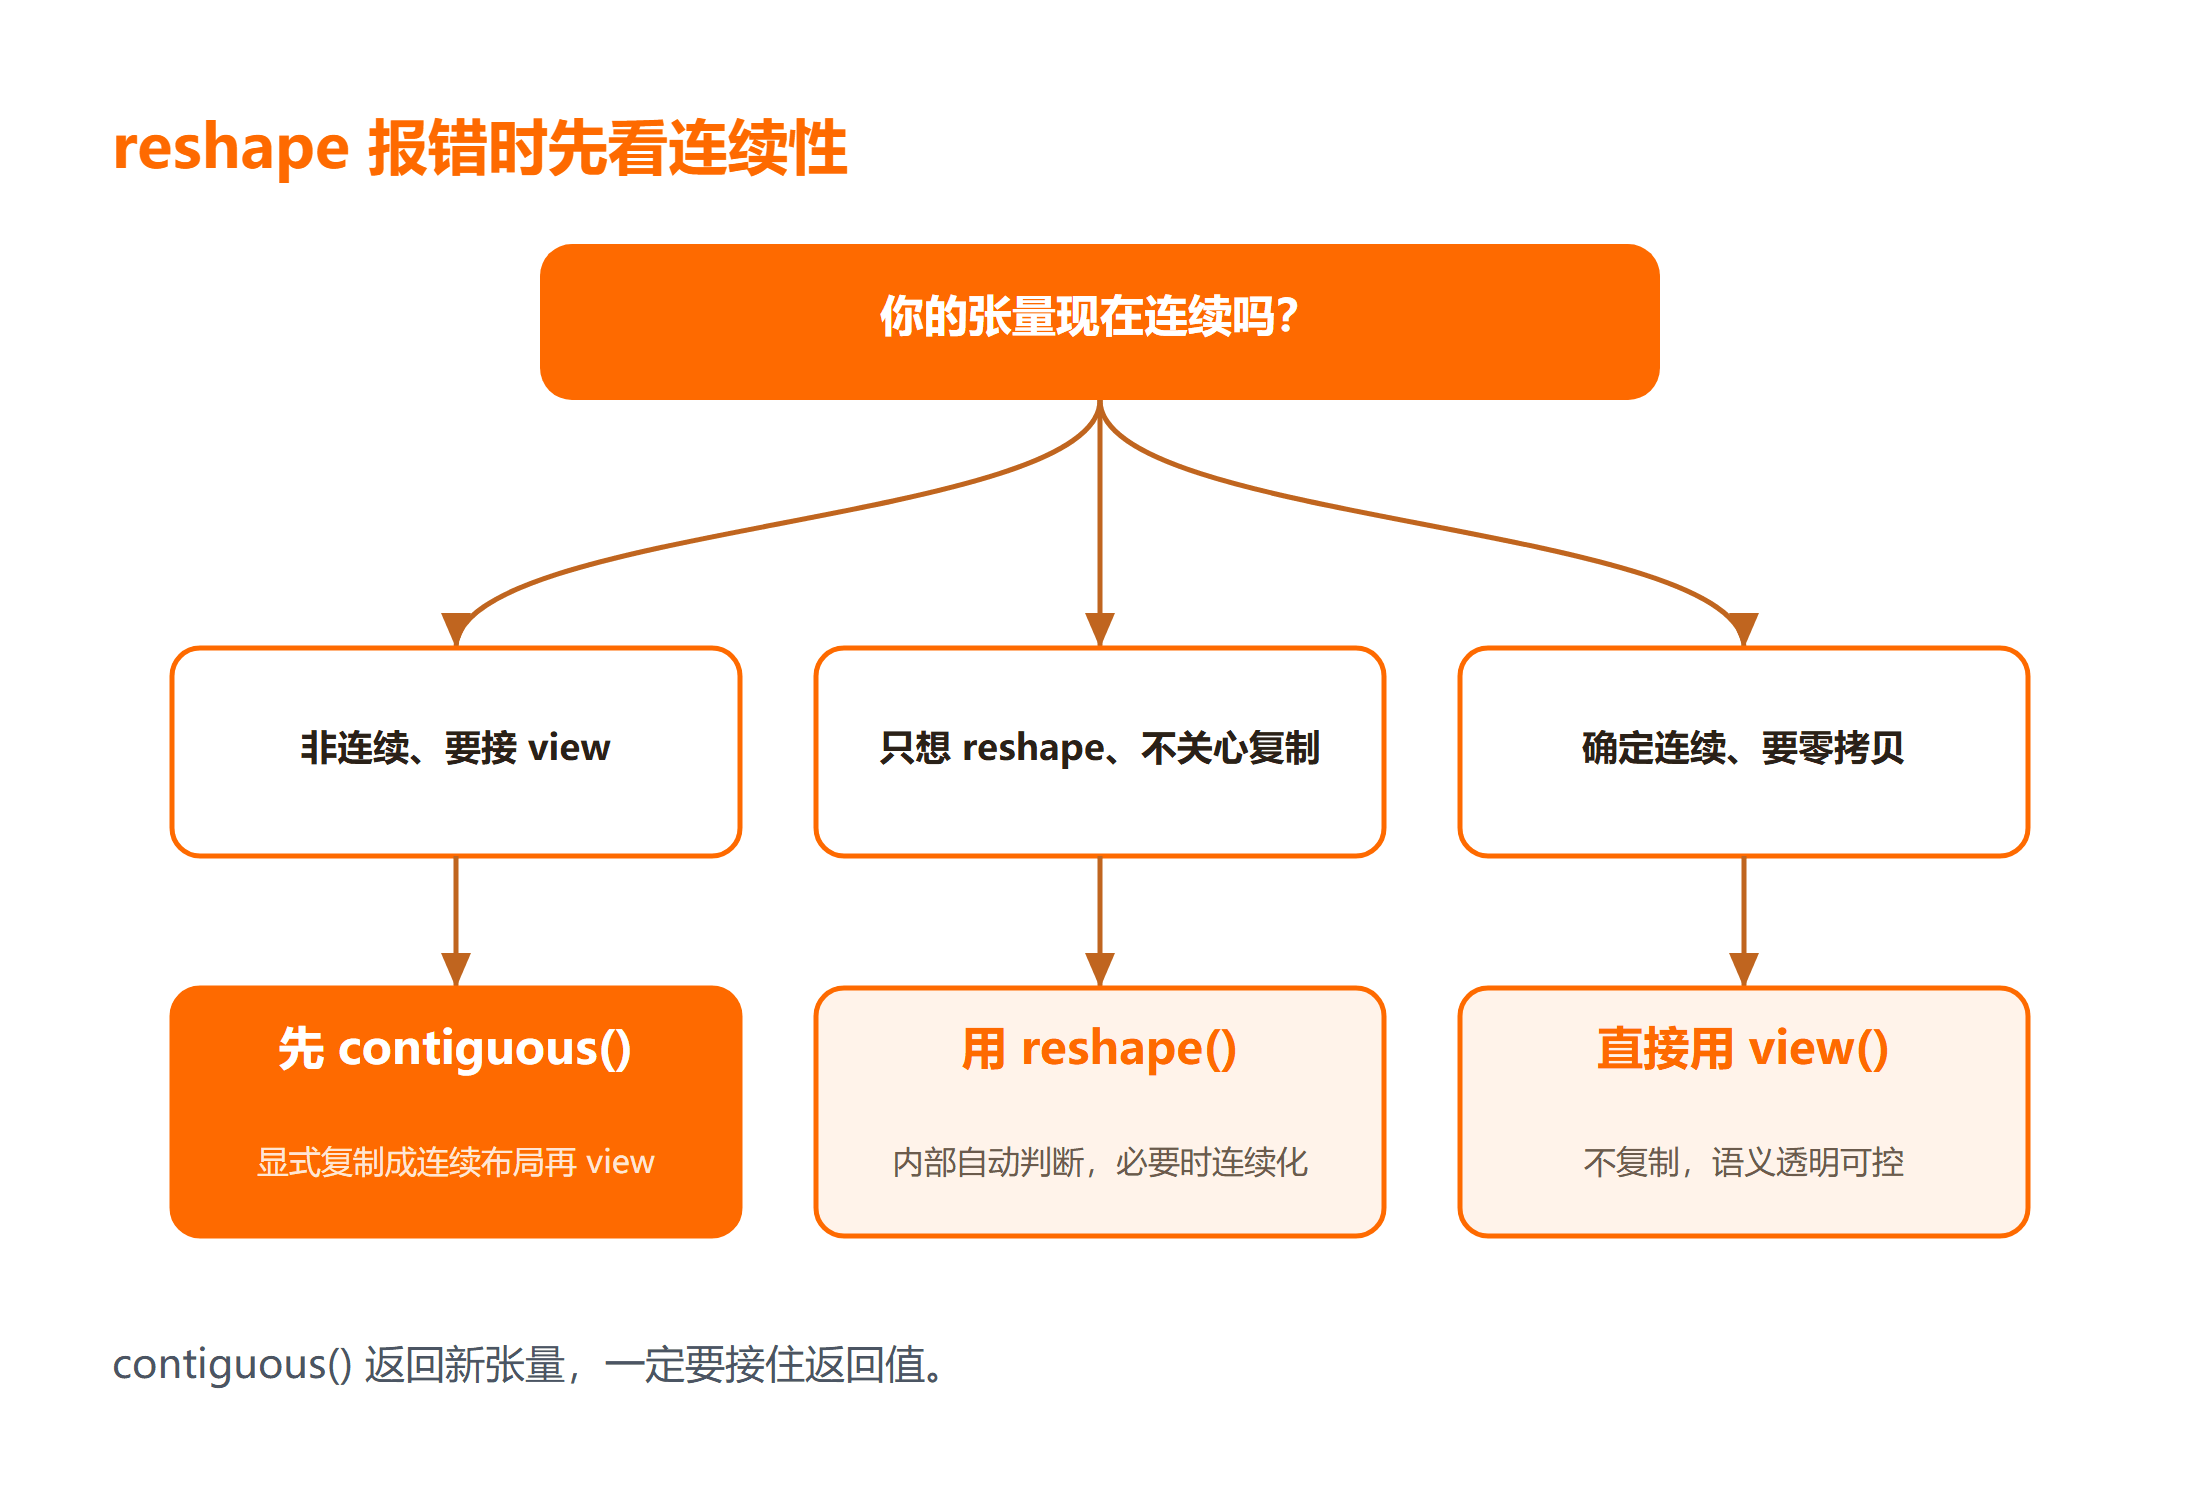
第三,三种写法各有取舍:contiguous() 显式、reshape 自动、view 前手动保证。三者适用场景不同,下面逐个说。
一、先复现「非连续」到底是什么意思
看这段最小代码,先制造一个非连续张量:
import torch

x = torch.arange(6).reshape(2, 3)
y = x.transpose(0, 1)      # 转置只改 stride,不改内存
print(y.is_contiguous())   # False
print(y.stride())          # (1, 3),行内步长不是 1 以外的连续关系
预期结果(未在本机执行):y 的内容是 x 的转置,但 is_contiguous() 返回 False。原因是 transpose 只交换了 stride,没有搬动内存里的元素,所以 y 在内存里并不是按新形状连续排列的。
这时候直接 view 就会失败:
y.view(6) # RuntimeError: view size is not compatibleview 要求元素在内存里连续,才能按新形状重新解释。非连续张量满足不了这个前提。
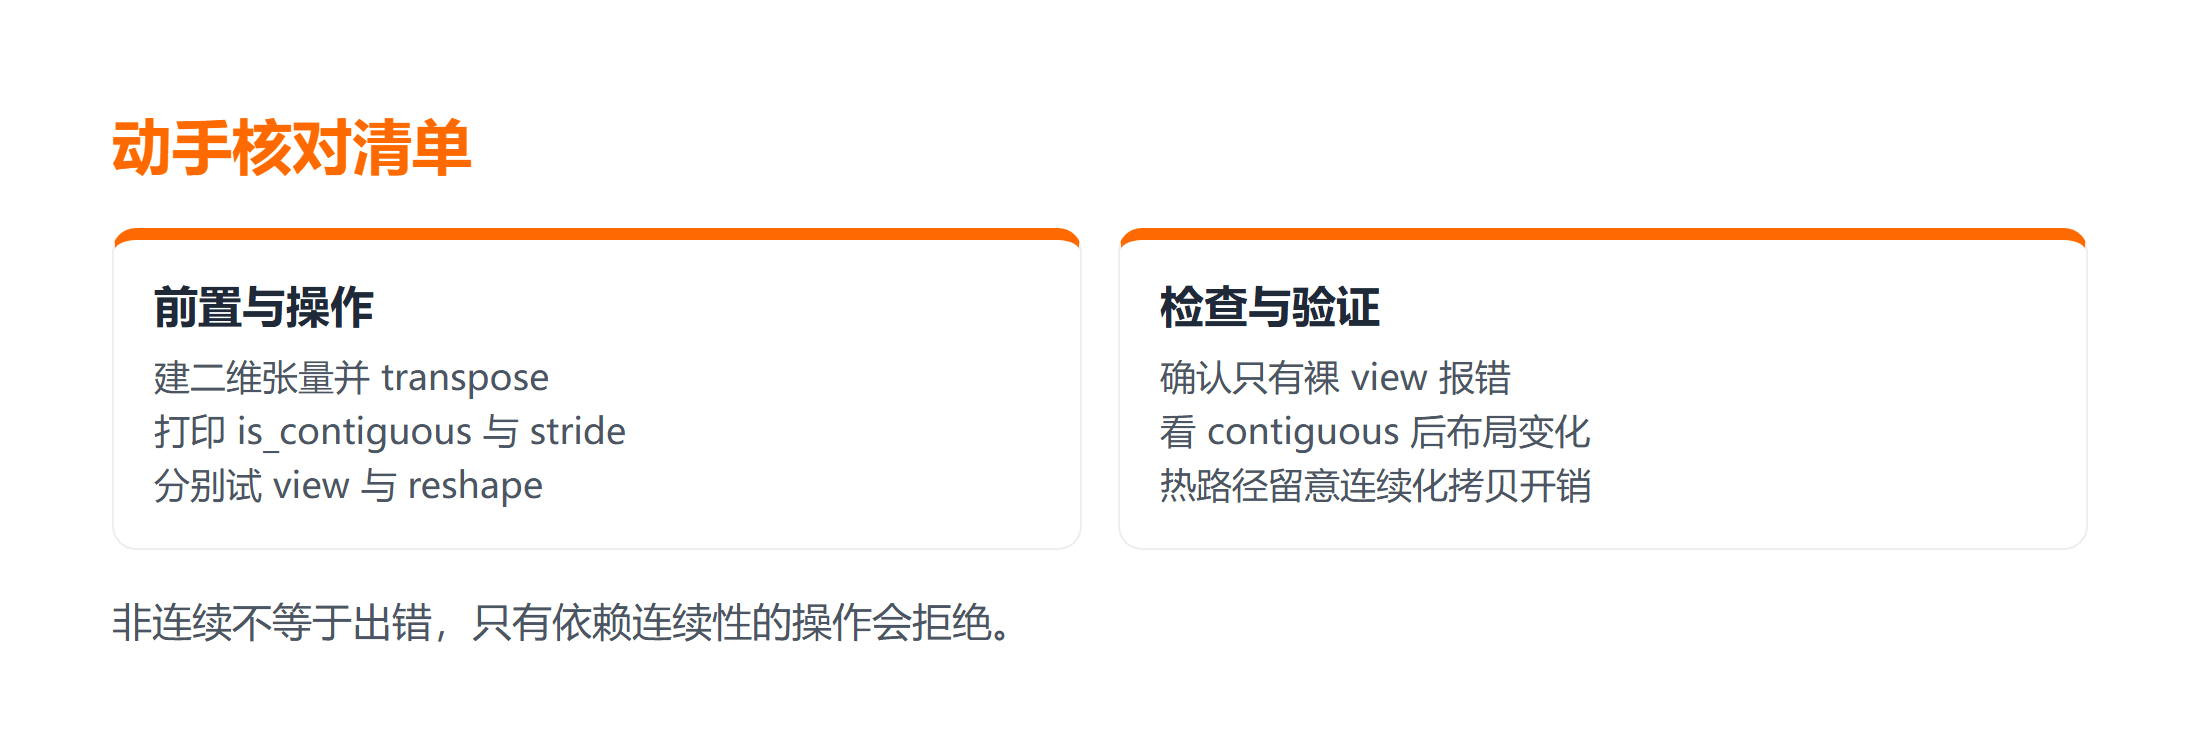
⚠️ 注意:非连续不等于出错。它只是「这套 stride 描述的内存布局」,普通索引、加法都正常,只有 view 这类依赖连续性的操作会拒绝。
二、写法一:contiguous() 显式修复
最直接的写法,是先 contiguous() 再 view:
z = y.contiguous()         # 复制成连续布局
print(z.is_contiguous())   # True
print(z.view(6))           # 现在可以正常 reshape
预期结果(未在本机执行):z 连续,view(6) 不再报错。contiguous() 在这里做了一次真实的数据拷贝,把元素按新顺序重排到连续内存里。
判断要不要调用,有个简单标准:先打印 is_contiguous(),为 False 再调。这样能避免在已经连续的张量上做多余判断。想在线核对张量形状与步长的变化,可以用 Python 在线运行 把代码粘进去跑一遍。
💡 小提示:contiguous() 返回的是新张量(需要时),不是原地操作。一定要接住返回值。
三、写法二:reshape 自动处理
reshape 是更省心的选择,它会在内部自动判断:能 view 就 view,不能就先 contiguous 再 view:
a = y.reshape(6)           # 内部自动处理连续性
print(a)
预期结果(未在本机执行):a 得到展平后的一维张量,不会因为 y 非连续而报错。换句话说,reshape 相当于「view 的宽容版」。
那么为什么不都用 reshape?因为语义不同。view 保证返回的是视图、不复制数据,适合你明确知道张量连续、想零拷贝 reshape 的场景;reshape 可能复制也可能不复制,行为不那么透明。追求性能和内存占用时,明确的 view 更可控。
四、三种写法横向对比与失败分支
把三种写法放在一起,选择就清楚了:
| 写法 | 是否自动处理非连续 | 是否可能复制 | 适用场景 |
|---|---|---|---|
| contiguous().view() | 显式先修复 | 是 | 需要明确控制复制时机 |
| reshape() | 自动判断 | 可能 | 只想 reshape、不关心是否复制 |
| view() | 否,要求已连续 | 否 | 确定连续、要零拷贝 |
4.1 反例与失败分支
几个真实会踩的坑:
- 忘记接返回值:写 y.contiguous() 却不赋值,以为改了 y。它返回新张量,原张量不变,白调一次。
- 以为 reshape 一定零拷贝:reshape 在必要时复制,别假设它和原张量共享内存。改了 reshape 的结果可能影响不到原张量。
- 性能取舍:在训练热路径里反复 contiguous() 会引入多次拷贝,拖慢速度。更好的做法是从源头让布局连续,比如构造时就按目标形状排好。
- 版本与边界:is_contiguous() 判断的是默认维度的连续性;某些操作会产生「部分连续」的张量,需要 verbose 参数才能看全。这一点不同版本行为略有差异。
4.2 动手核对清单
按顺序做一遍,就能确认自己用对了:
- 前置:构造一个二维张量并做 transpose,得到非连续张量;
- 操作:先打印 is_contiguous(),再分别试 view、contiguous().view()、reshape;
- 检查:确认只有裸 view 报错,另外两种都能得到展平结果;
- 预期:contiguous() 后张量连续,reshape 自动兜底;
- 验证:打印每一步的 stride,理解布局如何变化;
- 失败处理:仍报错就回到 is_contiguous() 检查,或改用 reshape 绕过。
以上步骤基于 PyTorch 2.x 通用接口整理,示例标为未在本机执行;你的环境版本不同,个别行为以实际为准。
总结
contiguous() 负责把张量的内存布局变连续,本身不改形状和数值,已经连续时原样返回。view 要求连续、可能报错,reshape 内部自动兜底。
要点带走:
- transpose / permute 后接 view 前,先 contiguous() 或直接用 reshape;
- contiguous() 返回新张量,一定要接住返回值;
- 热路径里留意连续化带来的拷贝开销,从源头规划布局更划算。
常见问题
Q:PyTorch 里 contiguous() 是什么作用?
A:它返回一个内存布局连续的新张量。当转置、维度变换让张量变得非连续、后续 view 报错时,用它修复布局。如果张量本来就连续,它直接返回原对象,不会复制。
Q:为什么 transpose 之后 view 会报错?
A:transpose 只改了 stride(读取顺序),没有搬动内存里的元素。view 要求元素在内存里连续排列才能重新解释形状,非连续张量不满足这个前提,所以拒绝执行。用 contiguous() 或 reshape 可以解决。
Q:reshape 和 view 应该怎么用?
A:确定张量连续、想要零拷贝视图时用 view;不确定连续性、只想 reshape 时用 reshape,它会在必要时自动连续化。两者语义不同,别混着追求同一种保证。
延伸学习
想继续补齐人工智能与张量计算基础,可以按这个顺序看:
- 想系统入门人工智能,可以看 AI 人工智能教程;
- 对照一个真实的概念辨析笔记找语感,翻 人工智能的基石——pytorch;
- 想把代码排版整理干净,用 Python代码格式化 辅助核对。



