
 TRAE-AI编程

明明设了代理却请求超时,账单上的 Token 计费还对不上?最直接的答案是:代理超时和 Token 计费是两条独立链路——超时决定请求能不能到达模型,计费决定到达后消耗多少 Token,恢复要分别定位,不能混为一谈。本文按"复现报错、定位根因、逐步修复、核对输出、回归验证"五步讲清恢复过程,覆盖代理地址、超时阈值、重试放大三类高频错误,帮你把配置调对、把账单对清。全文基于常见反向代理与 Chat Completions 接口,环境差异在文末说明。今天这篇文章,编程狮把这块讲透。
先看结论
配错代理导致超时后,先别急着改计费参数。先确认请求到底有没有到达模型:如果一直超时,请求根本没到,自然不会产生 Token 计费;如果请求到了但账单异常,问题在计费口径而非代理。把这两件事分开,定位效率会高很多。
判断根因的标准路径是:先看超时的具体表现(连接超时还是读取超时)、再核对代理地址与端口、最后检查重试配置有没有把一次请求放大成多次。三步走完基本能锁定根因。想先把大模型基础概念弄清,可过一遍 Trae 大模型入门 的相关章节。
一、复现报错并确认影响范围
先稳定复现,再谈修复。用一个最小请求脚本,固定提示词和模型,连续跑三次,记录每次的耗时与结果:
# 用 curl 观察连接与总耗时
curl -sS -o /dev/null -w "连接=%{time_connect}s 总耗时=%{time_total}s 状态=%{http_code}\n" \
  -H "Authorization: Bearer $DEEPSEEK_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"deepseek-chat","messages":[{"role":"user","content":"你好"}]}' \
  https://api.deepseek.com/chat/completions
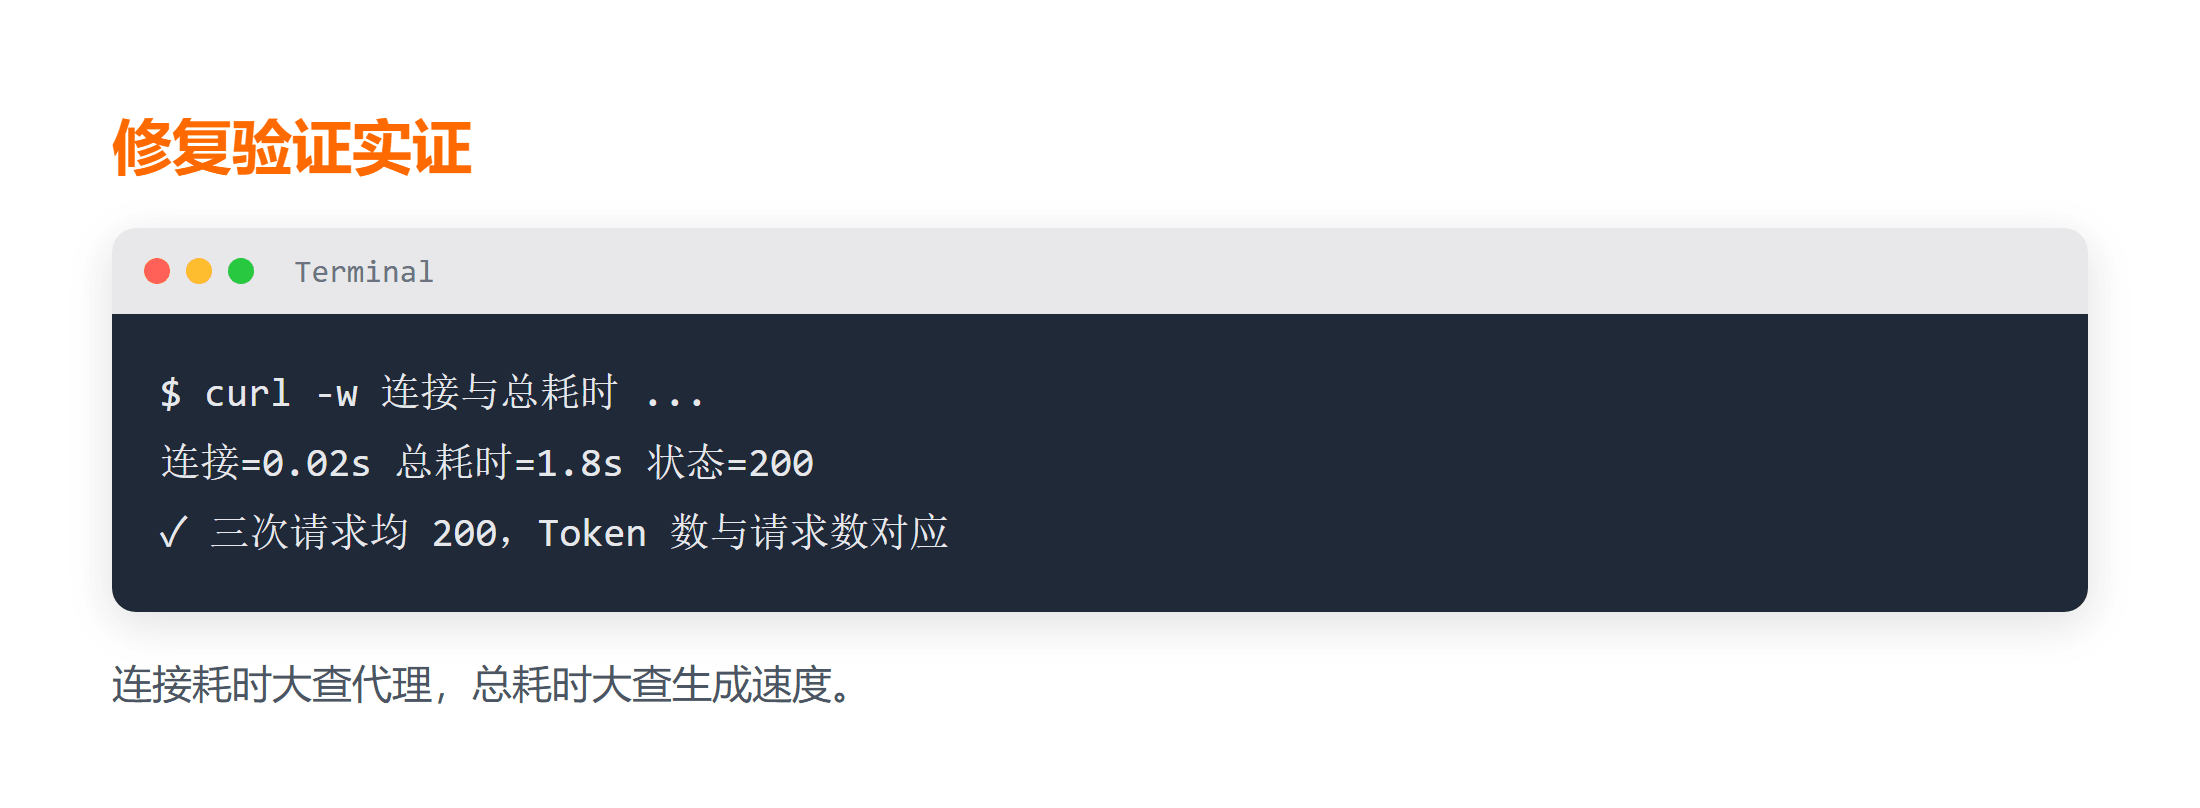
看三个数字:time_connect 很大说明 TCP 连接阶段就卡住,多半是代理地址或网络问题;time_total 大而连接快,说明模型生成慢或读取超时设太短;http_code 为 0 说明请求没拿到响应。检查网络配置时可对照 Trae 问题排查。
把三次结果记下来,才能判断是偶发还是必现。偶发多为网络波动,必现基本是配置错误。如果三次的耗时数字起伏很大,说明链路本身不稳定,此时先别急着改参数,应优先排查网络与代理服务的负载状况。
二、按现象定位根因
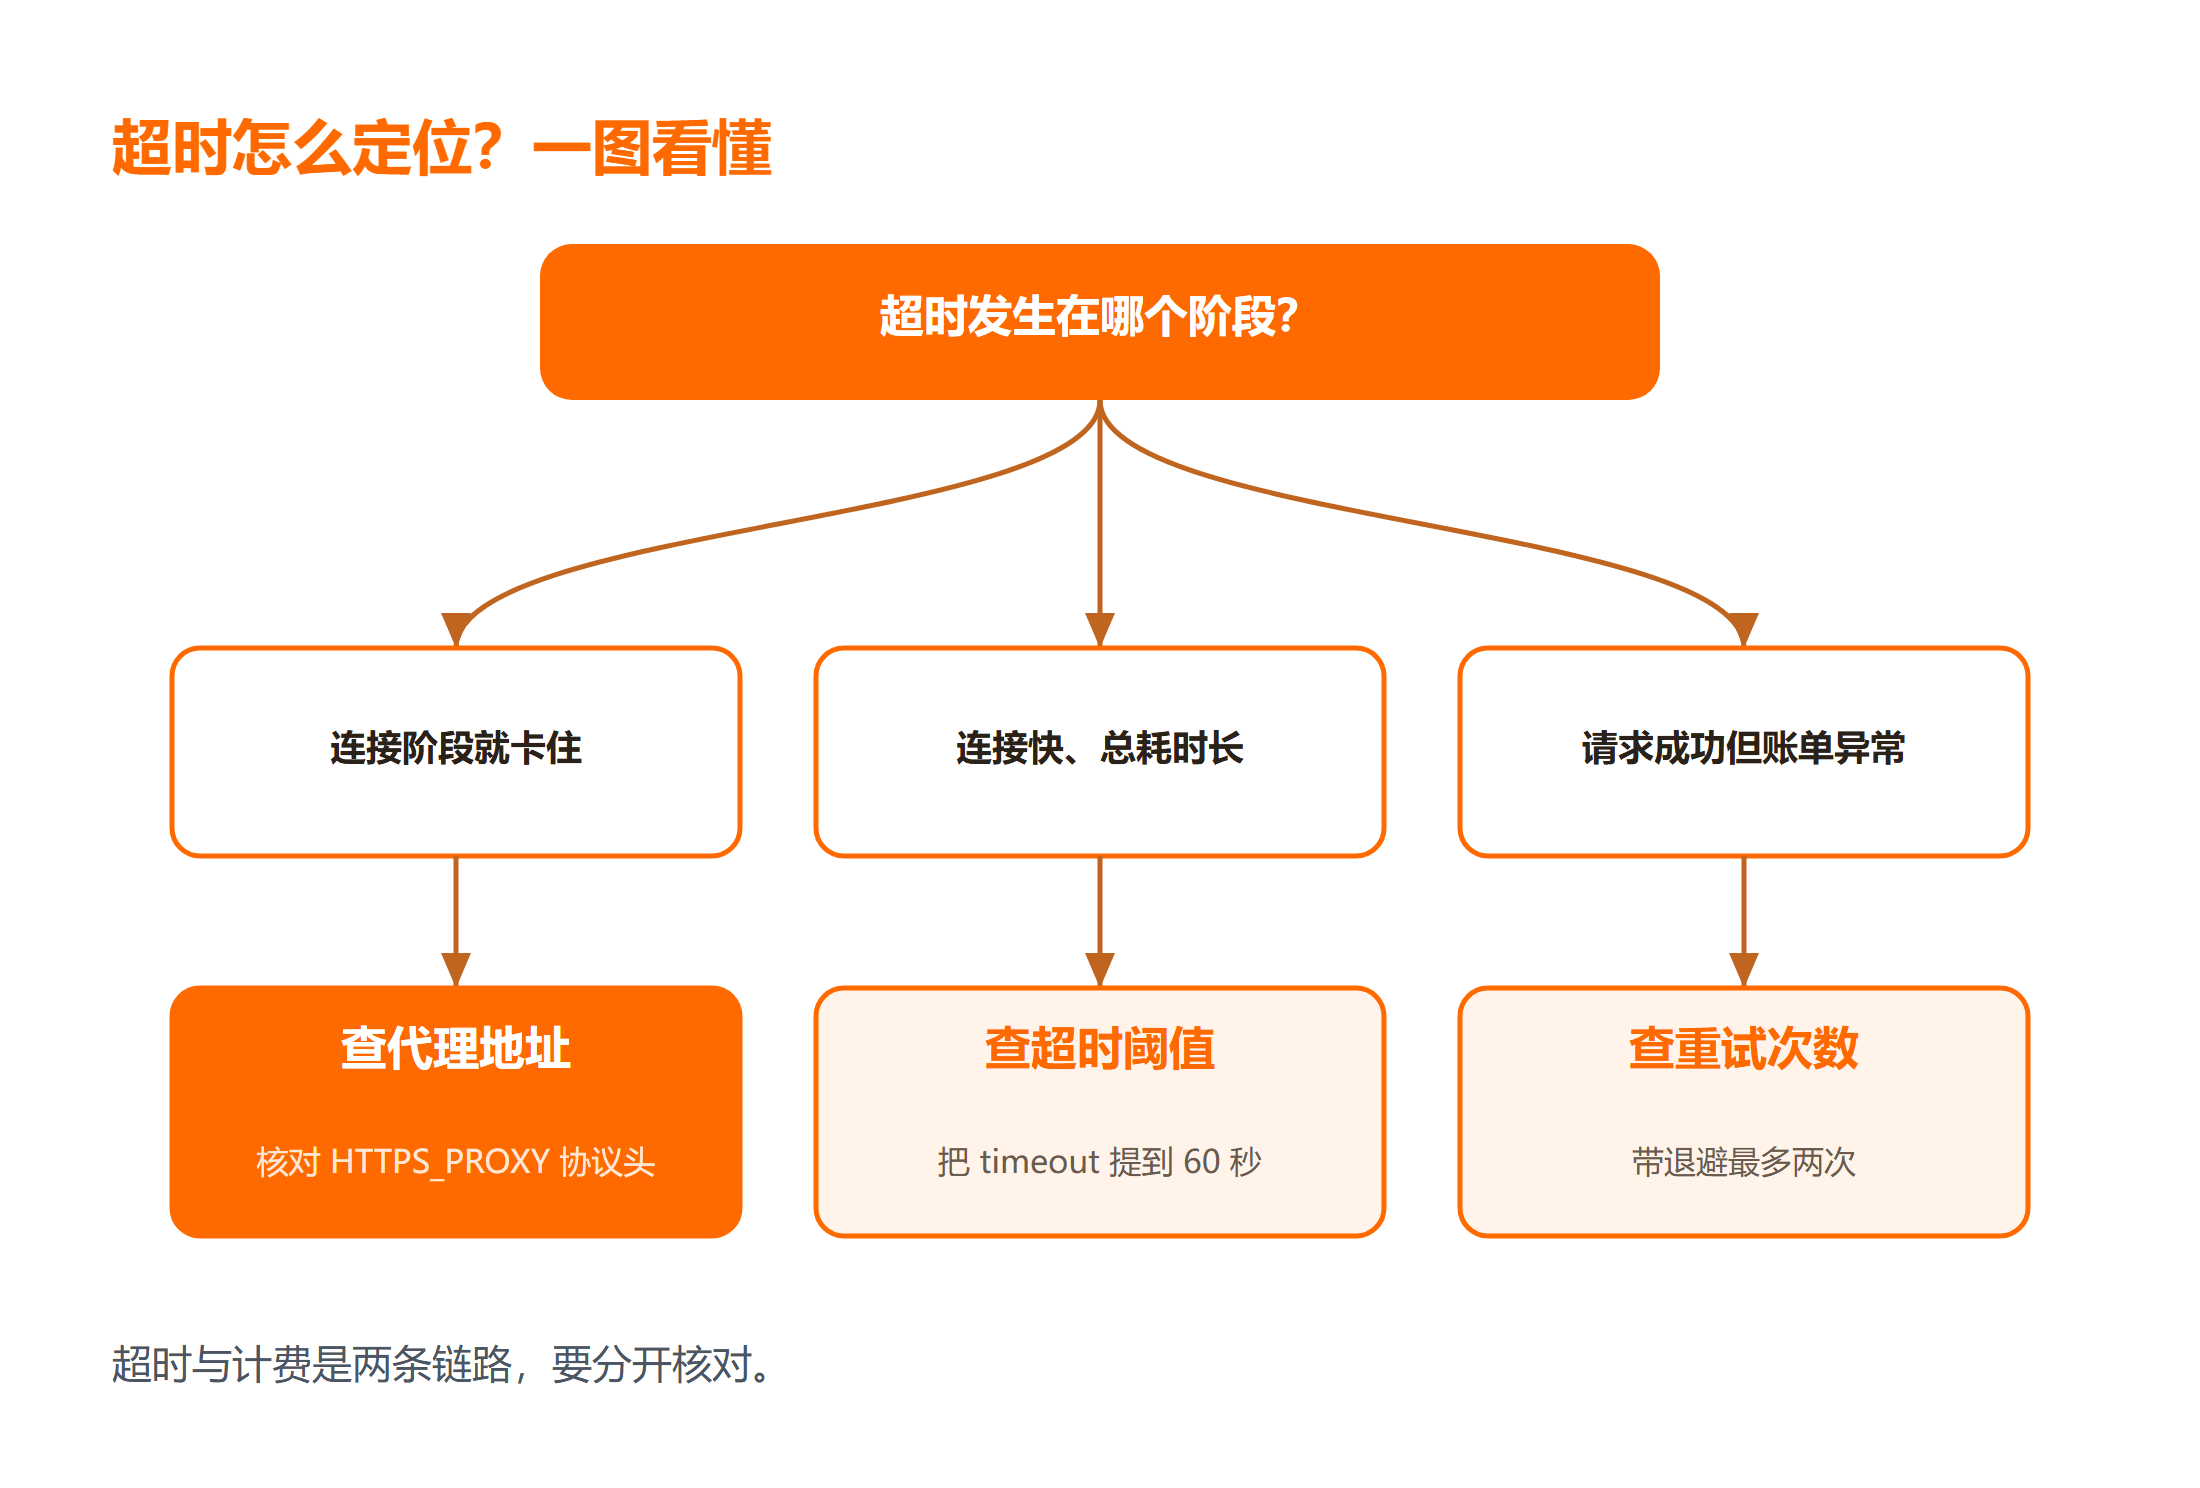
三类现象对应三类根因,逐一对号入座:
- 连接阶段超时:代理地址写错、端口不对、代理服务没启动。检查环境变量
HTTPS_PROXY是否指向正确地址,注意区分http://与https://协议头。 - 读取阶段超时:超时阈值设得太短,模型还没生成完就被掐断。把客户端 timeout 从默认值调到 60 秒以上再试。
- 账单计费异常但请求成功:多半是重试把一次请求放大成多次,或统计口径把输入、输出 Token 混算。
一个高频误区:把"超时"当成"没计费"就不管了。实际上部分网关在请求被掐断前可能已经计费,超时与计费要分开核对,不能想当然。
三、逐步修复
按根因逐项改,一次只动一个变量:
- 代理地址错误:修正
HTTPS_PROXY后重启应用,让新配置生效; - 超时过短:把客户端
timeout提到 60,观察是否还在读取阶段被掐断; - 重试放大:检查重试次数,把无脑重试改成带退避的有限重试,最多两次。
修复后重跑第一节的 curl 命令,对比三次的耗时与状态码。核对计费时,把请求次数和账单条数对一遍,确认没有一对多。语法细节可对照 Git 速查手册 之外的接口文档说明。
3.1 核对成功与失败输出
修复是否到位,看输出证据。成功时 http_code 为 200,响应体含 choices 字段;失败时按状态码分类:429 是限流、401 是密钥、504 是网关超时。把三类输出各留一份样例,下次出问题可直接比对。
预期结果(未在本机执行,标注为预期):修正代理并把超时提到 60 后,三次请求 http_code 均为 200,总耗时稳定在数秒级,账单 Token 数与请求数一一对应。
四、回归验证和复发预防
修好一次不算完,要防复发。把正确配置写成环境变量清单纳入版本管理(密钥除外),给代理地址和超时阈值加注释说明取值依据;把最小验证命令存成脚本,环境变更后跑一遍即可确认链路通畅。
| 检查项 | 错误配置 | 正确配置 | 验证方法 |
|---|---|---|---|
| 代理地址 | 协议头写错 | 与实际代理一致 | curl 看连接耗时 |
| 超时阈值 | 默认过短 | 60 秒以上 | 观察读取阶段 |
| 重试次数 | 无限重试 | 带退避最多两次 | 对账请求数 |
对比三类检查项可以看出:每一项都对应一个可观察的验证方法,配置对不对不靠猜,靠证据。性能取舍上,超时设得越长越不容易误掐,但异常请求占用连接的时间也越久,这是需要权衡的地方,不是越大越好。
总结
Token 计费代理超时要按两条链路分别定位:超时看请求能不能到达模型,计费看到达后消耗多少 Token。恢复五步走——复现报错、按现象定位根因、逐项修复、核对成功与失败输出、回归验证防复发。高频错误集中在代理地址、超时阈值和重试放大三处,每处都有对应的可观察验证方法。把正确配置纳入版本管理、保留最小验证脚本,能显著降低复发概率。
常见问题
Q:请求超时了,为什么账单上还有 Token 消耗?
A:请求被客户端掐断前,网关或服务端可能已经处理了一部分并计费。超时与计费是两条链路,超时后要去控制台核对实际计费记录,不能默认"超时就不计费"。
Q:超时阈值设多少合适?
A:没有通用值,要看模型生成长度和网络状况。短对话 30 到 60 秒通常够用,长生成要更大。设置过长会让异常请求久占连接,过短会误掐正常请求,按实际耗时分布调整。
Q:重试到底该设几次?
A:建议带指数退避、最多两次。无脑重试会把一次请求放大成多次,既拖慢响应又让账单翻倍。重试前先判断错误类型,限流和连接失败适合重试,401 这类配置错误重试没有意义。
延伸学习
想把这块知识系统补齐,可以按这个顺序来:
- 想系统学 AI 编程开发,可以看 腾讯CodeBuddy+AI设计网页实战课程;
- 对照"Token 是什么、怎么计费"的基础说明,翻 Token是什么大模型中的含义;
- 想把计费口径和上下文窗口一起弄清,看 Token是什么大模型计费怎么算。



