 TRAE-AI编程

可以转,而且 Java 在这件事上并不吃亏。但你真正要补的不是一门新语言,而是一整套新习惯:从「写确定的逻辑」转向「跟一个不确定的输出打交道」,包括提示词组装、超时与重试、结果校验、成本控制。语言还是 Java,思维方式要换。
很多 Java 开发者担心自己被排除在这波浪潮之外,理由是生态里 Python 的资料更多。实际上企业侧大量存量的账号体系、权限、审计、网关都是 Java 写的,把大模型能力接进这些系统,恰恰是 Java 开发者的主场。
本文给出三种接法的区别与代价,配一个可直接编译运行的 Java 示例,并说明哪些任务适合交给大模型、哪些任务交给它反而更麻烦。今天这篇文章,编程狮就把这条转型路径讲透。
先看结论
Java 转大模型应用开发完全可行,关键在选对接法。三种做法分别是:直接调 HTTP 接口、接编排框架、做带工具的智能体。第一种最轻,适合把现有系统加一个「问答框」;第二种省事,适合流程固定的场景;第三种最重,只有任务确实需要多步决策时才值得上。
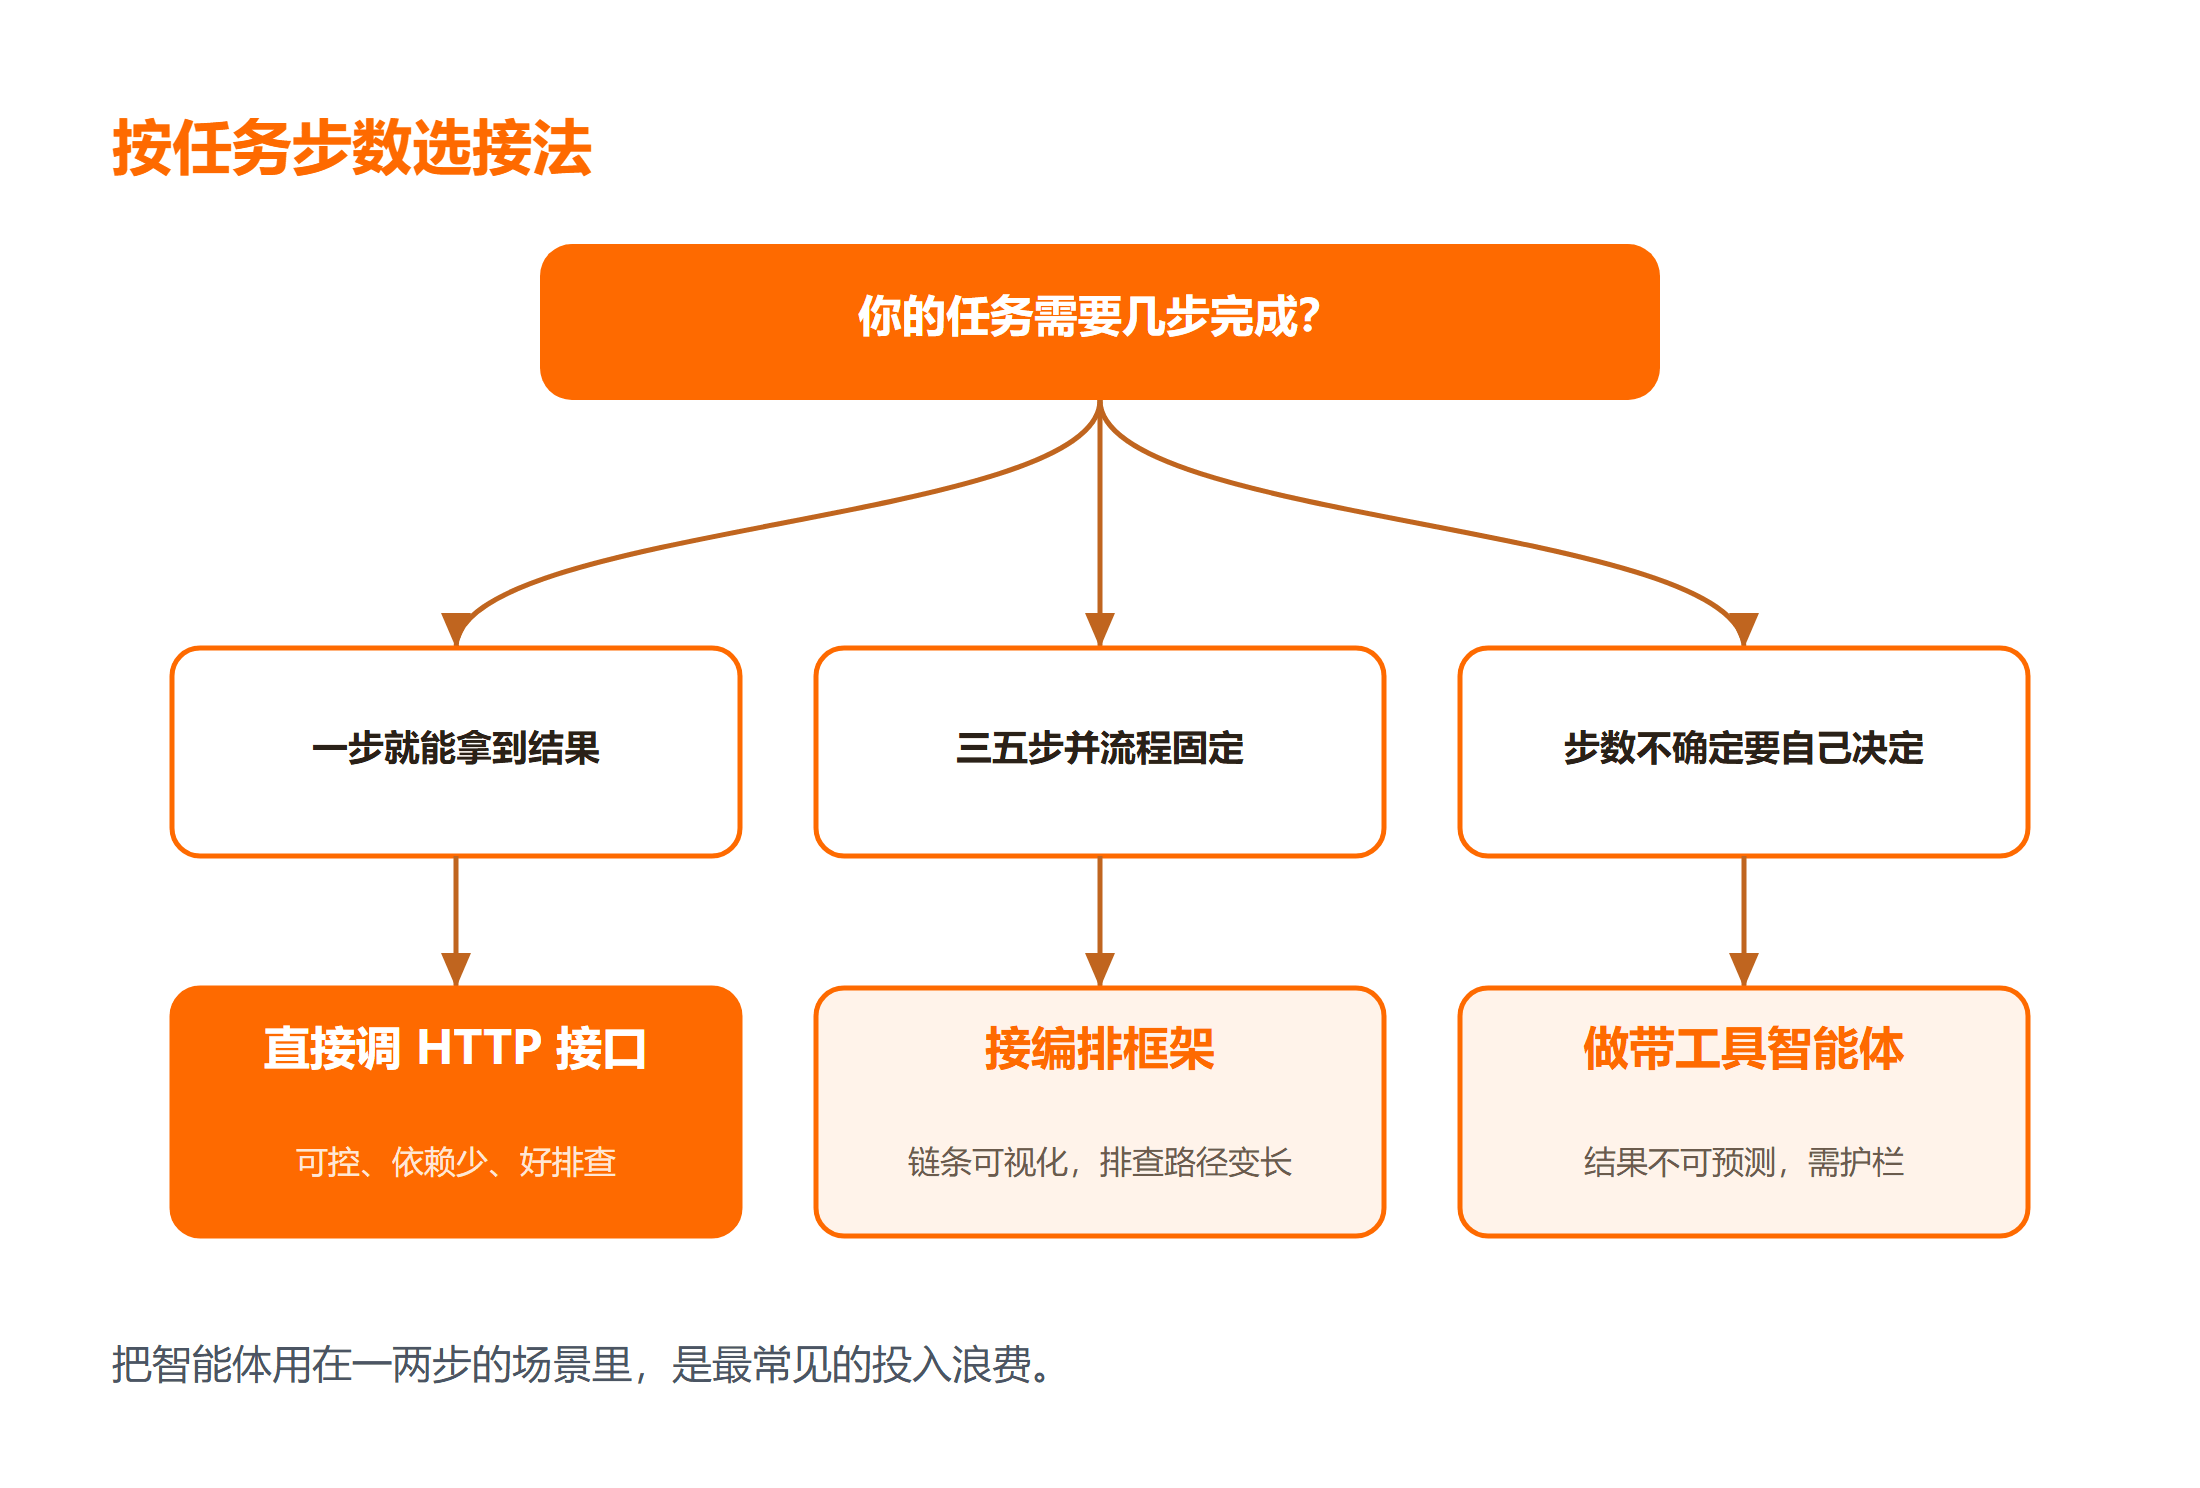
选择的判断依据是任务步数:一步能完成的用直接调用,三五步固定流程用编排框架,步数不确定、需要自己决定下一步的才用智能体。把第三种用在第一种的场景里,是最常见的浪费。
想看 AI 编程能力的完整分类,可以先翻 AI 编程指南,把能力边界摸清楚再决定投入多少。
一、先说清楚「转」的到底是哪一层
大模型应用开发这个词里,「大模型」是别人的,「应用开发」才是你的活。
1.1 语言层几乎不用换
Java 调大模型,本质就是发一个 HTTP 请求、拿回一段 JSON。JDK 11 起自带的 HttpClient 就够用,不需要先学一门新语言。你原有的工程能力——连接池、线程池、日志、鉴权——全都能直接复用。语法层面若有个别生疏,翻一遍 Java 教程 的基础章节就能补回来。
1.2 真正要补的是四件事
| 要补的能力 | 为什么 Java 项目里容易漏 | 典型后果 |
|---|---|---|
| 提示词组装 | 以前输入是结构化的,现在是自然语言 | 输出不稳定,同样的输入结果飘 |
| 超时与重试 | 大模型接口耗时远高于内网调用 | 线程被打满,接口雪崩 |
| 结果校验 | 输出是自由文本,不是强类型对象 | 脏数据直接落库 |
| 成本控制 | 按 token 计费,和 CPU 成本模型完全不同 | 一个循环把预算烧完 |
这四项里,超时与重试是最容易翻车的一项。大模型接口单次耗时常常在秒级,而很多 Java 项目沿用的是给内网服务配的超时值,直接套上去会把线程池占满。
⚠️ 注意:把密钥写在代码里是这类项目最常见的安全事故。密钥要走配置中心或环境变量,不要进版本库。
二、三种接法的区别与代价
先看清代价,再动手,能省掉大量返工。
2.1 直接调 HTTP 接口
适合场景:系统里加一个问答框、给客服系统加个摘要功能。优点是可控、依赖少、出问题好排查;代价是提示词、重试、解析都要自己写。
2.2 接编排框架
适合场景:流程固定,比如「先检索、再生成、最后格式校验」。优点是链条可视化、组件可复用;代价是多一层抽象,出错时排查路径变长,且版本升级常有破坏性变更。
2.3 做带工具的智能体
适合场景:步数不确定,需要模型自己决定下一步调什么。优点是能处理开放任务;代价是结果不可预测、成本不可控、需要额外的护栏设计。
💡 小提示:先用直接调用把链路跑通,再考虑要不要上框架。很多团队一上来就上框架,最后发现自己只用了其中一个步骤,却背上了整层的维护成本。
三、最小可运行示例:Java 调一次接口并解析
下面是一个完整可编译的单文件示例,用 JDK 11 自带的 HttpClient 发一次请求并取出返回文本。版本号按你本机的 JDK 调整。
import java.net.URI;
import java.net.http.HttpClient;
import java.net.http.HttpRequest;
import java.net.http.HttpResponse;
import java.time.Duration;
import java.util.Map;

public class LlmQuickStart {
    public static void main(String[] args) throws Exception {
        String apiKey = System.getenv("W3CSCHOOL_LLM_KEY");
        String body = """
                {"model":"qwen-plus","input":{"messages":[{"role":"user","content":"用一句话解释什么是 JSON"}]}}
                """;

        HttpClient client = HttpClient.newBuilder()
                .connectTimeout(Duration.ofSeconds(5))
                .build();

        HttpRequest request = HttpRequest.newBuilder()
                .uri(URI.create("https://www.w3cschool.cn/api/demo/llm"))
                .timeout(Duration.ofSeconds(30))
                .header("Content-Type", "application/json")
                .header("Authorization", "Bearer " + apiKey)
                .POST(HttpRequest.BodyPublishers.ofString(body))
                .build();

        HttpResponse<String> resp = client.send(request, HttpResponse.BodyHandlers.ofString());
        System.out.println("status=" + resp.statusCode());
        System.out.println("body=" + resp.body());
    }
}
上面这段代码做的是:从环境变量读密钥,构造一个 JSON 请求体,用 5 秒连接超时和 30 秒整体超时发出请求,最后打印状态码与响应体。示例依赖 JDK 11 及以上版本,密钥从环境变量读取而不是硬编码。
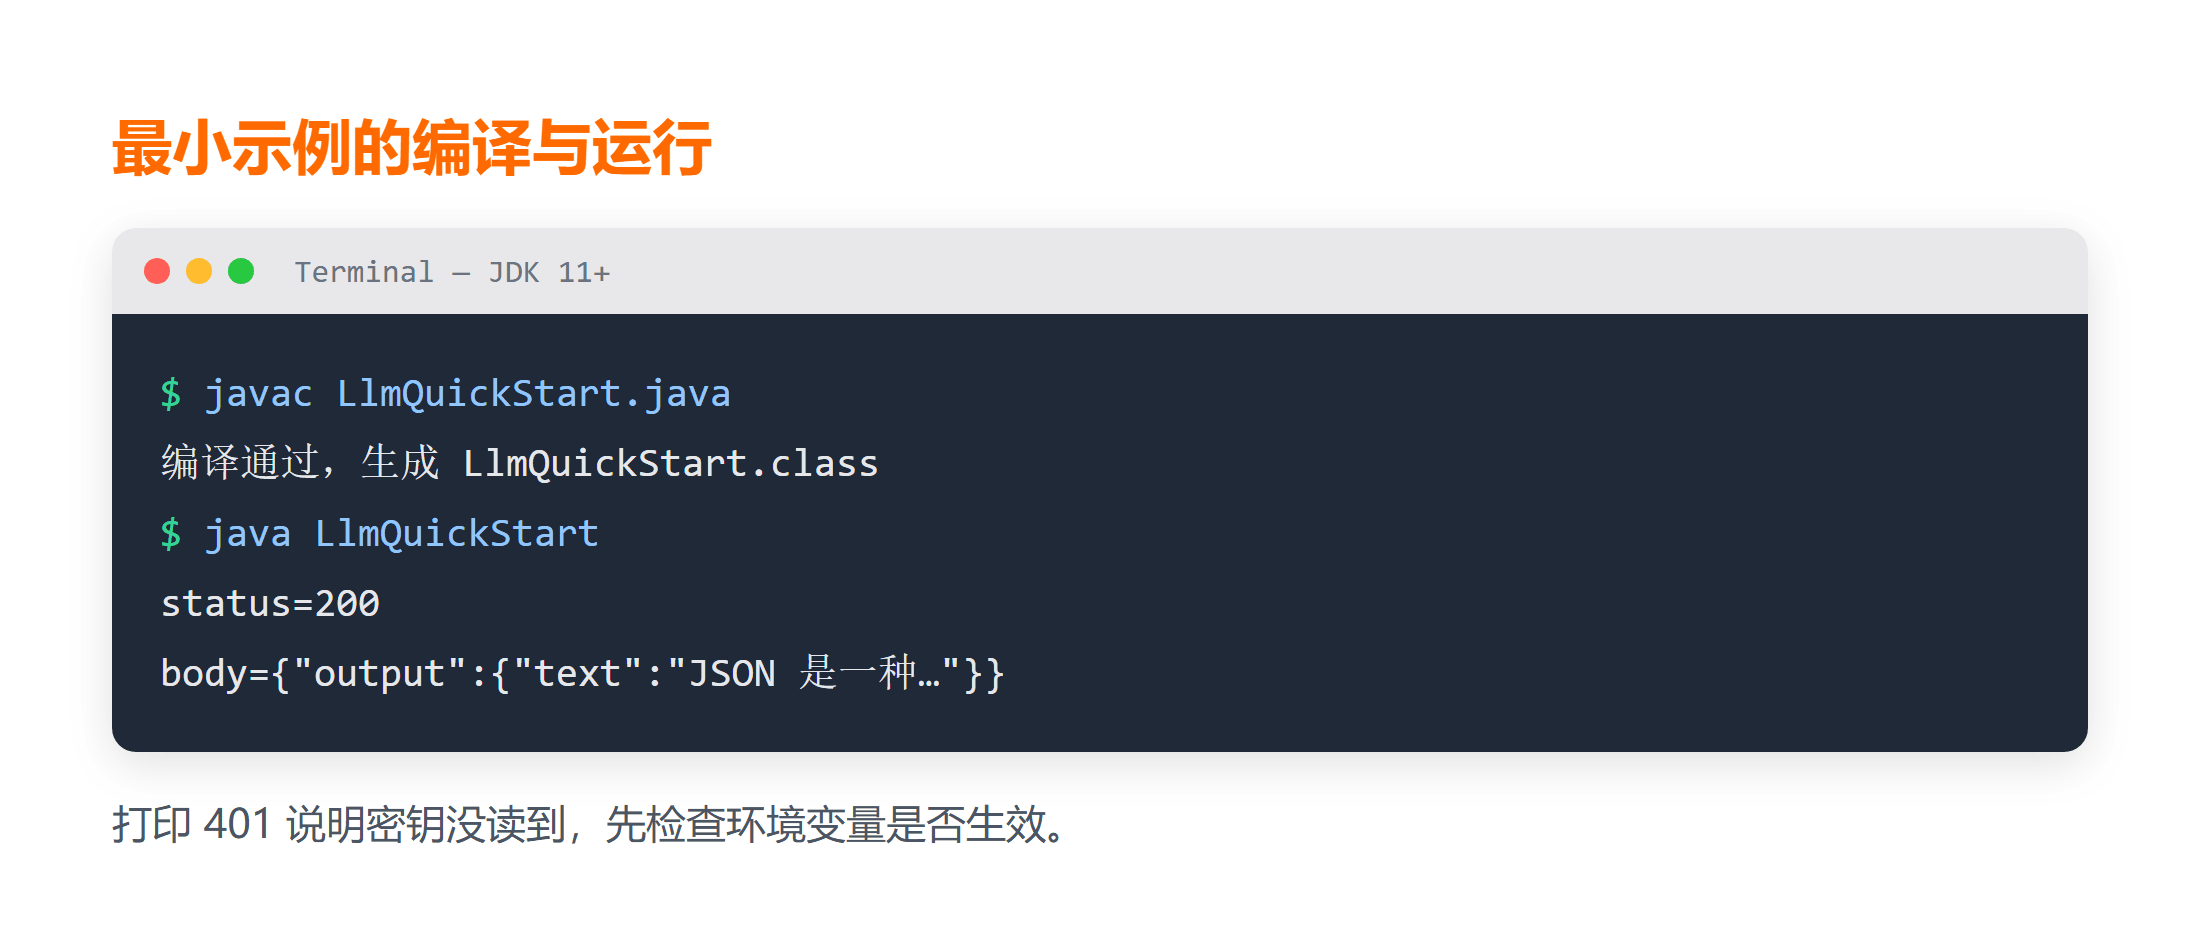
编译与运行的命令如下(预期结果:打印出状态码与响应体)。
javac LlmQuickStart.java
java LlmQuickStart
上面两条命令做的是编译并运行这个类。预期结果(未执行,依据官方文档对 HttpClient 行为的描述)是终端打印 status=200 与一段 JSON 文本;若打印的是 401,说明密钥没读到,先检查环境变量是否生效。
四、边界与取舍:哪些活不该交给它
判断边界比学会调用更重要。
4.1 适合交给它的任务
文本摘要、格式转换、意图识别、草稿生成、代码解释。这类任务的共同点是:输出允许有轻微偏差,且人能在几秒内判断对错。
4.2 不适合交给它的任务
金额计算、权限判定、库存扣减、任何需要精确且可审计的结果。这类任务要的是确定性,而大模型给的是概率性的输出。把这类活交给它,你会花更多时间在做校验上,比直接写逻辑更贵。
4.3 三个高频失败点
第一,超时配置沿用内网值,导致线程池被打满。第二,没做结果校验就把输出落库,脏数据进了系统。第三,在循环里无节制调用,成本失控。
对应的修复方式分别是:单独给大模型调用配置超时与隔离的线程池;把输出按 Schema 校验后再落库;在循环外层加调用次数上限。这三项不需要框架,写几行代码就能补上。
总结
Java 转大模型应用开发是可以的,而且你原有的工程能力在这里是优势。要补的是四件事:提示词组装、超时与重试、结果校验、成本控制。接法按任务步数选,一步完成就直接用 HTTP 调用,不要一上来就上框架。
要点带走:
- 语言不用换,JDK 自带 HttpClient 就能跑通第一条链路;
- 超时值必须单独配,套用内网值是线程池被打满的主因;
- 涉及金额、权限、库存的任务不要交给它,校验成本高于直接写逻辑。
下一步建议先把上面的示例改成你自己项目里的一个真实接口,跑通一次再谈框架。想系统补齐这块,可以顺着 AI 编程技能教程 往下看。
常见问题
Q:Java 做大模型应用开发是不是不如 Python?
A:资料数量上 Python 更多,但企业侧存量系统在 Java 上。接模型是一层薄薄的 HTTP 调用,真正的活在系统集成,这恰恰是 Java 的主场。
Q:一定要学一个编排框架吗?
A:不一定。任务只有一两步时,直接发请求更可控。框架的价值在流程固定且步骤多的时候才体现出来。
Q:大模型调用超时一般配多少合适?
A:没有通用值,要按模型与输入长度实测。经验起点是连接超时 5 秒、整体超时 30 秒,再根据实际耗时分布调整。
Q:输出直接落库有什么风险?
A:输出是自由文本,字段缺失、格式漂移都会发生。落库前必须按 Schema 校验,校验失败要有明确的失败处理路径。
延伸学习
想把这条路走顺,可以按这个顺序来:
- 读一篇相关笔记 Java 项目快速集成 AI,看真实集成步骤;
- 想动手练,Java 配套课程 把工程基础补扎实;
- 语法细节记不住时,翻 Java 速查手册 最快。