
 TRAE-AI编程

思维导图节点自动排布,本质是给节点树算坐标。常见做法有四种:树形分层布局、力导向布局、手动指定后自动避让、网格/辐射布局。选哪种看你的图是层级结构还是自由发散,以及节点规模多大。本文先给结论,再对比它们的适用场景、时间复杂度与边界,帮你按图的结构与规模选型,不被「看起来都能摆开」的假象误导。无论你做知识图谱、组织架构图还是思维导图编辑器,自动布局都决定了图好不好读、交互顺不顺,是可视化里最值得花心思的一层。先理解一件事:自动布局只负责算出每个节点的 x/y,真正的绘制是渲染层的事,两者解耦才好单独优化。
先看结论
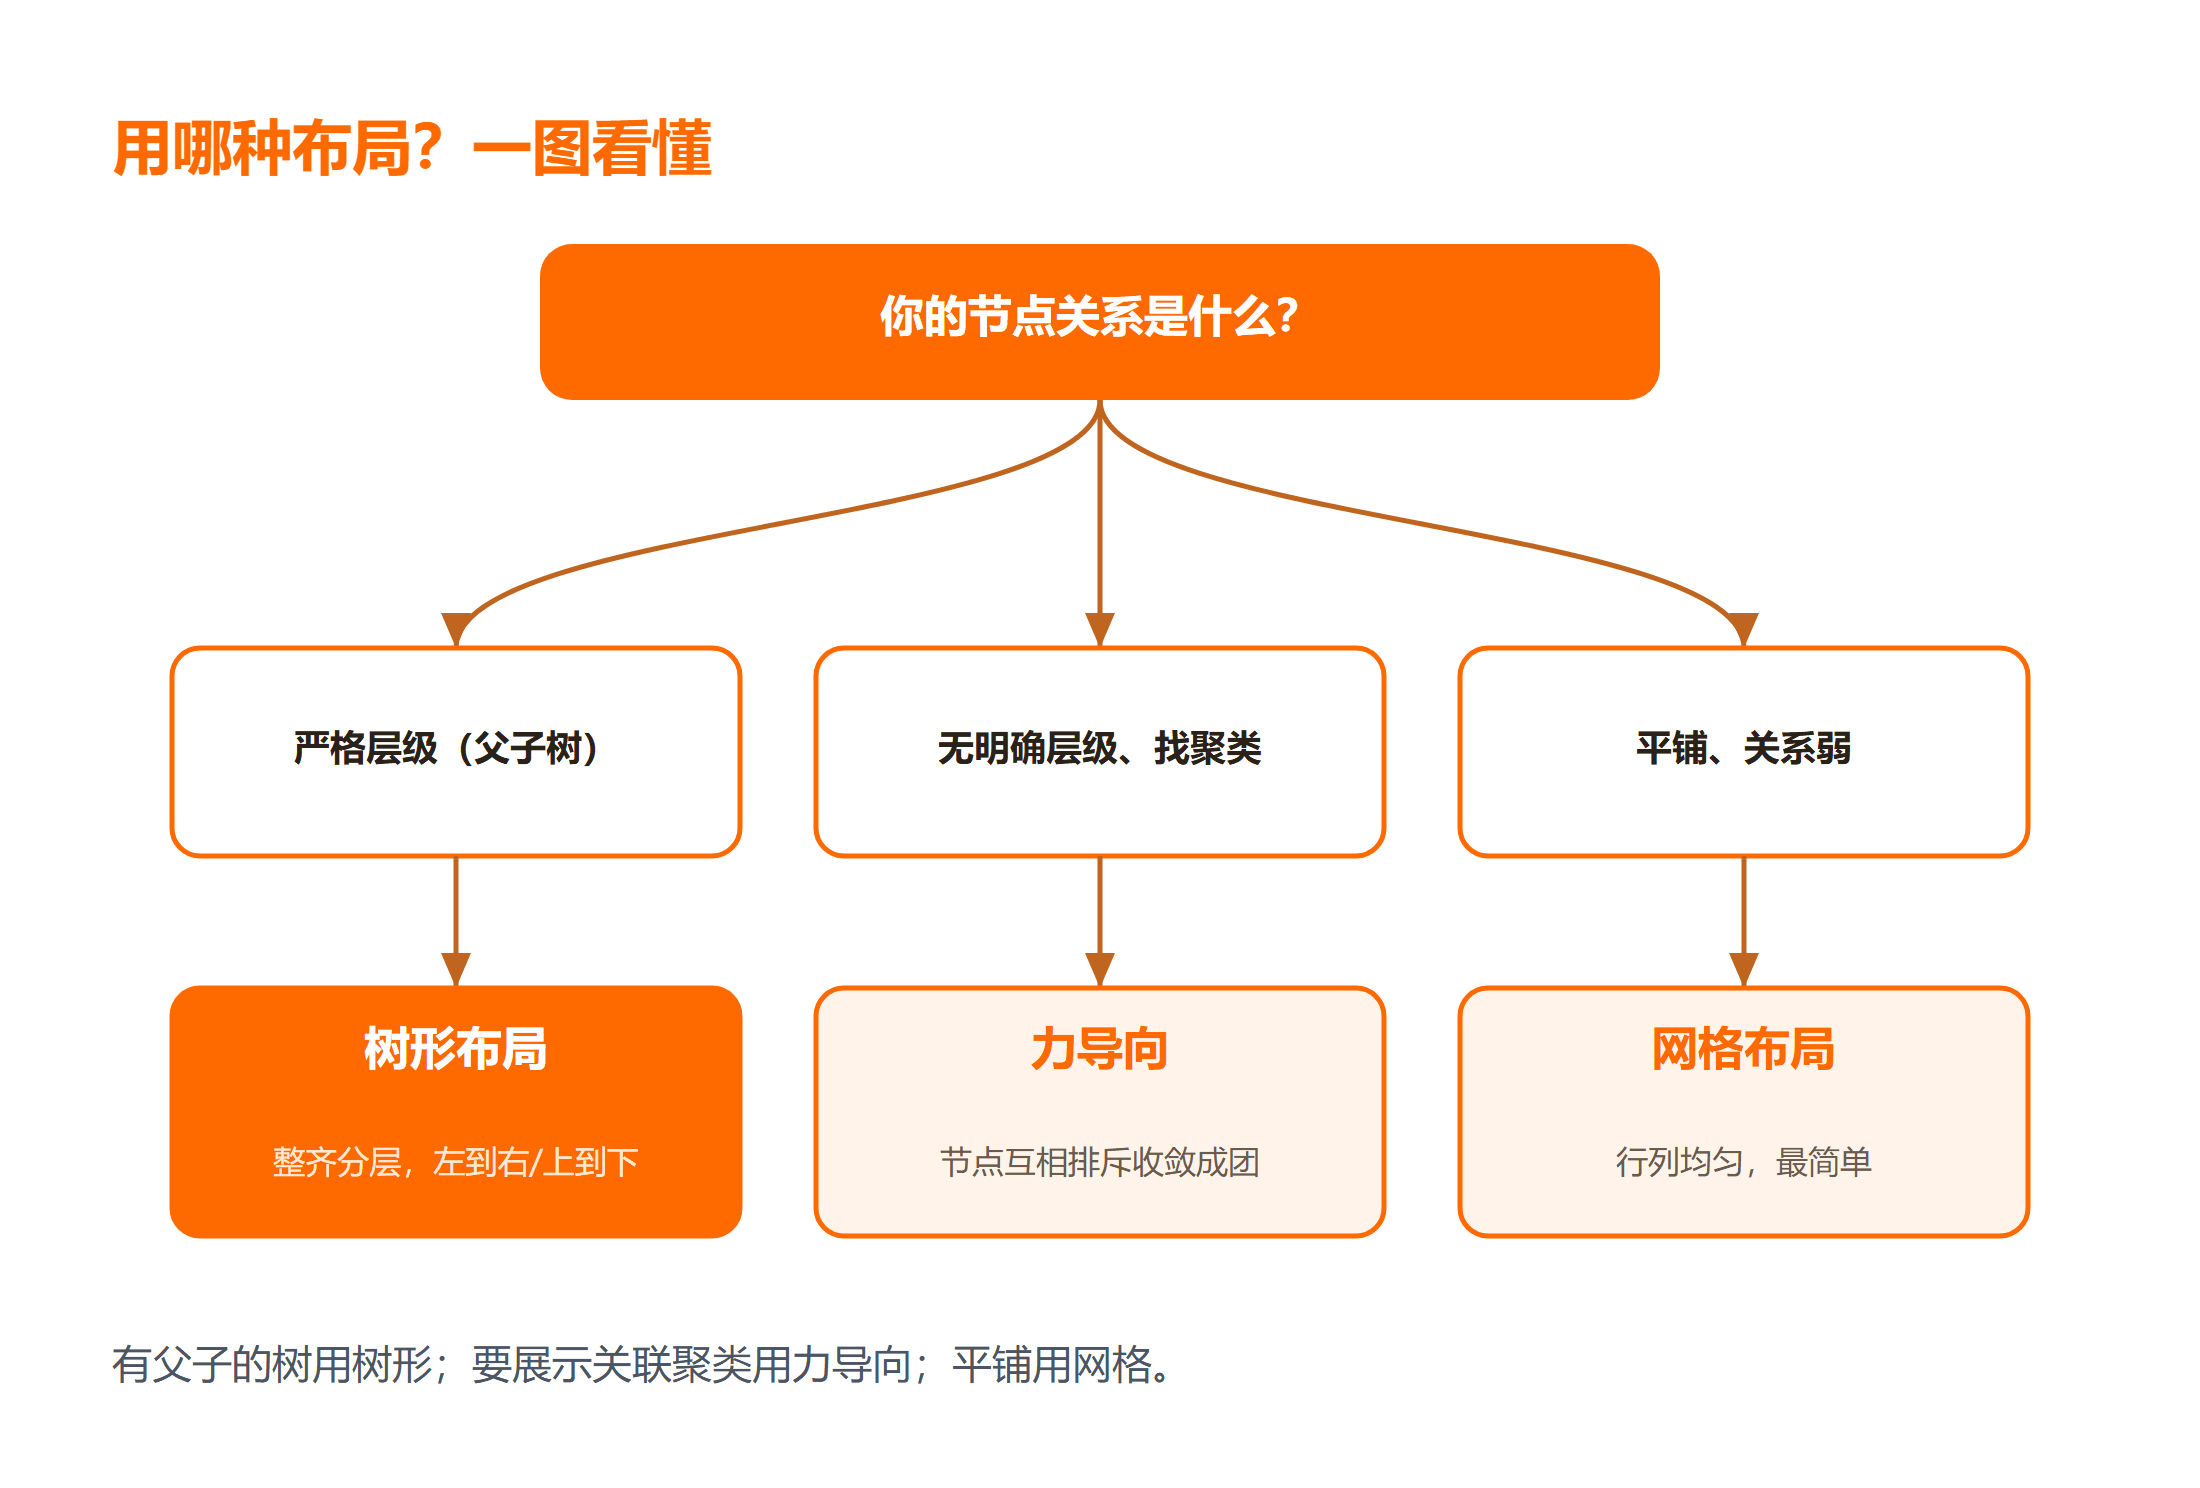
先把结论摆清楚。节点自动布局没有万能解:结构清晰、有父子层级的图用树形分层最稳,节点间是网状关系、强调聚类的用 力导向布局 更自然。手动指定后自动避让适合半自动编辑,网格/辐射布局适合知识图谱类放射结构。选型口诀:有层级用树,有网用力学,人工为主用避让,放射用网格。别拿力导向去排一棵纯目录树,所得坐标会乱飞且不可复现。
前置:准备一份节点树数据;操作:按图的结构选算法三步试跑;验证:导出坐标看是否稳定可复现;失败处理:坐标乱飞就退回树形、不可复现就加固定种子。
理解了布局的分类,还要理解坐标系。所有算法最终都输出一份「节点 id → (x, y)」的映射,这份映射就是节点位置。节点位置一旦算好,渲染层只负责把坐标画出来。配合 JavaScript 入门教程 理解坐标计算,能把布局从「玄学」变成可预测的函数。
一、树形分层布局(层级最稳)
树形布局按深度分层:根在顶层,子节点逐层往下,同层横向均分。它是思维导图最经典的算法,输出稳定、可复现,且天然贴合「中心主题—分支」的认知结构,适合绝大多数目录型、大纲型思维导图。
实现上先递归算每棵子树的高度,再自底向上分配 y、自顶向下分配 x:
function treeLayout(node, depth = 0, xCursor = { v: 0 }) {
  if (!node.children.length) {
    node.y = depth * 80;
    node.x = xCursor.v;
    xCursor.v += 140;
    return;
  }
  node.children.forEach(c => treeLayout(c, depth + 1, xCursor));
  const xs = node.children.map(c => c.x);
  node.x = (Math.min(...xs) + Math.max(...xs)) / 2;
  node.y = depth * 80;
}
坐标体系可参考 WebGL 速查手册 里的视口变换,把算出的逻辑坐标映射到画布像素。画布渲染时,这一步只负责算坐标,真正落笔是把这些坐标交给渲染层,两者解耦才好单独优化。
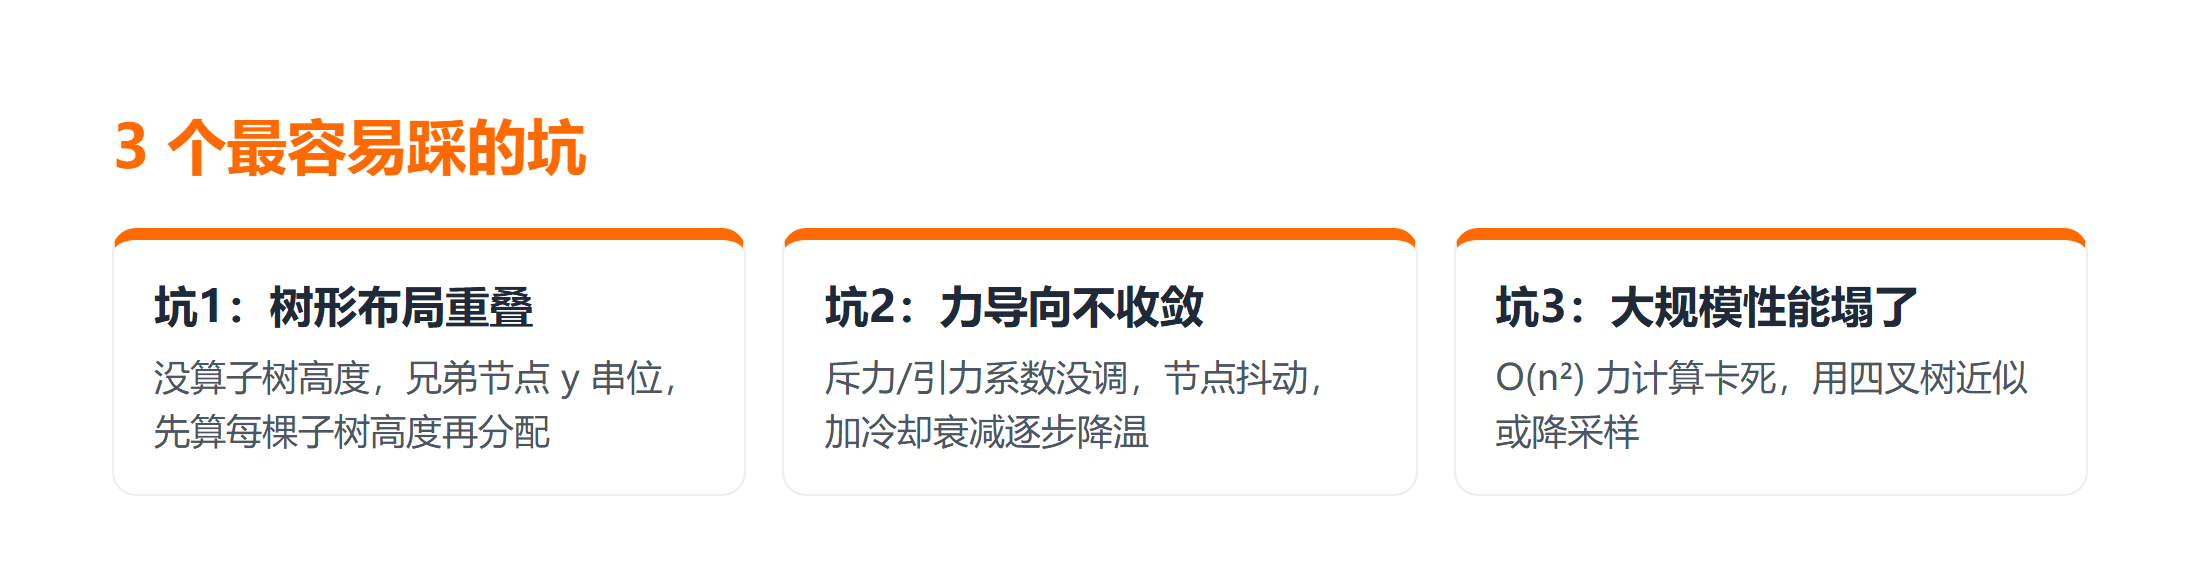
边界:当某分支特别深、另一分支很浅时,浅分支会留出大片空白,需要后处理压缩列间距。调整节点位置前,先做一遍子树宽度统计,对空列做合并,否则图会向右无限摊开。工程上建议把「节点位置计算」和「节点位置美化」拆成两步:先出可复现的初稿,再做列压缩和边距规整。
二、力导向布局(自由发散)
力导向把节点当带电粒子:相连的有引力、互相有斥力,迭代若干轮后达到平衡。它适合节点间是多对多关系、没有明显层级的图,聚类效果远胜树形,是社交网络、知识图谱的常用选择。
function forceStep(nodes, edges) {
  nodes.forEach(a => nodes.forEach(b => {
    if (a === b) return;
    const dx = a.x - b.x, dy = a.y - b.y;
    const d = Math.hypot(dx, dy) || 1;
    const rep = 2000 / (d * d); // 斥力
    a.x += (dx / d) * rep; a.y += (dy / d) * rep;
  }));
  edges.forEach(([s, t]) => { /* 弹簧引力把两端拉近 */ });
}
代价是结果依赖初值和随机性,同一张图每次跑坐标不同,不适合需要稳定导出的场景。工程上常用 Spring 速查手册 类比弹簧模型去理解引力项。节点上千时每轮是 O(n²),要上 Barnes-Hut 近似,否则卡死。
力导向的收敛过程很像物理仿真:每一轮都重新计算所有节点的合力,迭代到位移小于阈值才停。生产环境里建议限制最大迭代轮数,避免极端初始布局陷入长时间抖动,也方便在超时后直接回退到上一次稳定坐标。
关于模块隔离的工程思路,可以看 微前端隔离方案,其中「作用域互不污染」的原则和自动避让「各节点占各自格子」异曲同工。力导向输出的节点位置每次都变,若要做差异更新,务必在首次布局后把节点位置写库缓存,后续直接读缓存而非重算。
三、手动指定后自动避让与网格辐射
半自动编辑常见做法是:用户拖到大致位置,松手后做碰撞检测,把重叠节点沿最小位移方向推开(自动避让)。它尊重人的意图,只解决「别叠在一起」。网格/辐射布局则把中心节点放圆心,其余按角度均分放射排布,适合中心辐射型知识图谱。
三种进阶做法的取舍:避让保意图但依赖人工,网格放射美观但只适合放射结构,力导向自动但不可复现。落地时推荐组合——先按结构选树形或力导向算出初稿,再叠加自动避让做美化,兼顾自动与可控。这样即使后续要导出 PNG 或 SVG,节点位置也是确定可复现的。注意自动避让只调整重叠处的局部节点位置,不会全局重排,因此初稿质量直接决定最终观感。
实操检查清单
- 前置:先确认你的图是层级结构还是网状结构,并准备好节点树数据。
- 操作:按图的结构选算法跑一遍,观察实际坐标是否稳定可复现。
- 检查:导出坐标看是否稳定,预期与算法特性一致(树形可复现、力导向每次不同)。
- 失败处理:若坐标乱飞就退回树形、不可复现就加固定种子,逐条修复并重新验证。
- 适用边界:有层级用树、有网用力学、人工为主用避让,性能上节点上千需上近似算法。
总结
回到开头:思维导图节点自动排布按结构选型。纯层级用树形分层,网状关系用力导向,人工为主用避让,放射结构用网格。实践中常把「结构算法出初稿 + 自动避让做美化」组合,既自动又可控。选错算法最典型的症状是:树形图用力导向导致坐标乱飞不可复现,或网状图用树形导致关系被强行压平失真。记住核心原则——布局算法只算节点位置,渲染层只画节点位置,分工明确才好维护。
常见问题
Q:为什么力导向每次布局都不一样?
因为它从随机初值迭代收敛,且含随机扰动,没有固定种子就会每次不同。需要稳定导出时,固定初值种子、增加迭代轮数,或在首次布局后把节点位置存库,后续直接读缓存而非重算。
Q:树形布局出现大片空白怎么处理?
浅分支在深树里会留白。常见后处理是按子树宽度压缩列间距,或对空列做合并。也可以改用「紧凑树形」,让父节点 x 取子节点均值的同时,对同级做宽度感知的均分。
Q:节点上千时力导向太慢怎么办?
每轮斥力计算是 O(n²)。引入 Barnes-Hut 四叉树把远处节点聚合近似,复杂度降到 O(n log n);或限制每轮只更新位移超阈值的节点,配合 Web Worker 避免主线程卡顿。
Q:树形布局和力导向能混用吗?
可以,但要在同一份数据上分层处理:先用力导向算整体聚类,再对层级清晰的分支套树形坐标做局部规整。混用的前提是你能分清哪些节点该听力学、哪些该听层级,否则两股力互相打架,图会不停抖动。
Q:布局结果要不要在后端算?
节点几百以内放前端即可,依赖少、改起来快;节点上千或需要多人看到同一份坐标时,放到后端算并用缓存存结果,前端只负责拉坐标渲染,能省掉重复计算和不一致。



