
 TRAE-AI编程

结论先说:迷宫类题目测试用例过不全,八成不是搜索算法写错,而是三件事没处理干净——多组输入之间没清空状态、要最短路径却用了深度优先、以及输出格式和题目要求的行列顺序对不上。先把这三处对齐,再谈算法优化。
典型的挫败场景是这样的:样例能过,提交后只通过一部分测试点,剩下的报"答案错误"或者超时。你反复检查 DFS 的四个方向,看起来完全没问题,但就是过不去。这类题目里,算法思路正确只是及格线,真正拉开差距的是边界处理。
本文用一个统一的迷宫模型讲清三种做法的取舍,给出可编译的完整 BFS 实现、预期输出与失败分支,并列出三个最容易丢分的边界。代码基于 C++11 及以后的标准库(<queue>、<vector>、<string>)编写,未在本机编译执行,请按你的判题环境验证。
先看结论
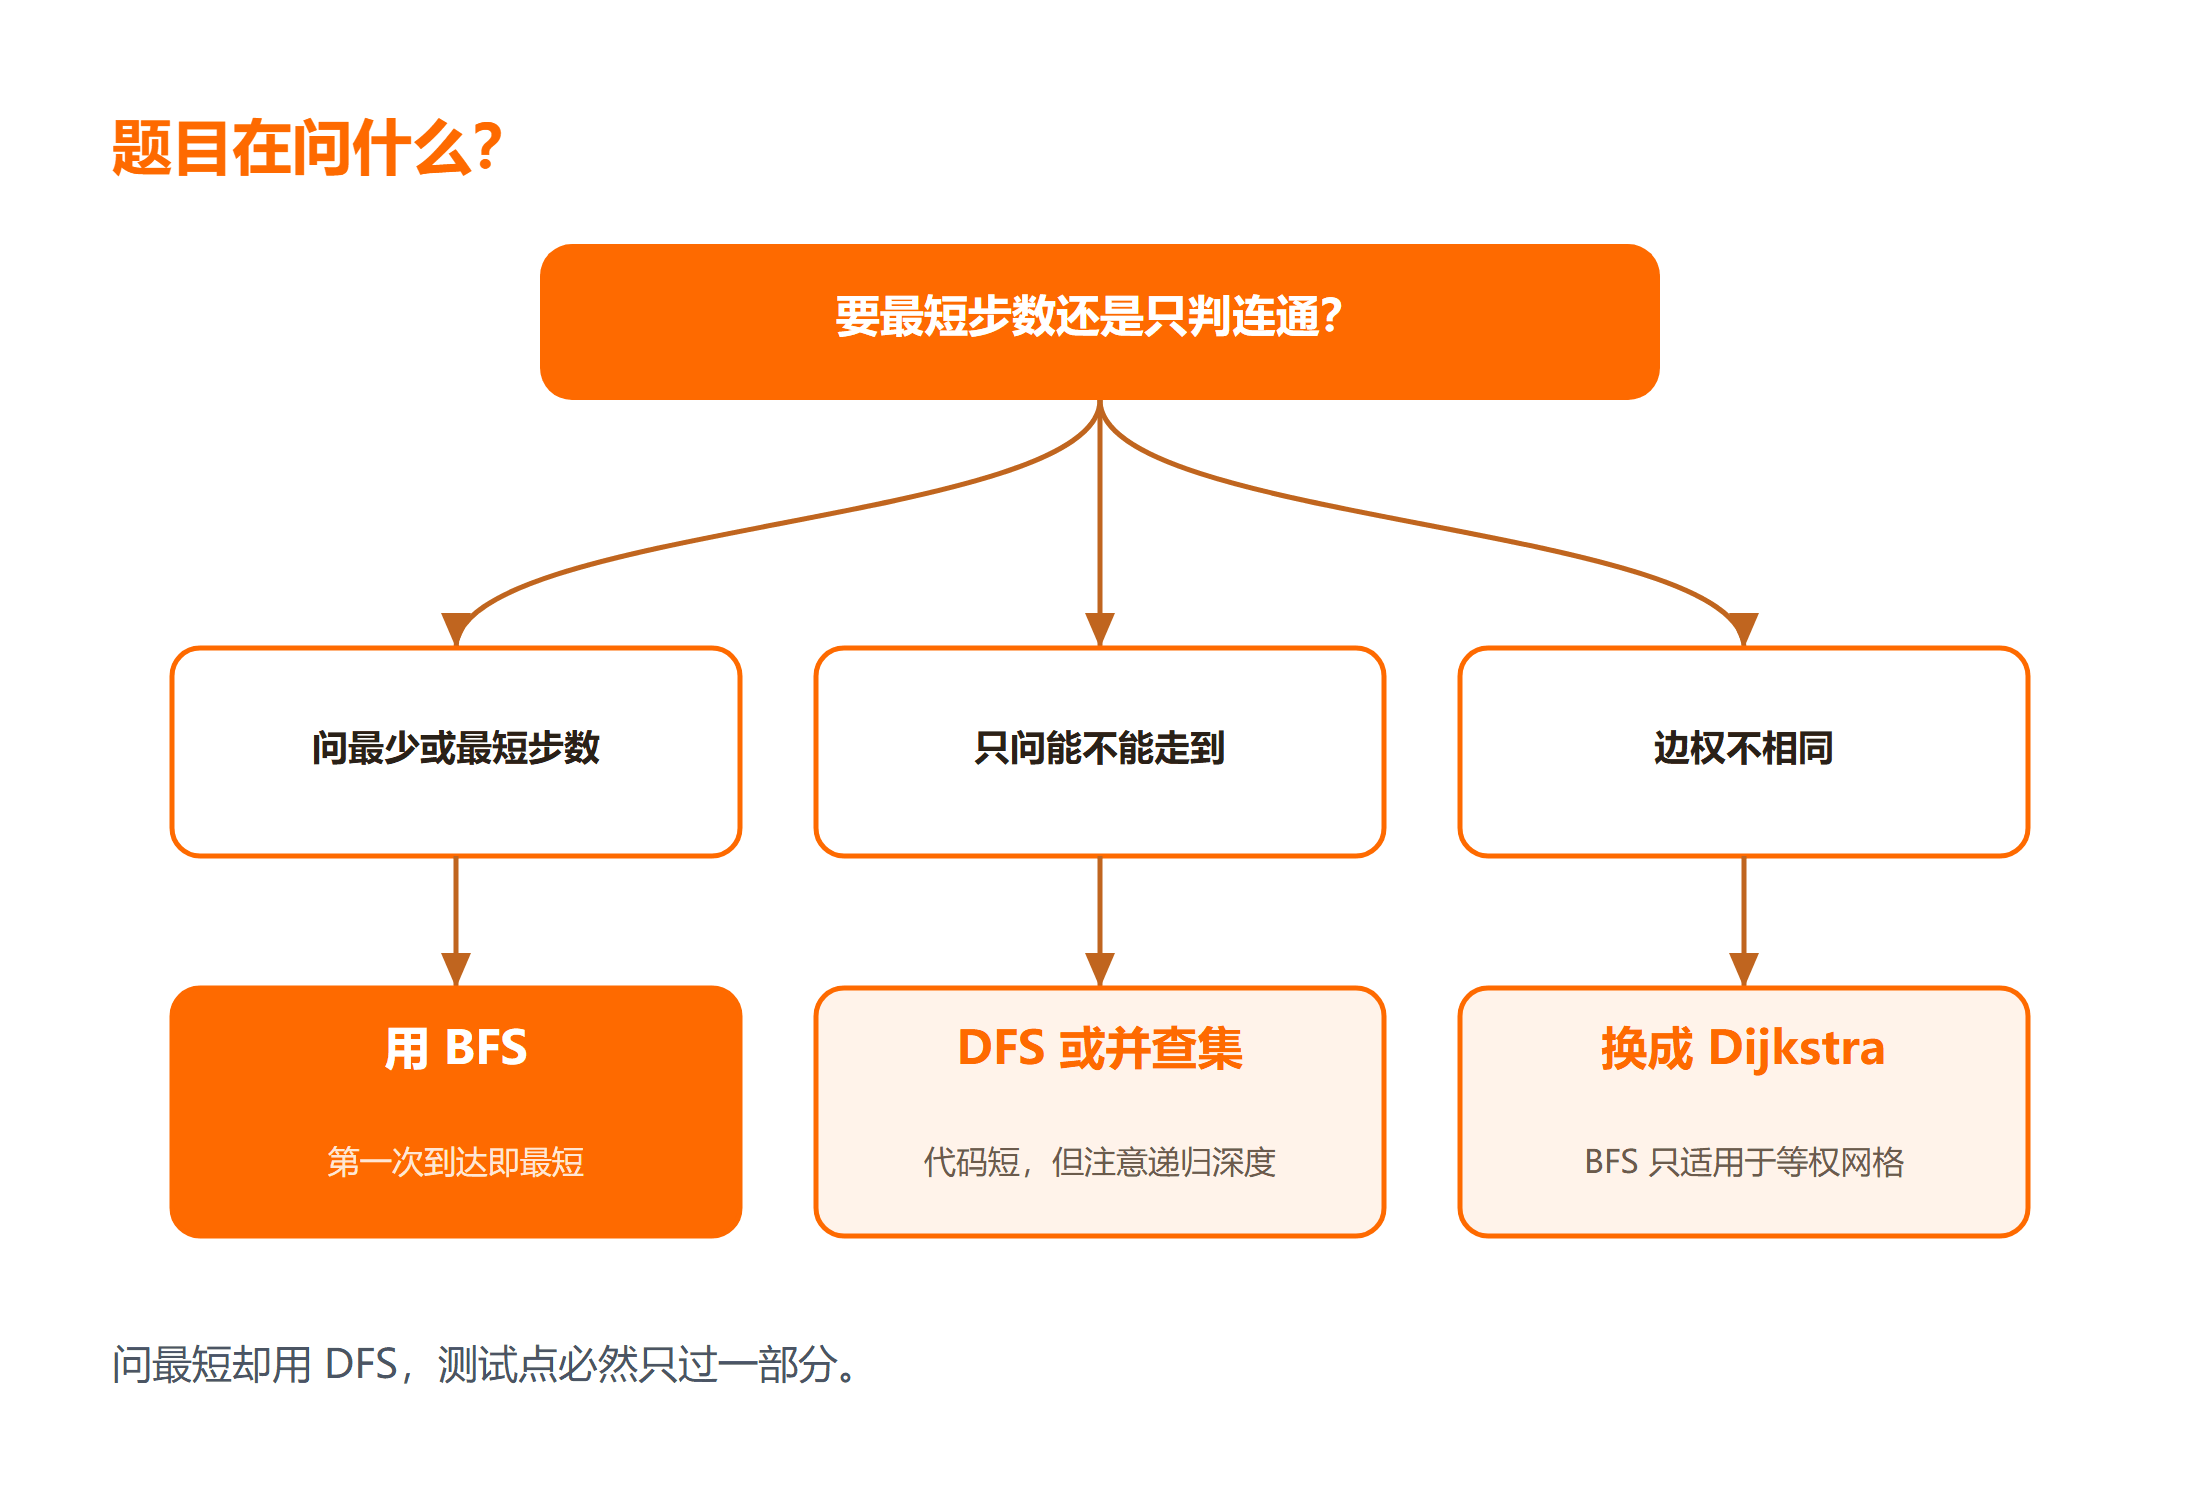
- 要最短路径就用 BFS:广度优先天然按层扩展,第一次到达终点的步数就是最短。
- 只判断连通性可以用 DFS 或并查集:DFS 代码短但可能爆栈,并查集适合动态加墙的场景。
- 多组测试用例必须清空状态:visited 数组、队列、距离数组都在循环外定义就等于自带脏数据。
- 先确认行列顺序再写循环:题目给的 n 行 m 列和你写的 m 行 n 列,在方阵上表现一致,在非方阵上必然出错。
一、最小场景与预期行为
统一约定:输入第一行是两个整数 n 和 m,接下来 n 行每行 m 个字符,# 表示墙、. 表示可走,起点是左上角、终点是右下角,输出最短步数,无解输出 -1。
3 4
.S..
.##.
...E
预期输出是 6。这个样例的关键在于它是 3 行 4 列的非方阵,如果你的循环把行列写反了,读到的图形会变形,样例就过不了——这也是为什么很多人的样例能过、非方阵测试点全挂。
判定顺序建议固定为:先读入并打印一次迷宫确认没读歪,再写搜索逻辑。这一步能省掉后续大量排查时间。如果是刚接触 C++ 的语法,可以先跟一遍 C++ 教程 把输入输出与容器部分补齐。
二、最稳的实现:BFS 求最短路径
广度优先按层扩展,第一次到达终点的层数就是最短步数,这是它相对深度优先最核心的优势。
#include <iostream>
#include <queue>
#include <string>
#include <vector>
using namespace std;

int main() {
    int n, m;
    cin >> n >> m;
    vector<string> g(n);
    for (int i = 0; i < n; ++i) cin >> g[i];

    vector<vector<int>> dist(n, vector<int>(m, -1));
    queue<pair<int,int>> q;
    q.push({0, 0});
    dist[0][0] = 0;
    int dr[4] = {1, -1, 0, 0};
    int dc[4] = {0, 0, 1, -1};

    while (!q.empty()) {
        auto [r, c] = q.front(); q.pop();
        for (int k = 0; k < 4; ++k) {
            int nr = r + dr[k], nc = c + dc[k];
            if (nr < 0 || nr >= n || nc < 0 || nc >= m) continue;
            if (g[nr][nc] == '#') continue;
            if (dist[nr][nc] != -1) continue;
            dist[nr][nc] = dist[r][c] + 1;
            q.push({nr, nc});
        }
    }
    cout << dist[n-1][m-1] << endl;
    return 0;
}
预期输出为最短步数;若终点不可达,dist[n-1][m-1] 保持 -1,输出 -1 即符合约定。
这里的 dist 数组同时承担 visited 的角色:值为 -1 表示未访问。把"标记已访问"放在入队时而不是出队时,能避免同一格被重复入队,这是 BFS 不超时的关键。
三、替代方案与取舍:DFS 与并查集
三种做法不是互相替代,而是回答不同问题:
| 做法 | 回答的问题 | 复杂度 | 主要风险 |
|---|---|---|---|
| BFS | 最短步数是多少 | O(n×m) | 需要额外距离数组 |
| DFS | 能不能走到 | O(n×m) | 递归层数深时爆栈 |
| 并查集 | 动态加墙后是否仍连通 | 近似 O(1) 合并 | 只能判连通,不能求步数 |
选错的代价很直接:要最短路径却用了 DFS,你会得到"某一条路径"而不是最短,测试点必然挂一部分;反过来只问连通性却写 BFS,代码量白白增加。
判断标准只有一句话:题目问"最少/最短",用 BFS;问"能否/是否",DFS 或并查集都行。
写这类题时对数组与字符串操作还不熟,可以翻 C 语言教程 把二维数组与字符处理部分过一遍。
四、反例、边界和常见失败:这 3 个坑最常见
坑一:多组测试用例之间没清空状态
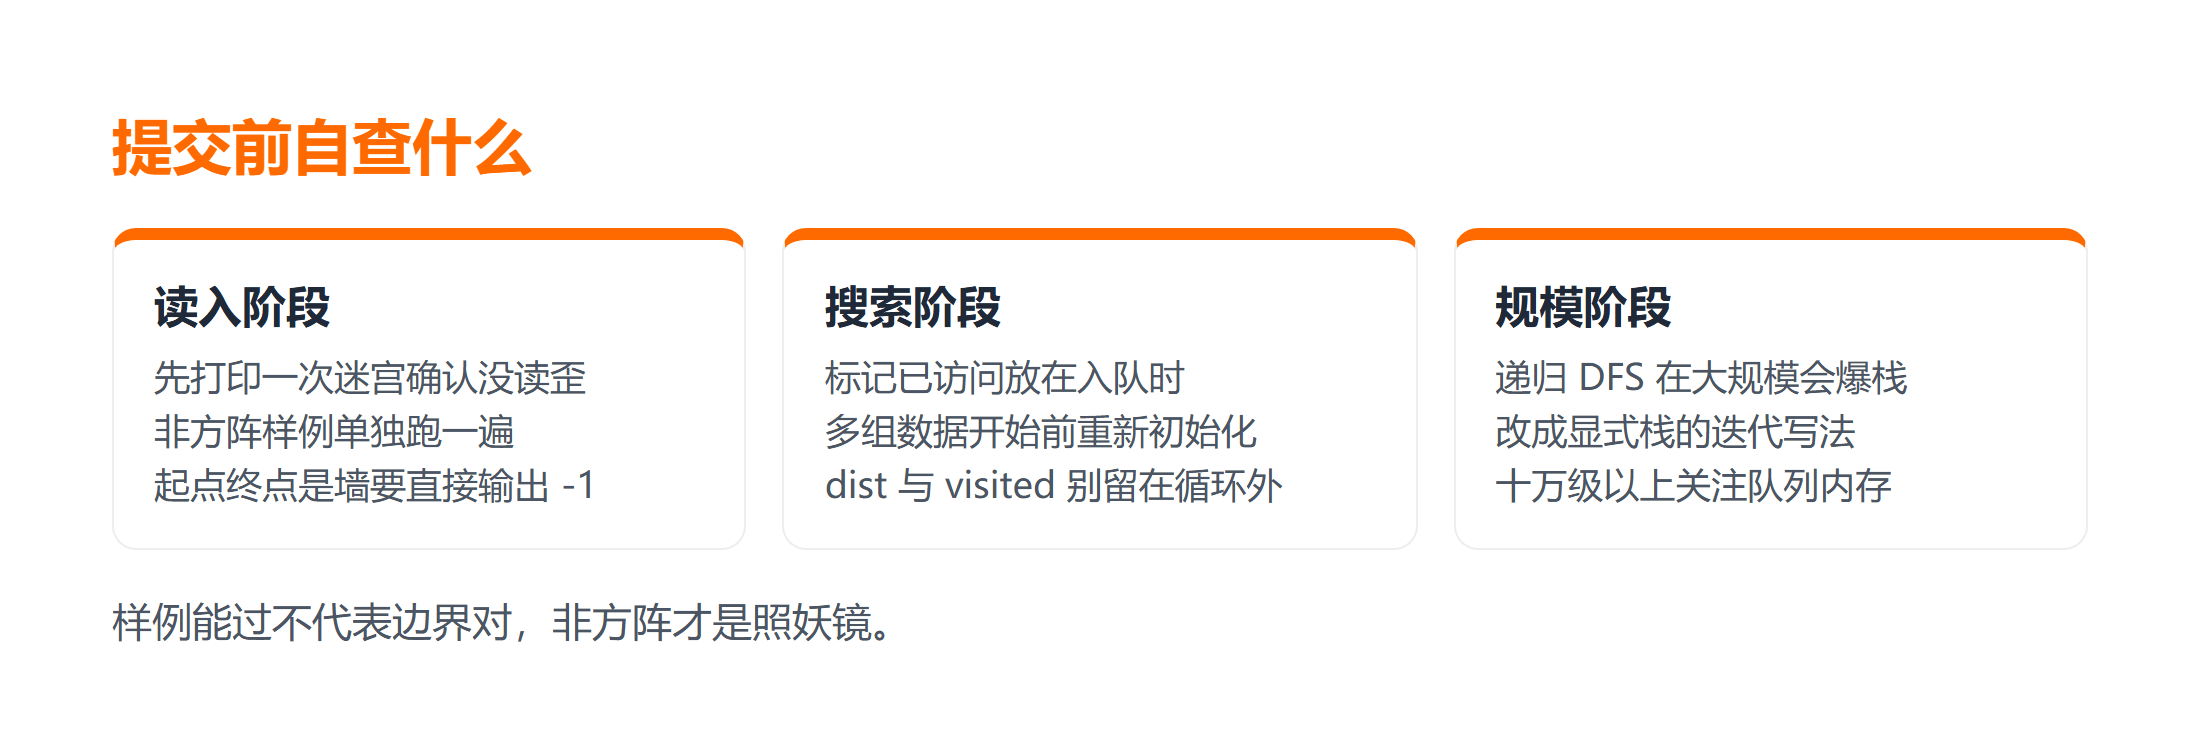
把 visited 或 dist 定义在循环外,第二组数据会带着上一组的残值继续跑,表现为"第一组对、后面全错"。处理方式是每组数据开始前重新初始化,或者在循环内定义这些容器。
坑二:起点或终点本身是墙
很多测试用例会包含起点不可走、终点被封死的情况。代码里若没有对 g[0][0] 与 g[n-1][m-1] 做判断,可能直接给出 0 或一个错误步数。正确做法是先判断两处是否为墙,是则直接输出 -1。
坑三:递归 DFS 爆栈
迷宫规模到几百乘几百时,递归 DFS 的层数会超过默认栈上限,表现为运行时崩溃而不是答案错误。处理方式有三种:改成显式栈的迭代写法、用 BFS 替代、或者在评测环境允许时调大栈空间。
动手核对清单:提交前怎么自查
按下面顺序过一遍,能挡掉大部分"样例过、测试点不全过"的情况(示例基于 C++17 与主流判题环境的通用行为,未在本机执行):
- 前置:确认输入输出格式与题目一致,命令为
g++ -std=c++17 maze.cpp -o maze && ./maze < input.txt,预期输出与样例一致; - 操作:先用 1×1、1×n、n×1 三种极端尺寸各跑一次;
- 检查:打印读入后的迷宫,确认行列没有颠倒;
- 验证:构造一个起点或终点为墙的用例,确认输出 -1;
- 失败处理:输出为 0 就查起终点是否被墙挡住;步数偏大就确认是不是把 DFS 当成最短路在用;运行时崩溃就改成迭代写法;
- 适用边界:BFS 适用于边权相同的网格,带权迷宫要换成 Dijkstra;
- 性能取舍:n×m 在万级以内三种做法都能过,超过十万级要关注队列内存与递归深度。
总结
迷宫题测试用例过不全,先查边界再查算法:多组数据是否清空状态、行列顺序有没有写反、题目问的是最短路径还是仅连通性。算法层面记住一句就够——问最短用 BFS,问能否用 DFS 或并查集。
要点带走:
- 非方阵样例是行列写反的照妖镜,务必单独测一次;
- 标记已访问要在入队时做,出队时做会重复入队导致超时;
- 递归 DFS 在大规模网格上会爆栈,改成迭代写法更稳。
常见问题
Q:为什么样例能过,提交后只过一部分?
A:最常见的是多组测试数据之间没清空 visited 或距离数组,以及把 n 行 m 列读成了 m 行 n 列。非方阵的测试点会立刻暴露这两个问题。
Q:DFS 求出来的步数为什么不对?
A:DFS 只保证找到一条能走通的路,不保证最短。题目问"最少步数"时必须用 BFS。
Q:visited 标记放在入队还是出队?
A:放在入队时。放在出队时同一格可能被多个前驱重复加入队列,队列长度膨胀,轻则变慢,重则超时。
Q:迷宫很大时程序崩溃怎么办?
A:多半是递归 DFS 层数超过栈上限。改成用显式栈的迭代 DFS,或者直接换成 BFS,两者都不会受递归深度限制。



