
 TRAE-AI编程

想在 Ollama 里用 LoRA 微调,却被 rank、alpha、学习率一堆参数绕晕?最直接的答案是:先用默认参数跑通最小流程,再按"秩决定容量、alpha 决定缩放、学习率决定步长"的对应关系逐项调,别一次改多个参数。本文用可复制的配置讲清关键参数的输入输出与失败边界,帮你在显存、速度和效果之间找到稳妥起点。全文基于主流微调工具链与 Ollama,版本差异在文末说明。今天这篇文章,编程狮把这块讲透。
先看结论
LoRA 微调参数怎么配,先看三条能落地的结论:第一,先用工具默认参数跑通一次全流程,确认数据、格式、导出环节都正常,再谈调参;第二,调参一次只动一个变量,否则无法判断是哪个参数改善了效果;第三,参数没有通用最优值,取决于你的数据规模、任务难度和显存预算,照搬别人的配置常常翻车。
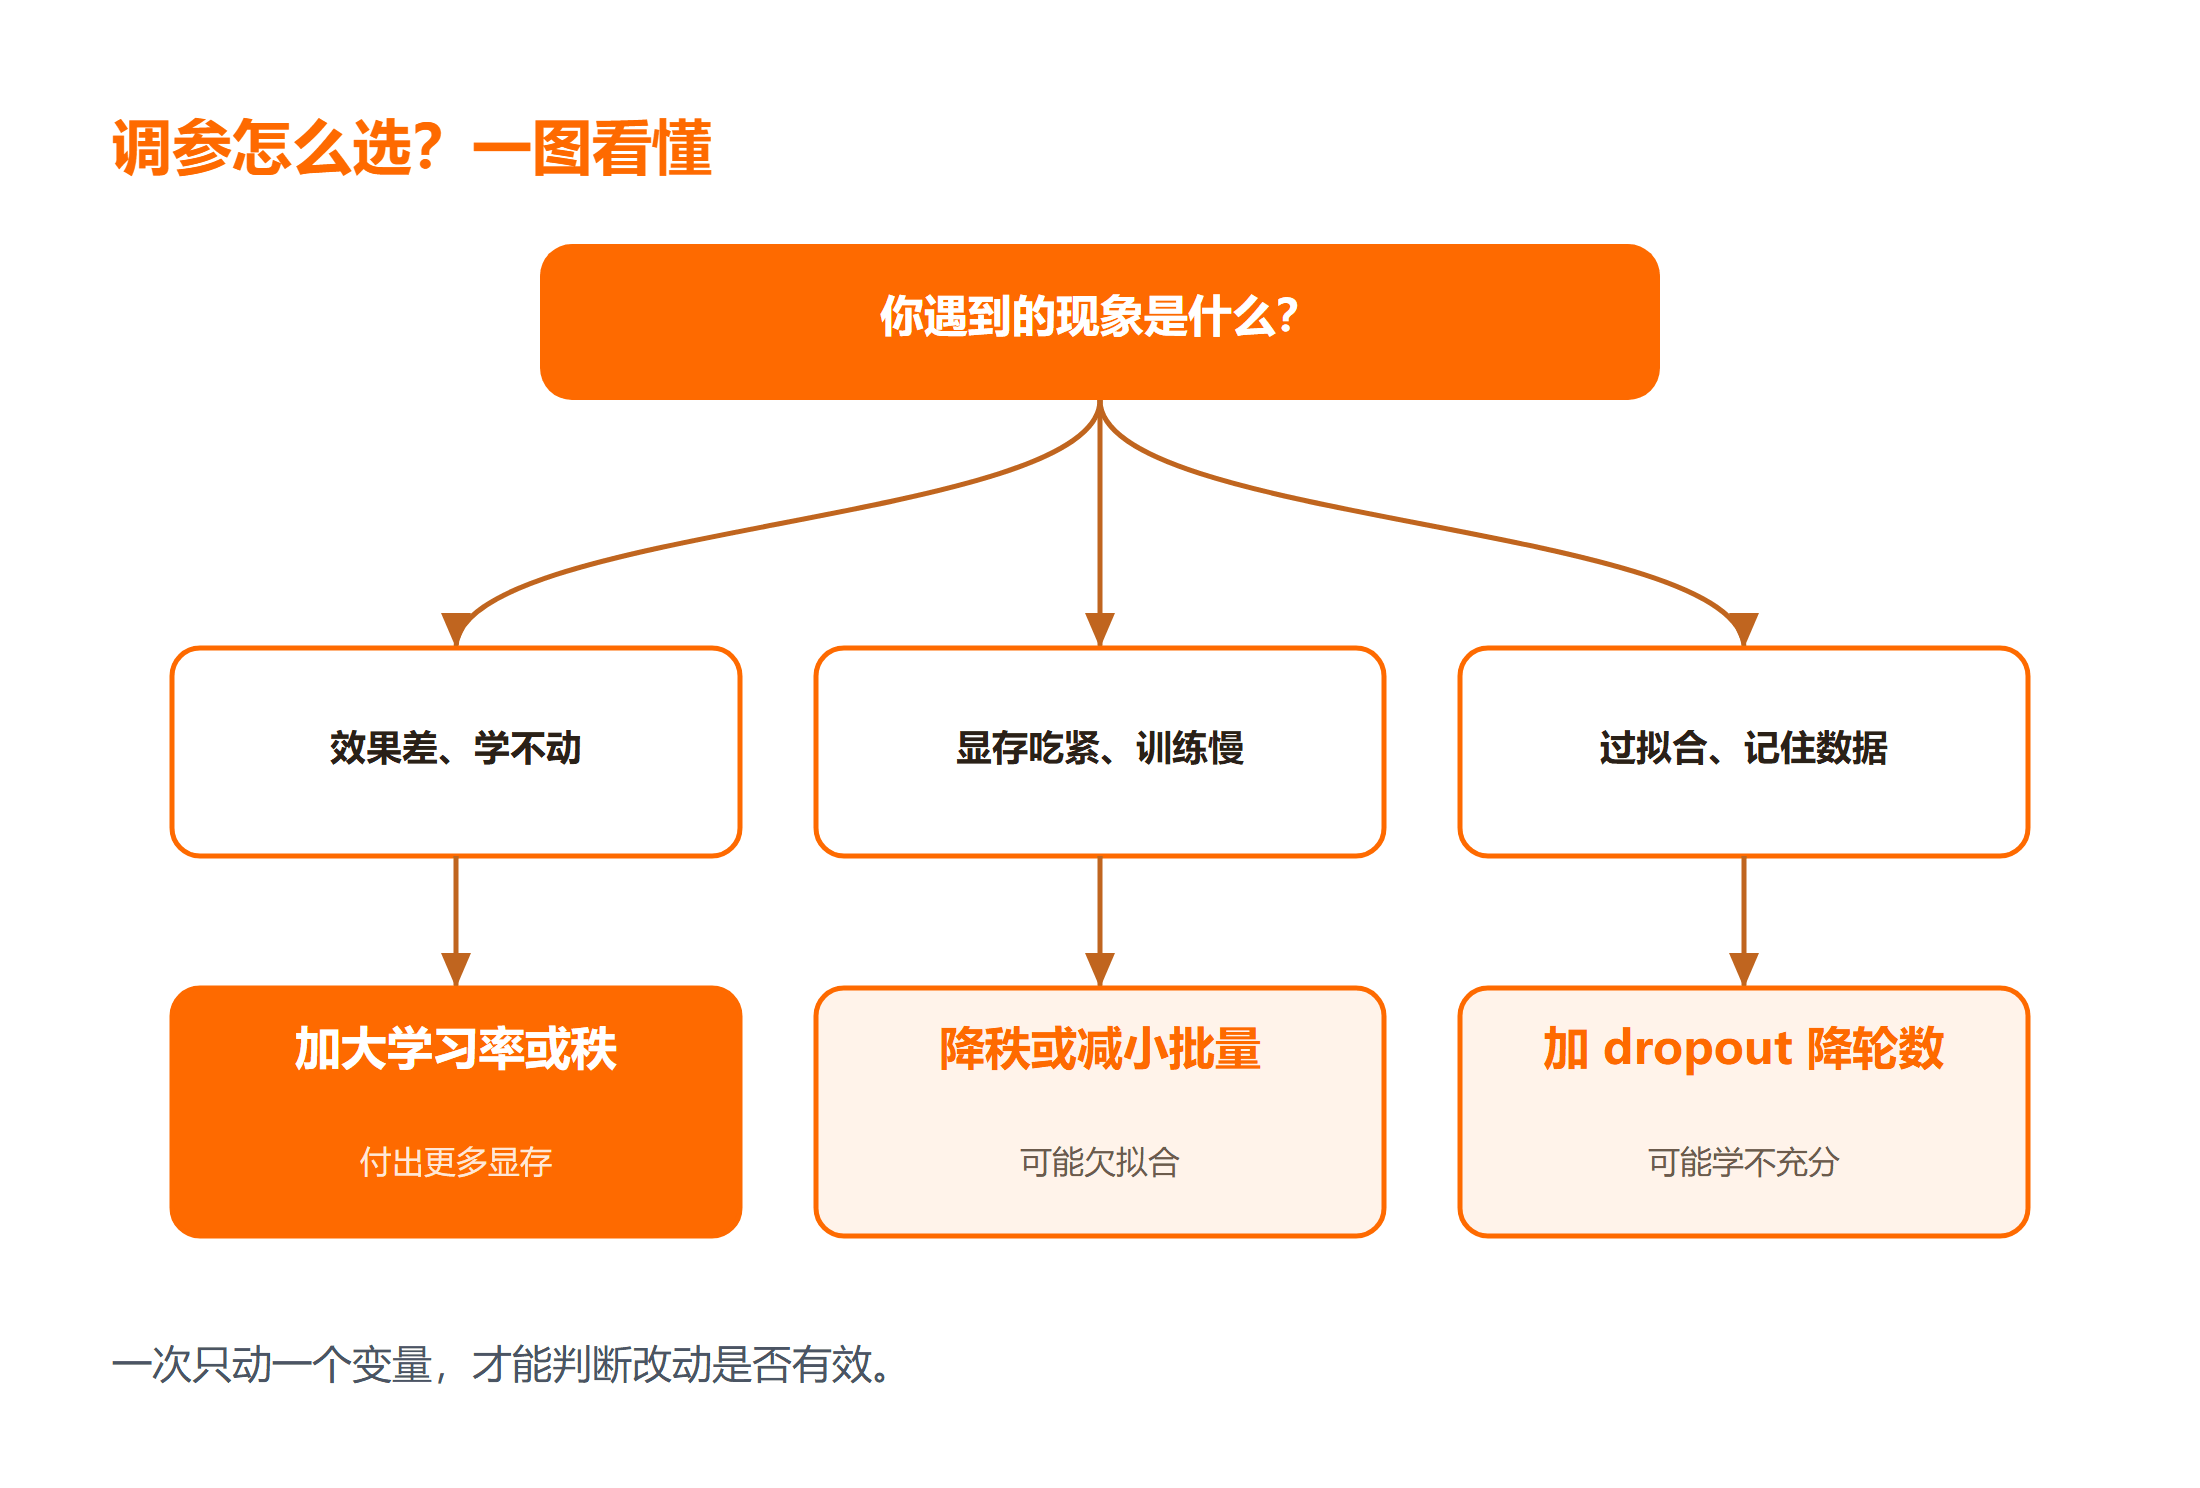
判断优先调哪个的标准:效果太差、学不动,优先看学习率和秩;显存吃紧、训练太慢,优先降秩和批量大小;过拟合、记住了训练数据,优先加正则、降学习率。想先把自定义模型的接入能力弄清,可以从工具文档里的模型配置章节入手,把基座与适配器的关系弄明白再动手。
一、先想清楚:你的场景到底需不需要微调
调参之前先回答一个更根本的问题:这个任务真的需要 LoRA 微调吗?LoRA 适合让模型学会特定风格、固定格式或领域术语,不适合灌输大量新知识。如果问题靠提示词和系统消息就能解决,微调往往是小题大做,成本高、维护难。
一个常见误区:把微调当成"让模型变聪明"的万能手段。实际上微调改变的是模型在特定任务上的表现倾向,不会凭空增加通用能力。数据质量差、样本量太小,再精妙的参数也救不回来。先确认你有足够的高质量样本,再进入调参环节。
适用边界要讲清:LoRA 因为只训练低秩适配器,显存占用远低于全量微调,适合消费级显卡;但如果任务需要深度改变模型行为,全量微调或继续预训练才是对的方向,这是能力上限的取舍,不是参数能弥补的。
二、最小可运行配置:先跑通再调
先给一份保守的起始配置,重点是能跑通而不是最优:
# LoRA 最小可运行配置(示意)
lora_rank: 8
lora_alpha: 16
lora_dropout: 0.05
learning_rate: 2e-4
num_train_epochs: 3
per_device_train_batch_size: 2
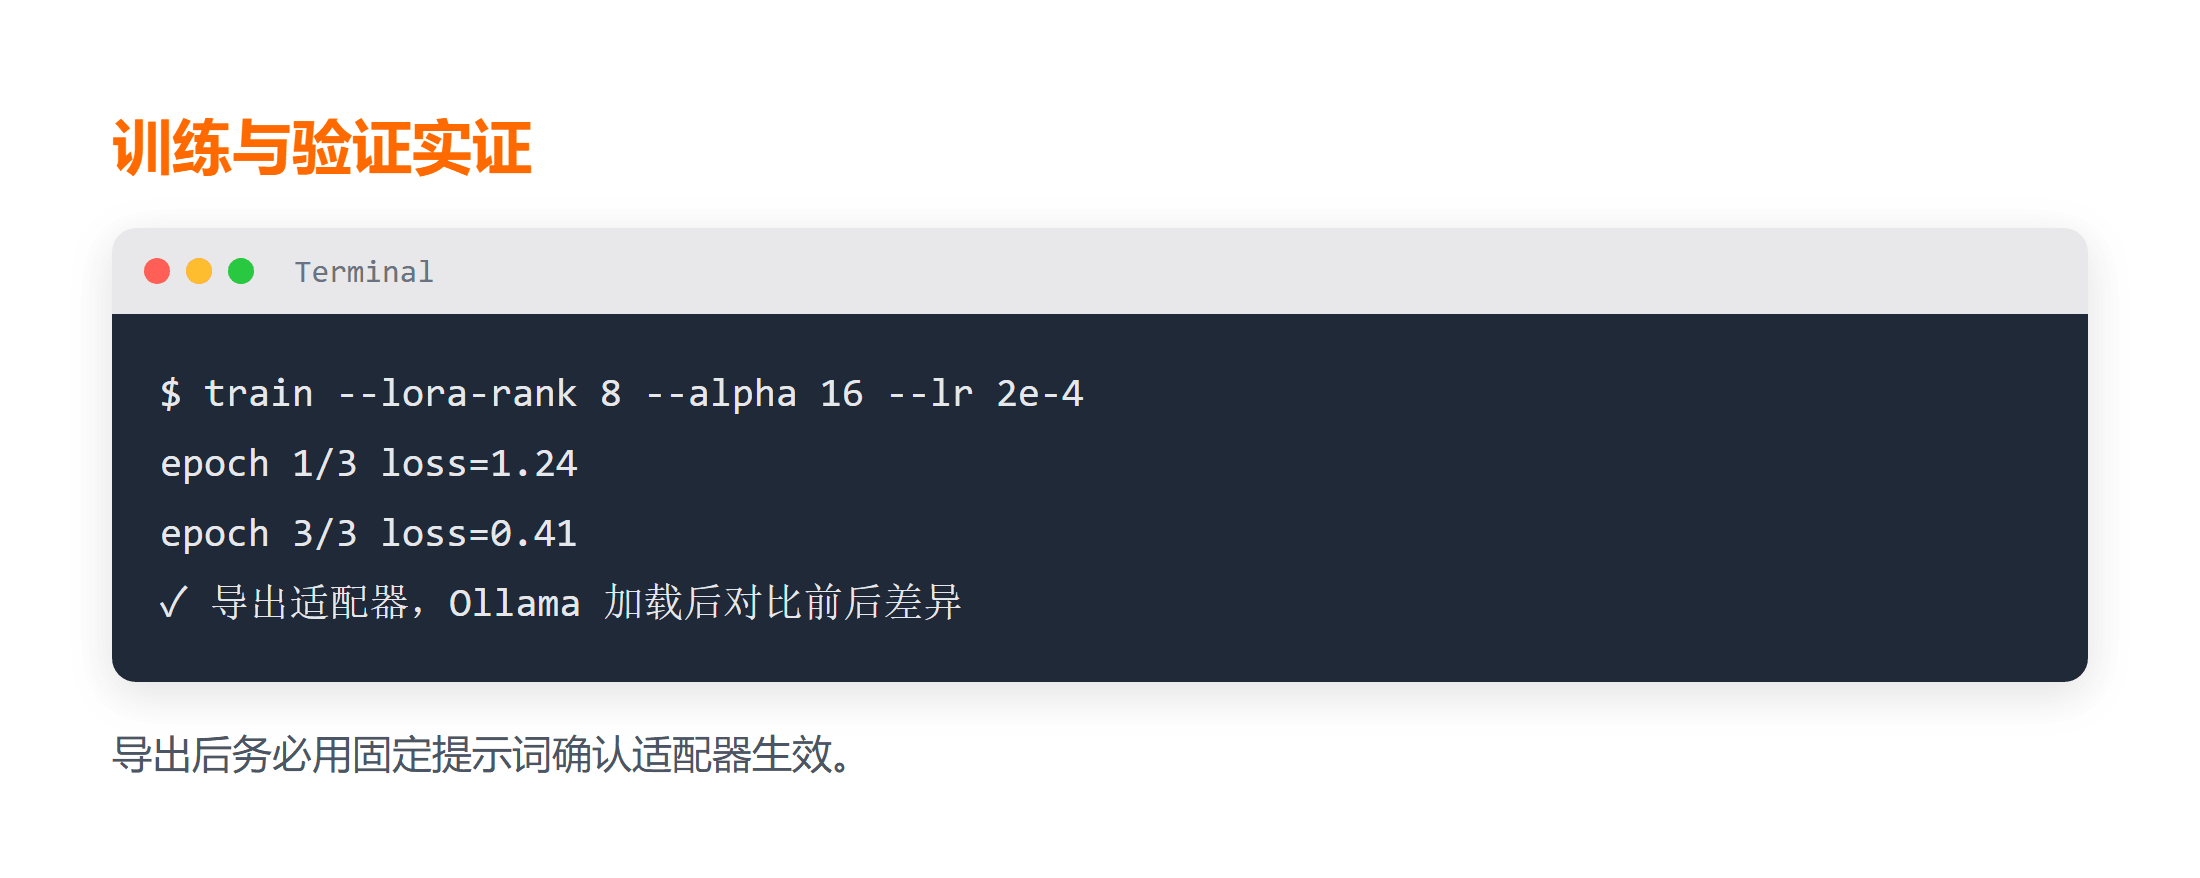
这份配置的意义:rank 8、alpha 16 是常见的稳妥起点,缩放系数 alpha/rank 为 2;学习率 2e-4 是 LoRA 的常用量级,比全量微调大;训练 3 轮足够让小数据集收敛。检查配置是否生效,先跑一小批样本看损失是否下降。
训练完导出适配器,再交给 Ollama 加载使用。加载是否成功,用一条固定提示词对比微调前后的输出差异来确认。环境里的语法细节可对照 Python 速查手册。
2.1 关键参数的对应关系
理解参数的含义,才能有方向地调:
- rank(秩):决定适配器的容量。秩越大,能拟合的模式越复杂,但参数和显存占用也上升。数据简单、样本少,秩 8 往往够用。
- alpha:缩放系数,实际影响是 alpha/rank。它调节适配器对原模型的影响强度,常设为 rank 的两倍。
- 学习率:决定每步更新幅度。LoRA 常用 1e-4 到 3e-4,过大容易震荡,过小学不动。
- dropout:正则手段,数据少时适当加大可缓解过拟合。
三、失败分支与边界处理
调参过程会遇到几类典型失败,逐项看懂现象和处理:
- 损失不下降:先检查学习率是否过小、数据标签是否正确;确认是不是任务本身不适合 LoRA。
- 显存溢出:降低批量大小、减小秩、缩短序列长度,三选一逐步试。
- 输出变差(灾难性遗忘):学习率过大或训练轮数过多,调小学习率、减少轮数。
- 导出后 Ollama 加载失败:检查导出格式与基础模型是否匹配,适配器必须对应同一个基座版本。
修复的顺序是"先复现、再定位、后改单一变量",一次只改一个参数并重新验证,才能判断改动是否有效。训练日志是定位问题的主要依据,可参考 Trae 会话日志定位 的思路。
四、三类参数取舍对比
把常见调节方向摆在一起看:
| 目标 | 优先调整 | 代价 |
|---|---|---|
| 效果学不动 | 加大学习率、提高秩 | 显存增加、可能震荡 |
| 显存吃紧 | 降秩、减小批量 | 容量下降、可能欠拟合 |
| 过拟合 | 加 dropout、降学习率、减轮数 | 可能学不充分 |
对比可见:每个目标都有明确的参数对应,但它们互相牵制——降显存和提效果常常冲突。这就是 LoRA 调参的核心取舍,没有同时满足所有目标的魔法配置。性能上,秩越大训练和推理都更慢,这是容量带来的必然开销。
想继续看工具链配置,可在延伸资源里找思路。
总结
Ollama 里配 LoRA 微调参数,稳字当头:先用默认配置跑通全流程,再按"秩管容量、alpha 管缩放、学习率管步长、dropout 管正则"的对应关系逐项调,一次只动一个变量。先判断任务是否真的需要微调,再在显存、速度和效果之间权衡。导出后务必用固定提示词对比前后差异,确认适配器真的加载生效。记住参数没有通用最优值,数据质量和任务适配比调参本身更关键。
常见问题
Q:rank 和 alpha 到底怎么设?
A:把 alpha/rank 理解成缩放系数,常见做法是 alpha 设为 rank 的两倍,例如 rank 8 配 alpha 16。先从这组默认值起步,效果不足再提高秩,不要一上来就用很大的值。
Q:学习率设多大合适?
A:LoRA 常用 1e-4 到 3e-4,比全量微调大一个量级。学不动就适当加大,输出变差或震荡就调小。每次只改学习率这一项,重新训练后对比效果。
Q:微调后 Ollama 里怎么确认生效?
A:用同一条固定提示词,分别让基座模型和加载适配器后的模型回答,对比两者差异。有明显且符合预期的变化,说明适配器正确加载;没有差异要回头检查导出格式和基座版本是否匹配。
延伸学习
想把这块知识系统补齐,可以按这个顺序来:
- 想看微调方法在其它场景的应用,可以看 spaCy微调BERT变压器;
- 对照"自定义模型怎么配"的做法,翻 Trae 自定义模型支持硅基流动;
- 想先把本地大模型跑起来,看 本地大模型Ollama安装入门。



