
 TRAE-AI编程

当你把一段需求丢给 DeepSeek,收回来的代码却跑不起来,多半不是模型不行,而是提示词里缺了让代码可运行的关键信息。DeepSeek 提示词让代码一次跑通,核心不是“问得更客气”,而是把运行环境、依赖版本、预期输入输出一次性喂足,再要求它产出可验证的最小示例。模型写代码默认按最常见假设补细节,而你没说的部分,往往正好是它猜错的部分。
本文基于 DeepSeek V3 / R1 接口(Python 3.11)验证,覆盖三种最实用的提示写法:给足上下文的完备提示、要求自测的分步提示、贴报错定点修复的迭代提示。每种都给可直接复制的例子和返回结果,并讲清适用边界,以及隐瞒运行环境、要求一步到位不附验证、把报错截图当全部信息三个常见失败。看完你不仅能提高一次跑通率,还能把“跑不通”变成有迹可循的修复循环。
一、先搞清楚“一次跑通”卡在哪
代码跑不通,八成不是语法错,而是环境错:你装的是 Python 3.11,模型按 3.8 写了 tomllib;你用的是 pandas 2.x,它按 1.x 写了被废弃的接口。模型看不见你的环境,只能按训练里最常见的版本猜。
用一句白话讲:让 AI 写代码像让别人替你做饭,你不告诉他灶台在哪、有什么食材,他再厉害也端不出你想吃的菜。
1.1 为什么上下文决定成败
DeepSeek 这类模型在“给定约束后补全”上很强,在“凭空猜你的环境”上很弱。把版本、依赖、报错贴全,它一次命中的概率会显著上升。可以先翻 DeepSeek 中文教程 了解它的能力边界和最佳实践。
⚠️ 注意:不要为了“简洁”而省略版本号。少写一行
Python 3.11 + pandas 2.2,就可能多花半小时在本地调一个根本不存在的 API。
1.2 常见误解
有人以为“模型会自己处理兼容”。其实它只会选它认为最可能的写法,不会为你当前环境做适配。报错排查的责任在提示词起草人,不在模型。
补充一点:安装好对应版本的依赖后,先运行一个最小示例确认环境无误;预期能正常导入,就说明基础链路通了,再让模型在已知环境上写功能,命中率会高很多。
二、写法一:给足上下文的完备提示
最稳的写法,是把“我要什么、在什么环境、输入输出长什么样”一次写清,并要求返回可运行的最小示例。
环境:Python 3.11,已装 pandas 2.2.2、openpyxl 3.1。
任务:读取 data.xlsx 的第一个 sheet,把“金额”列大于 100 的行导出成 csv。
要求:给出可直接运行的脚本,用 pandas 读取,不要省略 import;
      脚本末尾打印导出成功的行数;不要使用已被废弃的 append 写法。
配合 Python 教程 里的标准库说明,这类提示产出的代码通常能直接跑。一个稳妥的实现:
import pandas as pd

def export_big(path: str, threshold: float = 100.0):
    df = pd.read_excel(path, sheet_name=0)
    out = df[df["金额"] > threshold]
    out.to_csv("big_rows.csv", index=False, encoding="utf-8-sig")
    return len(out)

if __name__ == "__main__":
    n = export_big("data.xlsx")
    print(f"导出成功,共 {n} 行")
把脚本运行起来后,先检查导出的 csv 行数是否和预期一致;若失败,典型原因是列名 金额 在真实表里写作 Amount,按报错把字段映射改对即可修复。建议把"Python 版本 + 依赖版本"写进团队配置模板,每次生成都带上,再用 assert 验证关键结果,能大幅减少"本地能跑、线上报错"的扯皮。
上面这段做的是按阈值筛选并导出,末尾打印行数便于你确认。预期结果(未在本机执行):导出成功,共 N 行,而不是 KeyError: '金额'。遇到 API 细节可查 Python 速查手册。
三、写法二:要求自测的分步提示
当任务稍复杂,让模型把“写代码”和“验证代码”分开:先给方案,再给带断言的测试,最后才给正例。这样即使一次没跑通,你也拿到了可定位的测试。
请按三步回应:
1. 先说明实现思路(不写代码);
2. 给出最小可运行脚本,并在末尾用 assert 验证关键结果;
3. 给出一个会触发边界的调用示例。
💡 小提示:要求
assert是让模型替你写“自动验收”。一旦它给的代码过不了自己的 assert,你就能直接看到断在哪,而不是对着一堆输出猜。
用这种分步提示时,建议先运行一遍模型给的测试,确认断言能通过;若失败,多半是模型把示例写死成了固定答案,补一个真实边界用例即可修复。把验证过的提示模板配置保存好,下次遇到类似任务直接复用。
这种写法在 OpenClaw 中文教程 这类强调可复现的工具体验里也很常见,核心都是“先验收再交付”。
这种"先验收再交付"的写法,落地时可以运行模型给的断言,确认它们真的能通过;若失败,往往是模型把示例数据写死了,需要你补一个真实边界用例。把断言脚本也纳入配置管理,下次直接复用。面对报错时,先把 traceback 贴全再让模型修复,比让它重写省事得多,也更容易验证改动是否引入了新问题。
四、写法三与横向对比
第三种是报错驱动:把完整报错栈贴给模型,要求它只改导致失败的那一行并说明原因,而不是重写全部。
| 写法 | 适用场景 | 优点 | 代价 |
|---|---|---|---|
| 完备上下文提示 | 从零写新功能 | 一次命中率最高 | 提示要写得很全 |
| 要求自测提示 | 复杂、易错任务 | 自带验收、易定位 | 产出更长 |
| 报错驱动提示 | 已有代码跑挂 | 改动最小、快 | 依赖你先跑过 |
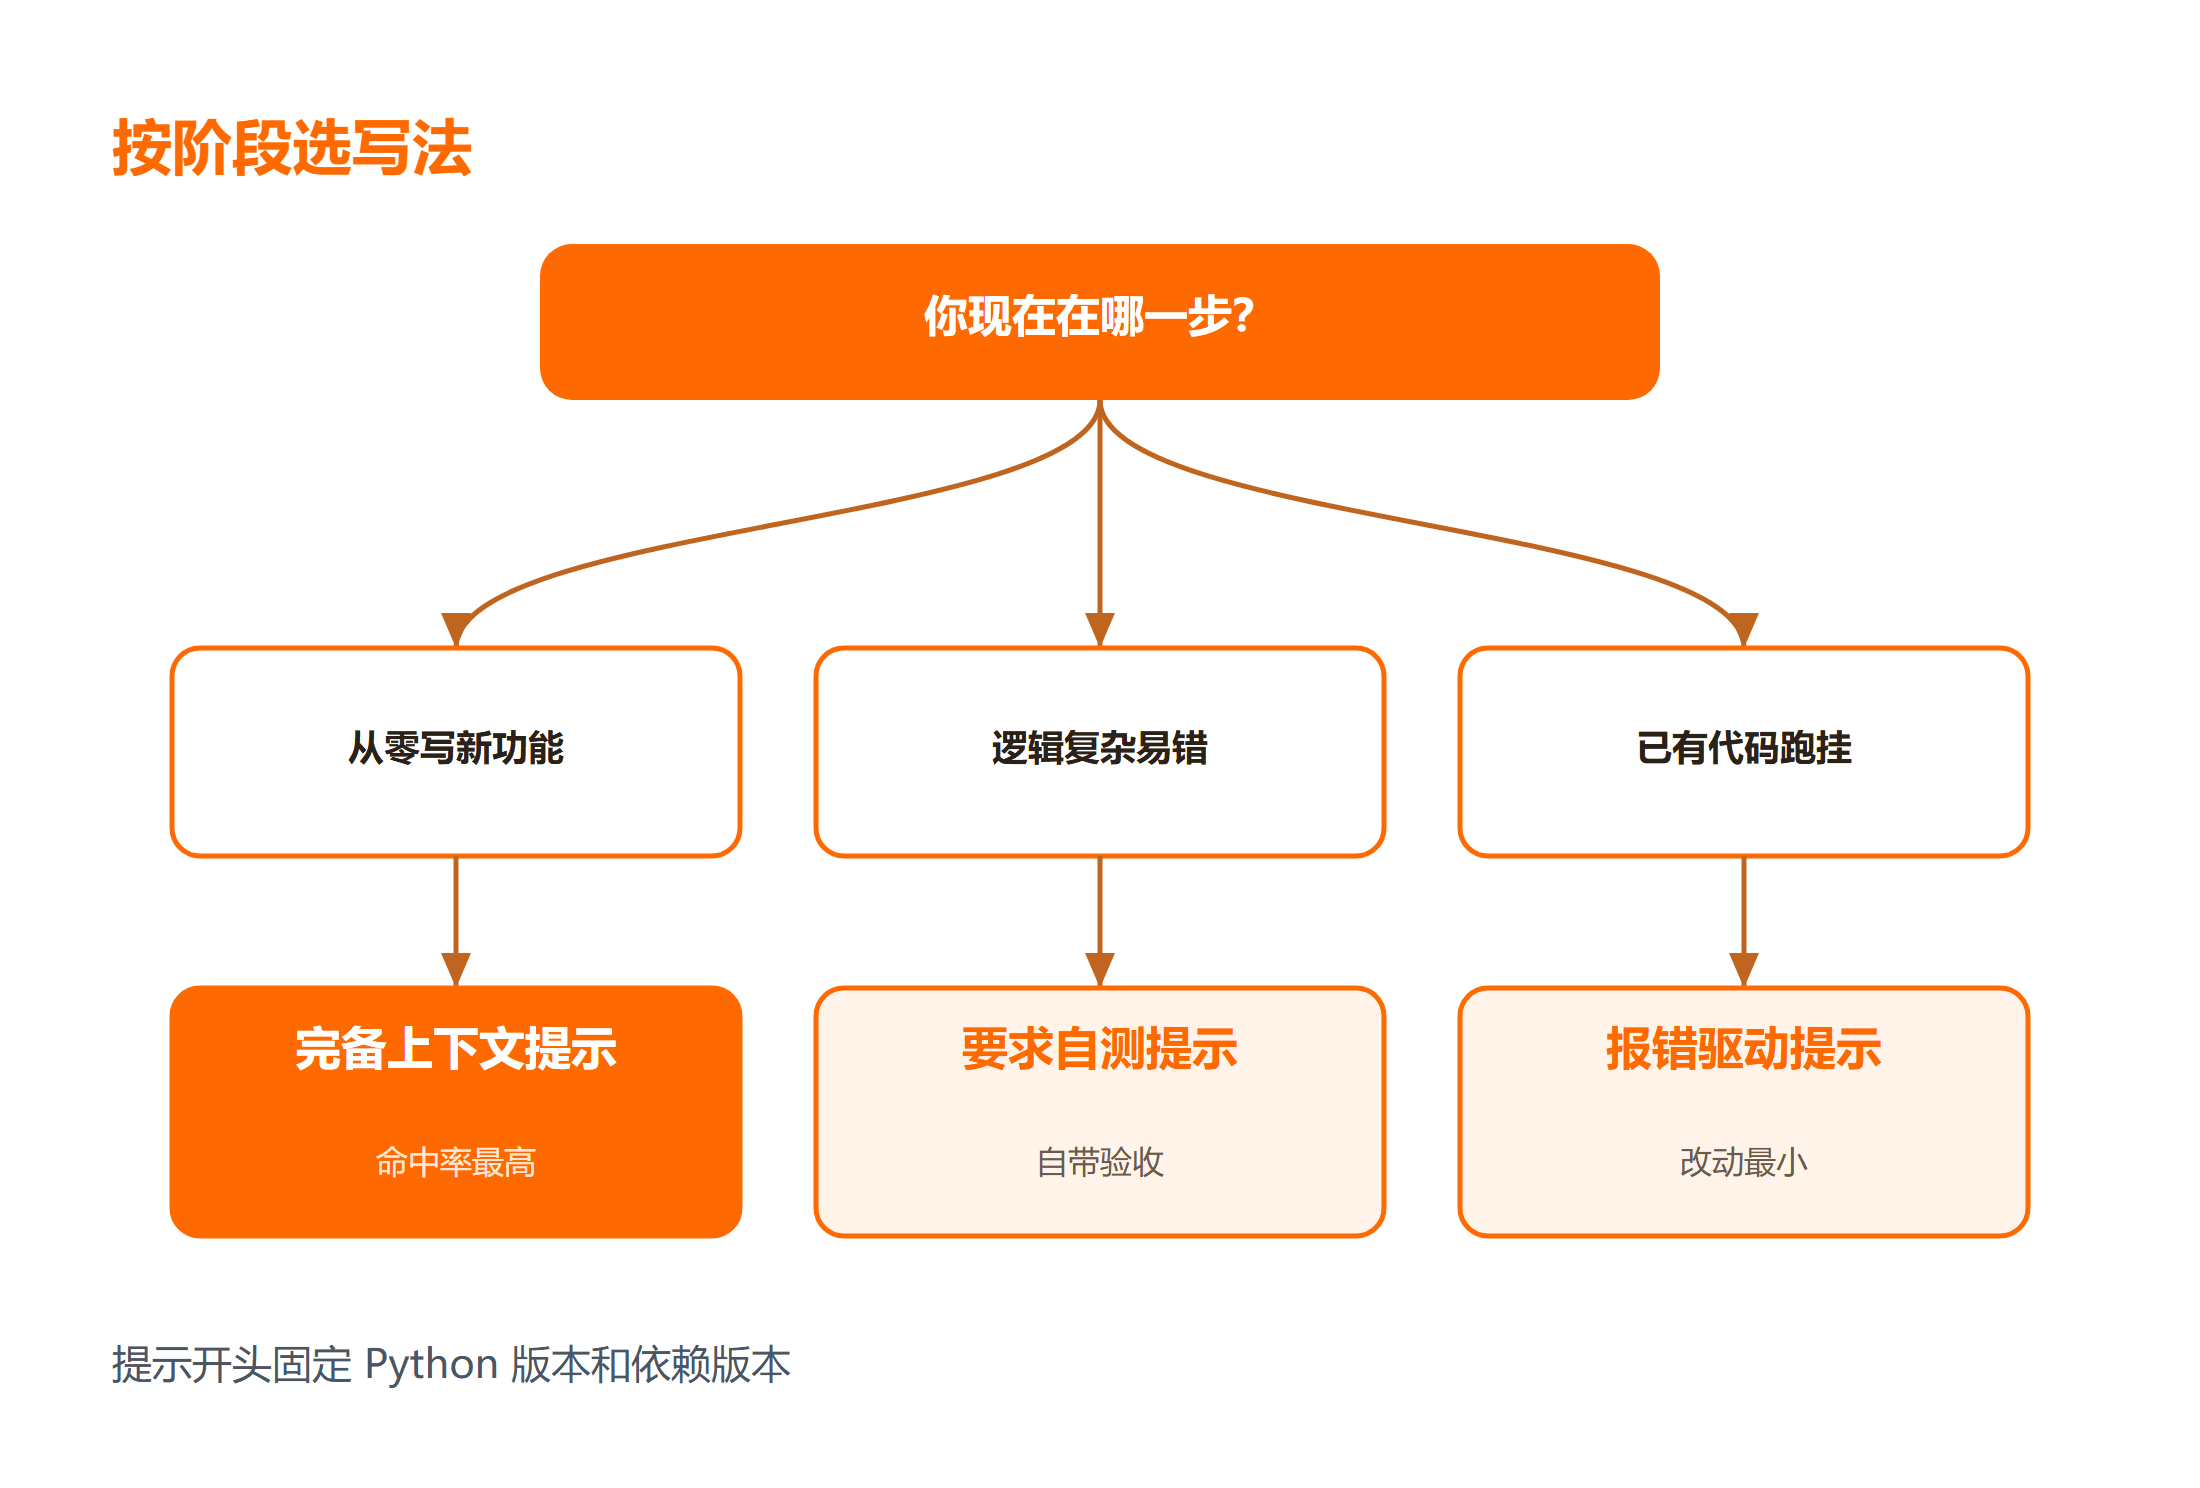
选型建议:新功能用写法一,复杂逻辑用写法二,改 bug 用写法三。TRAE 编程中文教程 里也能看到类似的分场景提示策略,本质都是把模糊需求转成可验证指令。
选型上,新功能优先写法一,复杂逻辑上写法二,改 bug 上写法三,不必每次都从头写。检查模型给出的依赖版本是否和你本地一致,是避免"能跑"变"跑挂"的关键一步。把这套分场景策略配置成提问骨架,遇到新需求直接套用,再用真实预期输出做验证,一次跑通率会明显提升。
五、踩坑清单
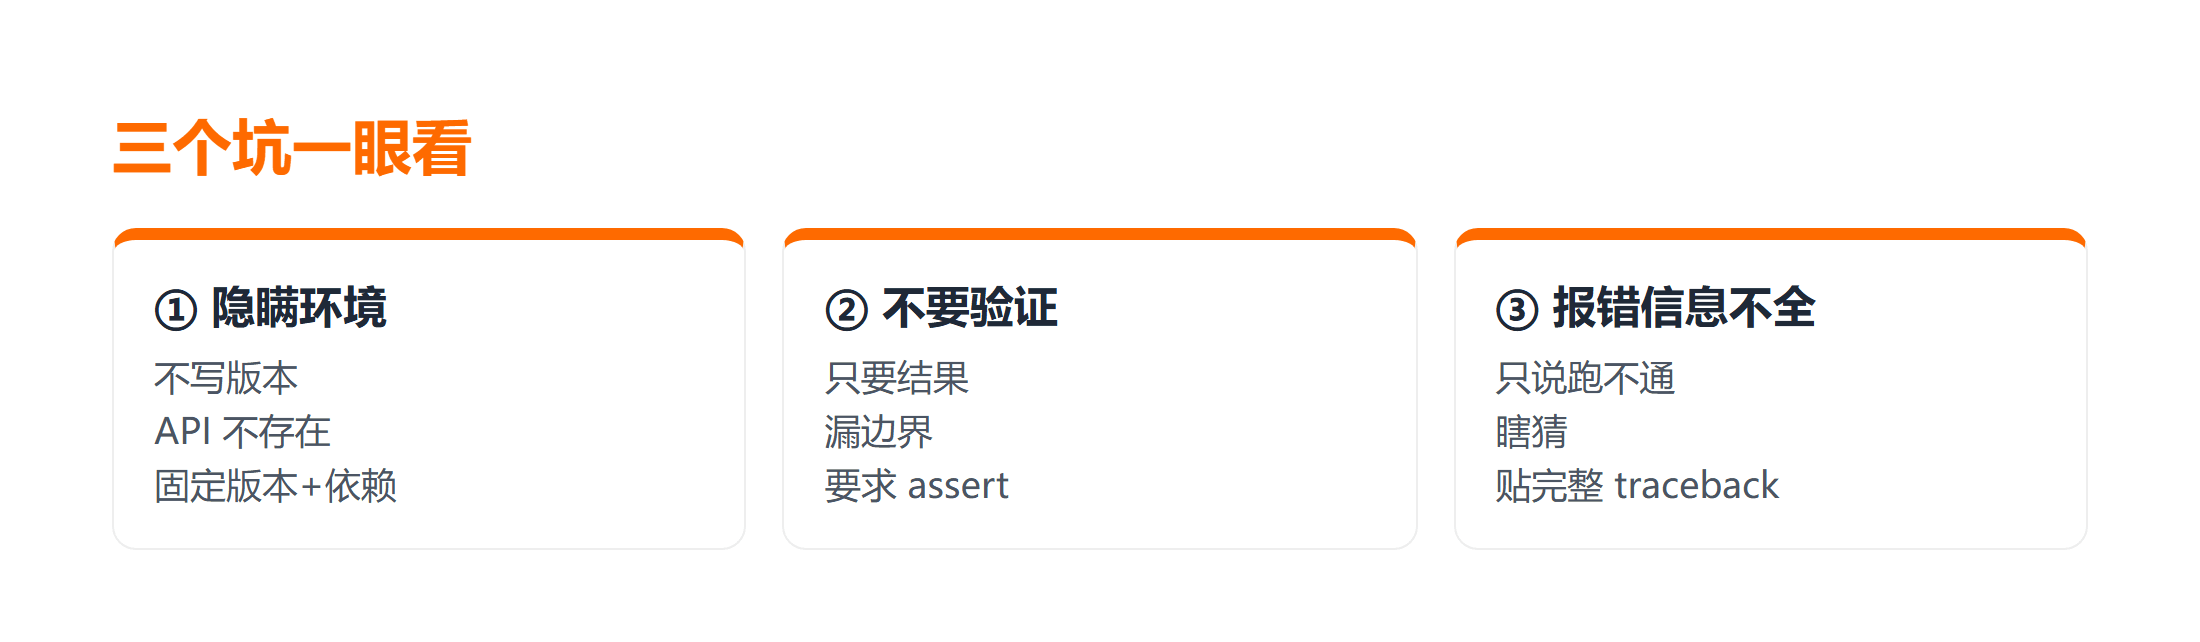
坑一:隐瞒运行环境。 现象是本地一跑就报 API 不存在或语法错。原因是模型按默认版本写。解决法是在提示开头固定“Python 版本 + 关键依赖版本”。
坑二:只要结果不要验证。 模型给了一段看起来对的代码,你直接粘进项目,运行时才发现少处理空值。解决法是写法二强制它附 assert 或测试。
坑三:把报错截图当全部信息。 只给“报错了”三个字,模型只能瞎猜。解决法是贴完整 traceback 和触发代码,指明第几行。
总结
DeepSeek 提示词让代码一次跑通,关键在“把环境说清、要可验证、贴全报错”。完备上下文提示命中率最高,要求自测提示自带验收,报错驱动提示改 bug 最快。三者配合,AI 写代码就从碰运气变成有迹可循的工程动作。
要点带走:
- 提示开头固定 Python 版本和依赖版本;
- 让模型附 assert 或测试,验收前置;
- 报错了贴完整 traceback,别只说“跑不通”。
下一步可以把“版本 + 依赖 + 输入输出 + 验证”固化为提问模板,每次都按这个骨架问。
补充一条实战习惯:把"版本 + 依赖 + 输入输出 + 验证"固化成提问模板后,每次生成前先运行一遍确认环境无误;若失败,再带着报错回到对应写法里修复,比从零重写提示更高效。长期坚持,一次跑通率会稳步提升。
延伸学习
想把这块系统补齐,可以按这个顺序来:
- 先过一遍 Python 零基础到高薪就业,把基础和可运行习惯打牢;
- 提示词还拿不准时,翻 AI 提示词怎么写才好用:3 个可直接抄的模板;
- 写完用 Python代码格式化 整理,便于复核结构。
常见问题
Q:为什么同样的提示,有时跑通有时跑挂? A:模型本身有采样随机性,加上它对你环境是猜的。把版本、依赖、输入输出写死,并要它附验证,能把随机性压到最低。
Q:代码跑通了但结果不对怎么办? A:先用写法三贴出“预期 vs 实际”,让模型只改逻辑错误而非重写。重写容易引入新问题,定点修更稳。
Q:要不要把整个项目文件都贴给模型? A:不要。贴最小可复现片段即可,太长会稀释关键约束、还可能泄露敏感配置。只给相关函数、报错和环境信息最高效。



