
 TRAE-AI编程

刷题或面试备战时常遇到这种情况:把题目贴给 AI,几秒钟就吐出一份“看起来很对”的算法题解。但 AI 生成算法题解最大的坑,不是写不出代码,而是写出“在示例上通过、在边界上翻车”的解法。要让它真正可用,必须建立一套验证正确性的习惯,而不是照抄输出。
所谓验证正确性,核心是用“可复现的测试”去证伪,而不是用“读着像对的”去相信。下面从最小可行验证到进阶手段,讲清上手前该确认的几件事。
先看结论
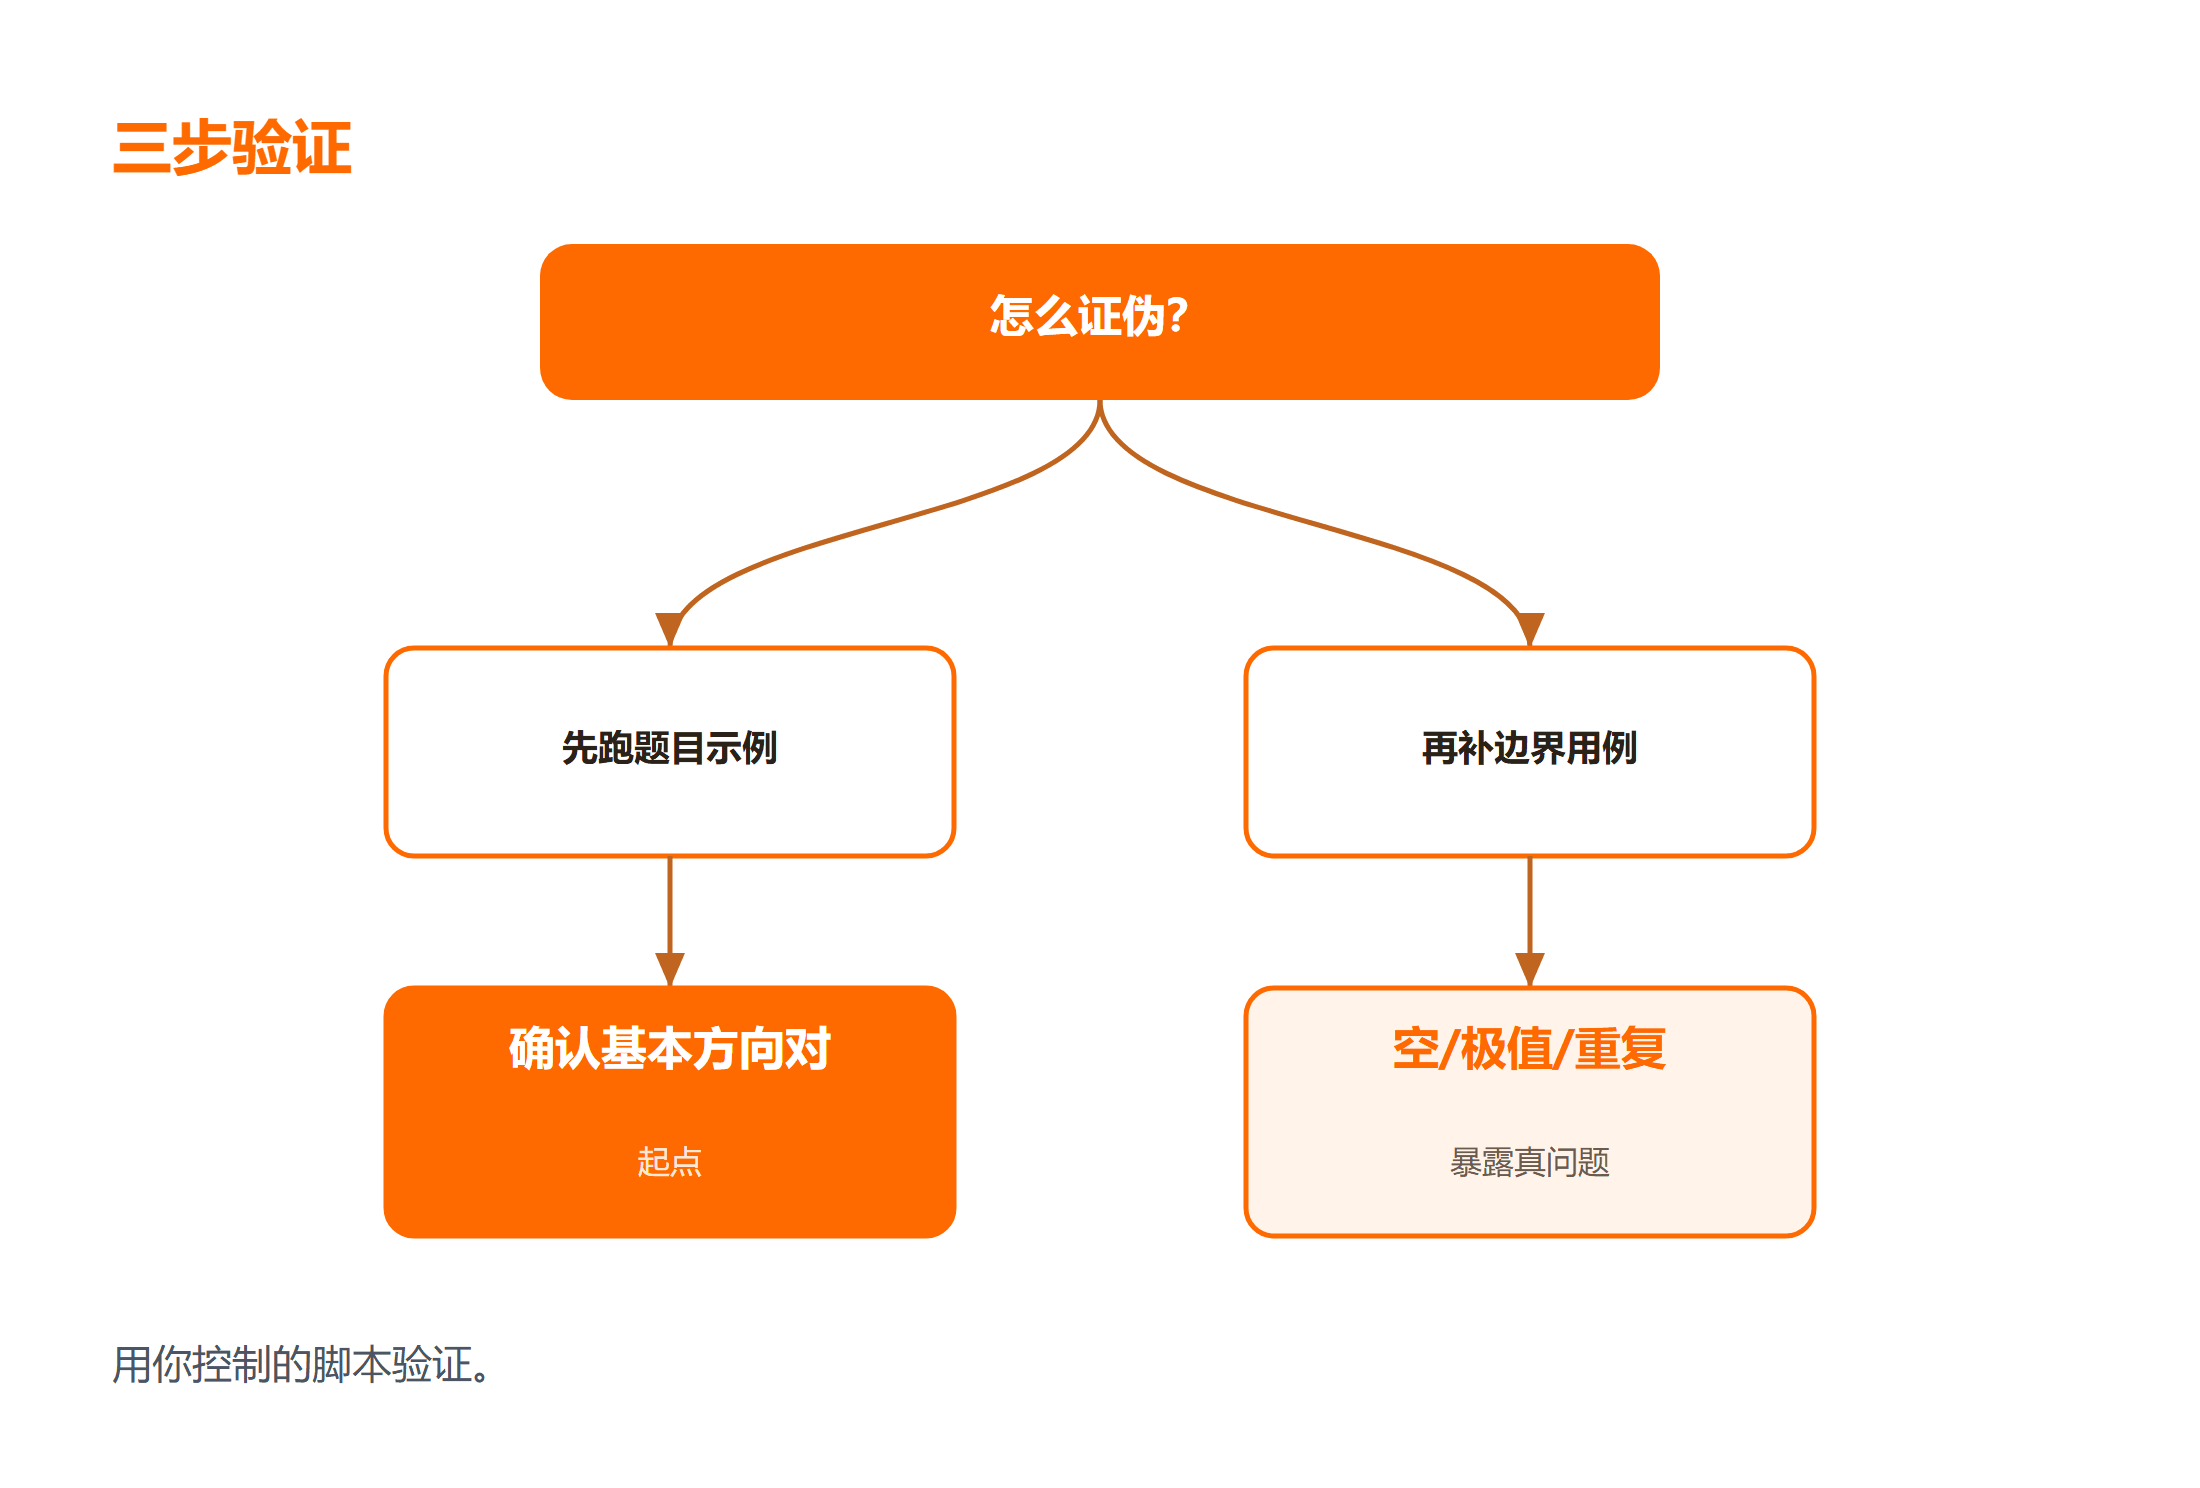
拿到 AI 给的算法题解,先做三件事:用题目给的示例跑通、构造边界用例(空输入、极大极小、重复元素)跑通、再写单元测试覆盖典型分支。只要有一类用例失败,就说明题解不可信,必须让模型针对该用例修正,而不是整体重来。
一、最小场景与预期行为
假设题目是“数组中去重并保留首次出现顺序”。你拿到一段代码,预期是:输入 [1,2,2,3,1] 输出 [1,2,3],且时间复杂度可控。但 AI 可能写成“先排序再去重”,顺序就错了。
明确这个预期很重要,因为它是验证的基准。没有预期输出,就无法判断 AI 是不是在胡编。关于模型能力边界,可参考 DeepSeek 中文教程。
验证的前提是“先想清楚什么是对的”。很多人在拿到 AI 代码后直接跑,跑通示例就收工,却从没认真定义过自己的预期输出。建议在贴题之前,自己先把两三个关键用例的手算答案写下来,这些就是后续验证的“标尺”。没有标尺,再多测试也只是盲跑。
二、先用最稳的实现:示例 + 边界双跑
最稳的验证,是先拿题目示例确认“基本对”,再补边界用例确认“真的对”:
def dedupe_keep_order(a):
    seen = set()
    out = []
    for x in a:
        if x not in seen:
            seen.add(x)
            out.append(x)
    return out

assert dedupe_keep_order([1, 2, 2, 3, 1]) == [1, 2, 3]
assert dedupe_keep_order([]) == []
assert dedupe_keep_order([5, 5, 5]) == [5]
示例通过只是起点,真正暴露问题的是后面两条空输入与全重复用例。更多 AI 能力用法见 TRAE 编程中文教程。
示例用例里,前两条是“正常路径”,第三条空输入和第四条全重复才是“异常路径”。AI 的解法常常在正常路径上无懈可击,一遇到异常就暴露出边界没考虑。所以验证的重心应该放在异常路径上,而不是反复确认它已经对的那些点。异常路径恰恰是 AI 最弱、也最容易被忽略的环节,多花十分钟在边界上,往往能救回一道本以为稳了的题。
三、替代方案与取舍
当用例变多,再考虑自动化手段:
第一种,写单元测试覆盖分支。把示例、边界、随机大规模用例都写进测试,跑通才算数。AI 编程能帮你起稿,但验证必须自己掌控。
第二种,用大样例对拍。拿一份已知正确的暴力解,和 AI 的解法在随机数据上比对输出,不一致就定位差异。TRAE 的插件能力也支持此类工作流,可看 Trae Plugin Use AI Capabilities。
对拍法的价值在于“不依赖你对算法的理解”。哪怕你看不懂 AI 写的那段递归,只要有一份你知道正确的暴力解,就能用随机数据逼出差异。差异出现时,先别急着改 AI 的代码,而是定位是哪类输入导致不一致,这往往能直接指向它逻辑里的漏洞。
第三种,复杂度复核。让模型说明时间/空间复杂度,并对照题目约束判断是否会超时。
四、反例、边界与常见失败
最容易踩的坑有三个。
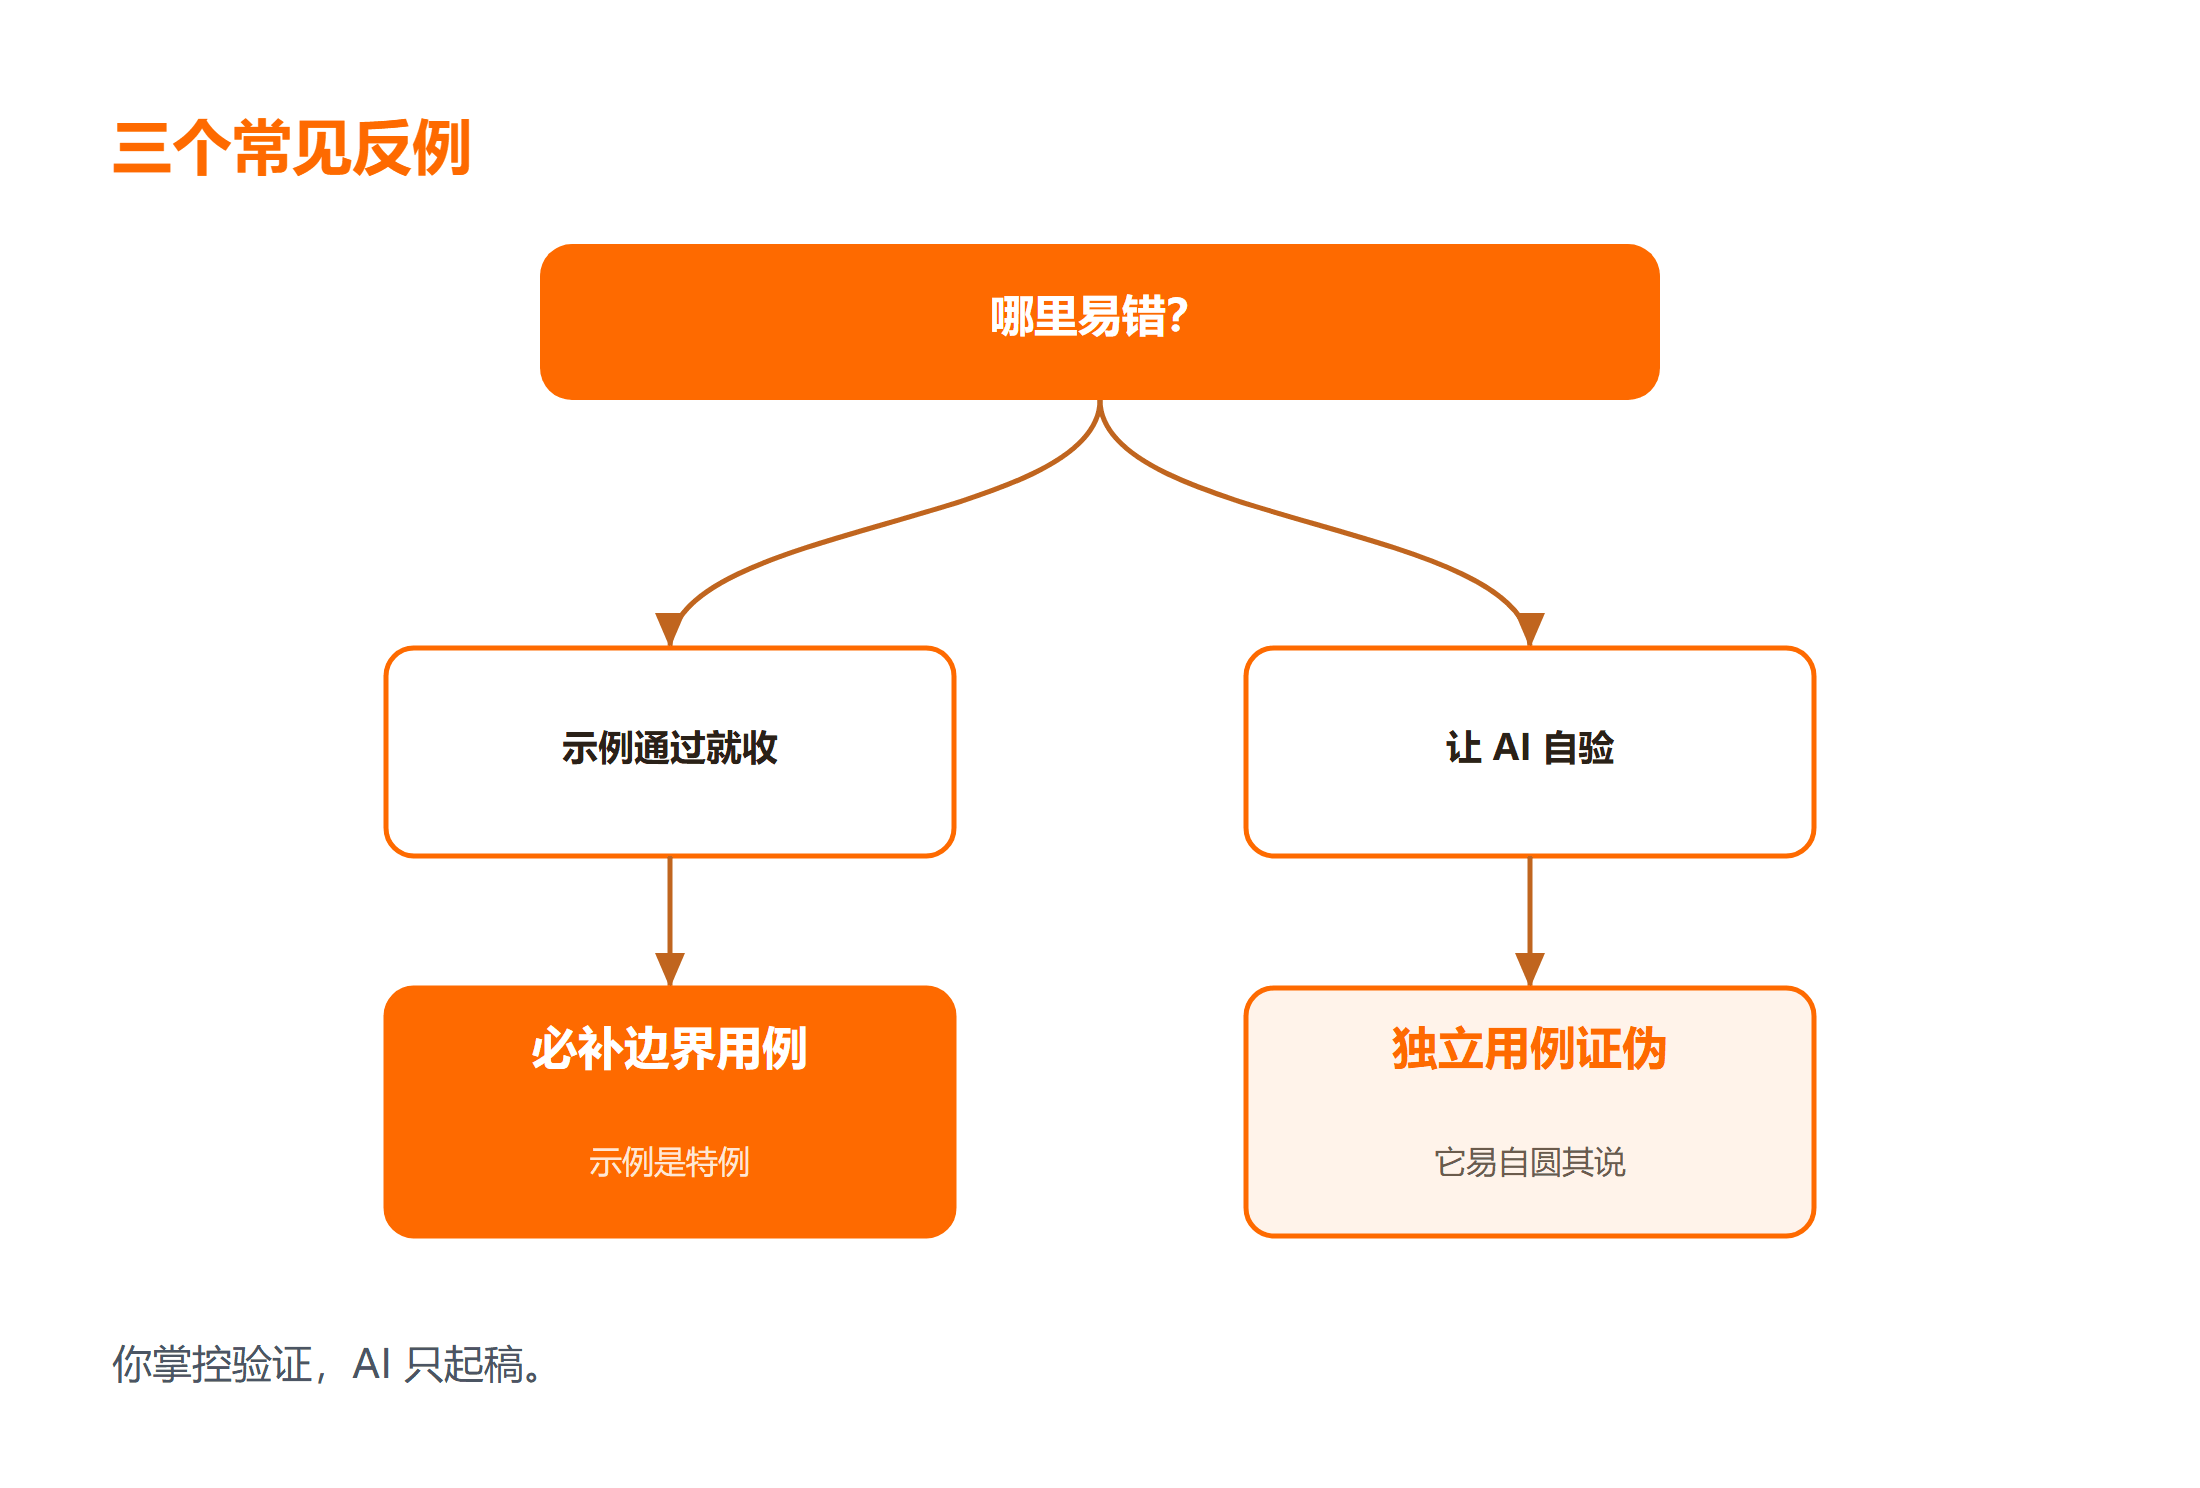
坑一:只看示例通过就收。示例往往是特例,AI 的解法常在这些点上“刚好对”,一换输入就错。务必补边界用例。
坑二:让 AI“自己验证自己”。模型容易为了通过测试而改写测试、或给出看似合理的错误解释。验证要用你控制的脚本,而不是它的自述。排查思路可参考 TRAE 问题排查。
坑三:忽略整数溢出与浮点误差。涉及大数相乘、除法比较时,AI 容易写出在小数上翻车的实现,需用极值用例压测。
验证还要覆盖“输出格式”而非只覆盖“数值正确”。有些题解数值算对了,返回的却是列表而不是题目要求的特定结构,照样被判错。把格式校验也写进你的测试,能让 AI 的产出更接近可提交的形态,减少临场翻车。面试里格式错和答案错一样扣分,这个细节值得写进你的固定测试模板。
坑四:低估大样例对拍的时间成本。用暴力解对拍 100 组随机数据时,如果暴力解本身是指数级复杂度,单组就要耗上几秒,整体跑完可能比写题还久。遇到这种规模,先把数据量降到能秒级返回的量级做正确性验证,再单独用小规模随机用例压边界;验证的目标是先生效、再谈性能,顺序不能反。把对拍当成“找反例”而非“跑压测”,心态和写法都会更稳。
动手验证清单
- 安装/配置:准备好 Python 环境与题目函数。
- 运行:依次执行示例、空输入、全重复、大规模随机用例。
- 检查:每条 assert 都应通过;任一失败即说明题解有误。
- 预期:解法在给定约束下不超时、不爆精度。
- 验证:用一份暴力解对拍 100 组随机数据,输出应完全一致。
- 失败处理:若某用例失败,把该用例贴回模型,要求其针对此例修正而非整体重写。
- 注意:以上代码为演示,未在本机逐条执行,请以你的实际运行结果为准。
常见问题
Q:AI 给的算法题解示例通过了,能直接用吗?
不能。示例通过只说明基本方向对,必须用边界用例与随机对拍验证,否则很容易在隐藏测试上出错。
Q:让 AI 自己写测试来验证靠谱吗?
只能作为辅助。模型可能为了通过而改写测试或自圆其说,验证脚本应由你自己控制,用独立用例去证伪。
Q:没有暴力解怎么对拍?
可缩小数据规模手算几组、或换一种已知正确的思路实现一份参考解,再与 AI 解法比对输出差异。
总结
AI 生成算法题解的价值在“快”,风险在“假对”。验证正确性不能靠“读着像对的”,而要靠可复现的测试:先用题目示例跑通,再补空输入、极值、重复元素等边界用例,最后用单元测试或暴力解对拍收尾。任何一类用例失败,都说明题解不可信,应针对该用例让模型修正。记住——你掌控验证,AI 只提供草稿。



