
 TRAE-AI编程

结论先说:用通义千问读 PDF 提取表格数据,最稳的做法是"先想清楚表格长什么样,再决定让它输出成什么格式"——直接丢一句"把表格提取出来"往往得到错列、合并单元格丢失的结果。本文基于通义千问的文档解析与对话能力,讲清动手前先想清楚的几件事:表格是规则还是扫描件、要转成 Markdown 还是 Excel、以及怎么校验提取结果没串列。动手前多想清楚一步,后面抽样核对的工作量能少一大半,也更能信得过结果。
先看结论
通义千问做 PDF 表格提取,建议分三步:第一步确认 PDF 是文本型还是扫描型(扫描件要先走 OCR,模型直接读会丢字);第二步明确告诉模型"保留表头、按行输出、不要合并单元格";第三步把结果和原表抽样核对,重点查数字串列和跨页断行。边界是:模型对不规则表格的还原不如专用 PDF 解析库精确,金额、日期这类关键列务必人工抽验。
一、先想清楚:你的 PDF 是哪种
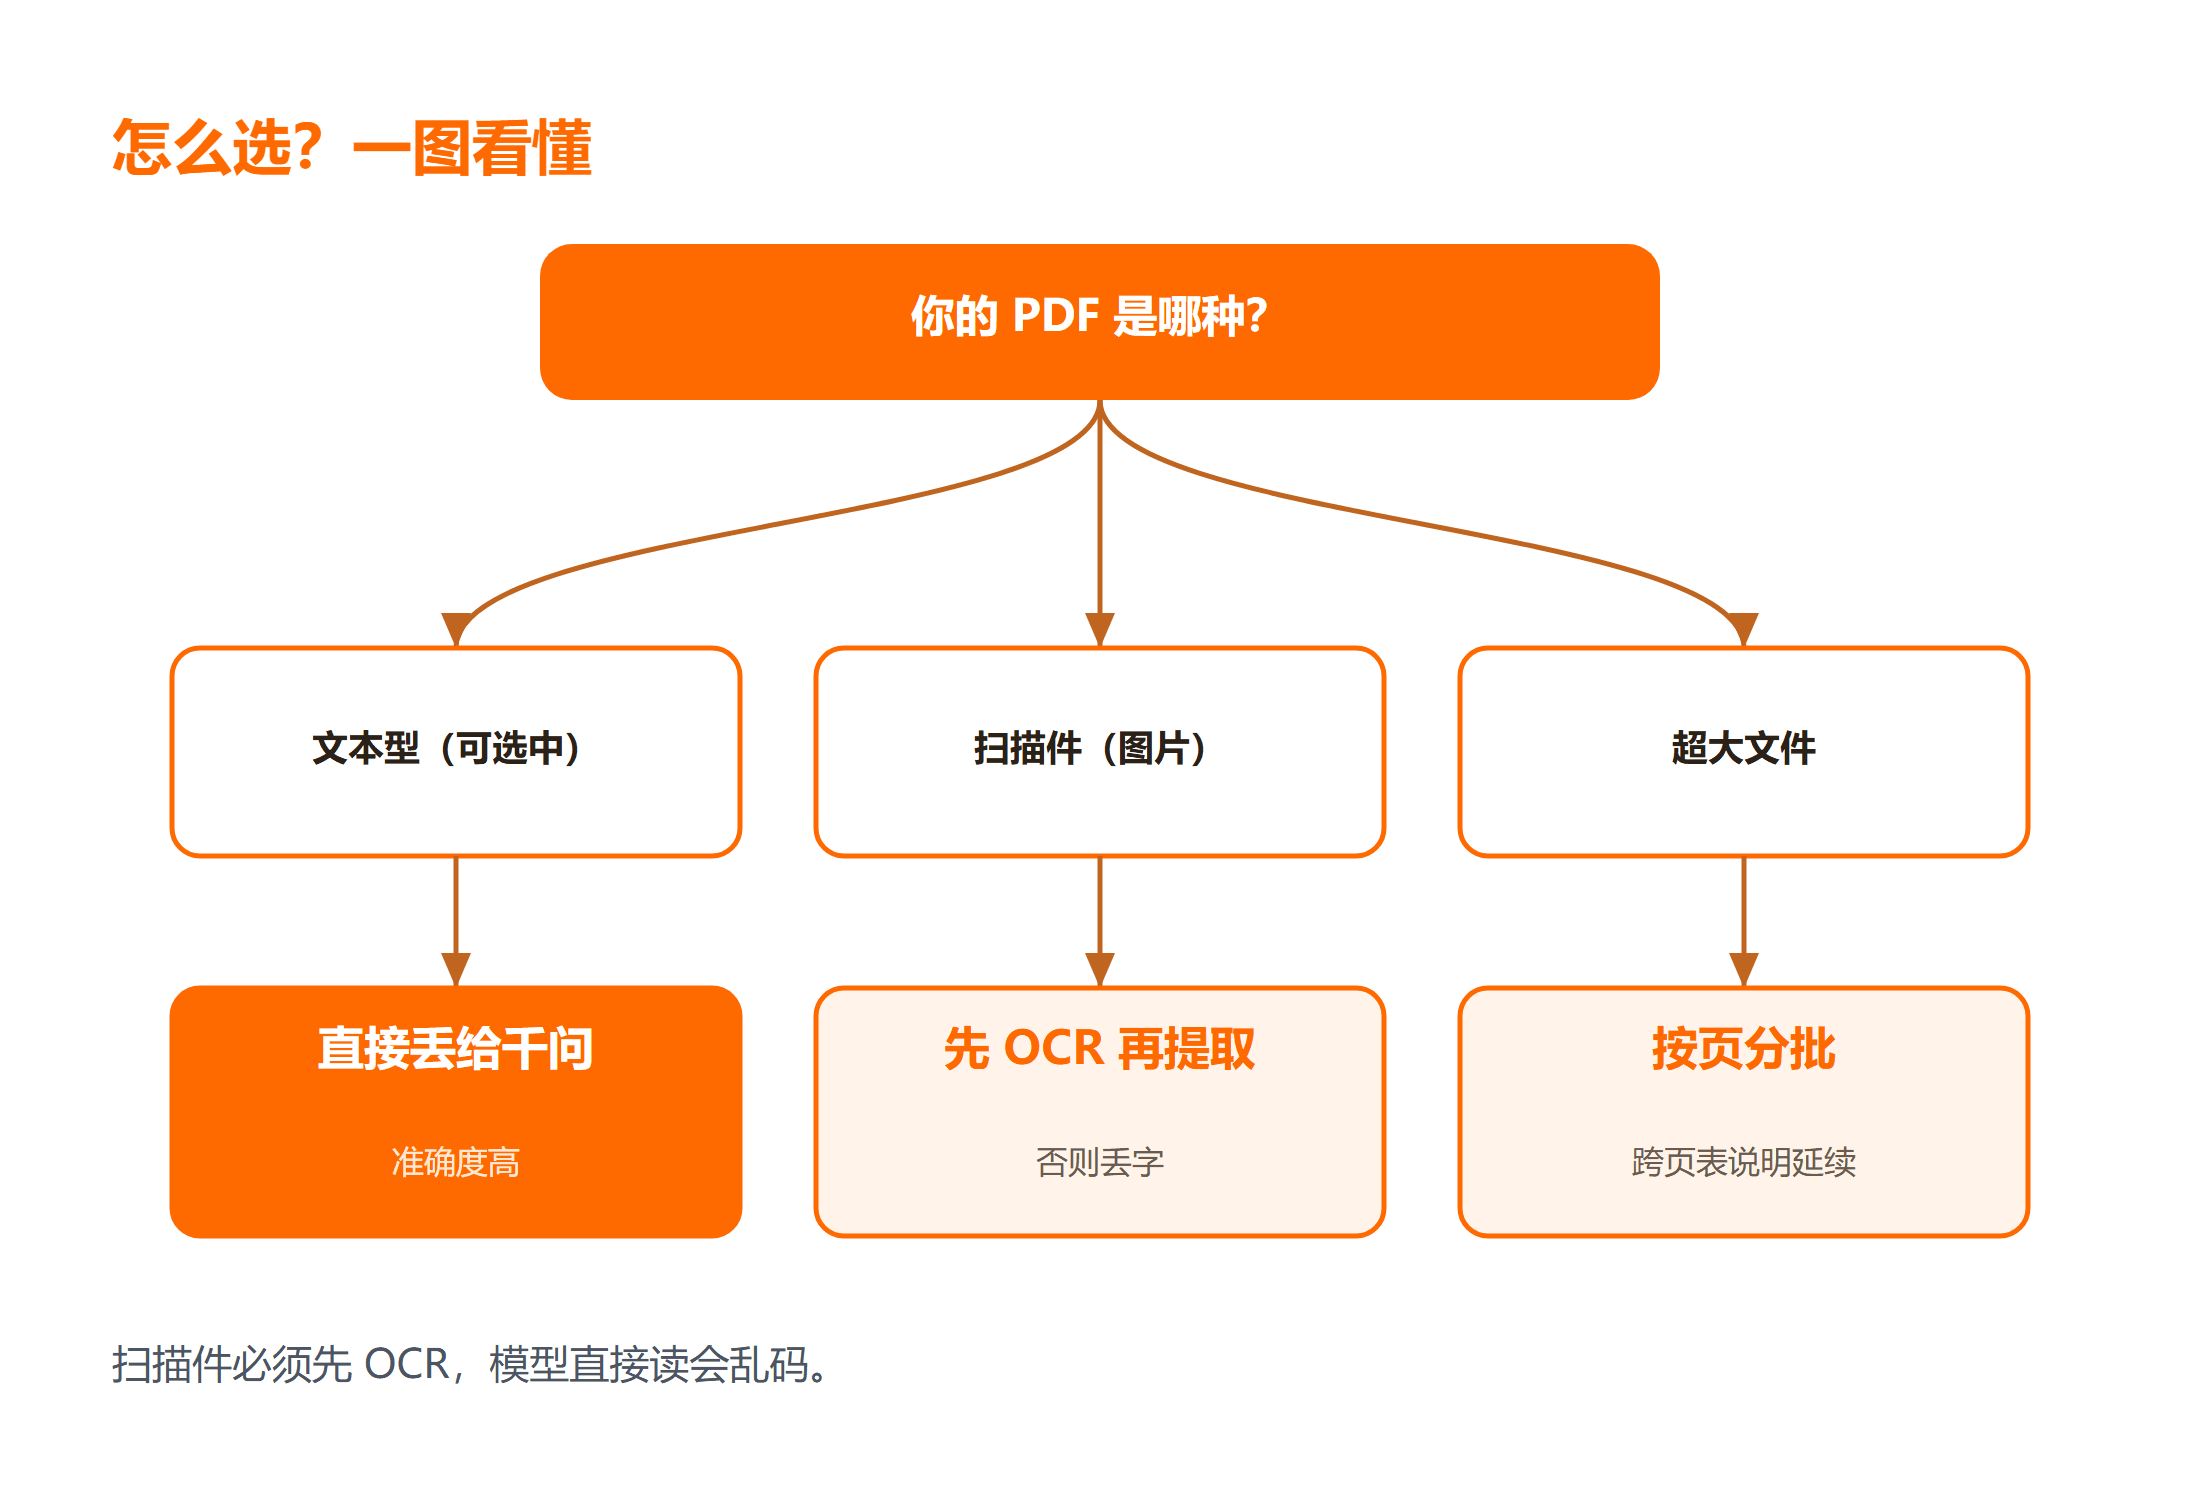
动手前先确认表格来源。文本型 PDF(可选中文字)通义千问读起来基本准确;扫描件(图片型)必须先 OCR,否则模型读到的可能是乱码或空白。判断方法很简单:用阅读器试着选中表格里的字,选不中就是扫描件。通义千问读 PDF 的适用前提是表格结构相对规整;遇到严重合并单元格、跨页断行,模型很容易错位,这类场景更适合交给专用 PDF 解析库或人工核对,别迷信一键提取。
# 用 pypdf2 先看一页能不能提取出文字(预期:能打印出该页文本)
python3 -c "import pypdf2" 2>/dev/null && echo 'pypdf2 可用,文本型 PDF 可走程序提取'
上面这行是在确认本地有没有 pypdf2 这个 PDF 解析依赖,能在命令行回显说明环境就绪,后面无论是程序提取还是交给通义千问,都更有底。动手前先配置好提取环境:运行这步确认能读到文字后,检查 PDF 类型是否为文本型,预期选中的字能被正常复制;对扫描件要先做 OCR 把图片转成文字,再验证提取结果有没有串列。
二、告诉模型"怎么读",而不是"读一下"
最常见的错误提示是"帮我把这个 PDF 的表格提取出来"。这种指令太模糊,模型会按自己的理解整理,经常把跨页表格截断、把表头丢失。
更好的问法是带约束:"请读取附件 PDF,提取第 3 页的表格,保留原表头,每一行一条记录,不要合并单元格,输出为 Markdown 表格。" 约束越具体,AI 读 PDF 的还原度越高。如果你参考 PyPDF2 使用文档 的解析思路,会发现程序提取也是"先定结构再取数",和给模型的指令逻辑一致。
三、决定输出格式:Markdown 还是 Excel
提取出来要干什么,决定输出格式。如果只是自己看、要发文档,Markdown 表格最方便;如果要进数据库或继续计算,务必让它直接输出 CSV 或给出可复制的结构。
通义千问对 Markdown 表格的支持很稳,但转到 Excel 时容易在逗号、引号上出错。涉及金额、编号的表格,宁可要 CSV 也不要让模型"顺便格式化",避免它自作主张改列。把"读 PDF"和"提取表格数据"拆成更可控的两步,反而更不容易串行。
四、校验:别只看"提取成功"
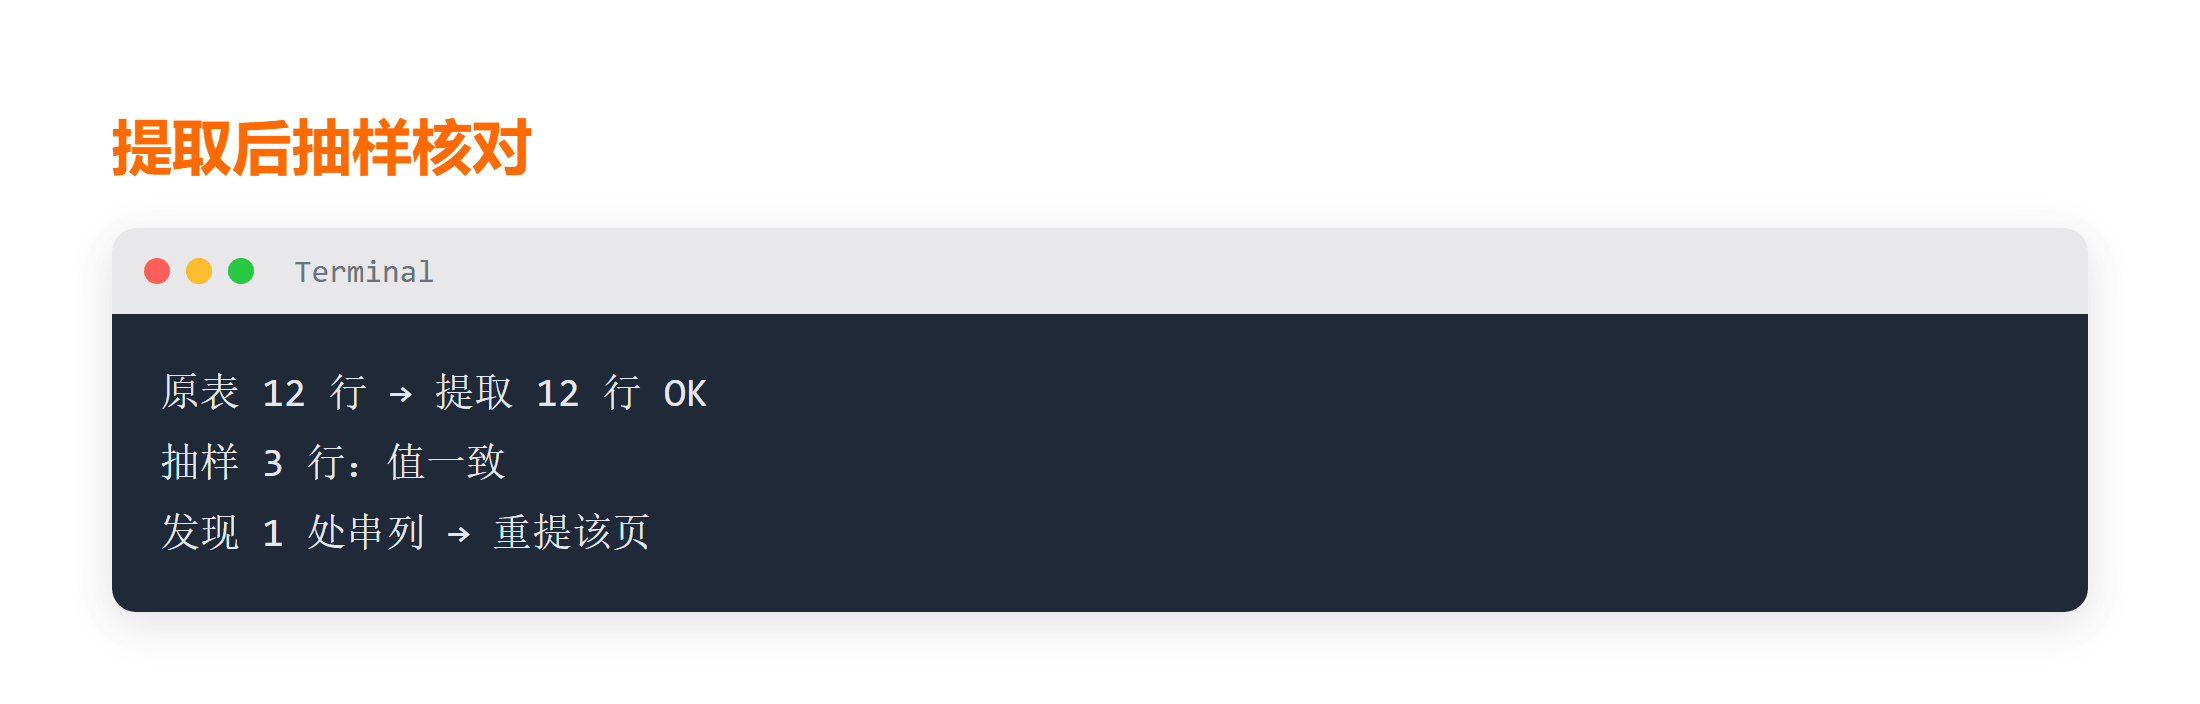
提取完最危险的一步是默认它全对。务必抽样核对:随机挑三行,把模型给的值和原 PDF 对照,重点查三类问题——数字串列(把 B 列的值填到了 C 列)、跨页断行(一行被拆成两行)、表头错位(子表头被当成数据)。
如果一处出错,宁可让模型重提这一页,也不要整张表手动改。对关键表格,建议让它同时给出"行数",你数一下原表行数是否一致,能快速发现漏行。
提取到 Markdown 或 CSV 只是中间态,要真正可用还有两步。
第一步,做字段级校验。除前面说的抽样三行,还要核对表头是否齐全、合并单元格有没有被拆散成多行、跨页表格的表头是否在第二页重复出现导致重复列。金额、日期这类关键列,建议人工抽验至少 5 处,别只信模型说"已提取完成"。
第二步,决定落库方式。要进数据库就直接要 CSV 并指定编码为 UTF-8,避免中文乱码;要做二次计算就让它给出可复制的结构,而不是一段描述。用 Python 处理这类结果时,可参考 Python 速查手册 核对字符串与文件读写的用法。
失败处理上,如果一处出错,宁可让模型重提这一页,也不要整张表手动改——手动改既慢又容易引入新错。对关键表格,让它同时给出"行数",你数一下原表行数是否一致,能快速发现漏行。通义千问读 PDF 的适用前提是表格结构相对规整,遇到严重合并单元格、跨页断行,模型很容易错位,这类场景更适合交给专用 PDF 解析库或人工核对。收尾这一步多花两分钟,后面因为数据错列返工的概率会明显下降,通义千问读 PDF 才真正省事。记住一个原则:提取结果的"可用",永远比"提取成功"更重要,宁可多核一遍,也不要把脏数据直接喂进数据库。
常见问题
Q:扫描件能不能直接让通义千问读?
不能直接读准。扫描件要先做 OCR 把图片转成文字,再交给模型提取;否则极容易丢字、串行,结果不可用。
Q:为什么提取的表格数字会串列?
多半是表格本身不规则(合并单元格、列宽不统一),模型按视觉对齐猜测列归属出错。补一句"严格按表头列对齐,缺失值留空"能显著改善。
Q:大文件一次读不完怎么办?
按页分批提交,每页单独提取再拼接。跨页表格要特别说明"这是同一张表的延续",避免模型当成独立表处理。
总结
用通义千问读 PDF 提取表格数据,核心是先想清楚 PDF 类型和目标格式,再用带约束的指令让模型"按结构取数",最后抽样校验串列与漏行。AI 读 PDF 虽方便,但金额、日期这类关键列必须人工抽验,PDF 解析的精度边界要心里有数。



