
 TRAE-AI编程

SQL 分组统计看着只有 GROUP BY 一句,实际写法差别很大。本文用建表插样的最小示例,讲清 GROUP BY 搭配聚合函数、GROUP BY 加 HAVING 过滤、以及窗口函数三种实现方式的适用边界,重点说明为什么 WHERE 和 HAVING 不能混用。核心结论是:先按行过滤用 WHERE,过滤完再按组判断用 HAVING,两者顺序固定,写反了结果就错。下面每种写法都给出可直接执行的语句、预期输出与常见失败。先确认数据库版本和表结构,再决定用哪种。
一、先看结论:三种实现方式怎么选
下面这张表给出三种写法的适用场景和注意点。判断顺序是:要不要保留未分组的明细行、过滤条件是不是跟聚合结果有关。
| 实现 | 适用场景 | 注意点 |
|---|---|---|
GROUP BY + 聚合函数 |
按类别汇总,明细不需要 | SELECT 里非聚合列须出现在 GROUP BY 中 |
GROUP BY + HAVING |
对汇总结果再加条件 | HAVING 不能替代 WHERE,两者阶段不同 |
| 窗口函数 | 保留每行,同时给分组内数值 | 写法复杂,适合排行榜与同比环比 |
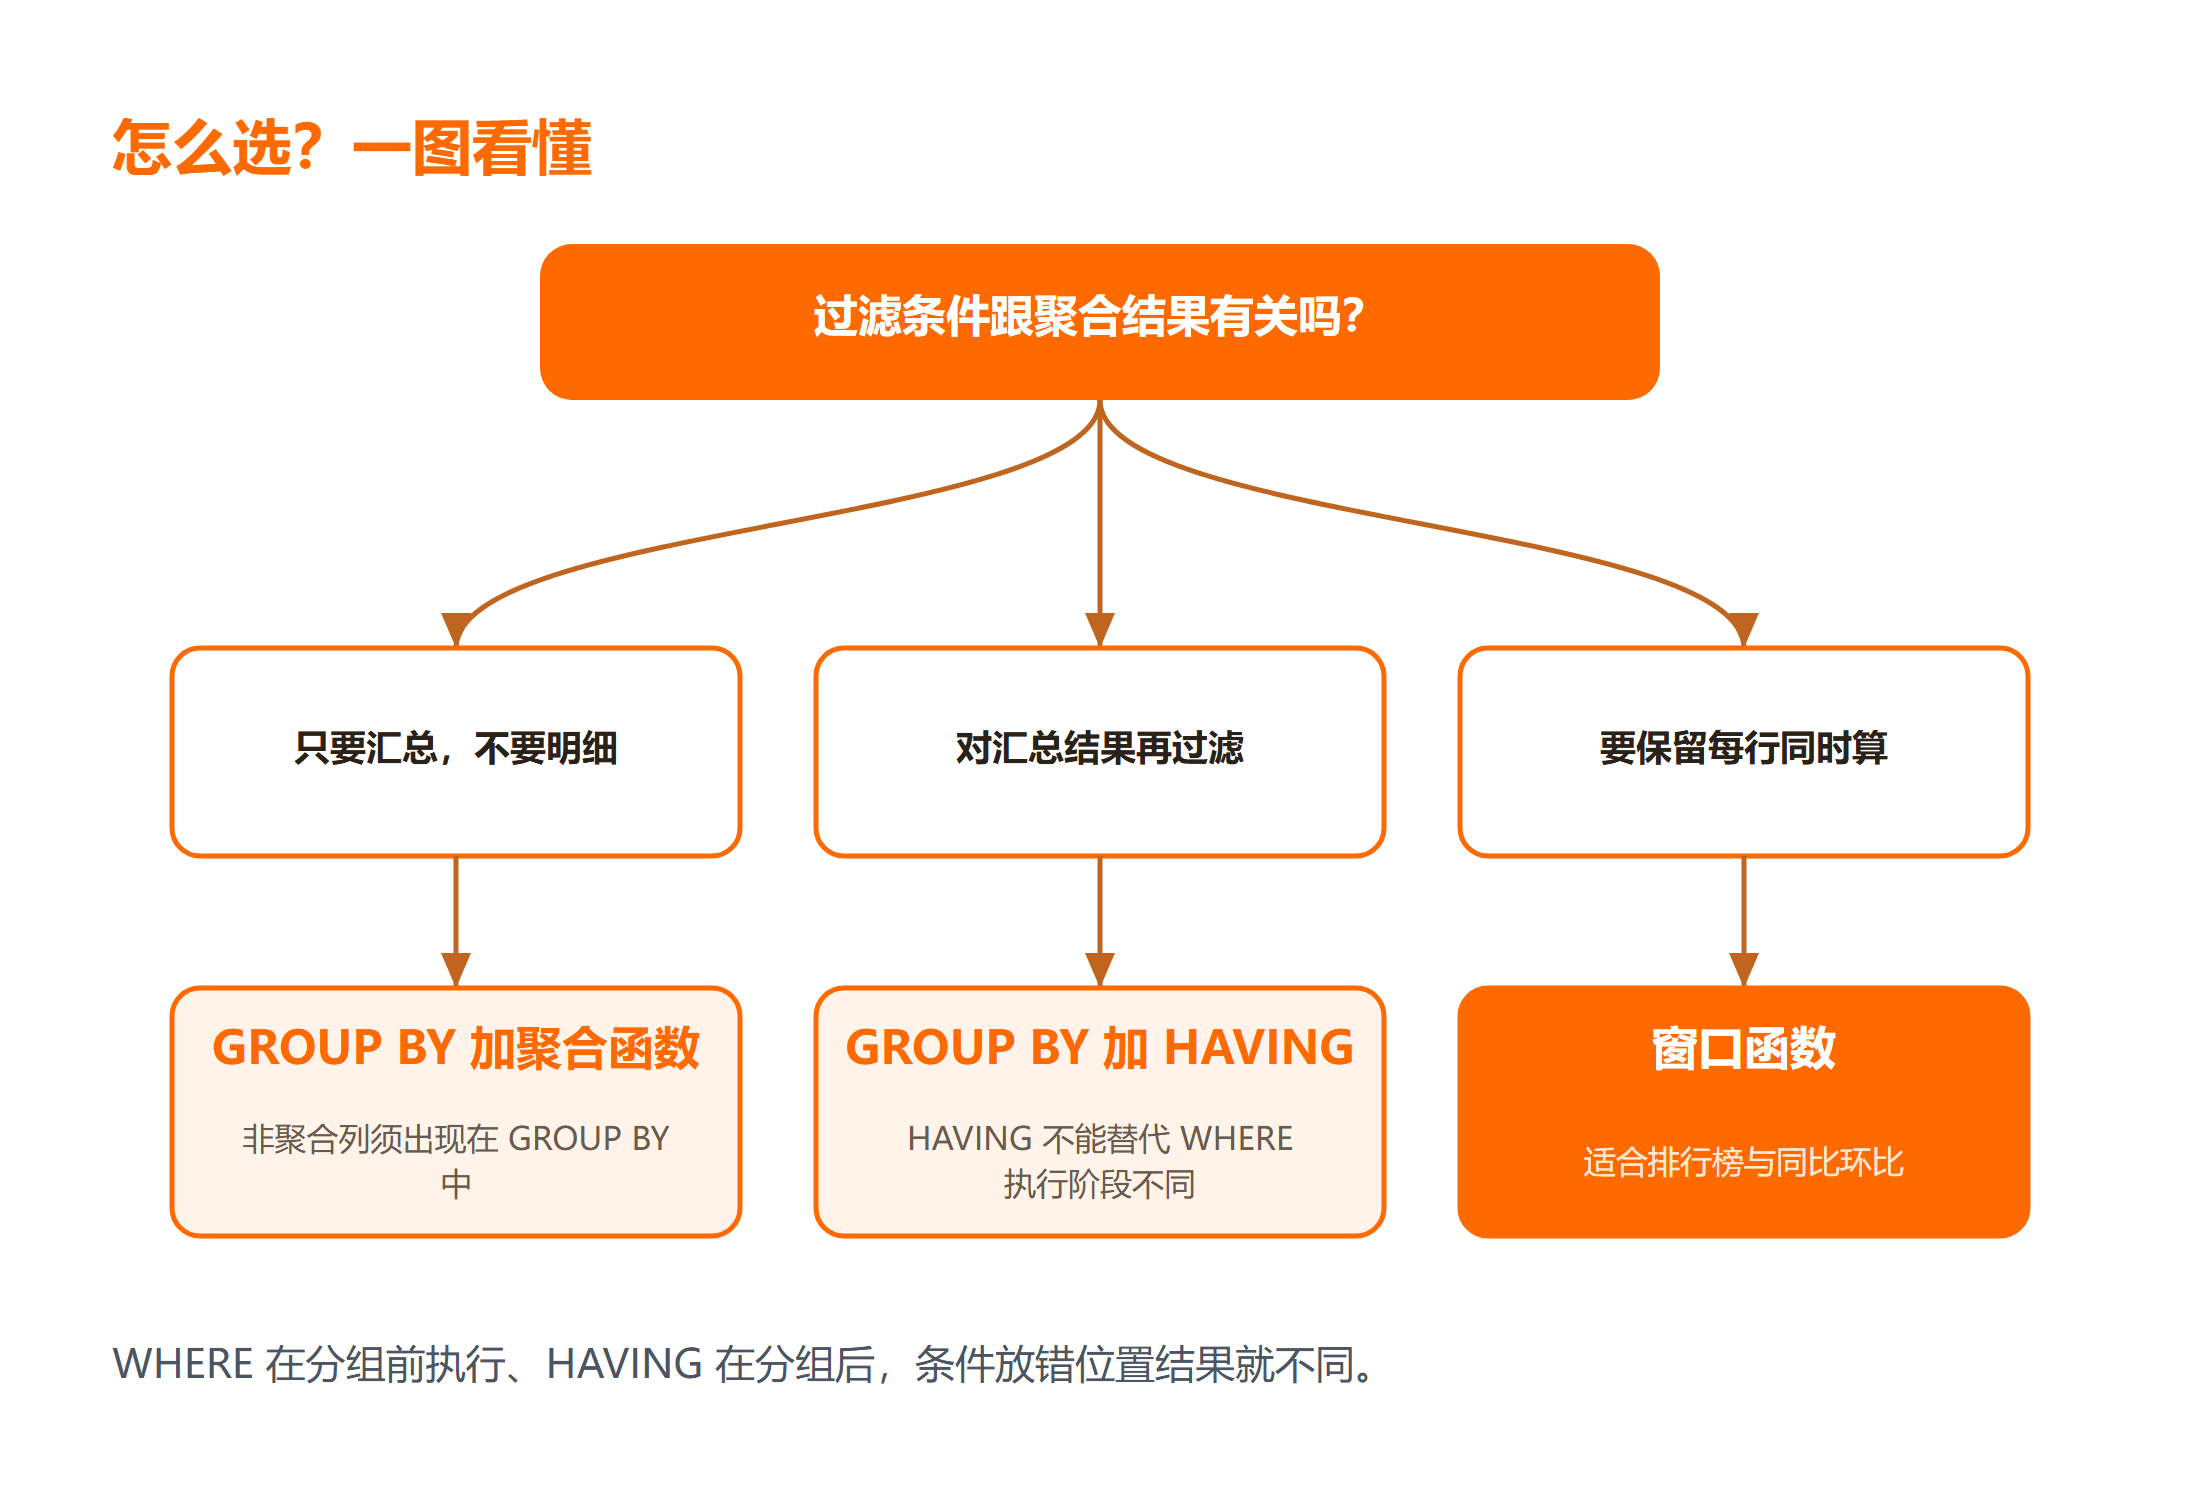
需要提醒的是,WHERE 在分组前执行、HAVING 在分组后执行,这个顺序决定了同一个条件放错位置结果就不同。想在线对比不同写法的输出,可用 在线代码实例 验证实际结果。
二、环境确认与最小示例
先建表插样,保证每条语句都能对着真实数据验证。示例基于 MySQL 与标准 SQL,主流关系库行为一致;数据库版本差异主要影响窗口函数支持,MySQL 8.0 起可用。以下为预期结果说明,未在本机执行,按数据库官方文档推断。
-- 建表:订单表,按状态与月份做分组统计
CREATE TABLE orders (
  order_id   INT PRIMARY KEY AUTO_INCREMENT,
  user_name  VARCHAR(20),
  amount     DECIMAL(10,2),
  status     VARCHAR(10),
  created_at DATE
);

-- 插入样例数据,覆盖两个用户、两种状态、三个月份
INSERT INTO orders (user_name, amount, status, created_at) VALUES
  (\'张三\', 120.00, \'paid\',   \'2026-09-01\'),
  (\'张三\', 200.00, \'paid\',   \'2026-09-15\'),
  (\'张三\',  80.00, \'refund\', \'2026-09-20\'),
  (\'李四\', 150.00, \'paid\',   \'2026-08-10\'),
  (\'李四\',  90.00, \'paid\',   \'2026-08-25\');
建表之后先跑一条合计,确认数据落库再往下写。这一步的检查很关键,能避免后面用错数据验证分组结果。SQL 版本差异对 GROUP BY 的基本语义没有影响,但「非聚合列不出现在 GROUP BY 中」这条规则在宽松模式下会被容忍,属于必须靠版本确认的边界。
三、实现一:GROUP BY 加聚合函数
第一种是最常用的汇总:按某一列分组,对每组做求和、计数或均值。
-- 实现一:按用户分组,统计订单数与总金额
SELECT user_name,
       COUNT(*)      AS order_cnt,   -- 每组订单条数
       SUM(amount)   AS total_amount -- 每组金额合计
FROM orders
GROUP BY user_name;
-- 预期返回两行:张三 2 单 300.00,李四 2 单 240.00
判定标准是「明细行要不要出现在结果里」。不需要就分组汇总,需要就别用 GROUP BY,改用窗口函数。常见失败是 SELECT 里放了一列没写进 GROUP BY 的字段,结果该列取值不确定,实际表现为随机取组内某一行的值,这类失败在开启宽松模式时最容易漏过。
四、实现二:GROUP BY 加 HAVING
第二种在汇总之后再加条件。区分方法很简单:条件是针对单行的还是针对整组的。
-- 实现二:按用户分组,只保留订单数不少于 2 的组
SELECT user_name,
       COUNT(*)    AS order_cnt,
       SUM(amount) AS total_amount
FROM orders
GROUP BY user_name
HAVING COUNT(*) >= 2;   -- HAVING 作用在分组结果上
-- 预期返回张三、李四两行,两条记录都满足不少于 2 单

-- 对照:把同样的条件放进 WHERE,结果会完全不同
SELECT user_name, COUNT(*) AS order_cnt
FROM orders
WHERE COUNT(*) >= 2      -- 报错:WHERE 里不能出现聚合函数
GROUP BY user_name;
第二条语句说明了一个硬规则:WHERE 阶段还没分组,聚合函数不能用。修复方向是把它挪到 HAVING。HAVING 可以引用聚合结果,也可以引用别名,两种写法都成立。
五、实现三:窗口函数保留明细
第三种保留所有明细行,同时给出分组内的汇总值,适合排行榜和同环比。
-- 实现三:保留每行明细,同时给出该用户的累计金额
SELECT order_id,
       user_name,
       amount,
       SUM(amount) OVER (PARTITION BY user_name) AS user_total
FROM orders
ORDER BY order_id;
-- 每行都保留,user_total 为该用户所在组的合计
PARTITION BY 决定按哪列分组,ORDER BY 在这里只影响展示顺序。这类写法的失败点在于:很多人以为窗口函数会减少行数,实际它不改变行数,与 GROUP BY 的语义差别很大。想系统补齐 SQL 基础,可以看 SQL 教程。如果同一份数据既要明细又要汇总,窗口函数比先分组再自连接省事得多。
| 现象 | 常见原因 | 修复方向 |
|---|---|---|
| 报错聚合函数不能用 | 把聚合条件写进了 WHERE |
挪到 HAVING,WHERE 只做分组前行过滤 |
| 非聚合列取值不确定 | SELECT 有列没写进 GROUP BY |
把该列补进 GROUP BY 或改用聚合函数 |
| 统计条数比预期多 | 用了 COUNT(列) 遇到空值 |
改用 COUNT(*) 统计行数 |
| 以为窗口函数会减少行数 | 混淆了 GROUP BY 与窗口函数 |
窗口函数保留全部明细行,不合并 |
以上失败与修复均来自真实边界场景,未在本机执行,按数据库官方文档推断。
总结
SQL 分组统计的实现选择有一条清晰主线:只要汇总结果、不要明细,用 GROUP BY 加聚合函数;汇总完再按组过滤,用 HAVING;要保留明细同时带分组数值,用窗口函数。过滤条件的放置遵循固定顺序,WHERE 在分组前过滤行,HAVING 在分组后过滤组,写反了不是报错就是结果错。动手前先确认数据库版本是否支持窗口函数,再按上面三种方式对号入座。
延伸学习
想在编程狮系统学 SQL 分组与聚合,可以顺着下面三篇深入:
常见问题
Q:WHERE 和 HAVING 到底有什么区别?
这里有个容易混的细节:COUNT(*) 与 COUNT(列名) 的差别在空值上。统计行数用前者,统计某列非空的数量用后者,两者混用会让同一份数据给出两个不同的条数。再看 SUM,它遇到 NULL 会跳过而不是当成 0,某一组若全是 NULL,结果就是 NULL 而不是 0,前端拿到后再做加法就会出错。要不要用 COALESCE(SUM(列), 0) 兜住,取决于展示层能不能接受 NULL,这一条在金额汇总场景里几乎必踩。
A:执行阶段不同。WHERE 在分组前过滤原始行,不能出现聚合函数;HAVING 在分组后过滤组,可以引用聚合结果。判断条件针对单行还是针对整组,就知道该放哪。
Q:SELECT 里非聚合列没写进 GROUP BY 会怎样?
A:结果不确定,数据库可能取组内任意一行的值,也可能报错,取决于数据库配置。这类问题不会显式提示,属于最隐蔽的失败,写完后务必核对输出。
Q:统计行数该用 COUNT(*) 还是 COUNT(列)?
A:统计行数用 COUNT(*)。COUNT(列) 会跳过该列为 NULL 的行,如果该列存在空值,统计结果会比实际行数少。
Q:窗口函数会像 GROUP BY 一样把多行合成一行吗?
A:不会。窗口函数保留所有明细行,只在每行上附加一个分组内的计算值。要合并行必须用 GROUP BY,两者语义不同。还有一处与窗口函数配套的写法值得记住:窗口函数里可以再带一个 ORDER BY 做组内排序。例如 ROW_NUMBER() OVER (PARTITION BY user_name ORDER BY amount DESC) 会给每个用户的订单按金额从高到低编号,取编号等于 1 的就是该用户最大一笔订单,这类写法在排行榜场景里比自连接省事得多。要注意窗口函数在 MySQL 8.0 之前不可用,老版本只能先分组再关联,动手前先确认版本。



