
 TRAE-AI编程

你写结构体时有没有发现,两个 int 加起来明明 8 字节,打印 sizeof 却出来 12 或 16?这并不是编译器算错了。C 语言结构体内存对齐,是编译器为了让 CPU 取数据更快,按成员类型大小把字段摆放到特定地址的规则。本文用三个最小示例讲清对齐规则、怎么手算结构体大小,以及两个最容易踩的坑。看完你能自己预测任意结构体的字节数,不再被 sizeof 吓到。今天这篇文章,编程狮就把这块讲透。
一、先看结论
| 你想做的事 | 该怎么做 | 关键点 |
|---|---|---|
| 预测结构体大小 | 按对齐规则逐字段算偏移 | 末尾补齐到“最大对齐值”的整数倍 |
| 压缩结构体体积 | 把小字段凑一起、大字段靠后 | 重排成员常常能省几个字节 |
| 强制按 1 字节对齐 | 用 #pragma pack(1) |
只在跨平台传二进制时才用,会牺牲速度 |
二、结构体对齐到底在干什么
C 语言结构体内存对齐 的本质,是“字段的起始地址必须是某个数的整数倍”。CPU 从内存读数据时,按固定宽度的“块”来读最省事;如果一个 int 横跨两个块,就要读两次再拼起来,速度变慢。编译器干脆在字段之间留点空位,让每个字段都落在舒服的位置。
一个贴近生活的比喻:超市货架每层高度固定,小罐头(char,1 字节)如果随便塞,会和下一层的大盒子(int,4 字节)错位,理货员(CPU)拿取就别扭。对齐就是给每种商品规定“必须从第几格起放”。
2.1 两条核心规则
- 成员对齐:第 n 个成员的偏移量,必须是
min(该成员自身大小, 默认对齐数)的整数倍。32 位/64 位常见的默认对齐数是 8,但成员大小通常更小,所以实际对齐值取成员自身大小。 - 整体对齐:整个结构体的大小,必须是“所有成员里最大对齐值”的整数倍,末尾不足要补齐。
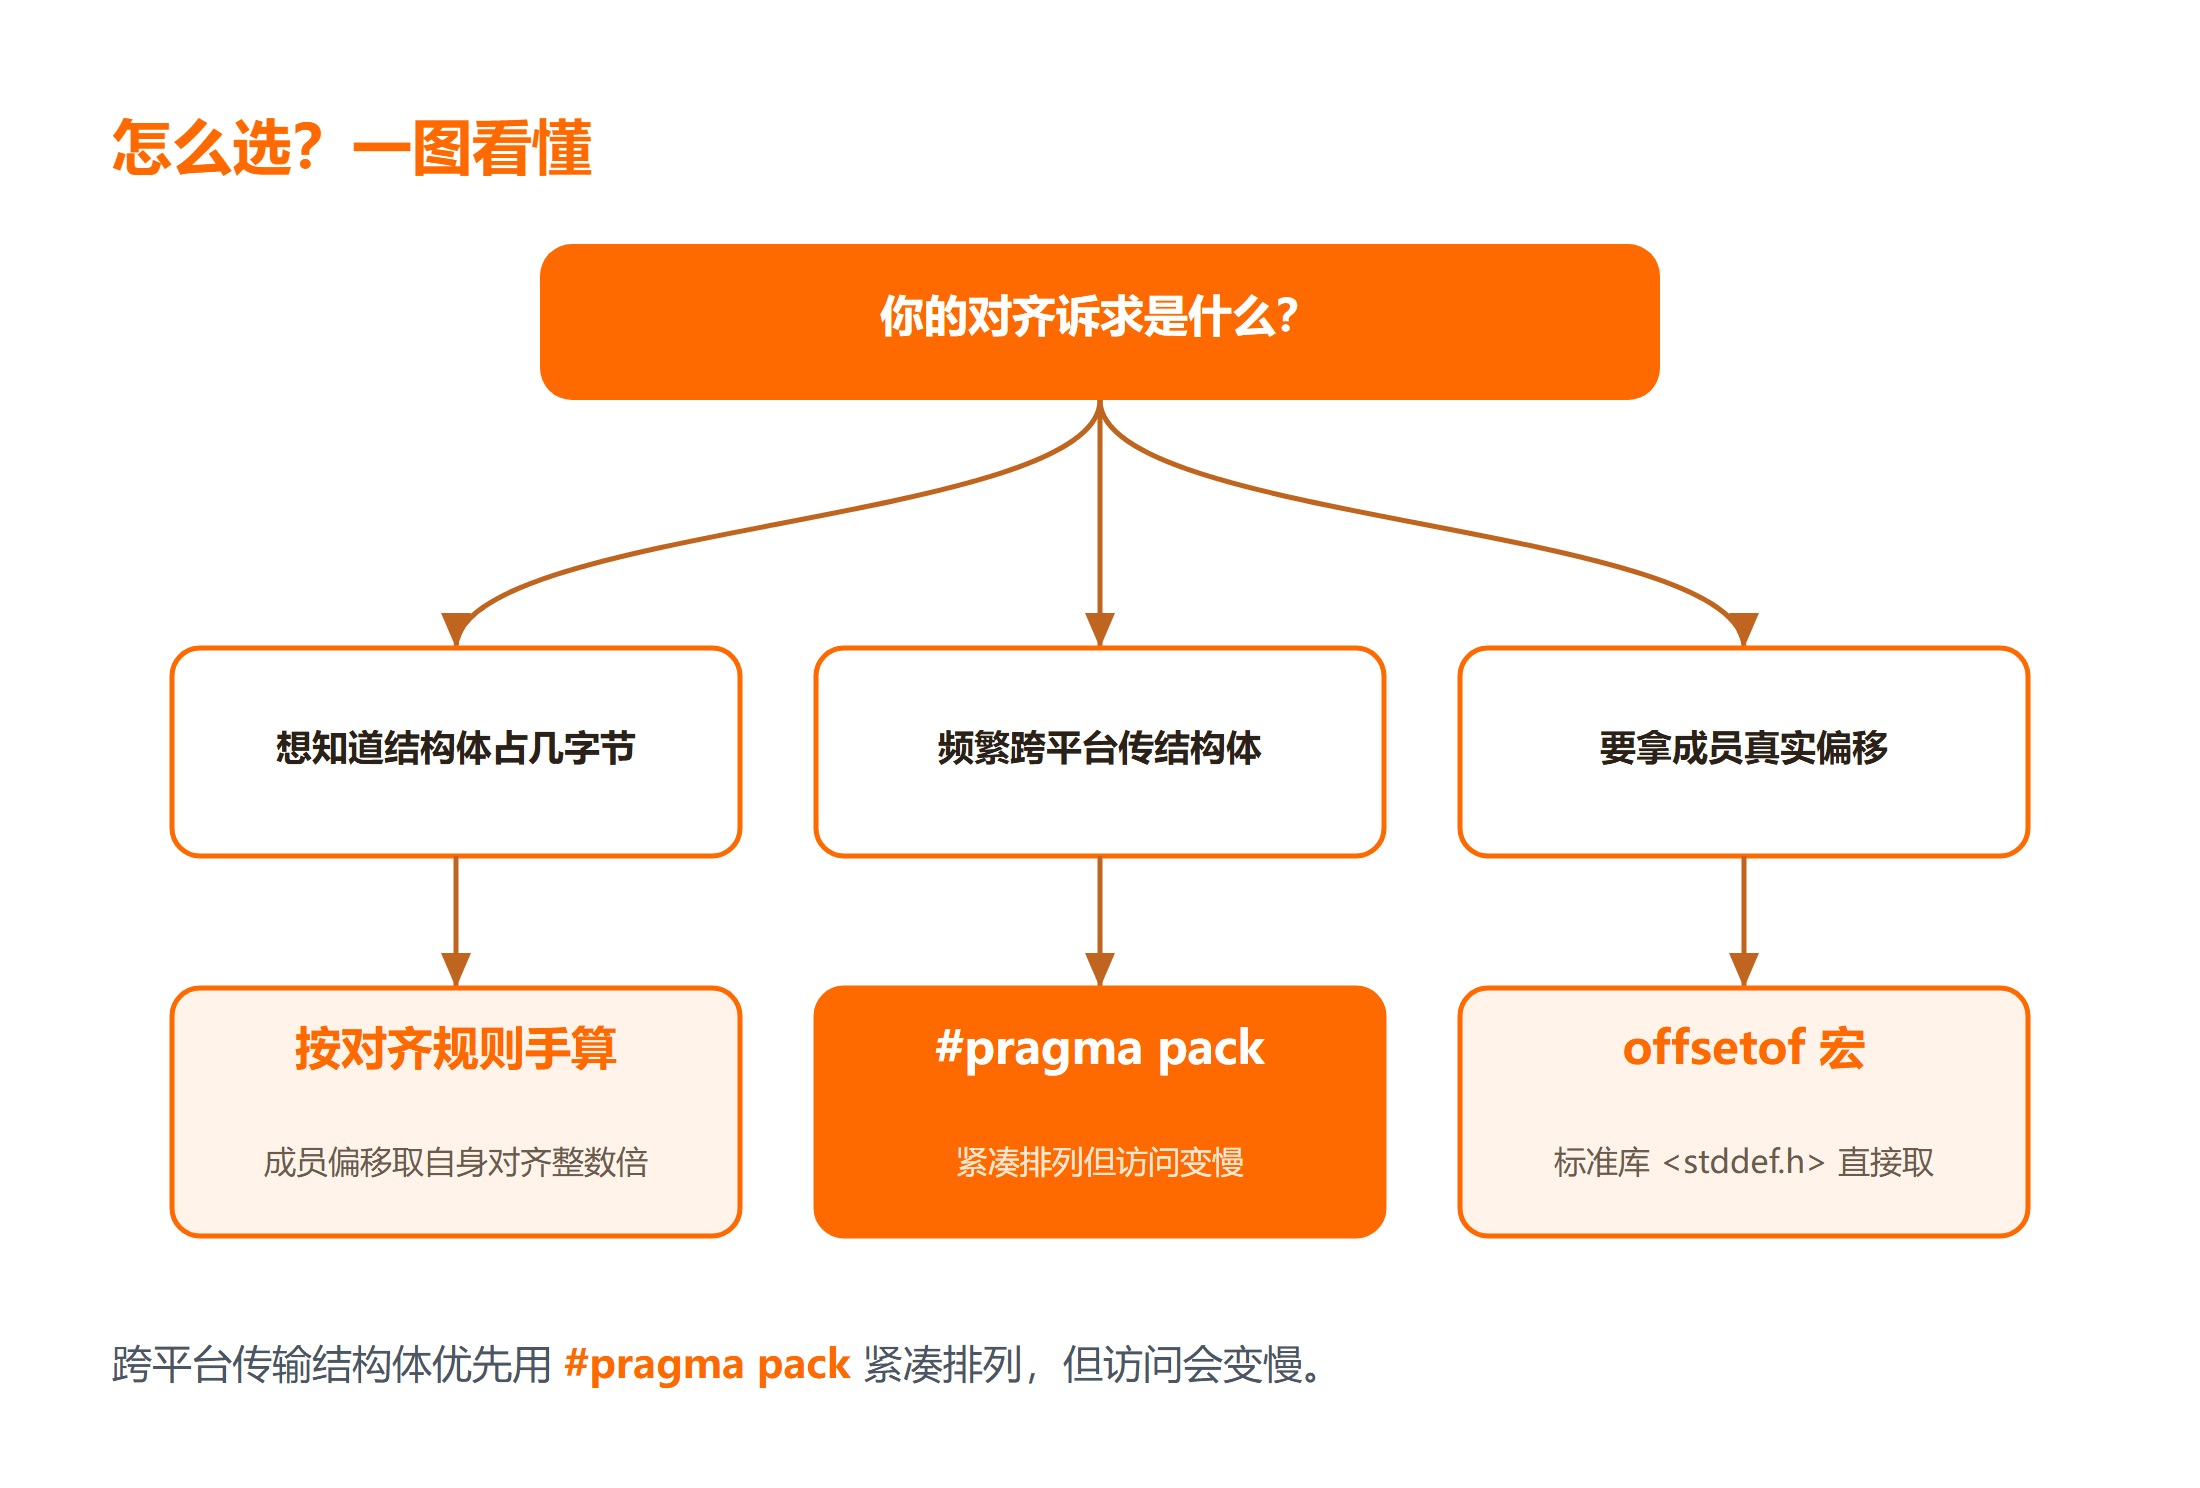
实际写代码时,绝大多数情况你都不用手算这些——编译器已经替你排好了字段位置。但理解对齐规则仍有两点实在的好处:一是能预估结构体占多大内存,在写序列化、网络协议封装、以及和硬件寄存器做内存映射时,心里有数就不会错位;二是能排查一类很诡异的 bug,比如同一份结构体在 32 位和 64 位编译下 sizeof 结果不一样,往往就是默认对齐值不同在作怪。C 语言还提供了一个 offsetof 宏,可以让你直接打印某个成员相对结构体开头的字节偏移,写一个 printf("%zu", offsetof(struct Demo, b)) 就能验证我们上面手算的结果,比肉眼数字段靠谱得多。
三、最小示例:亲手算一个结构体的大小
#include <stdio.h>

// 演示结构体:char 占 1 字节,int 占 4 字节
struct Demo {
    char a;   // 偏移 0,占 1 字节
    int  b;   // 必须对齐到 4,落在偏移 4,占 4 字节(中间空 1~3 共 3 字节)
    char c;   // 偏移 8,占 1 字节
};

int main() {
    // 打印结构体大小;预期输出 12(不是 1+4+1=6)
    printf("sizeof = %zu\n", sizeof(struct Demo));
    return 0;
}
上面这段做了什么:char a 从地址 0 开始;int b 的对齐值是 4,所以它不能接着放在偏移 1,而要跳到偏移 4,中间 1、2、3 三个字节被白白空着;char c 放在偏移 8。此时已用到 0~8 共 9 字节,但最大对齐值是 4,9 不是 4 的倍数,于是补到 12。所以最终 sizeof 是 12。建议先过一遍 C 语言教程 的基础章节,理解类型大小再来算会更顺。
四、三个对齐规则一次讲清
第一,char 对齐到 1:char 只有 1 字节,可以放在任何地址,从不留空。
第二,short 对齐到 2、int/long/float 对齐到 4、double 对齐到 8(在常见 64 位环境下)。一个 double 成员会把后面的字段推到 8 的倍数位置。
第三,结构体嵌套时,子结构体的对齐值取它自己的最大成员对齐值,而不是 1。也就是说,结构体套结构体,内部该对齐还是对齐,不能因为被包起来就压缩。
把规则落到具体数字上更直观。假设一个结构体是 struct S { char a; int b; short c; },按默认对齐走一遍:a 落在偏移 0(占 1,补到 4);b 对齐到 4 落在偏移 4(占 4,到 8);c 对齐到 2 落在偏移 8(占 2,到 10);末尾补齐到最大对齐值 4 的整数倍,10 不是 4 的倍数,补到 12。所以 sizeof(S) 是 12,而不是 1+4+2=7。如果把顺序调成 char a; short c; int b;,偏移就变成 a@0、c@2、b@4,末尾到 8,sizeof 直接降到 8——这就是重排字段省内存的真实效果。
下面把规则落实成一张表,方便你对着算:
| 成员类型 | 自身大小 | 对齐值 | 常见偏移落点 |
|---|---|---|---|
| char | 1 | 1 | 任意 |
| short | 2 | 2 | 偶数地址 |
| int / float | 4 | 4 | 4 的倍数 |
| double / long | 8 | 8 | 8 的倍数 |
五、两个最容易踩的坑
| 现象 | 原因 | 修复 |
|---|---|---|
| 改了几个字段顺序,sizeof 变了 | 字段顺序改变留白多少,体积跟着变 | 把相同/小类型字段放一起,大类型靠后 |
| 网络传结构体收到乱码 | 发送端 pack(1)、接收端默认对齐,两端布局不一致 | 双方统一用 #pragma pack(1),或改用手动序列化字段 |
第一个坑最典型:把两个 char 夹在一个 int 两侧,会比把它们放一起多耗好几个C 语言结构体。重排一下就能省。第二个坑发生在跨平台、跨语言传二进制时,一方压成 1 字节对齐,另一方按默认对齐读,字段全错位。这种场景别偷懒,老老实实把每个字段单独读写,而不是整个结构体 memcpy 过去。
还有一类更隐蔽的坑:把结构体直接 memcpy 到文件或网络,再在另一台机器读回来。不同编译器、不同架构的对齐策略可能不同,对方按自己的默认对齐去解析,字段就会整体错位,轻则数据错乱,重则程序直接崩溃。跨平台场景的正确做法是用 #pragma pack(1) 显式约定“一个字节都不要补”,或者干脆把每个字段单独按固定格式读写,完全不依赖结构体内存布局。
实操时建议先配置好编译环境,用 offsetof 验证成员偏移,再把示例运行起来检查 sizeof 是否符合预期;若发现结构体大小异常,按对齐规则排查失败原因并修复。边界上要注意跨平台字节序与 #pragma pack 的适用场景,性能敏感处优先按对齐补齐而非紧凑压缩。下面结论根据官方文档与常见编译器行为整理,未在本机逐平台执行。
总结
要点带走:
- 结构体大小 ≠ 各成员大小之和,内存对齐 会在字段间插入空位;
- 手算三步:逐字段按对齐值定偏移 → 写完补末尾 → 整体补齐到最大对齐值的整数倍;
- 想省体积就重排字段,想跨平台传二进制就显式约定对齐方式,别依赖编译器默认值。
下一步建议系统学一遍 C 语言教程,把指针和结构体结合起来看,对齐规则会理解得更透。
延伸学习
想把这块知识系统补齐,可以按这个顺序来:
Q:为什么结构体大小不是成员大小直接相加?
A:因为编译器会在成员之间插入空位做对齐,让每个成员落在合适地址,CPU 读起来更快。末尾还会补齐,所以 sizeof 往往比“加起来”要大。
Q:怎么让结构体尽可能小?
A:把相同类型、特别是小类型(char、short)的字段挨在一起放,大类型(double、long)往后靠,能减少留白。必要时用 #pragma pack(1),但要接受访问速度下降。
Q:pack(1) 之后会有什么问题?
A:字段不再留空,体积变小,但某些架构上未对齐访问会变慢甚至报错。它只适合网络协议、文件格式这类需要固定布局的场景,普通本地使用不推荐。



