
 TRAE-AI编程

你在 TRAE 里打开一个稍大的项目,问 AI「这个登录校验函数在哪、改了会不会影响注册流程」,它却答非所问,十有八九是代码索引构建还没做好。先给结论:trae代码索引构建的本质,是把整个仓库的符号、依赖和调用关系预先解析成可检索结构,让 AI 从「只看当前文件」升级为「读懂整个项目」;而代码索引构建的成败,取决于你打开项目的方式、排除规则是否合理、以及有没有耐心等它跑完第一次全量扫描。本文基于 TRAE IDE 的通用工作流整理,覆盖最稳的构建步骤、两种替代做法、失败分支与验证方法,并附上动手核对清单。看完你能自己判断索引是否就绪,也能在「答非所问」「索引卡住不动」这类问题上快速定位,少走弯路。
先看结论
构建代码索引前,先把三件事记牢,能省掉大半排查时间。
第一,索引是以工作区为单位的。TRAE 只对你用「打开文件夹」方式载入的项目根目录建索引,单独打开一个零散文件不会触发全量索引。所以第一步永远是确认项目文件夹正确载入,而不是急着问 AI。想先了解整体工作方式,可过一遍 TRAE 编程中文教程 的工作区章节。
第二,第一次是全量,之后是增量。首次打开项目会扫描全部源码并建立符号与语义索引,这一步耗时最长;后续改动通常只增量更新改动文件。很多人以为「索引很慢」是bug,其实是没等第一次全量扫描跑完就开始提问。
第三,索引是否就绪要看状态,不看感觉。右下角或设置里的索引状态从「正在索引」变为完成,才是可以放心提问的信号。只看「界面打开了」并不算数——索引没就绪时,AI 只能看到当前文件的上下文,跨文件的调用关系一概不知。
一、先搞清楚代码索引构建在做什么
用一句判断句给出定义:TRAE 的代码索引构建,是编辑器在后台把项目里的函数、类、变量、import 依赖和调用关系预先解析出来,存成一份可快速检索的结构。
打个比方,没有索引就像在一栋没有门牌号的楼里找人,只能挨家敲门;有了索引就像前台有一本住户名册,报个名字就能定位到房间和相邻住户。AI 回答跨文件问题时依赖的正是这本「名册」。
1.1 触发条件
索引构建在几种情况下发生:首次用「打开文件夹」载入项目、切换到新的工作区、大批文件新增或删除之后、以及手动触发重建。索引范围默认跟随工作区根目录,并受排除规则影响。这里没有固定的版本号门槛,但不同 TRAE 版本的状态入口位置略有差异,路径以你实际使用的版本为准。
⚠️ 注意:不要把包含
node_modules、.git、构建产物目录的大项目整个丢进去索引。这些目录文件数量极大且几乎不含你自己的业务逻辑,会拖慢扫描、占满磁盘,还容易让 AI 检索到一堆重复符号。
1.2 常见误解
最常见的误解是「我把文件在编辑器里打开了,AI 自然就懂整个项目」。事实上,打开单个文件不等于建立工作区索引。另一个误解是把索引当成搜索引擎——它不是简单的关键字匹配,而是带有符号与依赖关系的语义结构,所以问「谁调用了这个方法」这类问题才有意义。
二、最稳的构建步骤
前置条件确认后,按下面的顺序操作,成功率最高。
- 用「文件 → 打开文件夹」载入项目根目录,确保载入的是包含源码的顶层目录,而不是某个子目录;
- 打开设置,确认代码索引相关选项处于开启状态;
- 配好排除规则,把依赖目录和构建产物排除在外;
- 等待状态栏的索引任务跑到完成,期间尽量避免大规模改动文件;
- 用一次跨文件提问验证索引是否真的生效。
排除规则是这一步的关键。在项目根目录建一份忽略配置,把无关目录列进去:
node_modules/
dist/
build/
.git/
*.min.js
上面这份配置告诉索引器跳过依赖与构建产物。执行后你应该看到索引扫描的文件数明显下降、完成速度变快。举个实际场景:用 TRAE AI 开发一个 Python Django 后台管理系统时,项目原本要扫三万多个文件,排除 node_modules 和虚拟环境后往往只剩几百个业务文件,首次全量索引从十几分钟缩短到一两分钟。
如果项目用的是 Python,也可以按同样思路排除虚拟环境和缓存目录:
.venv/
__pycache__/
*.pyc
关于性能取舍:排除得越彻底,索引越快,但过度排除会让 AI 看不到必要的依赖声明。原则是排除「第三方生成的、不修改的」目录,保留「自己写的、要改动」的源码。
三、两种替代做法与取舍
除了随项目自动建索引,还有两种做法适用于不同场景。
| 做法 | 适合场景 | 优点 | 代价 |
|---|---|---|---|
| 打开文件夹自动建索引 | 日常主力开发 | 一次配置、持续增量更新 | 首次全量扫描较慢 |
| 手动重建索引 | 索引结果明显错乱、改过排除规则后 | 强制刷新,纠正陈旧结构 | 重建期间 CI 与问答会短暂变慢 |
| 缩小工作区范围 | 超大 monorepo 只改其中一个模块 | 索引快、检索干扰少 | 看不到模块外的代码 |
手动重建通常在命令面板里搜索索引相关的「重建」命令触发;若现象超出本文范围,可对照 TRAE 问题排查 里的「索引未生效、配置未加载」条目继续查。
从取舍看,多数人只需要第一种。手动重建是「纠错手段」,不是日常操作;缩小工作区适合巨型仓库,但代价是跨模块的问题答不了。
四、常见失败分支与适用边界
把最容易踩的坑逐个拆开说。
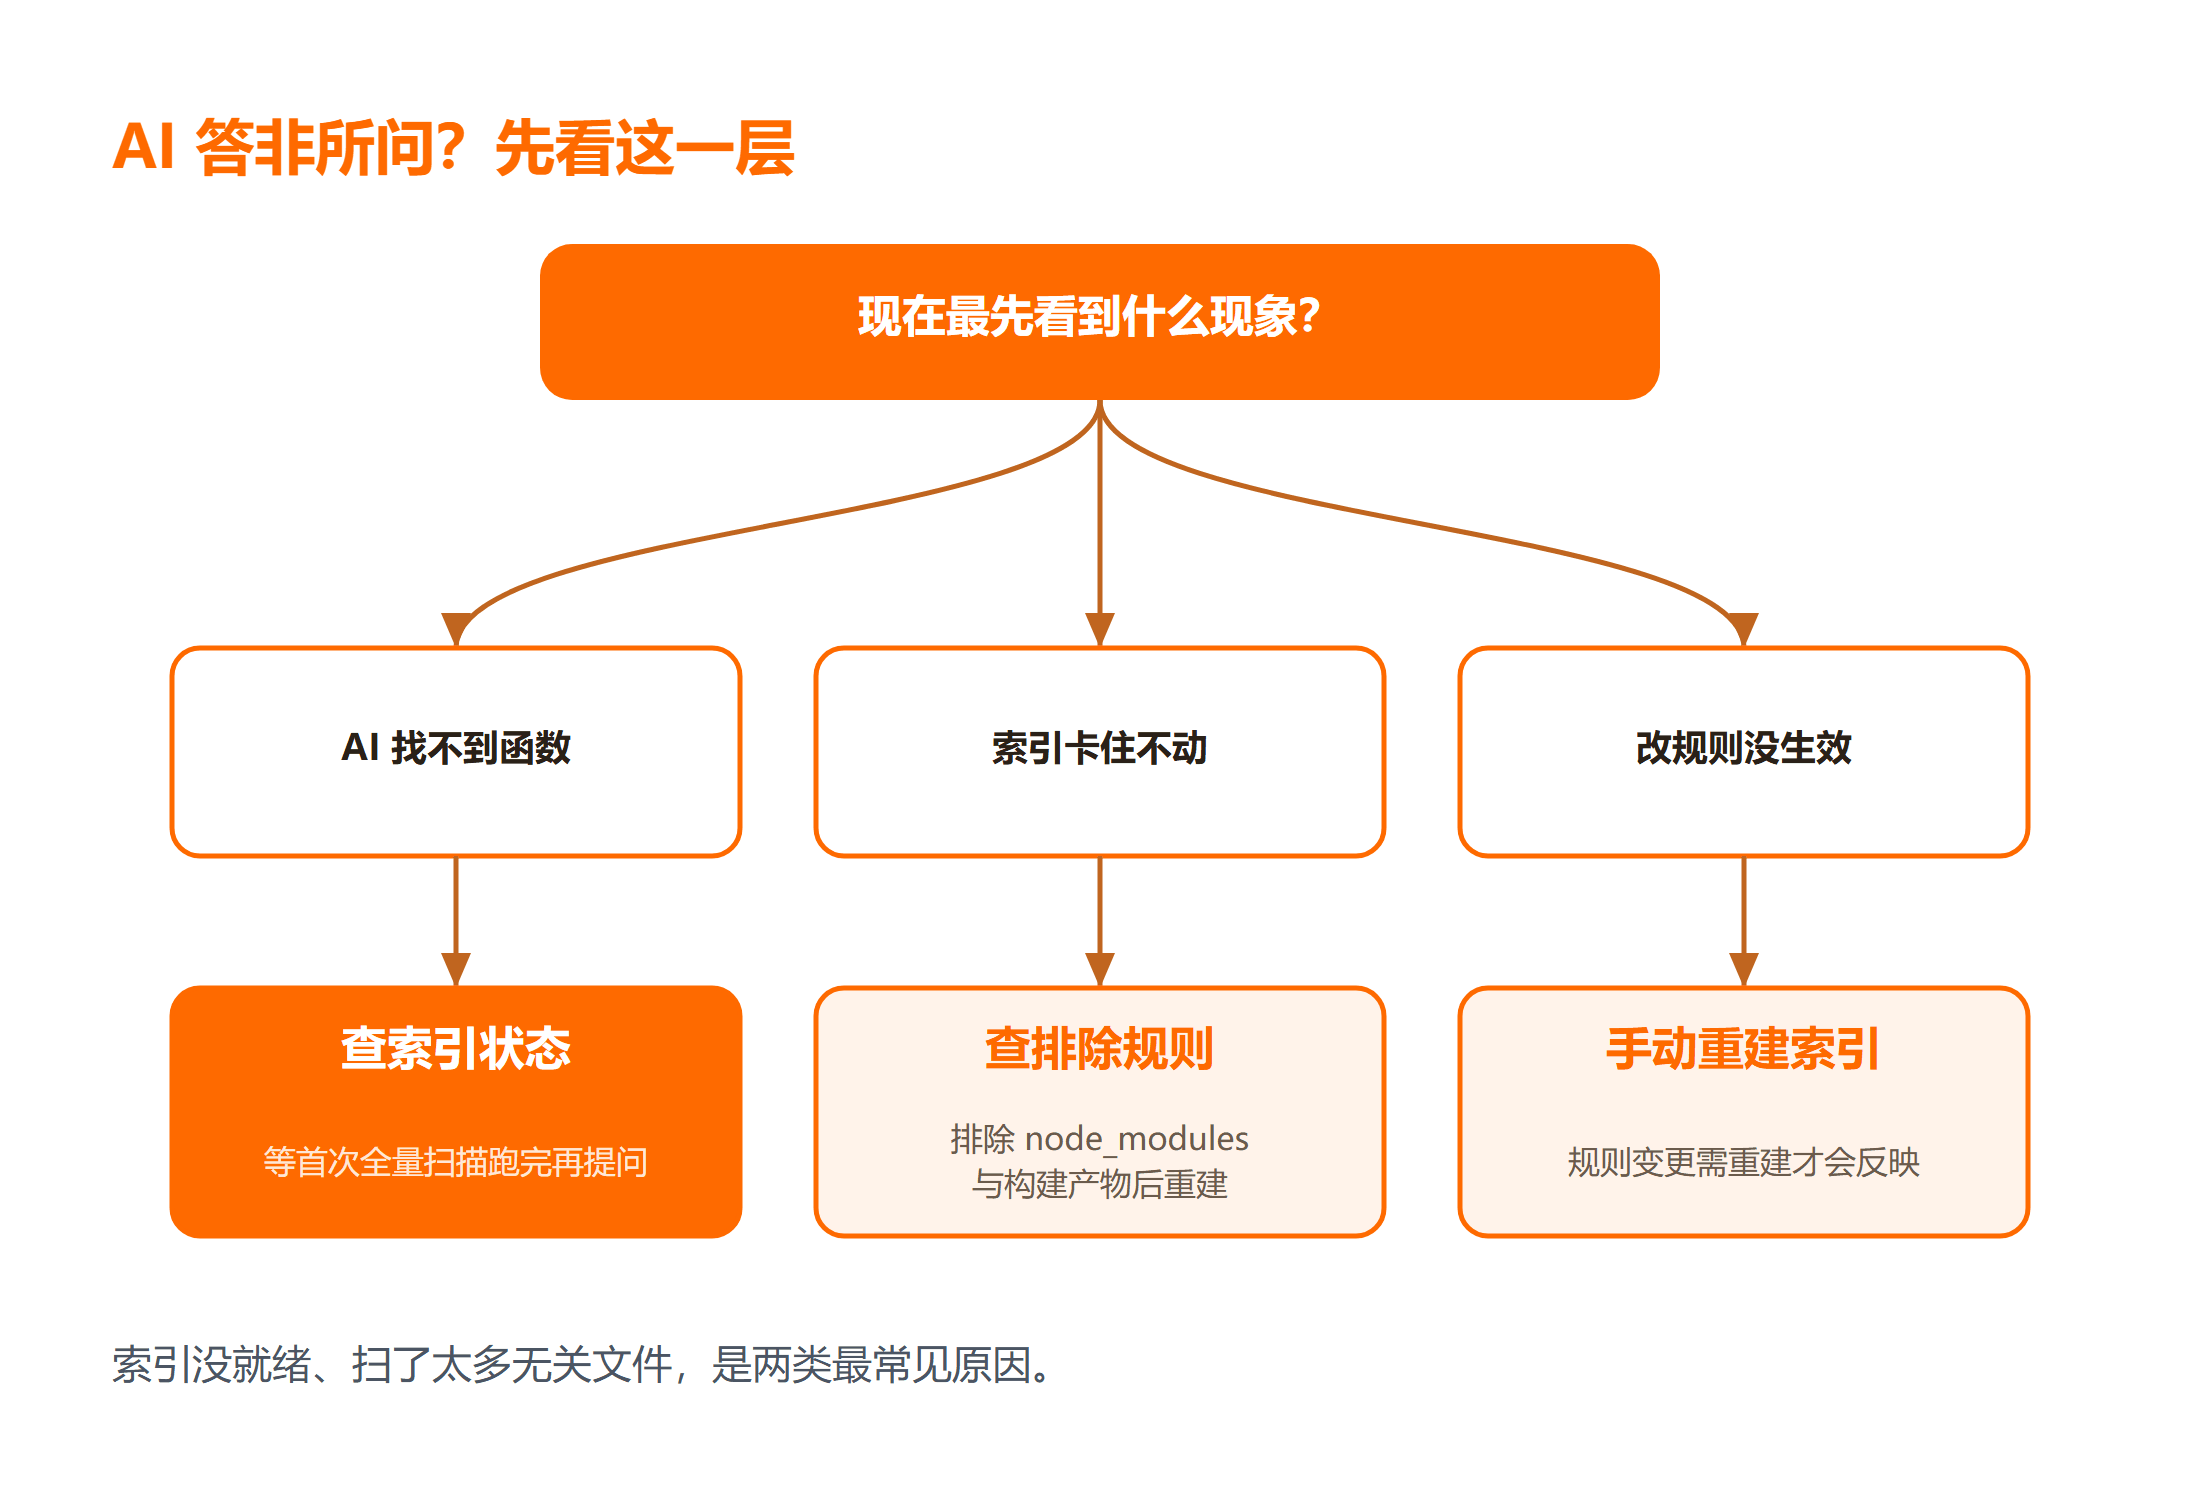
- AI 答非所问、说找不到函数:先确认索引状态是否完成。未完成就等它跑完;已完成仍答不出,检查是不是只打开了单个文件而非整个文件夹。
- 索引长期卡在某个百分比:多半是扫描了过多无关文件。按第二节配好排除规则后手动重建一次,通常立刻缓解。
- 改了排除规则没生效:排除规则变更后一般需要重建索引才会反映到检索结果里,光改文件不重建等于没改。
- 磁盘占用暴涨:索引数据存储在本机缓存目录,超大项目会占几个 GB;确认排除规则生效,必要时清理旧工作区缓存。
- 适用边界:本文步骤基于 TRAE IDE 的通用工作流整理,标为编辑推断;不同版本菜单文案与状态入口位置可能略有差异,以你使用的版本为准,本文讨论的是索引配置思路,未在特定版本本机逐项实测。
动手核对清单
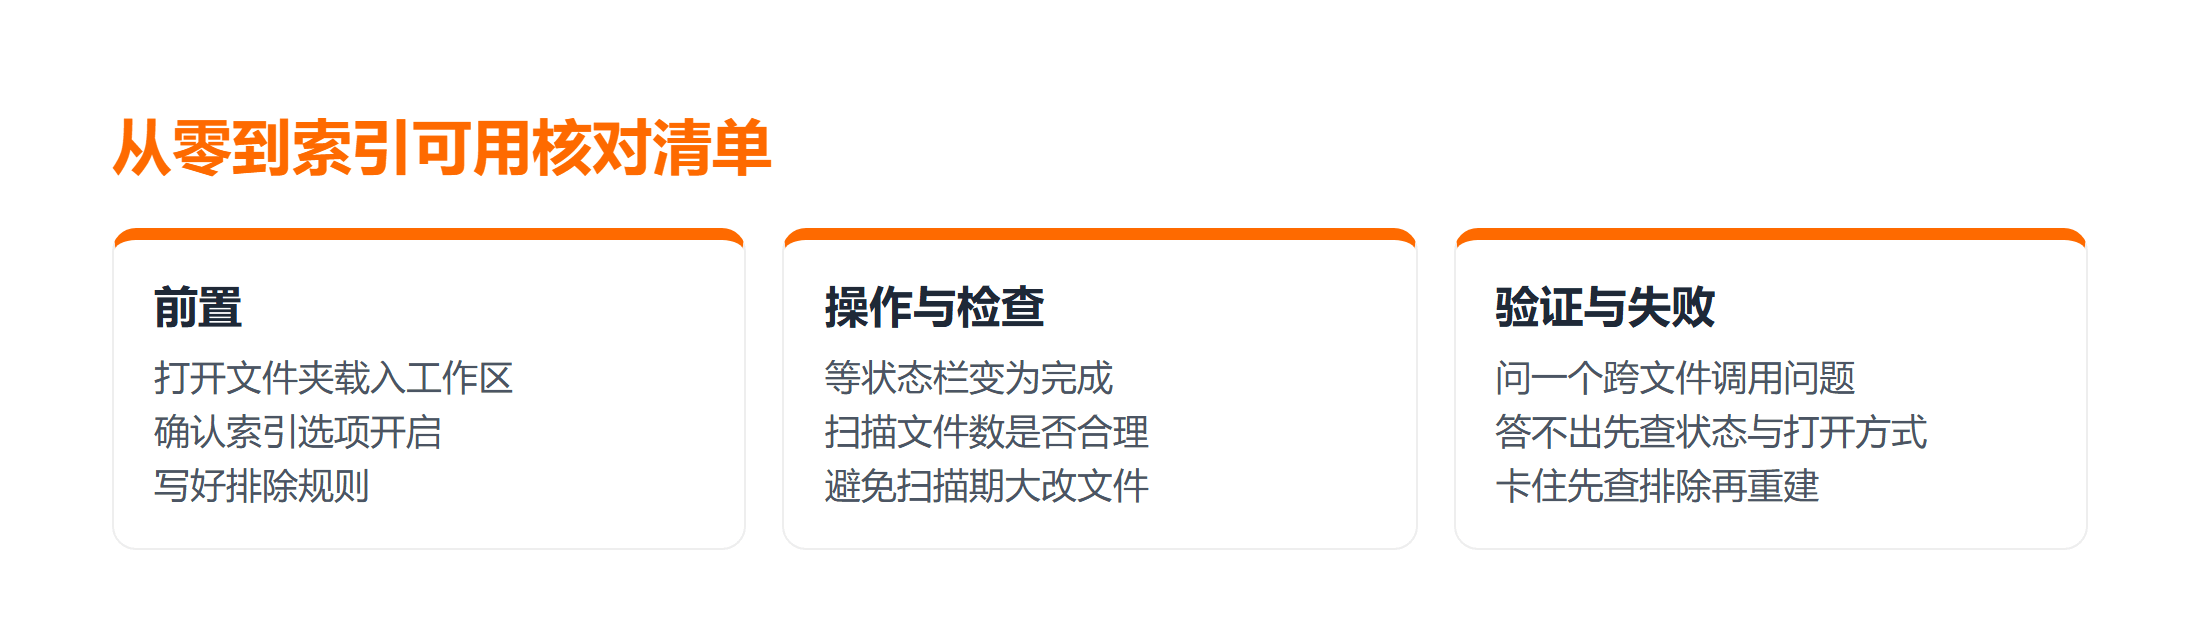
按顺序做一遍,从零到索引可用:
- 前置:用「打开文件夹」载入项目根目录,确认是含源码的顶层目录;
- 操作:开启代码索引选项,按项目语言写好排除规则;
- 检查:观察索引状态是否从「正在索引」变为完成,扫描文件数是否合理;
- 验证:问一个跨文件问题(如「谁调用了某方法」),看 AI 能否给出正确文件与行号;
- 失败处理:答不出先查状态与打开方式,卡住先查排除规则再重建,不重复新建工作区。
总结
trae代码索引构建,关键在于三点:用打开文件夹的方式载入工作区、用排除规则控制扫描范围、用状态栏和跨文件提问双重验证。索引没就绪或扫了太多无关文件,是绝大多数「AI 答非所问」的真正原因。
要点带走:
- 索引以工作区为单位,单开文件不会触发全量索引;
- 首次全量、后续增量,先等扫描跑完再提问;
- 排除
node_modules、.git与构建产物,能大幅提速; - 改过排除规则要手动重建,才能反映到检索结果里。
索引就绪后,AI 才能读懂跨文件的调用关系,给出的修改建议才靠得住。
常见问题
Q:TRAE 的代码索引一定要手动开启吗?
A:通常打开工作区后会自动开始构建,无需手动干预。需要手动介入的场景主要是两类:一是索引结果明显错乱时手动重建,二是改过排除规则后让新规则生效。日常开发把这两件事交给默认行为即可。
Q:为什么同样的项目,同事的索引比我快很多?
A:常见原因是排除规则不同。如果对方排除了依赖目录和构建产物,扫描文件数可能比你少一个数量级,速度自然快得多。先对比双方扫描的文件数,再检查各自的排除配置。
Q:索引和「全局搜索」有什么区别,我还要用搜索吗?
A:索引带符号与依赖关系,适合回答「谁调用了这个函数」这类结构性问题;全局搜索是字面匹配,适合精确找某段文本。两者互补:定位调用链用索引辅助提问,找具体字符串仍可用搜索。
延伸学习
想系统补齐 AI 编程与代码库理解的知识,可以按这个顺序来:
- 想用 TRAE 系统做一个完整项目,可以看 TRAE AI 开发 Python Django 后台管理系统;
- 对照实际配置案例查漏补缺,翻 C++ 智能指针(附 3 种做法),手把手教你含完整示例与避坑;
- 需要批量整理配置文件格式时,用 Python代码格式化 辅助检查。



