 免费 AI IDE

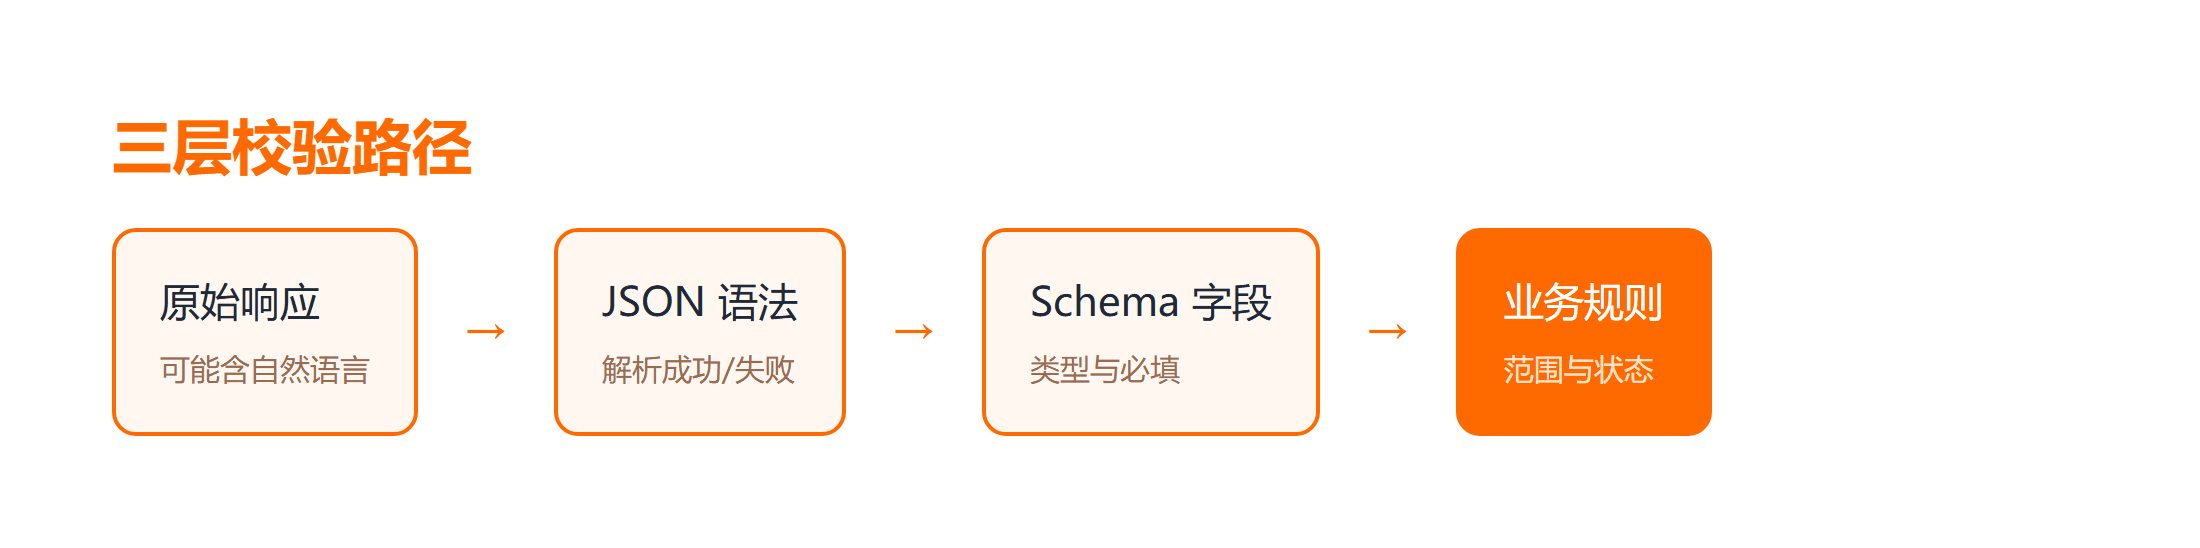
AI 返回的 JSON 解析失败时,先区分响应不是合法 JSON、字段不符合 Schema,还是业务值越界。把这三层拆开,才能知道应该修提示词、修解析器,还是拒绝业务数据。本文用订单摘要作为例子,模拟正常、缺字段、类型错误和截断响应,给出可重复运行的校验流程。示例不依赖特定厂商 API,真实 API 的拒答、限流和网络失败仍需单独记录。 为了便于复现,文中会把JSON 解析失败、结构化输出、JSON Schema分别落到输入、判断和输出三个位置,并用边界样例说明何时应该接受、拒绝或继续排查;同时明确讨论字段校验与类型检查。
一、先把解析失败分成三层
JSON 解析失败是一个现象,不是一个原因。响应前后多了一段说明文字时,json.loads 会在第一个字符就报错;JSON 合法但缺少 order_id 时,语法解析会通过,字段校验仍应失败;金额为负数时,字段类型正确,业务规则却不接受。先打印响应类型、长度和前后几十个字符,避免把完整令牌写入日志。
如果需要补齐基础概念,可先阅读JSON 数据格式教程,再回到下面的示例核对结果。
import json
raw = '{"order_id":"A-17","amount":1299}'
data = json.loads(raw)
print(data["order_id"], data["amount"])
JSON 解析失败是一个现象,不是一个原因。
二、用结构化约束减少格式漂移
结构化输出的目标是让模型按约定返回对象,但约束不能替代程序验证。Schema可以声明字段、类型和是否允许额外属性;它不能替你决定金额上限、订单状态是否允许退款。接口边界应把模型文本当作不可信输入,先限制最大响应长度,再解析和校验。对于支持原生结构化输出的接口,记录所用Schema版本,避免提示词和程序各维护一套规则。
SCHEMA = {"type":"object","required":["order_id","amount"],"additionalProperties":False,"properties":{"order_id":{"type":"string"},"amount":{"type":"integer","minimum":0}}}
print(SCHEMA["required"])
结构化输出的目标是让模型按约定返回对象,但约束不能替代程序验证。Schema版本与代码版本一起记录,修改字段时先更新样例和测试。
三、字段校验要拒绝隐式转换
把字符串“1299”自动转成整数看起来方便,却会把空字符串、科学计数法和小数截断问题藏起来。入口处先判断类型,再按明确规则转换;金额使用整数分,避免浮点数在比较和序列化时产生歧义。必填字段缺失时给出字段名,类型错误时保留收到的类型,不回显敏感值。
如果需要补齐基础概念,可先阅读Python3 教程,再回到下面的示例核对结果。
def validate_order(data):
    if not isinstance(data, dict): raise ValueError("结果必须是对象")
    if not isinstance(data.get("order_id"), str) or not data["order_id"].strip(): raise ValueError("order_id 无效")
    if type(data.get("amount")) is not int or data["amount"] < 0: raise ValueError("amount 必须是非负整数")
    return data
把字符串“1299”自动转成整数看起来方便,却会把空字符串、科学计数法和小数截断问题藏起来。严格使用 type(value) is int 可排除 True 被当作1的情况。
四、业务规则和模型拒答要分开
模型拒答、限流和网络超时都不是“字段校验失败”。前者表示没有得到可用结果,后者表示得到了结果但不符合业务。建议返回带状态的内部对象,例如 transport_error、parse_error、schema_error 和 accepted,监控按状态计数。重试只针对短暂网络错误,不要对业务拒绝无限重试。
def classify(raw):
    try: data=json.loads(raw)
    except json.JSONDecodeError: return "parse_error"
    try: validate_order(data)
    except ValueError: return "schema_error"
    return "accepted"
模型拒答、限流和网络超时都不是“字段校验失败”。把错误分类写进测试名称,日后看到指标上升才能定位层级。
五、边界测试与排错记录
准备五条输入:合法对象、缺少 amount、amount 为字符串、amount 为负数、末尾被截断的 JSON。对每条输入断言状态分别为 accepted、schema_error、schema_error、schema_error、parse_error。再加入一条模型返回“我无法处理”的文本,确认它不会被当成字段错误。测试通过后,把同一组样例交给真实 API 或离线响应回放,比较原始响应和解析状态。
在“AI 返回的 JSON 总解析失败?从格式约束到字段校验排查”这个问题上,把测试结果按“输入、实际输出、预期输出、结论”记录下来;出现失败时保留原始错误和运行环境,不要只截取最后一行。模型输出和知识库文档都属于外部输入,先保存原始响应与版本,再判断程序是否给出了可追溯的结果。
常见误区与选择建议
不要用正则从自然语言里截 JSON;不要把一次成功解析当成Schema长期兼容;不要在异常日志中打印完整响应和密钥;不要为了让流程继续而给缺失字段填默认金额。需要兼容旧字段时,显式写版本迁移函数并保留旧样例。
落地检查清单
- 为JSON 解析失败准备一份最小正常输入和一份已知失败输入,先固定环境再比较结果。
- 检查结构化输出的边界,明确哪些情况应接受、拒绝或继续排查。
- 记录JSON Schema的判断依据,避免错误被默认值、静默重试或格式化输出掩盖。
- 回归时一次只改一个变量,并把失败样例保留在测试目录。
- 交接时写明版本、命令、输入、输出和已知限制,让下一位维护者能复现结论。
- 对照正常输出与失败输出,确认错误信息能指出具体字段、路径、版本或状态,而不是只返回“失败”。
- 若规则发生变化,先更新样例和预期结果,再修改实现,避免测试通过但验收标准已经悄悄改变。
- 最后记录哪些情况尚未覆盖,把它们列为待确认项,不用默认值替代未知结论。
动手练习
- 先运行正文中的正常样例,保存完整输出。
- 只改变JSON 解析失败相关的一个输入,确认失败位置符合预期。
- 再改变结构化输出,比较错误信息是否仍然可定位。
- 关闭一项校验或配置,确认测试能够主动失败。
- 恢复配置并重跑,检查结果是否回到基线。
- 把一次失败记录整理成可交接的复现步骤。
- 将尚未覆盖的边界加入下一轮回归清单。
结果怎么判读
- 输出符合预期且日志完整:记录为通过,并保留输入样例。
- 输出不符合预期但错误位置清楚:记录为可修复失败,先定位规则。
- 输出看似成功但缺少关键字段:不能放行,补充边界校验。
- 同一输入在不同环境结果不同:先比较版本、配置和依赖。
- 修改后正常样例通过、失败样例消失:优先检查错误是否被吞掉。
- 只有把JSON 解析失败、结构化输出和JSON Schema的证据一起保存,结论才适合交接。
总结
把AI输出当作外部输入,按传输、语法、结构和业务四层验收。JSON 解析失败的修复方向取决于失败层级:格式约束解决生成形状,Schema解决字段结构,业务校验解决真实规则。
延伸学习
- JSON 解析失败基础:AI 文档教程
- AI 数据分析课程
- AI 语音客服实战笔记
常见问题
Q:JSON 合法就可以直接入库吗?
A:不可以。还要检查字段类型、必填项、业务范围和权限,必要时再做数据库约束。
Q:为什么不建议自动补全缺失字段?
A:因为补全会把模型的不确定性变成看似正常的数据,除非业务明确规定默认值且可追溯。