 免费 AI IDE

知识库问答的引用不能只看有没有编号,还要确认编号指向的片段真的支持答案。最小检查方法是准备三组样本:原文明确支持、检索到旧版本、文档没有答案。本文用两份带版本号的本地文档演示检索片段、答案句子和引用位置如何逐项核对,并说明无法找到证据时应该怎样返回。 为了便于复现,文中会把知识库问答、引用溯源、检索评估分别落到输入、判断和输出三个位置,并用边界样例说明何时应该接受、拒绝或继续排查;同时明确讨论文档版本与证据片段。
一、把“找到文档”和“支持答案”分开
检索命中只说明关键词相似,不说明答案被原文支持。问题“退款多久到账”可能同时命中旧政策和新政策;如果答案没有携带文档日期,读者无法判断采用了哪一条。评估表至少记录 query、命中文档、片段文本、答案句子和引用编号。
如果需要补齐基础概念,可先阅读AI 人工智能教程,再回到下面的示例核对结果。
documents=[{"id":"refund-v2","date":"2026-09-01","text":"银行卡退款通常在3个工作日内到账。"},{"id":"refund-v1","date":"2026-01-01","text":"银行卡退款通常在7个工作日内到账。"}]
for doc in documents: print(doc["id"], doc["date"])
检索命中只说明关键词相似,不说明答案被原文支持。先固定文档版本,才能解释为什么同一句问题得到不同片段。
二、给证据片段稳定编号
切片时不能只保存一段字符串。应保存文档ID、版本、页码或段落序号和字符范围。文档重新切分后,旧引用编号可能失效,因此索引重建要生成版本号。引用展示给用户的文字可以缩短,但后台必须能回到原始文档。
def evidence(doc_id, version, section, text):
    return {"doc_id":doc_id,"version":version,"section":section,"text":text}
print(evidence("refund","v2","p3","3个工作日"))
切片时不能只保存一段字符串。引用ID要能在日志中回放,不要用每次查询都变化的数组下标。
三、三组样本覆盖真正风险
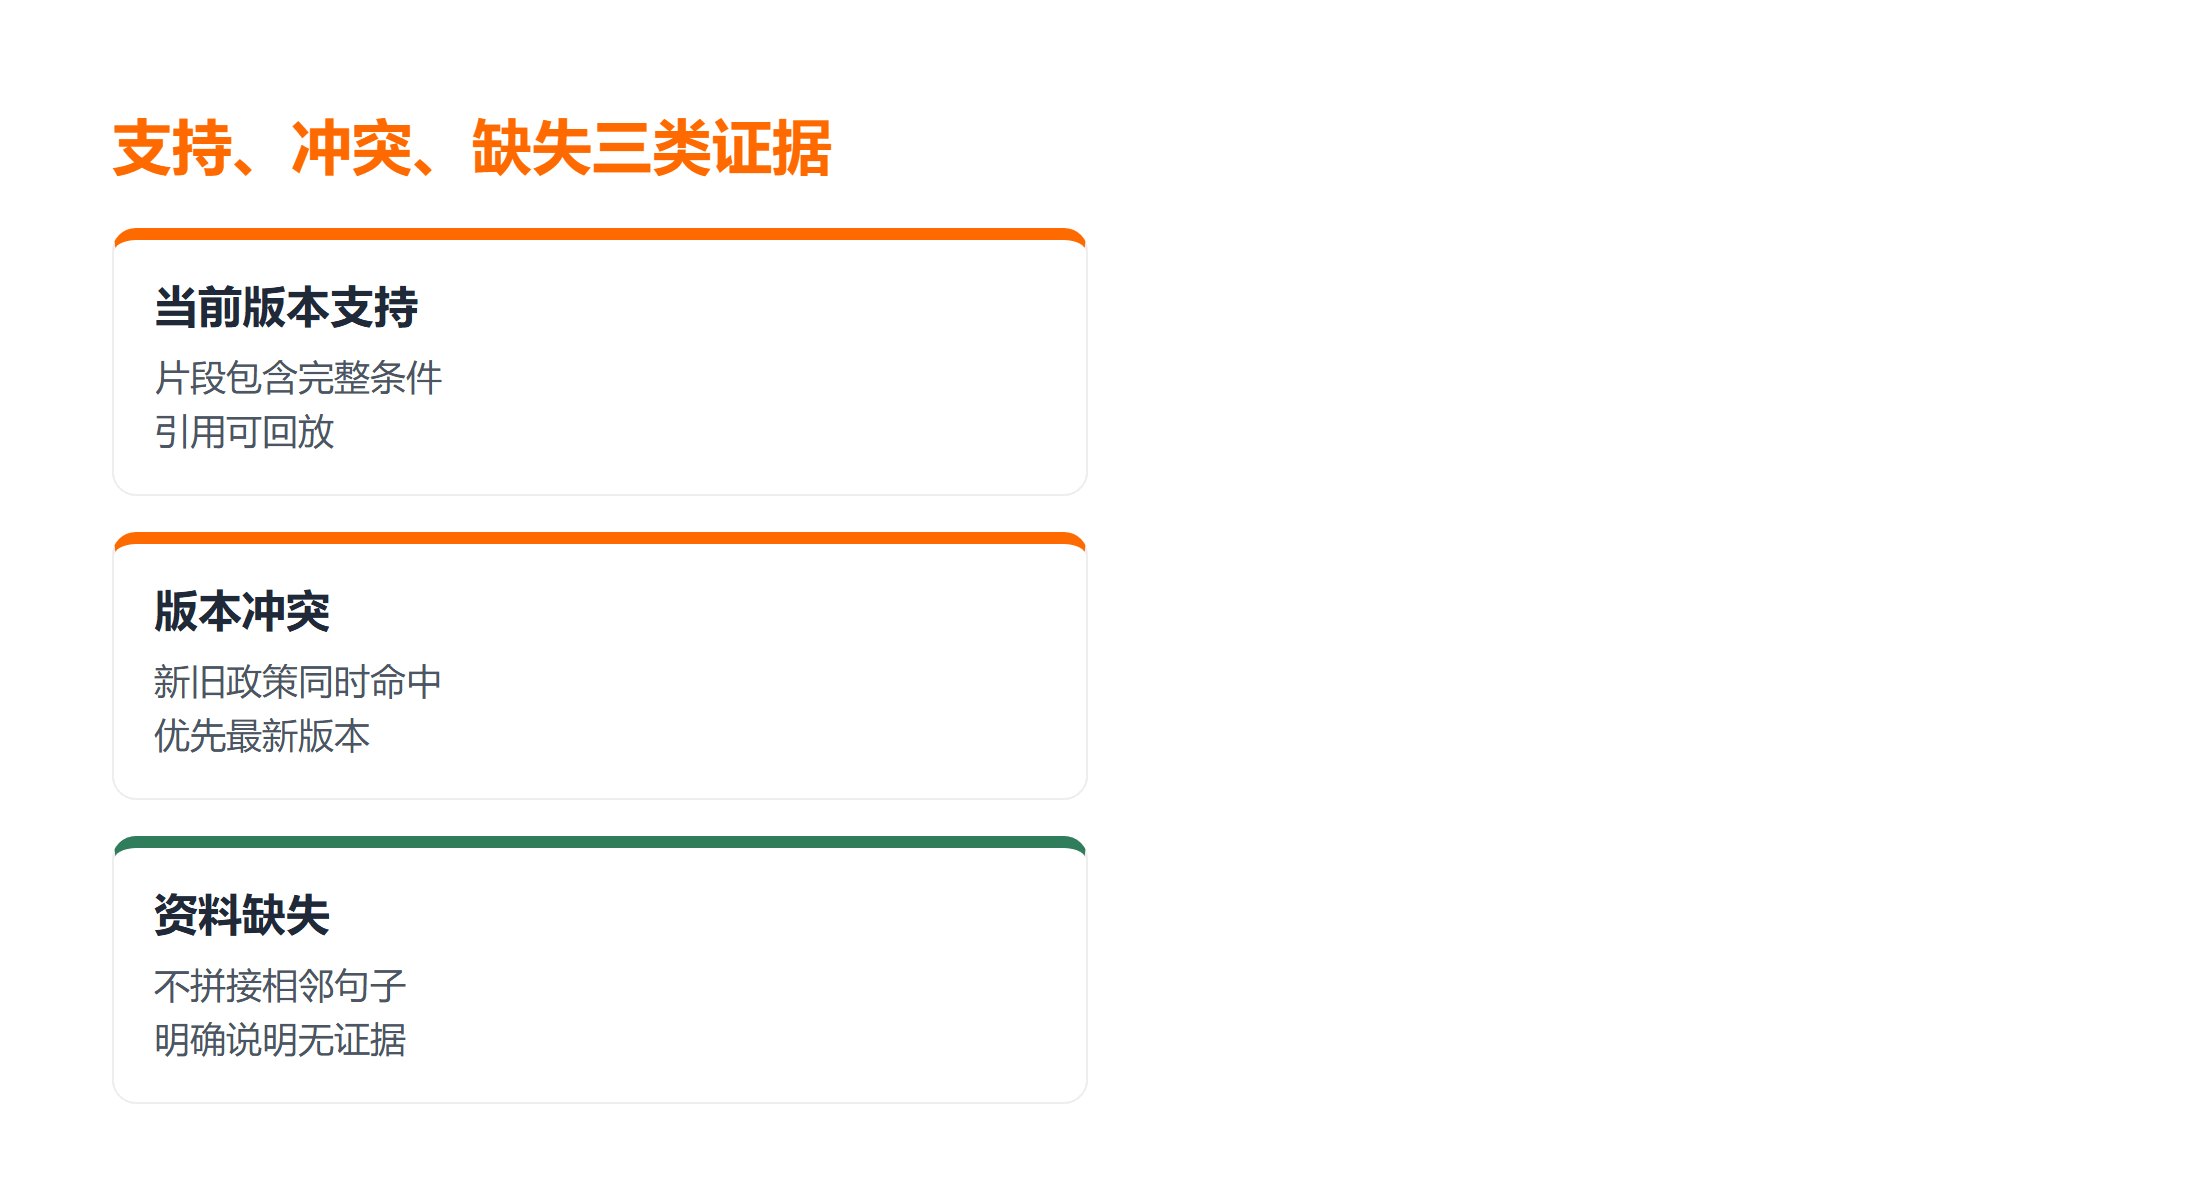
第一组答案由当前文档明确支持,检查引用范围是否包含完整条件;第二组让旧版本与新版本同时命中,检查系统是否优先当前版本;第三组故意询问资料没有覆盖的事实,预期是说明没有足够证据,而不是拼接相邻句子。
如果需要补齐基础概念,可先阅读Python 3 教程,再回到下面的示例核对结果。
cases=[("支持","退款通常在3个工作日内到账"),("冲突","v2优先于v1"),("缺失","资料未说明周末是否计算") ]
for name, expected in cases: print(name, expected)
第一组答案由当前文档明确支持,检查引用范围是否包含完整条件;第二组让旧版本与新版本同时命中,检查系统是否优先当前版本;第三组故意询问资料没有覆盖的事实,预期是说明没有足够证据,而不是拼接相邻句子。把“无证据”作为正常结果测试,避免用空答案率掩盖幻觉。
四、答案和引用一起验收
人工审查时逐句划出答案中的事实,再在片段中标记对应文字。若答案包含片段中没有的时间、范围或因果,就算引用看似存在也应标为不支持。引用显示“依据:文档名、版本、章节”,不要只显示一个神秘编号。
def supported(answer, snippet):
    required=["3个工作日"]
    return all(x in snippet for x in required) and "3个工作日" in answer
print(supported("通常3个工作日到账","银行卡退款通常在3个工作日内到账。"))
人工审查时逐句划出答案中的事实,再在片段中标记对应文字。引用评估关注可核验性,不以模型自评“有依据”为通过条件。
五、边界测试与排错记录
建立三份离线样本并固定版本。样本A包含完整退款期限,预期答案只引用A;样本B同时放入旧版和新版,预期引用新版并展示日期;样本C不包含周末规则,预期返回“资料未说明”。测试记录每个query命中的片段ID、最终引用和支持结论,不能只保存最终答案。
在“知识库问答引用对不上原文?用三组样本检查检索与引用”这个问题上,把测试结果按“输入、实际输出、预期输出、结论”记录下来;出现失败时保留原始错误和运行环境,不要只截取最后一行。模型输出和知识库文档都属于外部输入,先保存原始响应与版本,再判断程序是否给出了可追溯的结果。
常见误区与选择建议
不要把相似度最高当成证据最强;不要在索引更新后继续使用旧片段编号;不要把检索失败改写成“暂无相关内容”却丢掉日志;不要把一段支持“退款期限”的文字扩展成支持“所有渠道都一样”。
落地检查清单
- 为知识库问答准备一份最小正常输入和一份已知失败输入,先固定环境再比较结果。
- 检查引用溯源的边界,明确哪些情况应接受、拒绝或继续排查。
- 记录检索评估的判断依据,避免错误被默认值、静默重试或格式化输出掩盖。
- 回归时一次只改一个变量,并把失败样例保留在测试目录。
- 交接时写明版本、命令、输入、输出和已知限制,让下一位维护者能复现结论。
- 对照正常输出与失败输出,确认错误信息能指出具体字段、路径、版本或状态,而不是只返回“失败”。
- 若规则发生变化,先更新样例和预期结果,再修改实现,避免测试通过但验收标准已经悄悄改变。
- 最后记录哪些情况尚未覆盖,把它们列为待确认项,不用默认值替代未知结论。
动手练习
- 先运行正文中的正常样例,保存完整输出。
- 只改变知识库问答相关的一个输入,确认失败位置符合预期。
- 再改变引用溯源,比较错误信息是否仍然可定位。
- 关闭一项校验或配置,确认测试能够主动失败。
- 恢复配置并重跑,检查结果是否回到基线。
- 把一次失败记录整理成可交接的复现步骤。
- 将尚未覆盖的边界加入下一轮回归清单。
结果怎么判读
- 输出符合预期且日志完整:记录为通过,并保留输入样例。
- 输出不符合预期但错误位置清楚:记录为可修复失败,先定位规则。
- 输出看似成功但缺少关键字段:不能放行,补充边界校验。
- 同一输入在不同环境结果不同:先比较版本、配置和依赖。
- 修改后正常样例通过、失败样例消失:优先检查错误是否被吞掉。
- 只有把知识库问答、引用溯源和检索评估的证据一起保存,结论才适合交接。
总结
知识库问答的质量取决于答案能否逐句回到正确版本的原文。用支持、版本冲突、资料缺失三组样本做回归,每次文档更新后重跑,才能发现引用漂移。
延伸学习
- 知识库问答基础:AI 文档教程
- AI 数据分析课程
- AI 语音客服实战笔记
常见问题
Q:引用有编号就代表答案可信么?
A:不代表。必须检查编号指向的片段是否包含答案中的具体事实和条件。
Q:资料没有答案时应该怎么写?
A:明确说明当前资料不足,并记录检索结果;不要用相邻主题推断。